AI 面试知识体系索引(000)
📚 本目录为 **AI 面试知识库的唯一迭代源**。以后对话产生的新知识点,直接归类更新到下方对应大类文档;历史 `agent-output/` 目录不再更新。
📑 目录
1 📚 主文档(面试复习看这 14 个就够)
📚 本目录为 AI 面试知识库的唯一迭代源。以后对话产生的新知识点,直接归类更新到下方对应大类文档;历史
agent-output/目录不再更新。🗂 组织方式:一个大类一个文档,大类文档内的每个
##章 = 一个主题分册,章内小节层级保持原样。所有内容 原封不动 按来源保留,仅标题降一级以适配层级。📁 目录结构:
doc/(13 个大类文档 + 014 提示词工程知识导图 + 本索引 + 对应*_images图片目录 +_分册源/合并前分册备份 +_split_backup_20260909/拆分前备份,全部在此)📌 2026-09-09 拆分说明:原 001(AI 大模型与智能体)按主题拆出 008 大模型原理与基础 / 009 RAG 原理与评测 / 010 Agent 原理与评测 三个独立文档(评测体系按领域归属:LLM 评测留 001、Agent 评测入 010、RAG 评测入 009);原 005(容灾止损专项)拆出 006 变更管控专项 / 007 监控报警专项 两个独立文档,005 只保留容灾主体。拆分内容全部原封不动,仅调整标题层级与图片相对路径。
📌 2026-09-11 二次拆分:大模型与 Agent 知识收敛为两文档——原 001 的 LLM 评测体系(评测工程师 JD/OpenCompass 实战/LLM 评测框架/安全评测/框架选型/价值观评测/长文本评测)整体并入 008 大模型原理与评测;001 §9.9「大模型评测 vs Agent 评测差异」并入 010 Agent 原理与评测;001 剩余(AI API 协议 + Skill/MCP 工具链 + AI 行业观察)独立为 001 工具链与行业观察。008 更名「大模型原理与评测」,图片目录与引用同步迁移,全库校验 537=537 ALL OK。
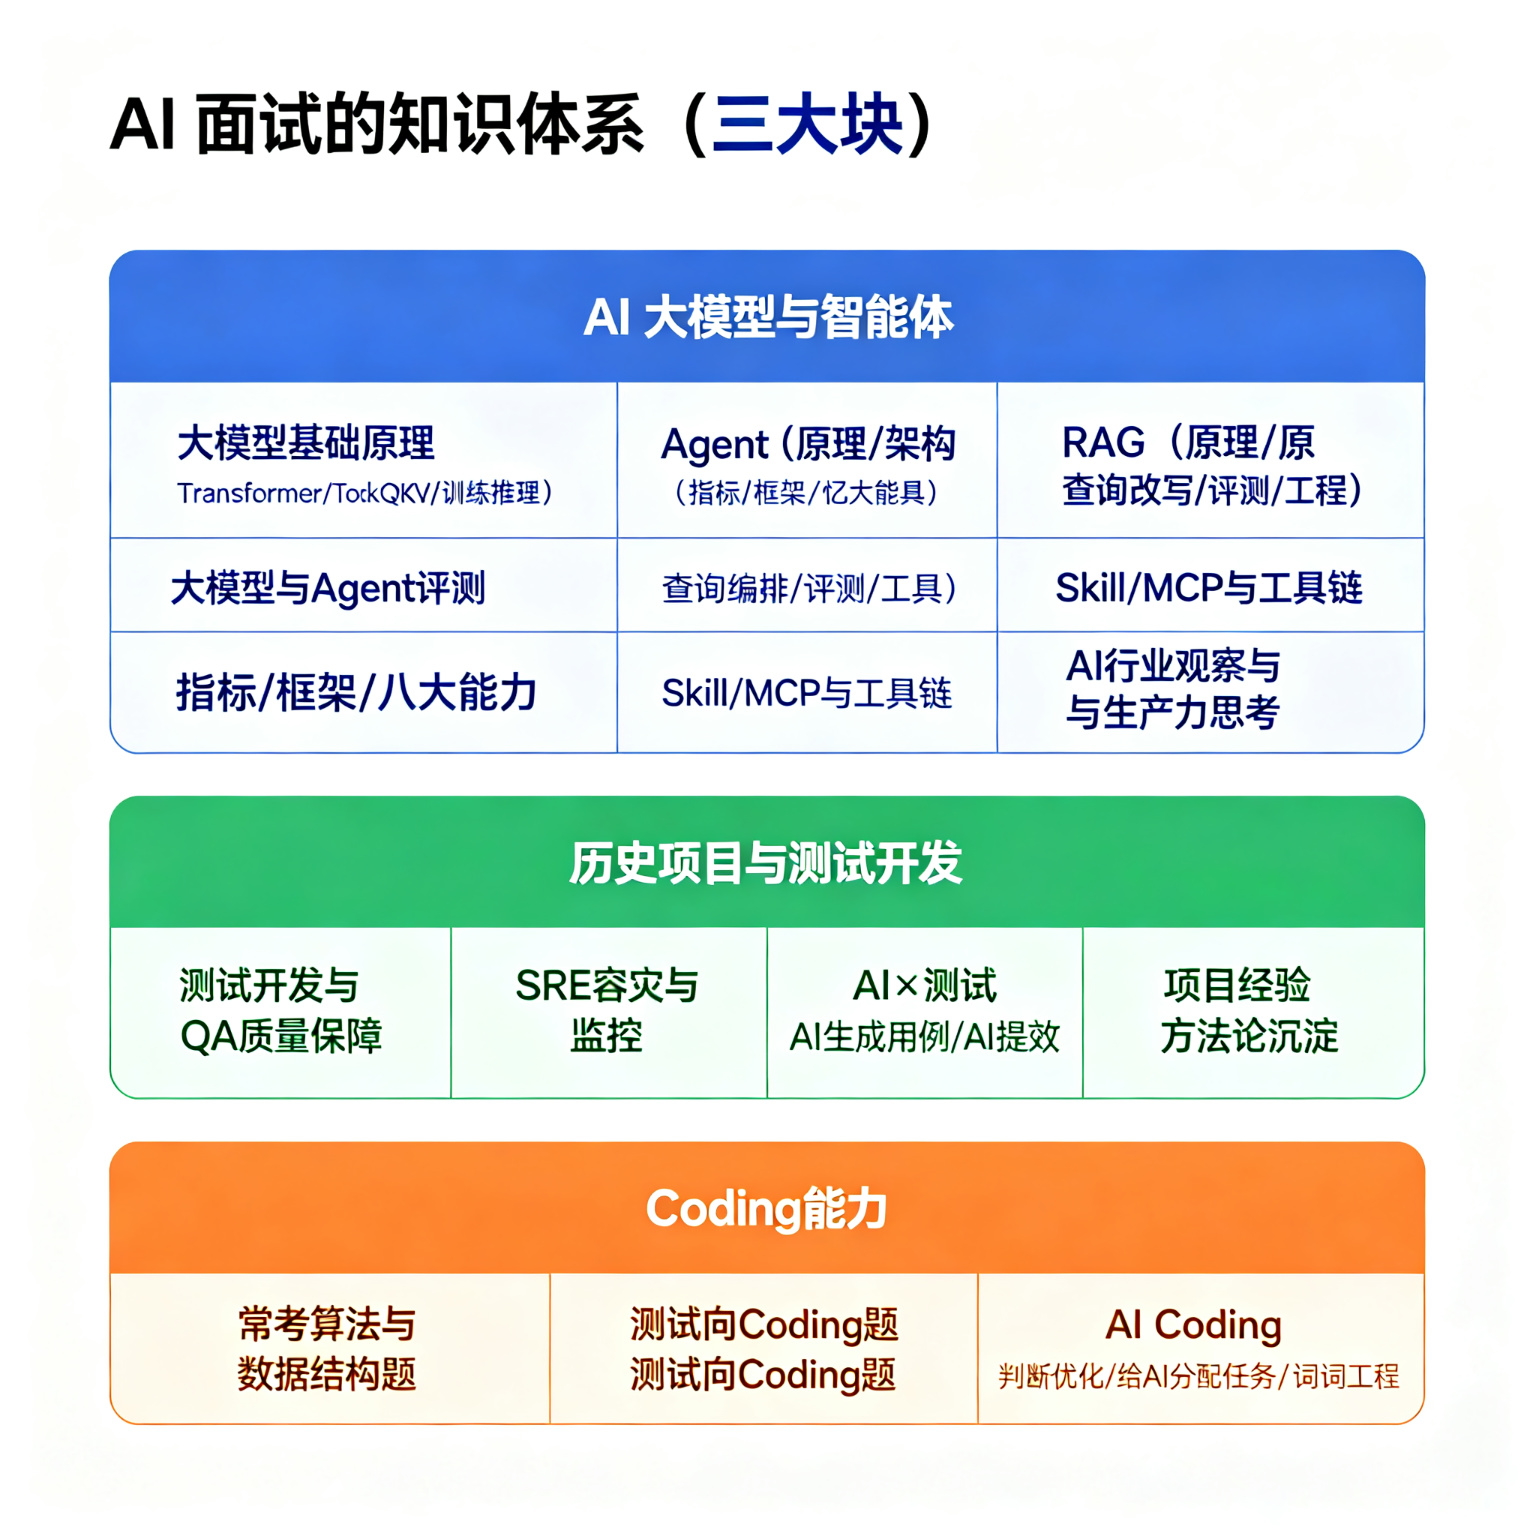
| 编号 | 文档 | 章(分册) | 图片 |
|---|---|---|---|
| 001 | 工具链与行业观察 | ①AI API 协议与 Skill 市场 ②Skill 与 MCP 工具链(WorkBuddy 实践/创建 Skills/Superdesign/插件/为何 Skill 还需 MCP/MCP vs CLI)③AI 行业观察与生产力思考(曾鸣三阶段/生产力革命/Codex 全流程/内容创作 5 趋势/DeepSeek 八万亿/马斯克解散)④AI 行业动态与前沿解析(大模型命名套路/行业收购事件/WeatherNext3/新闻诉讼/ChatGPT Ads/DSH/AI Builder·AI 时代开发者定位·三层能力·与 Prompt Engineer 区别)⑤AI 矢量图 | 43 |
| 002 | 历史项目与测试开发 | ①测试开发与QA质量保障 ②AI×测试 ③视频来源知识点 ④SDET面试全合集 ⑤A/B测试与灰度测试 ⑥Playwright/UI自动化工程落地 ⑦传统测试×AI重塑三Skill方法论 | 17 |
| 003 | Coding 与 AI 编程 | ①Coding能力与AICoding专题(手撕算法/测开脚本题/AI-Coding) | 0 |
| 004 | 通用能力与面试真题 | ①思维方法与通用能力 ②AI面试真题与求职经验 | 25 |
| 005 | 容灾止损专项 | ①SRE稳定性工程·容灾专项(容灾等级/混沌工程/大促容灾/演练/前端APP容灾/TNC/DNS/HTTPDNS/GTM/网络架构/实践全景)②事故响应手册·第8节(容灾与止损·架构防御全景)③附录:14 篇容灾稳定性行业实践文档精读 | 72 |
| 006 | 变更管控专项 | ①稳定性三板斧总纲(变更/监控/容灾对照)②变更管控(灰度策略/评审必检/冻结窗口)③变更回滚预案(SOP)工程化 | 0 |
| 007 | 监控报警专项 | ①监控三板斧与 MTTx 指标族 ②SEV 告警分级 ③事故响应全链路(黄金15分钟/ICS/沟通/复盘/TikTok案例)④事故应急 Agent 协作系统设计 ⑤最佳实践与面试题库 | 1 |
| 008 | 大模型原理与评测 | ①机器学习与神经网络基础 ②前向/反向传播 ③注意力机制与 QKV ④Transformer 详解 ⑤Token/幻觉/名词速查 ⑥模型后训练与轻量化(蒸馏/剪枝/量化·微调技术路线 SFT/PEFT/LoRA/RLHF/DPO)⑦模型评测指标(混淆矩阵/F1/ROC/PR/IoU/消融)⑧Transformer 底层机制进阶(GPT/BERT/KV-Cache)⑨微调面试高频问题 TOP 10 ⑩LLM 评测体系(评测工程师 JD·置信区间·显著性检验·Bootstrap/OpenCompass 实战·评测集速查·ACCEvaluator·singlescore vs m2n·ELO·LLM-as-Judge/LLM 评测框架·安全评测·框架选型·数据污染检测·数据集加载·旭日图/价值观评测·360 事件·FLAMES·五维案例/长文本评测)⑪RLHF/DPO/偏好对齐与评测体系全景(强化学习基础/预训练·SFT·RLHF 范式辨析/RLHF vs DPO·偏好对示例/微调两大维度 FFT·PEFT/Elo 评分/pairwise vs pointwise/MMLU·GSM8K·C-Eval·CMMLU/DeepEval·AgentEval·HumanEval/主观评测 MT-Bench·AlignBench 等/COIG·CAIA) | 111 |
| 009 | RAG 原理与评测 | ①RAG 原理工程与查询改写(检索/重排/Rerank 详解·RRF 倒数排名融合原理·Bi/Cross-Encoder·Query 改写技术全景·HyDE·指代消解·TopK/幻觉/权限/向量库/Agentic RAG)②RAG 评测(评测框架/召回评估/MRR 定义与提高方法论·混合检索·Rerank·分块/生成效果评估/评测数据集构建·ground truth 获取·生产日志清洗去重·拒答问题构造/DeepEval DAG/RAG 评测知识树·检索·生成·端到端三层/三大框架选型组合 AutoRAG·DeepEval·Ragas 三阶段)③配套脚本 query_dedup_tool.py / unanswerable_gen.py 用法 | 59 |
| 010 | Agent 原理与评测 | ①Agent 原理架构与编排(7 种架构/多Agent通信/编排/Workflow/Harness)②Agent 工程化记忆与工具(Function Calling/Loop/Memory/上下文压缩/Claude Code/agentscope-runtime 运行时底座·AaaS·沙箱·可观测)③Agent 评测(评测框架/多轮评测集/第一性原理六步法/八大能力体系实战/LLM vs Agent 评测差异·多轮对话归属)④工具调用评测 ⑤LangChain/LangGraph 代码入门 + Coze/Dify 实操案例(附章·RAG 链/反思循环状态机/零代码五步·低代码六步) | 160 |
| 011 | RAG 评测数据生产速查卡 | 清洗四步法/三级去重/拒答构造六类·五法·保真过滤/混淆矩阵/配套脚本 query_dedup_tool.py + unanswerable_gen.py 用法 | 0 |
| 012 | 美团 Agent 评测方法论和白皮书 | 微信文章归档(含全部图片):①《Agent评测漫谈——由浅入深讲解Agent评测》(评测方法论:评测是什么/核心方法论/人人一致人机一致/观测评测演进/长程Agent与Skill评测/开源评测行业调研)②《Agent 评测白皮书》系列01:Agent 评测全览(完备评测体系:两条Loop/三种能力/离线评测与评测集/在线评测与监控/Case挖掘归因/观测基建/成熟度自查/FAQ) | 48 |
| 013 | 大模型评测知识导图 | XMind《大模型评测》导图全量转 Markdown:①B站 OpenMMLab《OpenCompass 大模型评测实战》逐图知识(why/how/what·评测集·模型·评测器·任务分片·客观/主观评测·C-Eval/MMLU·数据污染·断点续传·run.py)②大模型微调数据构造(XTuner/数据清洗·3H 原则·格式)③promptfoo(prompt/RAG/Agent 红队测试与漏洞扫描)④RAG 系统评估选型(检索层/生成层指标·chunk·向量库·混合检索·rerank·Query 改写·BLEU/ROUGE·LLM-as-Judge·AutoRAG·Ragas·DeepEval·NDCG·框架选型组合) | 264 |
| 014 | 大模型提示词工程知识导图 | XMind《大模型提示词工程》导图全量转 Markdown:①提示工程基础(AGI 概念·Prompt 定义·角色/指示/上下文/例子/输入/输出)②提示词实战(Lost in the Middle·客服案例·DST/NLU/NLG·CoT·Self-Consistency·ToT)③提示词安全(奶奶漏洞·提示词注入·Moderation API·防御四层级·四层防御)④OpenAI API(Chat/Completion·role·Function Calling·MCP·seed/temperature)⑤吴恩达提示词课程精华(两条原则·迭代开发·结构化输出)⑥提示工程方法论与评测(五段式模板·迭代优化·Prompt 评测 5 大维度·SOLID·N+1) | 150 |
补充:
_分册源/目录保存合并前的 12 个分册原文(含原始一级标题);_split_backup_20260909/保存 2026-09-09 拆分前的 001/002/005 原文备份。图片目录00X_xxx_images/与文档同名,引用已全部校验(引用数=文件数)。012 为归档资料文档(微信文章全文归档),内容来源见各部分的「📎 内容来源」块。
2 迭代规则(以后对话照此执行)
- 新知识点先判断属于哪个大类 → 追加到大类文档对应
##章下(可在章内新增###小节),保持原文完整 - 新图片放入对应分册名
_images目录,引用路径用相对路径./00X_xxx_images/xxx.jpg - 大块内容需拆主题时,按章/小节原封不动拆分归位,不删减
- 每轮更新后自查:
大类文档图片引用数 + 000 索引图 == 图片文件总数 - 每个知识点在内容处标注来源链接(方便查看引用):
- 抖音视频来源 → 沿用
### X.1 视频信息表格,记录「原始链接 + 飞书妙记」双来源 - 微信文章来源 → 在所在章/文章标题下加「📎 内容来源」引用块(微信原文链接 + 官方博客/转载链接 + 发布时间) - 飞书文档 / 博客 / 论文 / GitHub 来源 → 在对应小节内保留原文链接 - 归档类多文合并文档(如《012_美团Agent评测方法论和白皮书》):每个部分标题下都必须有来源块,文档头另放来源总表
3 面试复习路径建议
- 第一遍(2-3 天):008(大模型原理+评测主线:机器学习 → 神经网络 → 注意力 → Transformer → LLM 评测体系)→ 010(Agent 原理与编排)→ 009(RAG 原理与检索)
- 第二遍(1-2 天):010 章③ + 009 章②(评测体系:Agent/RAG 怎么衡量)→ 008 章⑩(LLM 评测与选型)→ 007(监控告警与事故响应)→ 006(变更管控)→ 005(容灾专项)
- 第三遍(随刷):003(手撕代码)→ 002(项目面)→ 004(真题模拟)→ 001 章③(AI 行业观察,升华谈资)