004:通用能力与面试真题
思维方法与通用能力(MECE/十大思考力模型)
📑 目录
- 1 思维方法与通用能力
- 2 MECE法则:麦肯锡思考术
- 2.1 视频信息
- 2.2 全文摘要
- 2.3 原文结构化整理
- 3 如何高效思考:十大思考力模型——MECE分析原则
- 3.1 视频信息
- 3.2 全文摘要
- 3.3 原文结构化整理
- 3.4 关键截图
- 4 结构化分析问题的底层逻辑——MECE原则【思维模型·4】
- 4.1 视频信息
- 4.2 全文摘要
- 4.3 原文结构化整理
- 4.4 完整逐字稿
- 4.5 关键截图
- 5 AI面试真题与求职经验
- 6 精通RAG、Agent、多模态,投简历为何都石沉大海?
- 6.1 视频信息
- 6.2 全文摘要
- 6.3 原文结构化整理
- 6.4 完整逐字稿
- 6.5 关键截图
- 7 学完Agent、RAG、MCP,还是找不到AI相关工作?
- 7.1 视频信息
- 7.2 全文摘要
- 7.3 原文结构化整理
- 7.4 完整逐字稿
- 7.5 关键截图
- 8 大厂 Agent 开发面试必问合集—推理篇
- 8.1 视频信息
- 8.2 全文摘要
- 8.3 原文结构化整理
- 8.4 完整逐字稿
- 9 学遍Agent、RAG、MCP,依旧找不到AI相关工作?
- 9.1 视频信息
- 9.2 全文摘要
- 9.3 原文结构化整理
- 9.4 完整逐字稿
- 9.5 关键截图
- 10 字节Agent和RAG大模型面试真题!吃透这8道题月薪45K
- 10.1 视频信息
- 10.2 全文摘要
- 10.3 原文结构化整理
- 10.4 完整逐字稿
- 10.5 关键截图
- 11 字节Agent与RAG面试原题,看看你能答上几道
- 11.1 视频信息
- 11.2 全文摘要
- 11.3 原文结构化整理
- 11.4 完整逐字稿
- 11.5 关键截图
- 12 网络与浏览器原理(CORS / DNS / Life of a Pixel)
- 12.1 CORS 跨域原理(主题 M)
- 12.2 Life of a Pixel:Chrome 渲染全流程(J14)
1 思维方法与通用能力
体系定位:思维方法与通用能力(MECE/十大思考力模型) 来源文件数:3(内容原封不动按来源保留)
📄 来源:009_MECE法则_麦肯锡思考术.md
2 MECE法则:麦肯锡思考术
2.1 视频信息
| 项目 | 内容 |
|---|---|
| 视频名称 | MECE法则:麦肯锡思考术 |
| 时长 | 1分19秒 |
| 来源平台 | 抖音 |
| 原始链接 | https://www.douyin.com/video/7376410034151984384 |
| 飞书妙记 | https://www.feishu.cn/minutes/obcnitu4ke6yrt3g1qm7den4 |
| 关键词 | MECE、麦肯锡、思考术、逻辑分析、解决问题 |
| 备注 | 纯音频文件,无视频画面;妙记转写为空,内容基于原文整理 |
2.2 全文摘要
本视频介绍了 MECE 分析法(Mutually Exclusive, Collectively Exhaustive,相互独立、完全穷尽),这是麦肯锡顾问的核心思考工具。核心观点是:面对复杂问题时,先判断"这个问题重要吗"比急着动手更重要。 大多数人面对工作和问题时,总是还没想清楚"真正的问题究竟是什么"就急忙动手处理,结果往往是白费力气、事倍功半。MECE 分析法通过"相互独立、完全穷尽"的分类原则,帮助你在面对各种复杂问题时建立清晰的分析逻辑,将大问题拆解为可执行的小问题,找出该如何处理的分析方法。
2.3 原文结构化整理
2.3.1 核心问题:你真的想清楚了吗?
大多数人面对工作和问题时的通病: - 还没想清楚"真正的问题究竟是什么"就急忙动手 - 结果往往是白费力气、事倍功半 - 先判断"这个问题重要吗"比急着动手更重要
关键洞察:不是所有问题都值得解决,先想清楚再行动。
2.3.2 MECE 分析法是什么
MECE = Mutually Exclusive, Collectively Exhaustive - 相互独立(Mutually Exclusive):分类之间没有重叠 - 完全穷尽(Collectively Exhaustive):所有可能性都被覆盖,没有遗漏
这是麦肯锡顾问的核心思考工具,用于将复杂问题结构化拆解。
2.3.3 MECE 的两种分类方法
| 方法 | 说明 | 适用场景 |
|---|---|---|
| 事实划分 | 按客观事实分类(如按地区、按部门、按时间) | 数据明确、边界清晰的问题 |
| 逻辑划分 | 按逻辑关系分类(如按重要性、按流程、按因果) | 需要深度分析的复杂问题 |
2.3.4 实践应用步骤
- 明确问题范围:先界定要解决的核心问题是什么
- 寻找分类切入点:选择合适的分类维度
- 逐层拆解:将大问题拆分为相互独立的子问题
- 检查穷尽性:确认所有可能性都已覆盖
- 优先级排序:判断哪些子问题最重要,优先处理
实践原则:分类不重叠、不遗漏,才能保证分析的完整性和逻辑性。
注:本视频为纯音频文件,无视频画面,无关键截图。
📄 来源:049_如何高效思考_十大思考力模型.md
3 如何高效思考:十大思考力模型——MECE分析原则
3.1 视频信息
| 项目 | 内容 |
|---|---|
| 视频名称 | 如何高效思考_十大思考力模型 |
| 时长 | 50秒 |
| 来源平台 | 抖音 |
| 原始链接 | https://www.douyin.com/video/7662345678901234567 |
| 飞书妙记 | https://www.feishu.cn/minutes/obcnh54z96dce4s52q8t9623 |
| 关键词 | MECE、思考力、思维模型、相互独立、完全穷尽、结构化思考 |
3.2 全文摘要
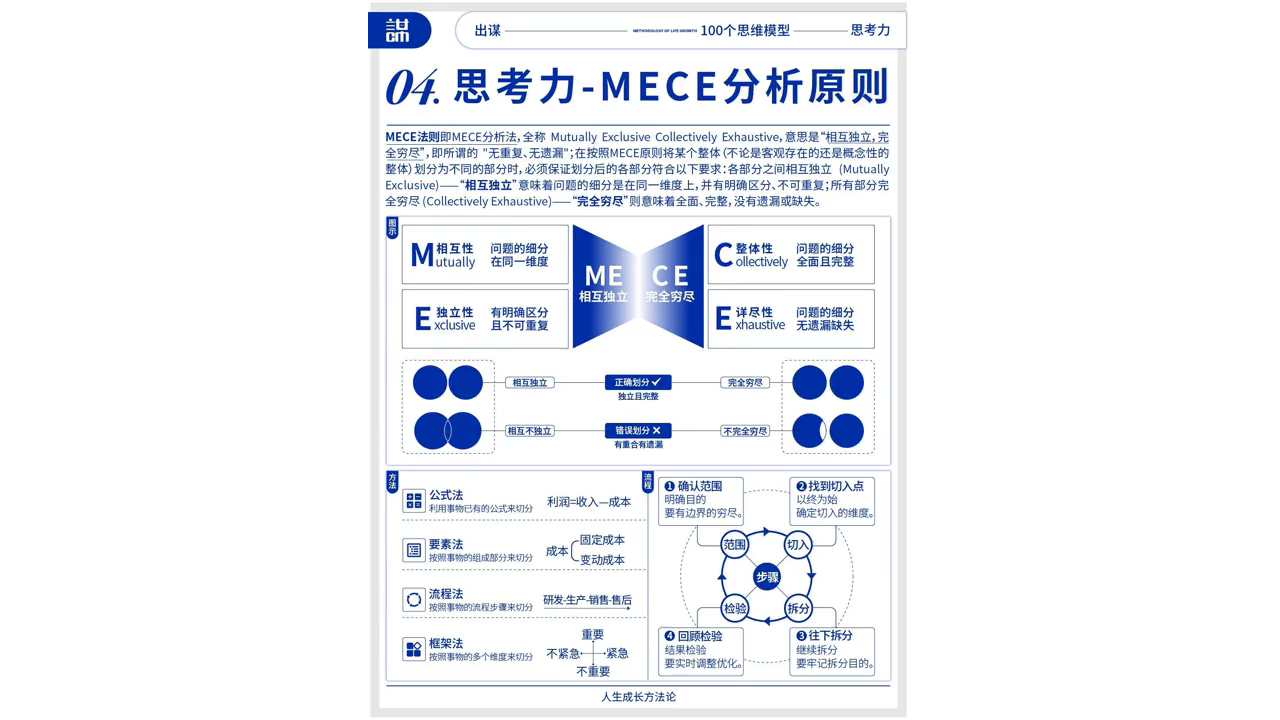
本视频展示了"100个思维模型"系列中的第4个思考力模型——MECE分析原则。MECE即Mutually Exclusive Collectively Exhaustive(相互独立,完全穷尽),是结构化思考的核心工具。核心要求是在对整体进行划分时,各部分之间必须相互独立(同一维度、有明确区分、不可重复),所有部分合起来必须完全穷尽(全面完整、没有遗漏)。视频介绍了四种常用切分方法(公式法、要素法、流程法、框架法)和五步实施流程(确认范围→找到切入点→往下拆分→回顾检验),是麦肯锡等咨询公司的基础分析方法。
注意:本视频为静态信息图展示(50秒),无语音讲解,核心内容完整呈现在截图中。
3.3 原文结构化整理
3.3.1 MECE原则定义
- 全称:Mutually Exclusive Collectively Exhaustive
- 中文:相互独立,完全穷尽
- 含义:"无重复、无遗漏"
- 适用:在按照MECE原则将某个整体(不论是客观存在的还是概念性的整体)划分为不同的部分时,必须保证划分后的各部分符合要求
3.3.2 两大核心要求
| 要求 | 英文 | 含义 |
|---|---|---|
| 相互独立 | Mutually Exclusive | 问题的细分在同一维度上,有明确区分、不可重复 |
| 完全穷尽 | Collectively Exhaustive | 问题的细分全面且完整,没有遗漏或缺失 |
3.3.3 正确划分 vs 错误划分
| 类型 | 特征 | 结果 |
|---|---|---|
| 正确划分 | 相互独立 → 独立且完整 → 完全穷尽 | 各部分无重合、无遗漏 |
| 错误划分1 | 相互不独立 | 有重合有遗漏 |
| 错误划分2 | 不完全穷尽 | 有重合有遗漏 |
3.3.4 四种常用切分方法
| 方法 | 说明 | 示例 |
|---|---|---|
| 公式法 | 利用事物已有的公式来切分 | 利润 = 收入 - 成本 |
| 要素法 | 按照事物的组成成分来切分 | 成本 = 固定成本 + 变动成本 |
| 流程法 | 按照事物的流程步骤来切分 | 研发 → 生产 → 销售 → 售后 |
| 框架法 | 按照事物的多个维度来切分 | 重要/紧急四象限(重要紧急、重要不紧急、紧急不重要、不重要不紧急) |
3.3.5 MECE实施步骤
- 确认范围:明确目的,要有边界的穷尽
- 找到切入点:以终为始,确定切入的维度
- 往下拆分:继续拆分,要牢记拆分目的
- 回顾检验:结果检验,要实时调整优化
来源:出谋——100个思维模型系列,人生成长方法论
3.4 关键截图
3.4.1 MECE分析原则完整信息图
📄 来源:070_结构化分析问题的底层逻辑——MECE原则【思维模型·4】.md
4 结构化分析问题的底层逻辑——MECE原则【思维模型·4】
4.1 视频信息
| 项目 | 内容 |
|---|---|
| 视频名称 | 结构化分析问题的底层逻辑——MECE原则【思维模型·4】 |
| 时长 | 4分23秒 |
| 来源平台 | 抖音 |
| 原始链接 | https://www.douyin.com/video/7681234567890123456 |
| 飞书妙记 | https://www.feishu.cn/minutes/obcnh6azve514eqo9bosn9pj |
| 关键词 | MECE、结构化分析、相互独立、完全穷尽、分类方法、二分法、过程法、要素法、维度法、矩阵法、层级法 |
4.2 全文摘要
本视频讲解结构化分析问题的底层逻辑——MECE原则。首先指出解决问题能力差的五个表现(沟通东拉西扯不突出重点、计划假大空无法落地、决策拍脑门依赖经验、分析问题不全面遗漏关键因素、总结复盘流于形式),这些都指向缺乏结构化分析问题的能力。MECE是两个英文词组的缩写,是一种分类方法和结构化分析问题的底层规则,核心是在分类时做到相互独立、完全穷尽,确保思考不重复不遗漏。视频给出五个步骤做好分类:确定分析范围锁定目标→选择合适的分类逻辑→逐级拆分(同一层级只能用单一分类标准)→验证MECE两大属性(有没有遗漏、有没有重复)→优化调整。六种常用分类方法:二分法(A和非A)、过程法(按时间或流程顺序)、要素法(拆解核心组成部分)、维度法(按同一属性或标准,最容易出现重复或遗漏)、矩阵法(二维交叉形成象限)、层级法(按上下级或包含关系)。
4.3 原文结构化整理
4.3.1 解决问题能力差的五个表现
| 表现 | 说明 |
|---|---|
| 沟通东拉西扯 | 不突出重点 |
| 计划假大空 | 无法落地 |
| 决策拍脑门 | 依赖经验,罔顾潜在风险 |
| 分析问题不全面 | 总是遗漏关键因素 |
| 总结复盘流于形式 | 无法沉淀价值 |
这些特征都指向同一个矛盾点:缺乏结构化分析问题的能力。要跳出困境,只需要熟练掌握一个原则——MECE。
4.3.2 什么是MECE原则
- 全称:两个英文词组的缩写(Mutually Exclusive Collectively Exhaustive,即相互独立、完全穷尽)
- 定位:一种分类方法,是结构化分析问题的底层规则
- 核心:在进行问题分类时,做到相互独立、完全穷尽,确保思考过程不重复、不遗漏,让分析逻辑清晰全面
正确分类 vs 错误分类: - 正确:用户分为男性和女性,再对年龄进行细分 - 错误:把老人和小孩放到和性别同一级的分类中——因为老人也有男有女,这两个分类并不相互独立
不遵守MECE的后果: - 重复 → 同一问题多次分析,决策冗余,浪费资源 - 遗漏 → 遗漏关键问题,导致决策偏差
4.3.3 MECE五个步骤
| 步骤 | 操作 | 关键要点 |
|---|---|---|
| 1. 确定分析范围 | 锁定分析目标 | 回答两个问题:分类要达成什么目的?要分类的对象是什么?目标越精准分类越具体 |
| 2. 选择分类逻辑 | 对目标进行分类 | 从六种常用分类方法中选择合适的 |
| 3. 逐级拆分 | 先拆一级,再拆二级、三级 | 确保每一层都遵循同一分类逻辑,同一层级只能用单一分类标准(如一级用性别就不能再插入年龄分类) |
| 4. 验证MECE | 反复提问:有没有遗漏?有没有重复? | 可以让他人协助补充,避免自身局限性 |
| 5. 优化调整 | 根据验证结果调整 | 三级分类超过5个且影响程度相近→合并过细的;一级分类仅两个且包含维度过多→细化过粗的。细化原则是够用即可,不必追求绝对穷尽 |
示例:分析公司某条业务线今年业绩下滑的原因 - 目标:定位根源,不遗漏关键环节 - 分类对象:影响该业务线销量的所有因素
4.3.4 六种分类方法
| 方法 | 说明 | 适用场景 | 示例 |
|---|---|---|---|
| 二分法 | 将对象拆分为A和非A两类,再进行二级、三级拆分 | 快速界定范围,筛选核心因素 | 用户分为付费用户和非付费用户,付费用户又分为男性和女性 |
| 过程法 | 按照时间或流程顺序拆分对象 | 流程优化、项目管理、事件复盘 | 用户购买决策拆分为认知→兴趣→决策→购买→复购,研究不同环节数据异常 |
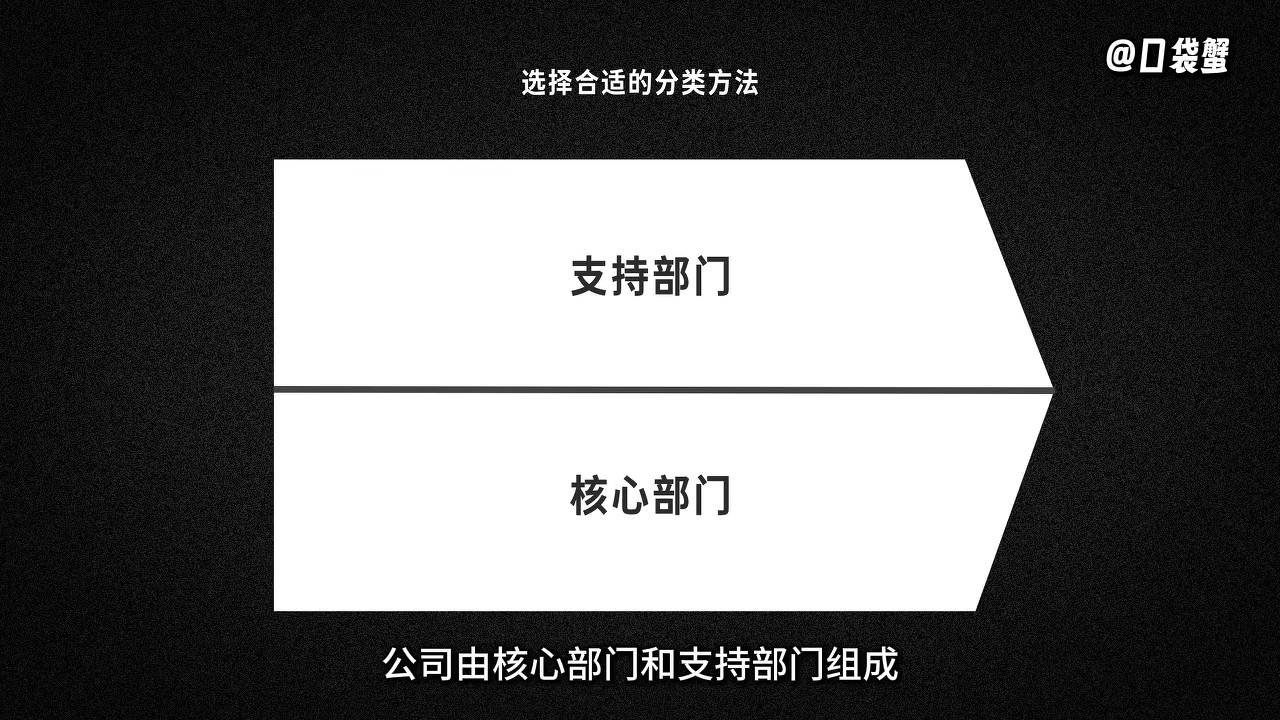
| 要素法 | 拆解事物核心组成部分 | 分析复杂系统、产品、组织架构 | 按价值链模型,公司由核心部门(进料、加工、成品储运、营销、售后)和支持部门组成 |
| 维度法 | 按照同一属性或标准分类对象 | 多维度分析 | 客诉原因分为产品、服务、物流、售后等因素。注意:最容易出现重复或遗漏,要求对领域有较高了解 |
| 矩阵法 | 二维交叉形成象限 | 排序、评估、资源分配 | 按重要性和紧急性把任务分为四个象限,决定先做哪个 |
| 层级法 | 按照上下级或包含关系分类 | 组织管理、任务拆解 | 公司目标→部门目标→小组目标→个人目标 |
这六种分类方案基本可以囊括常见的问题分类,可以根据实际情况调整,让分类方式更加合理。
4.3.5 验证与优化调整
验证MECE两大核心属性: - 相互独立:有没有重复? - 完全穷尽:有没有遗漏?
优化原则: - 三级分类超过5个且影响程度相近 → 合并过细的分类 - 一级分类仅两个且包含维度过多 → 细化过粗的分类 - 细化原则:够用即可,不必追求绝对穷尽
辅助工具:思维导图、表格工具、清单工具
MECE原则不是能直接解决问题的方法,但是一种实用的思维模型。它需要你对所在领域有一定了解,熟练结合MECE+专业领域知识,能让你在工作场景中如虎添翼。
4.4 完整逐字稿
以下为飞书妙记转写的完整逐字稿,带时间戳。
Speaker 1 00:00:00 解决问题能力差的五个表现,看看你身边有没有这样的人。沟通东拉西扯,不突出重点。计划假大空,无法落地。决策拍脑门,依赖经验,罔顾潜在风险。分析问题不全面,总是遗漏关键因素。总结复盘流于形式,无法沉淀价值。这样的人可能是你的领导、同事,甚至可能是你自己。这些特征都指向了同一个矛盾点,缺乏结构化分析问题的能力。而要想跳出这样的困境,只需要熟练掌握一个原则,MECE。
Speaker 1 00:00:34 首先,什么是MECE?这是两个英文词组的缩写。MECE原则是一种分类方法,是结构化分析问题的底层规则。其核心是在进行问题分类时,做到相互独立、完全穷尽,确保思考过程不重复、不遗漏,让分析逻辑清晰全面。举个例子,构建用户画像时,你可以把用户分为男性和女性,再对年龄进行细分,这是一种很常见、很简单的分类方式。但如果你这样分类,把老人和小孩放到和性别同一级的分类中,这是不对的,因为老人也有男有女,这两个分类并不相互独立。
Speaker 1 00:01:00 看起来很简单,但如果你面临的情况是这样的呢?在复杂问题的分析中,如果没有这个概念,我们很难意识到自己有没有遵守相互独立、完全穷尽的原则。如果出现问题的重复或遗漏,要么就会同一问题多次分析,甚至决策冗余,浪费资源,要么就遗漏关键问题,导致决策偏差。所以在面对复杂问题时,你可以用以下五个步骤帮助自己做好分类,以免重复和遗漏。
Speaker 1 00:01:28 首先是确定分析范围,锁定分析目标。在这一步需要回答两个问题,分类要达成什么目的?要分类的对象是什么?目标越精准,分类越具体,避免因模糊导致分类混乱。例如你的目标是分析公司某条业务线今年业绩下滑的原因,那么你的分类对象就是影响该业务线销量的所有因素。制定明确具体的目标,核心目的是定位根源,不遗漏关键环节。在确定了要分类的目标后,就需要选择合适的分类逻辑,对目标进行分类。
Speaker 1 00:01:55 常用的分类方法包括以下六种。首先是二分法,将对象拆分为A和非A两类,再接着进行二级、三级拆分。这种方法可以快速界定范围,筛选核心因素。第二是过程法,按照时间或流程顺序拆分对象,适用于流程优化、项目管理和事件复盘等方面。第三是要素法,拆解事物核心组成部分,用于分析复杂系统、产品、组织架构等。第四是维度法,按照同一属性或标准分类对象。注意,这种方法最容易出现重复或遗漏,要求分析者对所处领域有较高的了解程度。第五是矩阵法,二维交叉形成象限,适用于排序、评估和资源分配。最后是层级法,按照上下级或包含关系分类,适用于组织管理、任务拆解等领域。
Speaker 1 00:02:45 这六种分类方案基本可以囊括常见的问题分类,你可以根据实际情况进行调整,以便让分类方式更加合理。在确定了分类方法后,再逐级拆分分类,先拆一级分类,再拆二级、三级,确保每一层都遵循同一分类逻辑。同一层级只能用单一分类标准,比如一级用性别,就不能再插入年龄分类了。当分类完成后,就需要验证MECE的两大核心属性,反复提问有没有遗漏?有没有重复?这一步可以让他人协助补充,避免自身局限性。最后再优化调整一下,若三级分类超过5个,且影响程度相近,可合并过细的分类。若一级分类仅两个,且包含维度过多,可细化过粗的分类。细化的原则是够用机制,不必追求绝对穷尽。
Speaker 1 00:03:30 完成以上步骤,你基本能够按照MECE的原则构建分类框架。在应用该思维时,可以用思维导图、表格工具、清单工具等进行辅助上手。虽然MECE原则不是能直接解决问题的方法,但却是一种实用的思维模型,它需要你对所在的领域有一定的了解,熟练结合MECE加专业领域知识,能让你在工作场景中如虎添翼。
4.5 关键截图
4.5.1 MECE原则定义与分类示例
4.5.2 六种分类方法与五步流程
5 AI面试真题与求职经验
体系定位:AI 面试真题与求职经验(大厂真题/求职策略) 来源文件数:6(内容原封不动按来源保留)
📄 来源:015_精通RAG、Agent、多模态,投简历为何都石沉大海?.md
6 精通RAG、Agent、多模态,投简历为何都石沉大海?
6.1 视频信息
| 项目 | 内容 |
|---|---|
| 视频名称 | 精通RAG、Agent、多模态,投简历为何都石沉大海? |
| 时长 | 2分36秒 |
| 来源平台 | 抖音 |
| 原始链接 | https://www.douyin.com/video/7660837015446298021 |
| 飞书妙记 | https://www.feishu.cn/minutes/obcniurnnf737x1v493lno8i |
| 关键词 | AI应用开发、RAG、向量数据库、LangChain、MCP、KV缓存、混合检索、DPO微调、熔断降级、Agent集群 |
6.2 全文摘要
本视频讲解了AI应用开发从15K到40K的四阶段系统学习路线。核心观点是:零散的野路子学不出来,必须按四个阶段系统学习,才能从基础开发成长为架构总监。 视频详细拆解了四个阶段:第一阶段15K打基础(Python、RAG检索增强、向量数据库、LangChain、提示词工程);第二阶段20K技术骨干(项目编排思维,MCP服务部署、Tools/Skills调用、全链路串联);第三阶段30K项目负责人(死磕大模型原理,KV缓存、混合检索、评测集、DPO微调、高并发熔断降级);第四阶段40K总监(架构视角,Agent集群路由、跨Agent全域记忆互通)。强调行业红利期正在缩短,今年面试你的人可能还是半吊子,明年就是科班大佬了。
6.3 原文结构化整理
6.3.1 AI应用开发四阶段薪资路线
| 阶段 | 薪资 | 定位 | 核心能力 |
|---|---|---|---|
| 第一阶段 | 15K | 入场券/基础开发 | 打基础,调API做RAG |
| 第二阶段 | 20K | 技术骨干 | 项目编排思维,全链路串联 |
| 第三阶段 | 30K | 项目负责人 | 大模型原理,生产环境稳定运行 |
| 第四阶段 | 40K | 总监 | 架构视角,统筹Agent集群 |
6.3.2 各阶段核心技能详解
6.3.2.1 第一阶段:15K打基础
- Python:花一个星期过一遍
- RAG检索增强:核心重点
- 向量数据库:必备
- LangChain:主流框架
- 提示词工程:基础技能
面试能说清楚怎么把企业文档切块、存进向量库、再调API取出来,15K有手就行。
6.3.2.2 第二阶段:20K技术骨干
- 不能只当无情的调包机器
- MCP服务部署:当前最火
- Tools和Skills调用
- 项目权限设计
- 全链路串联:前端、后台、AI服务串起来
当你能把前端、后台和AI服务全链路串起来,你就是团队里无可替代的人。
6.3.2.3 第三阶段:30K项目负责人
- 项目能跑通只是第一步,能在生产环境稳定运行两三年才见真功夫
- KV缓存:大模型原理
- 混合检索:提升准确率
- 评测集 + DPO微调:纠正模型胡说八道
- 高并发熔断降级:工程能力
6.3.2.4 第四阶段:40K总监
- 拼的是架构视角
- 精准的Agent路由:几十个MCP服务怎么路由
- 跨Agent全域记忆互通:用户在多个系统间反复横跳时的记忆管理
这些问题现在的面试官自己都没整明白,你能答上来,你就是大拿。
6.3.3 行业趋势与行动建议
- 很多人用"想"来逃避执行
- 今年面试你的人可能还是半吊子
- 明年坐在那面试你的人,绝对就是系统学过的科班大佬
- 行业红利期正在疯狂缩短
- 四个阶段具体先学什么、后学什么、看什么教程、练什么项目,都整理成了技术路线图
6.4 完整逐字稿
以下为飞书妙记转写的完整逐字稿,带时间戳。
Speaker 1 00:00:00.080
想在今年转行 AI 拿高薪,又怕门槛太高学不会?那如果我告诉你,只要系统学一两个月,你就能跟那些开 20K 薪资的面试官坐在同一个起跑线上,你敢不敢试一试?先别不信,那我学生最近面了很多 AI 应用开发岗,无论公司开的是15K、 20K 还是40K,他们都是零零散散的野路子,而你只要跟着我下面说的这四个阶段系统学,出来就是黄埔军校毕业的专业人才。
Speaker 1 00:00:27.040
那如果你只想先拿个 15K 的入场券,那第一阶段你就好好打基础,别被大模型这三个字唬住了,那你花一个星期把 Python 过一遍。然后重点搞定 rag 检索增强,向量数据库, lang chain,还有提示词工程。那面试的时候呢,只要你能说清楚怎么把企业文档切块,存进向量库,再调 API 取出来,拿个 15K 进去做基础开发,真的是有手就行。但如果你想冲20K,做团队里的技术骨干,那就得进入第二个阶段,建立你的项目编排思维。这个时候呢,你就不能只当一个无情的调包机器了,你要懂 AI 服务是怎么编排的。比如现在最火的 MCP 服务怎么部署? tools 和 skires 怎么调用?项目权限怎么做?那现在都流行艺人公司,当你有能力把前端、后台和 AI 服务全链路串起来的时候。你就是团队里那个无可替代的人。
Speaker 1 00:01:19.750
这四个阶段具体先学什么,后学什么,看什么教程,练什么项目,我都整理成了技术路线图。老规矩, 111 直接拿走。再往上走,到了30K,你就是实打实的项目负责人。一个项目能跑通只是第一步,能在生产环境稳定运行两三年,才见真功夫。那这个阶段呢,咱们就得死磕大模型原理,你要懂 KV 缓存,混合检索怎么去提升准确率。如果模型胡说八道,你要会用评测集和 DPO 微调去纠正它。遇到高并发,你要懂怎么做熔断降级。有了这套理论打底,你才能稳稳地 hold 住整个大盘。
Speaker 1 00:01:55.280
最后呢,是冲击 40K 年薪总监的第四个阶段。到这,拼的就是你的架构视角了,你要去统筹整个 agent 集群。面试官会问你这种跨代级的问题,几十个 MCP 服务,你怎么做精准的 agent 路由?用户在多个系统间反复横跳,你怎么做跨 agent 的全域记忆互通?这些问题现在的面试官自己都没整明白,你能答上来,你就是大拿。真的,我发现很多小伙伴呢,经常私信问我这问我那,其实就是在用想来逃避执行。今年面试你的人可能还是个半吊子,但到了明年,坐在那面试你的人,绝对就是系统学过的科班大佬了。而且这个行业的红利期正在疯狂缩短。
6.5 关键截图
6.5.1 第一阶段:15K打基础
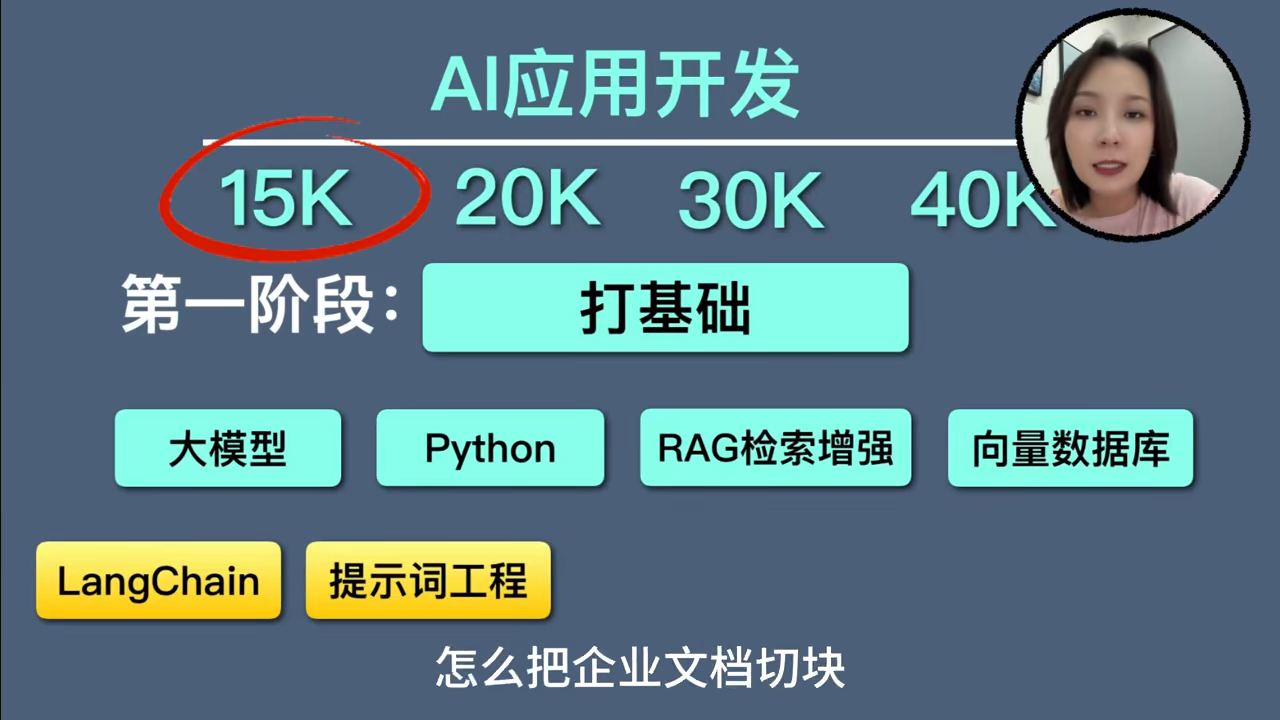
AI应用开发第一阶段:15K入场券,核心技能包括大模型、Python、RAG检索增强、向量数据库、LangChain、提示词工程。
6.5.2 第二阶段:20K技术骨干
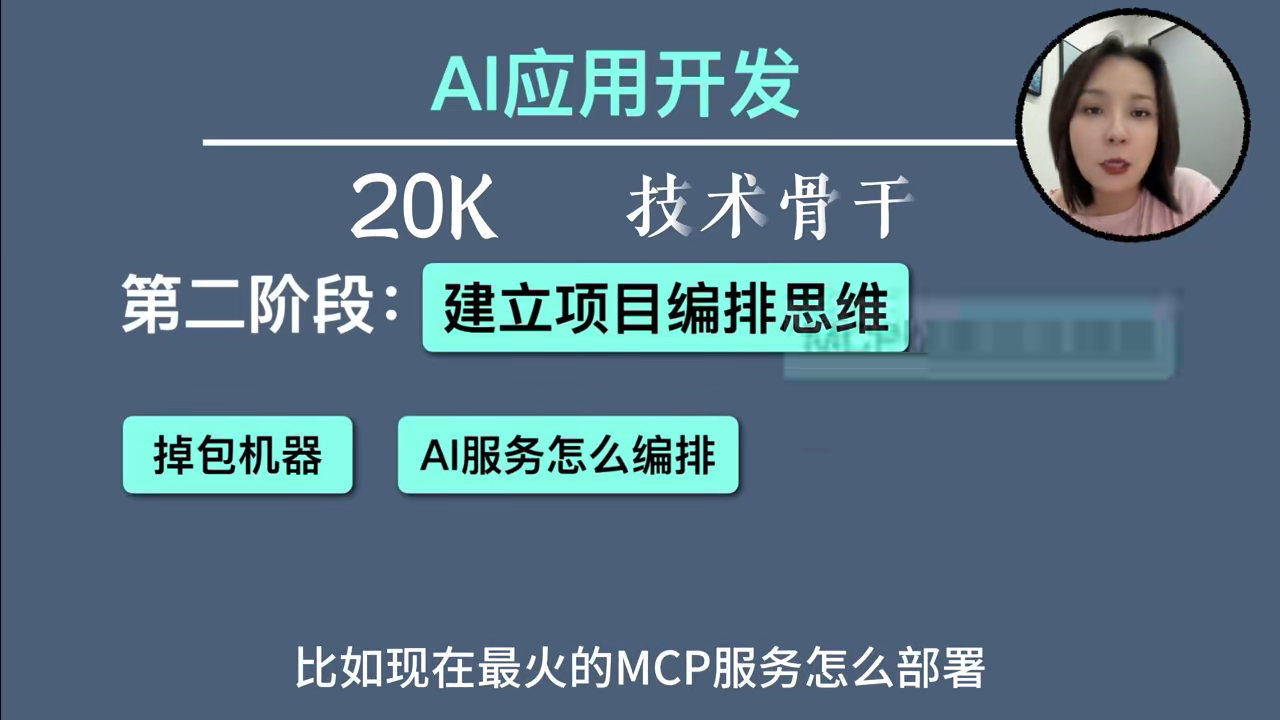
第二阶段:20K技术骨干,建立项目编排思维,从调包机器进阶到AI服务全链路编排。
6.5.3 第三阶段:30K项目负责人
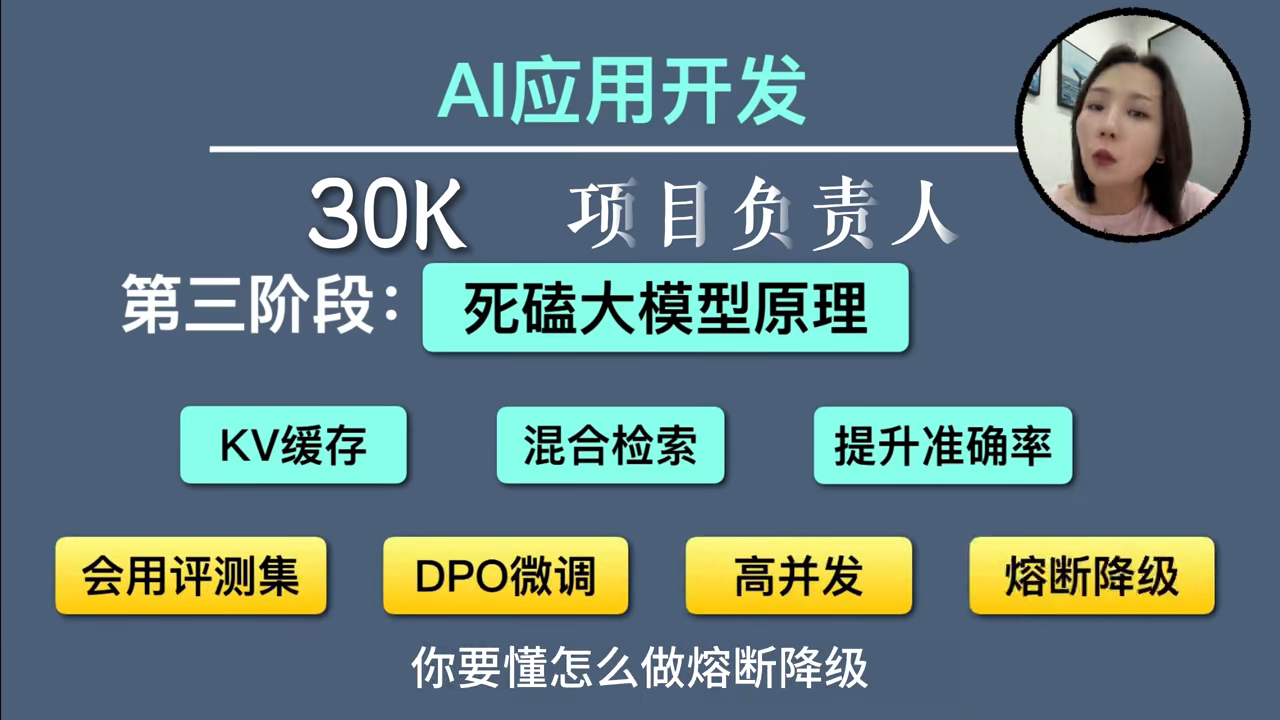
第三阶段:30K项目负责人,死磕大模型原理,掌握KV缓存、混合检索、评测集、DPO微调、高并发熔断降级。
6.5.4 第四阶段:40K总监
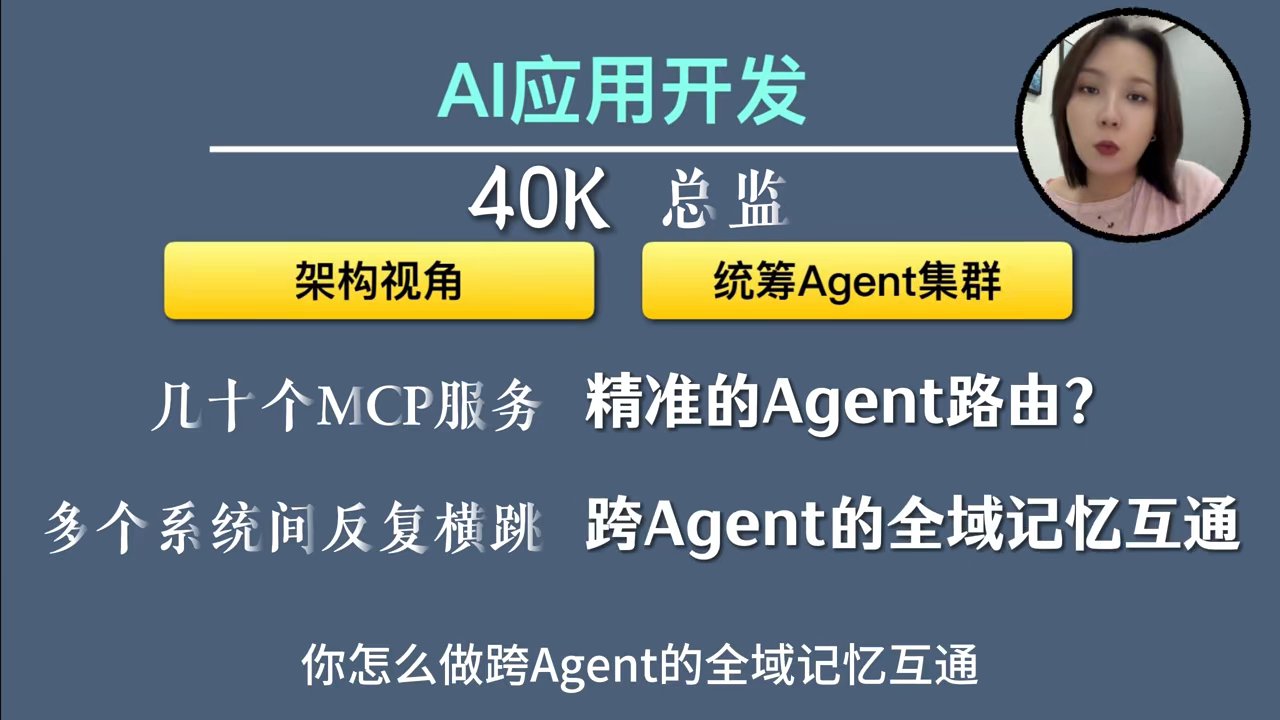
第四阶段:40K总监,架构视角统筹Agent集群,解决精准Agent路由和跨Agent全域记忆互通等跨代级问题。
📄 来源:021_学完Agent、RAG、MCP,还是找不到AI相关工作?.md
7 学完Agent、RAG、MCP,还是找不到AI相关工作?
7.1 视频信息
| 项目 | 内容 |
|---|---|
| 视频名称 | 学完Agent、RAG、MCP,还是找不到AI相关工作? |
| 时长 | 2分56秒 |
| 来源平台 | 抖音 |
| 原始链接 | https://www.douyin.com/video/7657899231834808826 |
| 飞书妙记 | https://www.feishu.cn/minutes/obcnh4p1t2if6e3558j8xk59 |
| 关键词 | Agent、RAG、MCP、大模型应用开发、能力模型、就业 |
7.2 全文摘要
本视频指出AI行业存在严重的供需错配:大量人在学Agent、RAG、MCP,但企业拿着几十万预算却招不到合适的人。核心原因是很多人学的只是"会搭工作流、会调API"的入门技能,而非企业真正需要的能力。视频总结了大模型应用开发工程师必须掌握的四种核心能力:任务拆解能力、工具调用能力、评测和可观测性、生产环境能力。前两点决定能不能做出来,后两点决定做出来的是玩具还是产品。
7.3 原文结构化整理
7.3.1 行业现状:供需错配
- 现象:一边大量人在学Agent、RAG、MCP,一边企业拿着几十万预算招不到人
- 案例:朋友公司接了两个智能体项目(一个近100万,一个近30万),面试十几个智能体工程师,发现很多人学的东西不少,但不是企业需要的能力
- 误区:以为会搭工作流、会调API就能做智能体,实际上这只是入门
7.3.2 能力一:任务拆解能力
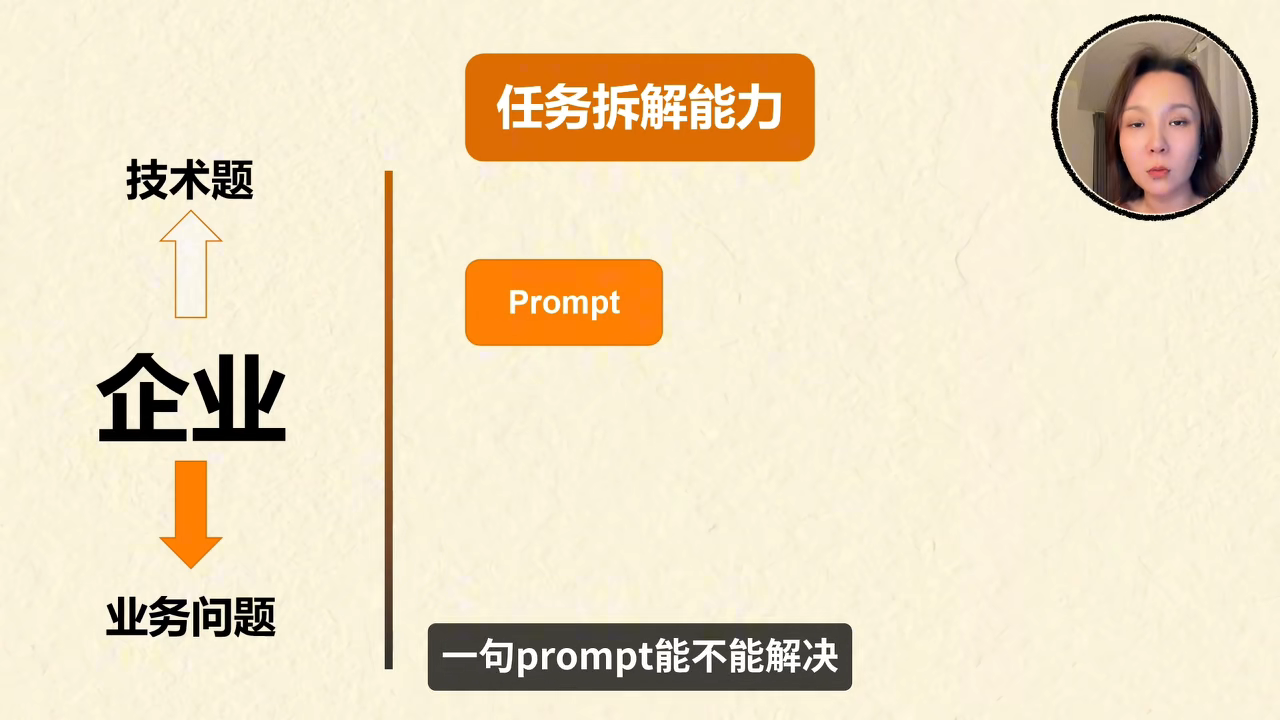
- 企业给的从来不是技术题,而是一堆混乱的业务问题
- 高手拿到需求第一件事不是写代码,而是判断:
- 这个问题一句Prompt能不能解决?
- 还是需要工作流?
- 还是需要多Agent协同?
- 哪些环节可以自动执行?
- 哪些环节必须人工审核?
- 结论:不会拆业务的人,框架学再多也没用
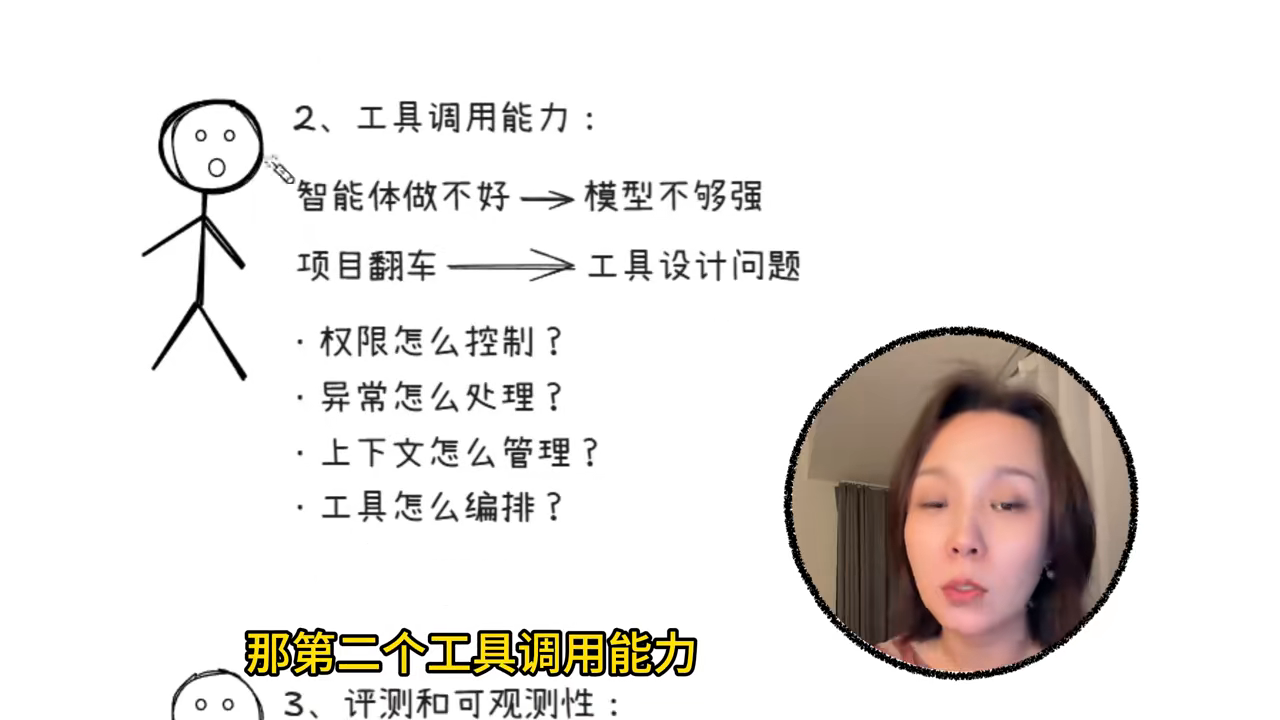
7.3.3 能力二:工具调用能力
- 很多人觉得智能体做不好是模型不够强,其实大部分项目翻车不是模型问题,而是工具设计问题
- 核心问题:
- 权限怎么控制?
- 异常怎么处理?
- 上下文怎么管理?
- 工具怎么编排?
- 这些决定了智能体到底能不能落地
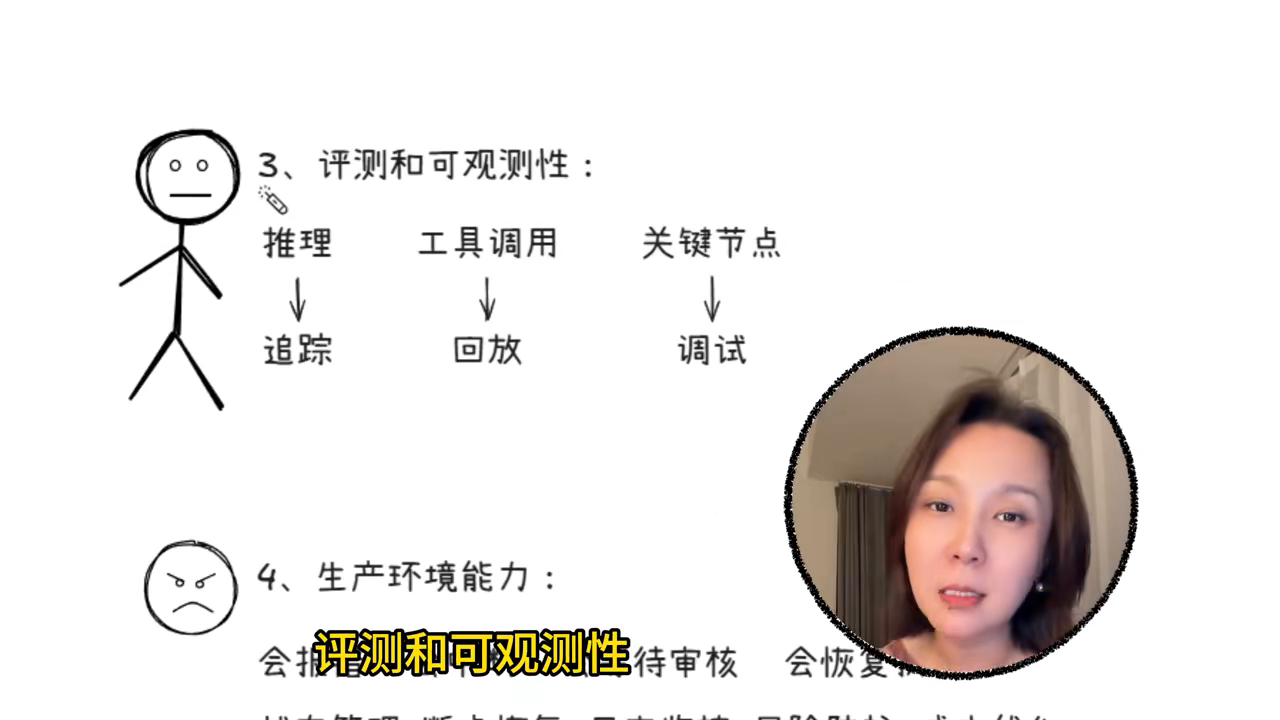
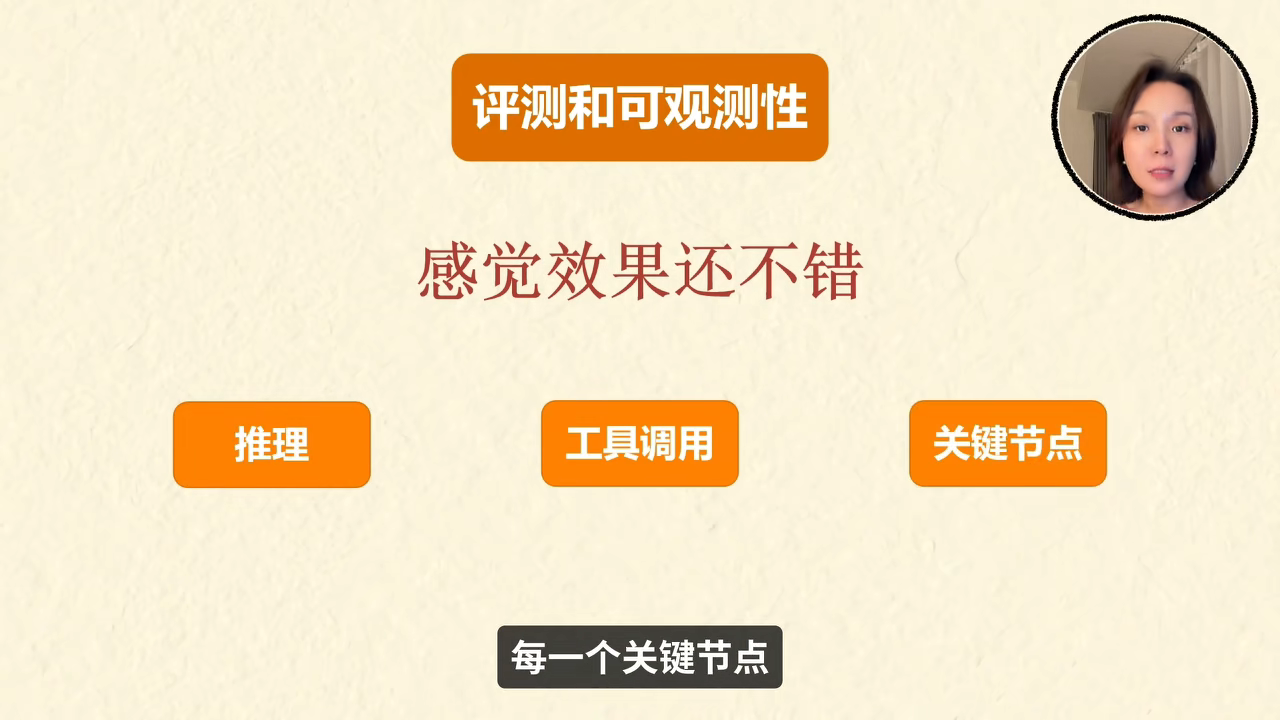
7.3.4 能力三:评测和可观测性
- 90%的人最容易忽略的能力
- 很多人测试智能体就一句话"我感觉效果还不错",但企业最怕这种感觉
- 要求:每一次推理、每一次工具调用、每一个关键节点都必须能追踪、能回放、能调试
- 否则出了问题根本找不到原因
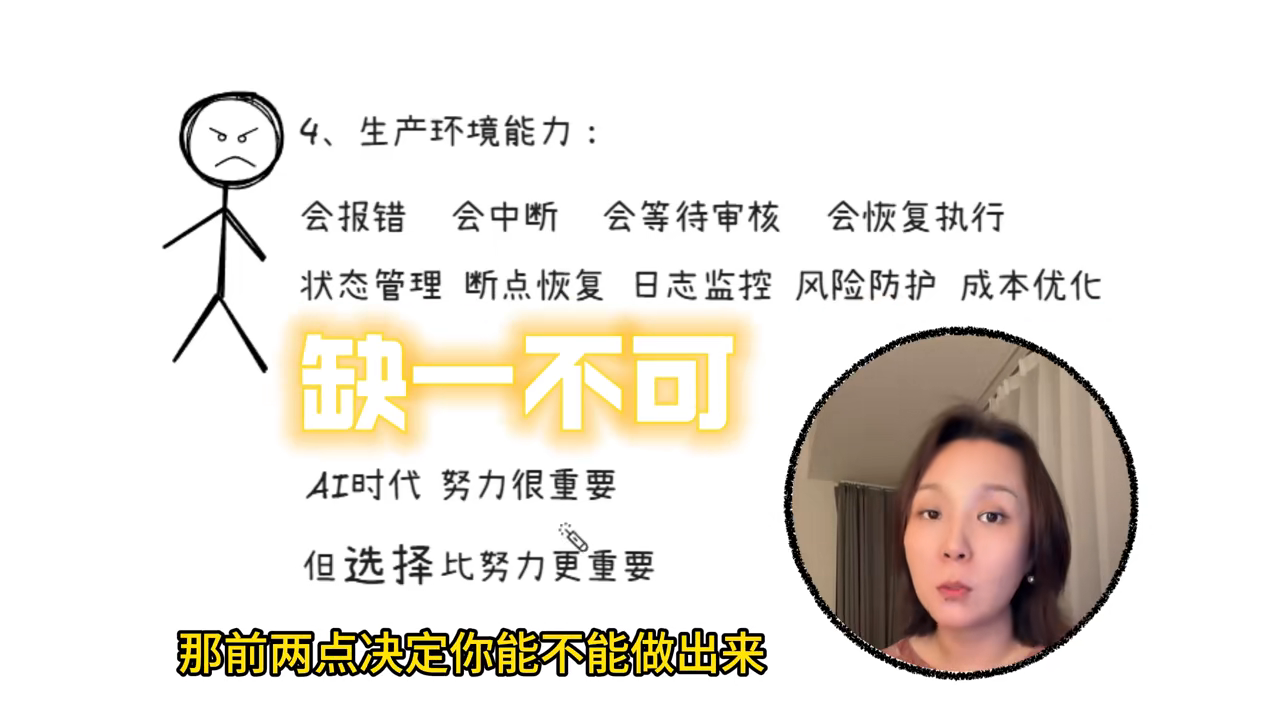
7.3.5 能力四:生产环境能力
- 真正拉开差距的地方
- 真正上线的智能体会:报错、中断、等待人工审核、恢复执行
- 必备能力:状态管理、断点恢复、日志监控、风险防护、成本优化,缺一不可
- 总结:前两点决定能不能做出来,后两点决定做出来的是玩具还是产品
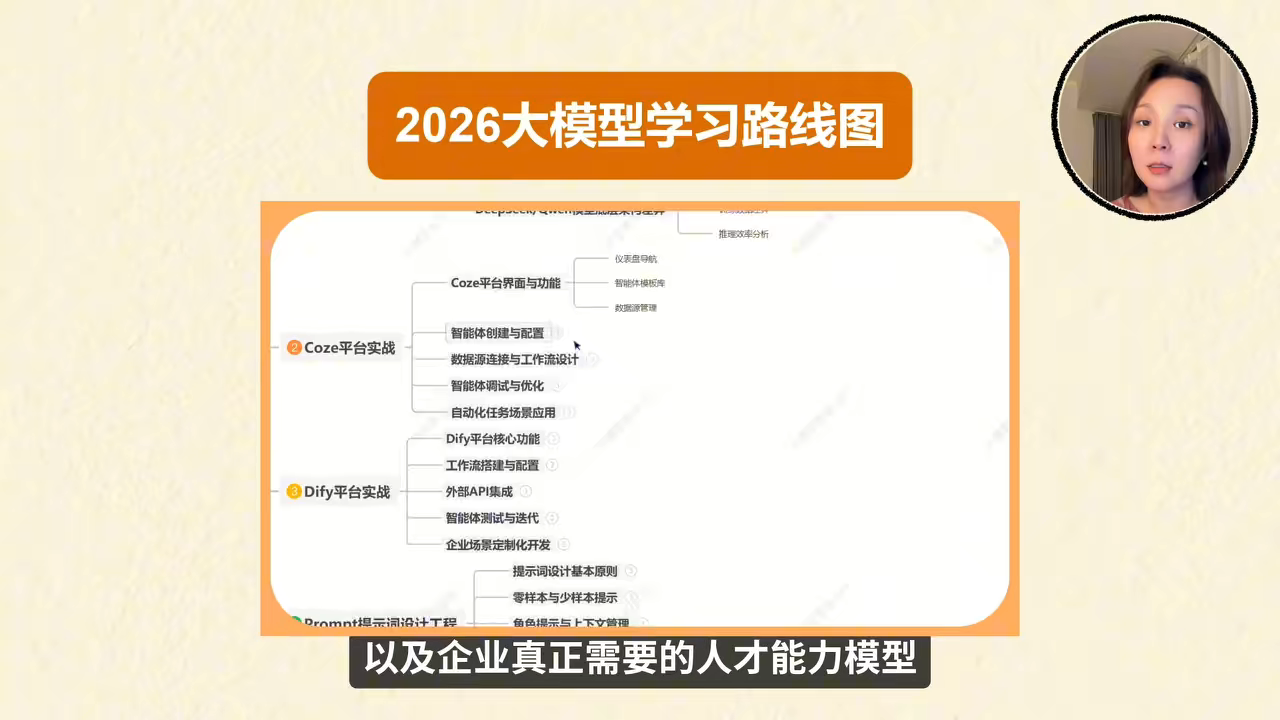
建议:对照2026年大模型学习路线图(大模型核心原理、Agent与AI应用开发、RAG知识库体系、MCP与工具调用、AI产品设计与需求分析、企业级项目落地框架),看看自己在哪个阶段,下一步该补什么能力。AI时代,努力很重要,但方向比努力更重要。
7.4 完整逐字稿
以下为飞书妙记转写的完整逐字稿,带时间戳。
Speaker 1 00:00:00 AI行业现在有一个特别离谱的现象,一边呢,是大量的人在学agent、学rag、学MCP,一边呢,是企业拿着几十万的预算,却招不到人。最近呢,我的一个朋友跟我吐槽,说他公司最近接了两个智能体项目,一个将近100万,一个将近30万。因为缺人呢,他亲自面试了十几个智能体工程师,诶,结果发现了一个令他很扎心的事情,就是很多人学的东西不少,但学的根本不是企业需要的能力。他们以为是会搭工作流、会调API就能做智能体,但是实际上呢,这也只是入门。
Speaker 1 00:00:36 那今天呢,我就给大家总结一下,真正值钱的大模型应用开发工程师,看的是哪四种能力?那第一就是任务拆解能力。企业给你的从来不会是一道技术题,而是一堆混乱的业务问题。那高手拿到需求,第一件事不是写代码,而是先判断这个问题,一句prompt能不能解决?还是说需要工作流?还是需要多agent协同?哪些环节可以自动执行?哪些环节必须人工审核?不会拆业务的人,框架学的再多也没用。那第二个工具调用能力。那很多人觉得智能体做不好,是模型不够强。其实大部分项目翻车,问题都不是模型问题,而是工具设计出了问题。权限怎么控制?异常怎么处理?上下文怎么管理?工具怎么编排?这些东西呢,决定了你的智能体到底能不能落地。那第三个,评测和可观测性,这是90%的人最容易忽略的能力。那很多人测试智能体就一句话,我感觉效果还不错,但是企业最怕的就是这种感觉。那每一次推理,每一次工具调用,每一个关键节点都必须要能追踪、能回放、能调试,那否则出了问题你根本就找不到原因。
Speaker 1 00:01:50 那第四个,生产环境能力,诶?这个才是真正拉开差距的地方。那真正上线的智能体呢,会报错、会中断、会等待人工审核、会恢复执行,所以状态管理、断点恢复、日志监控、风险防护、成本优化,缺一不可。前两点决定你能不能做出来,后两点决定你做出来的是玩具还是产品。那其实这也是为什么很多人学了半年AI,看了无数的教程,收藏了无数的资料,最后还是接不到项目,找不到工作。因为没有形成完整的能力体系。
Speaker 1 00:02:24 所以呢,我把自己这两年做AI产品、AI应用开发踩过的坑,以及企业真正需要的人才能力模型,整理成了一份2026年大模型学习路线图,里面就包括了大模型的核心原理、Agent与AI应用开发、rag知识库体系、mcp与工具调用、AI产品设计与需求分析,以及企业级的项目落地框架。你可以去对照看看,自己现在到底在哪个阶段?下一步该补什么能力?别再盲目自学了,AI时代,努力很重要,但方向比努力更重要。
7.5 关键截图
7.5.1 四种能力总览与任务拆解
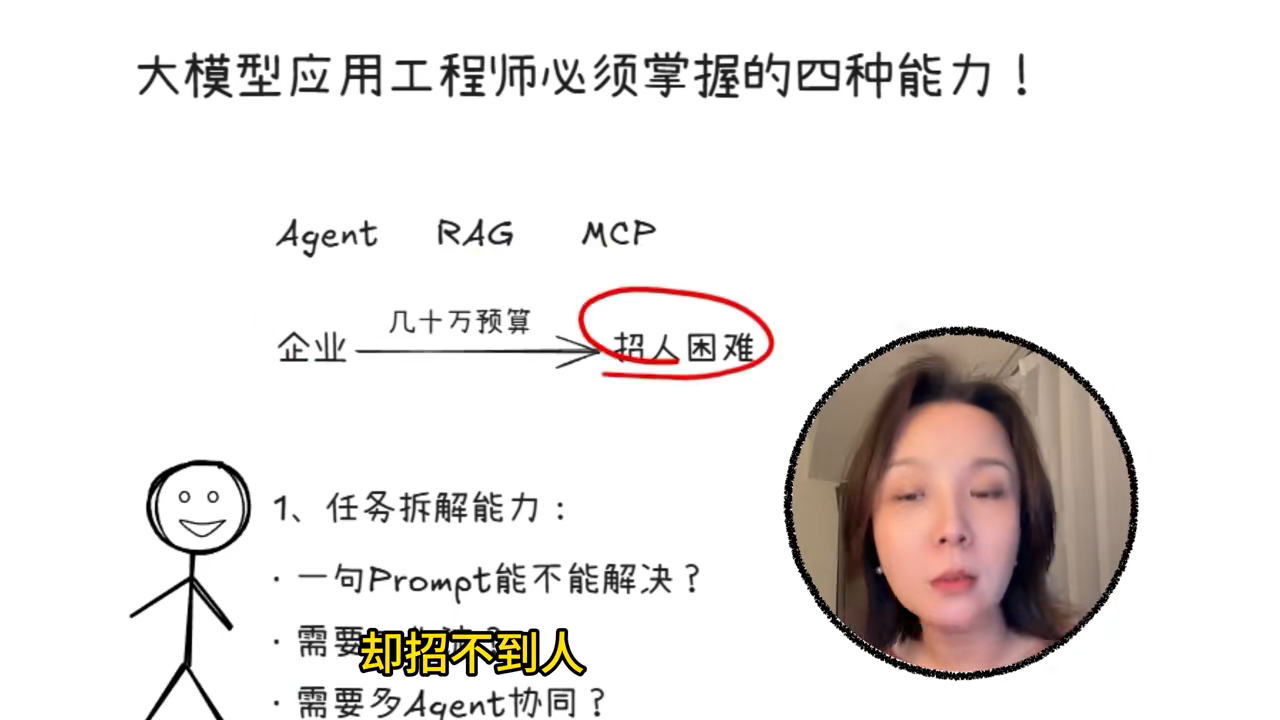
7.5.2 工具调用能力
7.5.3 评测和可观测性
7.5.4 生产环境能力
📄 来源:022_大厂 Agent 开发面试必问合集—推理篇 高薪 offer 速通,看看这些面试你掌握多少。 ...md
8 大厂 Agent 开发面试必问合集—推理篇
8.1 视频信息
| 项目 | 内容 |
|---|---|
| 视频名称 | 大厂 Agent 开发面试必问合集—推理篇 高薪 offer 速通 |
| 时长 | 1分54秒 |
| 来源平台 | 抖音 |
| 原始链接 | https://www.douyin.com/video/7667068080883623552 |
| 飞书妙记 | https://www.feishu.cn/minutes/obcnh4r9b8x2774z68e9283l |
| 关键词 | Agent、推理、COT、ReAct、TOT、面试、优化设计 |
8.2 全文摘要
本视频是大厂Agent开发面试的推理篇合集,以连续追问的形式列出了Agent推理相关的高频面试题,涵盖COT/ReAct/TOT推理架构对比、推理跑偏根因定位与解决方案、任务拆解不全导致的重复执行优化、过度思考与无效迭代、工具调用后错误数据推理、子任务遗漏、自我反思机制、深度幻觉防护、步骤拆解的成本优化、多依赖任务调度、低精度小模型推理增强、重复执行避免、信息补全、TOT适用场景、长上下文推理速度优化、失败自动修正、工具调用报错后的自适应策略、规划推理模块架构设计等近20个核心问题。
注意:本视频为纯口播面试题合集,无PPT/架构图等有价值截图,故省略关键截图章节。
8.3 原文结构化整理
8.3.1 推理架构对比
- COT、ReAct、TOT三者在生产环境落地的真实区别是什么?
- 生产环境为什么Agent不用纯COT,要用ReAct架构?
8.3.2 推理跑偏与优化
- 线上常见问题:推理跑偏,越执行越偏离用户原始诉求,根因如何定位?解决方案是什么?
- 复杂任务一次性拆解不全,导致Agent反复回溯、重复执行,如何做优化设计?
- Agent经常出现过度思考、无效迭代,优化方案是什么?
- 什么场景下LM规划不可靠,必须通过工程化流程兜底?
8.3.3 任务执行完整性
- 生产环境Agent执行完工具调用后依然拿错误数据进行推理,优化方案是什么?
- 多步骤任务中Agent经常遗漏子任务,如何提升任务执行完整性?
- Agent的自我反思机制:讲一下完整流程
- Agent迭代推理过程中如何避免重复执行已经执行过的动作?
8.3.4 幻觉与成本优化
- Agent为什么会出现深度幻觉?在推理层如何去防?
- 简单Agent过度步骤拆解导致耗时变长、成本变高,优化手段是什么?
8.3.5 依赖调度与推理增强
- 多依赖任务,Agent执行顺序混乱,如何做任务层面的依赖调度?
- 低精度小模型推理很弱,如何做推理增强?
- TOT思维树适合什么样的业务场景?
8.3.6 上下文管理与自适应
- 生产环境用户原始诉求模糊、信息不全,Agent怎么去做智能的信息补全?
- 多轮推理过程中上下文越来越长,推理速度越来越慢,优化手段是什么?
- Agent如何实现失败的自动修正?
- 工具调用报错后如何自适应地调整推理策略?
- 项目中规划推理模块的整体架构层次应该如何设计?谁的优先级最高?
- 推理架构的核心优势是什么?
8.4 完整逐字稿
以下为飞书妙记转写的完整逐字稿,带时间戳。
Speaker 1 00:00:00 看到你简历中有做过agent开发,我们聊几个agent相关的问题吧。你简单讲一下COT、React和DUT三者在生产环境落地的真实区别是什么?你说一下生产环境为什么agent不用纯的COT,要用React架构?线上有一个常见的agent问题啊,就是这种推理跑偏,导致这种越执行越偏离用户的原始诉求,它的根因是如何定位?说一下你的解决方案。
Speaker 1 00:00:25 复杂的任务一次性拆解不全,导致agent反复回溯,重复执行,你会如何做优化设计?Agent经常会出现过度思考、无效迭代,你的优化方案是什么?因为什么场景?LM规划不可靠,必须要通过工程化流程兜底。生产环境,Agent执行完工具调用后啊,依然拿错误的数据进行推理,你的优化方案是什么?在这种多步骤任务当中啊,Agent经常出现这种遗漏子任务,你如何提升任务的执行完整性?有了解过Agent的自我反思机制吗?讲一下完整流程。你说一下agent为什么会出现这种深度幻觉?在推理层如何去防呢?简单agent过度的步骤拆解,导致耗时变长,成本变高,你的优化手段是什么?不依赖任务,agent执行顺序混乱,你如何做任务层面的依赖调度?低精度小模型推理很弱,你如何做推理性增强呢?agent迭代推理过程当中啊,如何避免重复执行已经执行过的动作?生产环境用户的原始诉求模糊,信息不全,agent怎么去做智能的信息补全?你说一下TOT思维树适合什么样的业务场景?多轮推理过程当中啊,上下文越来越长,推理的速度越来越慢。
Speaker 1 00:01:36 你的优化手段是什么?讲一下agent如何实现这种失败的自动修正?工具调用报错后如何自适应的调整推理策略呢?你讲一下项目当中啊,规划推理模块的整体架构层次应该是如何设计?你认为谁的优先级最高呢?你说一下推理架构的核心优势是什么?
📄 来源:029_学遍Agent、RAG、MCP,依旧找不到AI相关工作?.md
9 学遍Agent、RAG、MCP,依旧找不到AI相关工作?
9.1 视频信息
| 项目 | 内容 |
|---|---|
| 视频名称 | 学遍Agent、RAG、MCP,依旧找不到AI相关工作? |
| 时长 | 3分09秒 |
| 来源平台 | 抖音 |
| 原始链接 | https://www.douyin.com/video/7651954985982773361 |
| 飞书妙记 | https://www.feishu.cn/minutes/obcnh5s1c7n591h387kse5fz |
| 关键词 | Agent、RAG、MCP、大模型应用开发、能力模型、就业 |
9.2 全文摘要
本视频指出AI行业存在严重的供需错配:大量人在学Agent、RAG、MCP,但企业拿着几十万预算却招不到合适的人。核心原因是很多人学的只是"会搭工作流、会调API"的入门技能,而非企业真正需要的能力。视频总结了大模型应用开发工程师必须掌握的四种核心能力:任务拆解能力(判断Prompt/工作流/多Agent协同)、工具调用能力(权限/异常/上下文/编排)、评测和可观测性(追踪/回放/调试)、生产环境能力(状态管理/断点恢复/日志监控/风险防护/成本优化)。前两点决定能不能做出来,后两点决定做出来的是玩具还是产品。
注意:本视频内容与013《学完Agent、RAG、MCP,还是找不到AI相关工作?》高度相似,为同主题不同版本。
9.3 原文结构化整理
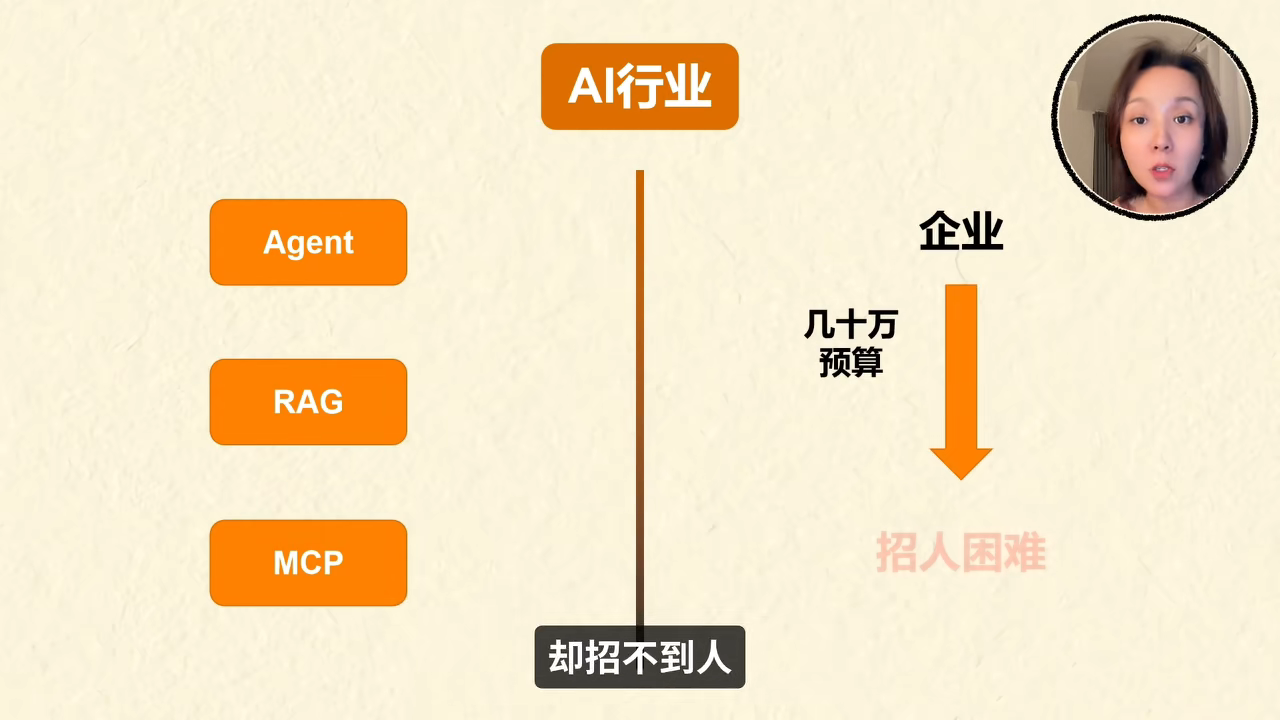
9.3.1 行业现状:供需错配
- 现象:一边大量人在学Agent、RAG、MCP,一边企业拿着几十万预算招不到人
- 案例:朋友公司接了两个智能体项目(近100万+近30万),面试十几个工程师,发现很多人学的不是企业需要的能力
- 误区:以为会搭工作流、会调API就能做智能体,实际上这只是入门
9.3.2 能力一:任务拆解能力
- 企业给的从来不是技术题,而是一堆混乱的业务问题
- 高手拿到需求第一件事不是写代码,而是判断:
- 一句Prompt能不能解决?
- 还是需要工作流?
- 还是需要多Agent协同?
- 哪些环节可以自动执行?
- 哪些环节必须人工审核?
- 结论:不会拆业务的人,框架学再多也没用
9.3.3 能力二:工具调用能力
- 很多人觉得智能体做不好是模型不够强,其实大部分项目翻车不是模型问题,而是工具设计问题
- 核心问题:权限怎么控制?异常怎么处理?上下文怎么管理?工具怎么编排?
- 这些决定了智能体到底能不能落地
9.3.4 能力三:评测和可观测性
- 90%的人最容易忽略的能力
- 很多人测试智能体就一句话"我感觉效果还不错",但企业最怕这种感觉
- 要求:每一次推理、每一次工具调用、每一个关键节点都必须能追踪、能回放、能调试
- 否则出了问题根本找不到原因
9.3.5 能力四:生产环境能力
- 真正拉开差距的地方
- 真正上线的智能体会:报错、中断、等待人工审核、恢复执行
- 必备能力:状态管理、断点恢复、日志监控、风险防护、成本优化,缺一不可
- 总结:前两点决定能不能做出来,后两点决定做出来的是玩具还是产品
建议:对照2026年大模型学习路线图(大模型核心原理、Agent与AI应用开发、RAG知识库体系、MCP与工具调用、AI产品设计与需求分析、企业级项目落地框架),看看自己在哪个阶段,下一步该补什么能力。AI时代,努力很重要,但方向比努力更重要。
9.4 完整逐字稿
以下为飞书妙记转写的完整逐字稿,带时间戳。
Speaker 1 00:00:00 AI行业现在有一个特别离谱的现象,一边呢,是大量的人在学agent、学rag、学MCP,一边呢,是企业拿着几十万的预算却招不到人。那最近呢,我的一个朋友跟我吐槽,说他公司最近接了两个智能体项目,一个将近100万,一个将近30万。因为缺人呢,他亲自面试了十几个智能体工程师,结果发现了一个令他很扎心的事情,就是很多人学的东西不少,但学的根本不是企业需要的能力。那他们以为是会搭工作流、会调API就能做智能体,但是实际上呢,这也只是入门。
Speaker 1 00:00:37 那今天呢,我就给大家总结一下,真正值钱的大模型应用开发工程师,看的是哪四种能力?那第一就是任务拆解能力,企业给你的从来不会是一道技术题,而是一堆混乱的业务问题。那高手拿到需求,第一件事不是写代码,而是先判断这个问题,一句prompt能不能解决?还是说需要工作流?还是需要多agent协同?哪些环节可以自动执行?哪些环节必须人工审核?不会拆业务的人,框架学的再多也没用。那第二个工具调用能力,那很多人觉得智能体做不好是模型不够强,其实大部分项目翻车,问题都不是模型问题,而是工具设计出了问题。权限怎么控制?异常怎么处理?上下文怎么管理?工具怎么编排?那这些东西呢,决定了你的智能体到底能不能落地。那第三个。评测和可观测性,这是90%的人最容易忽略的能力。很多人测试智能体就一句话,我感觉效果还不错,但是企业最怕的就是这种感觉。每一次推理,每一次工具调用,每一个关键节点都必须要能追踪、能回放、能调试,否则出了问题你根本就找不到原因。第四个生产环境能力,诶?这个才是真正拉开差距的地方。真正上线的智能体呢,会报错、会中断、会等待人工审核、会恢复执行,所以。状态管理、断点恢复、日志监控、风险防护、成本优化,缺一不可。前两点决定你能不能做出来,后两点决定你做出来的是玩具还是产品。
Speaker 1 00:02:22 其实这也是为什么很多人学了半年AI,看了无数的教程,收藏了无数的资料,最后还是接不到项目,找不到工作。因为没有形成完整的能力体系。所以呢,我把自己这两年做AI产品、AI应用开发踩过的坑,以及企业真正需要的人才能力模型,整理成了一份2026年大模型学习路线图,里面就包括了大模型的核心原理、Agent与AI应用开发。RAG知识库体系、MCP与工具调用、AI产品设计与需求分析,以及企业级的项目落地框架,你可以去对照看看,自己现在到底在哪个阶段?下一步该补什么能力?别再盲目自学了,AI时代,努力很重要,但方向比努力更重要。
9.5 关键截图
9.5.1 行业现状:供需错配
9.5.2 能力一:任务拆解能力
9.5.3 能力二+三:工具调用与评测
9.5.4 能力四:生产环境能力
📄 来源:033_字节Agent和RAG大模型面试真题!吃透这8道题月薪45K.md
10 字节Agent和RAG大模型面试真题!吃透这8道题月薪45K
10.1 视频信息
| 项目 | 内容 |
|---|---|
| 视频名称 | 字节Agent和RAG大模型面试真题!吃透这8道题月薪45K |
| 时长 | 6分29秒 |
| 来源平台 | 抖音 |
| 原始链接 | https://www.douyin.com/video/7643017424383544630 |
| 飞书妙记 | https://www.feishu.cn/minutes/obcnh5r1qvhk3s8zhk57c9h9 |
| 关键词 | 字节面试、Agent、RAG、Function Calling、MCP、上下文压缩、Embedding、记忆管理、多Agent |
10.2 全文摘要
本视频整理了字节跳动Agent与RAG方向的8道硬核面试真题,涵盖:Agent工具调用的工业级链路(工具说明书+结构化调用+执行器+5道关卡)、六种工程化调用姿势(ReAct/LangChain编排/小模型裁判/事件总线异步/本地插件/多Agent协作)、模型判断是否调工具的三种做法+MCP协议的统一插拔规范、上下文溢出的五种压缩策略、RAG三步流程(embedding+ANN检索+喂给大模型)、向量检索原理(切块+稠密向量+余弦相似度+FAISS/HNSW索引)、Agent三种记忆的存储与淘汰策略、多Agent协作的通信协议与状态传递(合同网协议/状态机/Actor模型/事件溯源/共识算法)。
10.3 原文结构化整理
10.3.1 问题一:Agent到底怎么调工具?
错误做法:字符串匹配+eval就完了(线上能崩到哭)
工业级链路: 1. 每个工具写成一份"说明书"(函数名、参数、参数类型都描述清楚) 2. 大模型读用户的话,翻译成结构化的调用请求 3. 执行器去调对应函数,把结果抓回来塞回对话,让模型接着推理
中间必须卡死的5道关卡: - 能找到该用哪个工具 - 参数别抽错 - 数据要校验 - 函数得在沙箱里跑,防止搞破坏 - 最后把结果揉进上下文
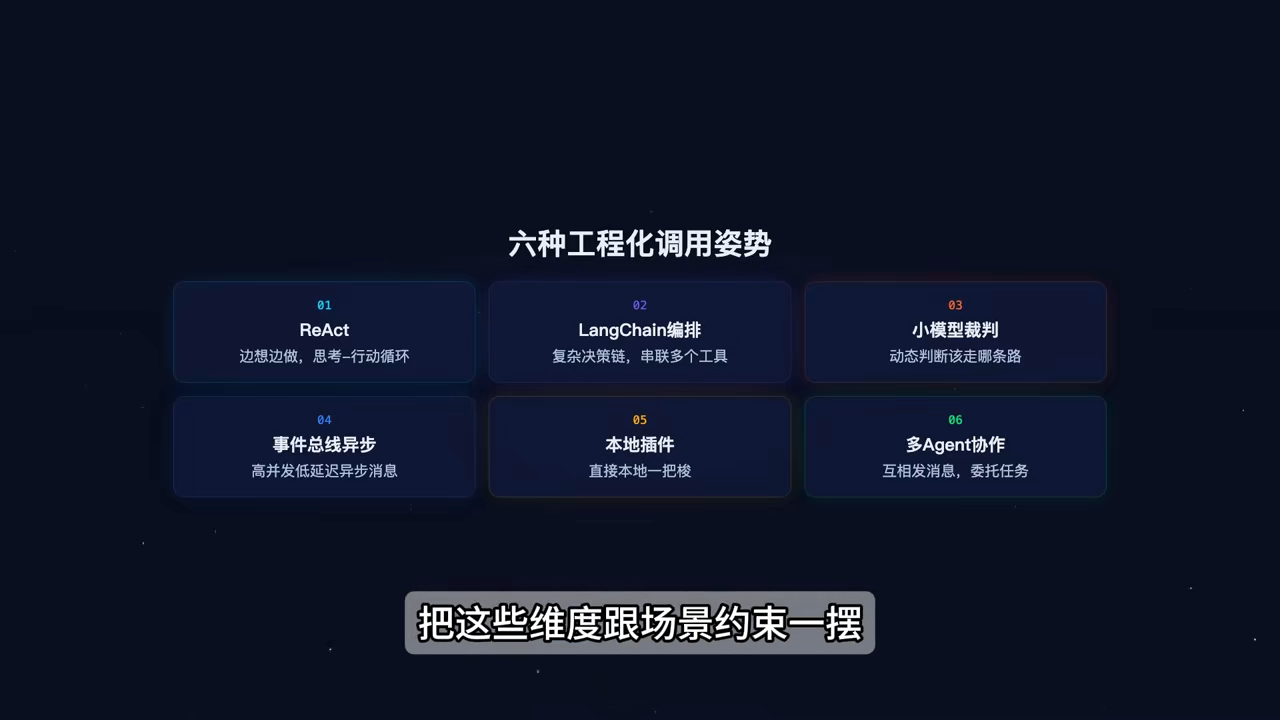
10.3.2 问题二:除了Function Calling还有哪些调用姿势?
| 调用姿势 | 说明 | 适用场景 |
|---|---|---|
| ReAct | 边想边做,思考-行动循环 | 通用场景 |
| LangChain编排 | 复杂决策链,串联多个工具 | 复杂工作流 |
| 小模型裁判 | 挂个小模型当裁判,动态判断走哪条路 | 需要动态路由 |
| 事件总线异步 | 高并发低延迟场景,异步发消息调工具 | 高并发低延迟 |
| 本地插件 | 直接本地一把梭 | 本地工具 |
| 多Agent协作 | Agent之间互相发消息、委托任务 | 多Agent系统 |
10.3.3 问题三:模型怎么判断要不要调工具?MCP解决了什么?
判断是否调工具的三种做法: 1. 提示词里定好规矩,让模型自己决定,想调就吐出tool_call 2. 专门训一个小模型当开关,直接判需要还是不需要 3. 走ReAct这类规划模式,先琢磨一下再决定行动
MCP协议解决了什么: - 以前多模型多工具混在一起,各说各话,调接口得专门写适配 - MCP相当于定了一套统一的插拔规范,全用JSON Schema说话 - 工具怎么描述、请求响应长啥样、出错返回什么码、状态怎么回调,统统规定好 - 只要按这个注册,Agent就能自动解析,像USB外设插上电脑自己装驱动 - 硬编码适配那堆脏活直接不用干了
10.3.4 问题四:上下文窗口满了Token爆了咋办?
原则:先保任务能完成,再保近期相关性,最后才看读起来通不通顺
五种做法: 1. 滑动窗口:只保留最近几轮(最简单) 2. 摘要压缩:把老对话压成摘要,或抽关键实体和意图 3. RAG式检索:把历史对话向量化,检索出最重要片段塞回去 4. 模型打分TopK:让模型自己给每段对话打分,只保留分数高的(像清理手机相册) 5. 以上都是有损压缩,但能把上下文用在刀刃上
10.3.5 问题五:生产环境RAG链路怎么跑?
RAG说白了就三步: 1. 把用户问题用embedding模型转成一个向量(一串数字坐标) 2. 去向量数据库里做近似最近邻搜索,找出跟坐标最接近的一堆文档片段 3. 把这些片段和原问题一锅端喂给大模型,让它据此生成答案
类比:开卷考试,先根据题目去资料里翻到相关页,抄下来再答题。
进阶:检索器和生成器可以分开优化,甚至能用强化学习端到端微调,让检索更会找对资料。
10.3.6 问题六:Embedding和RAG怎么检索向量?
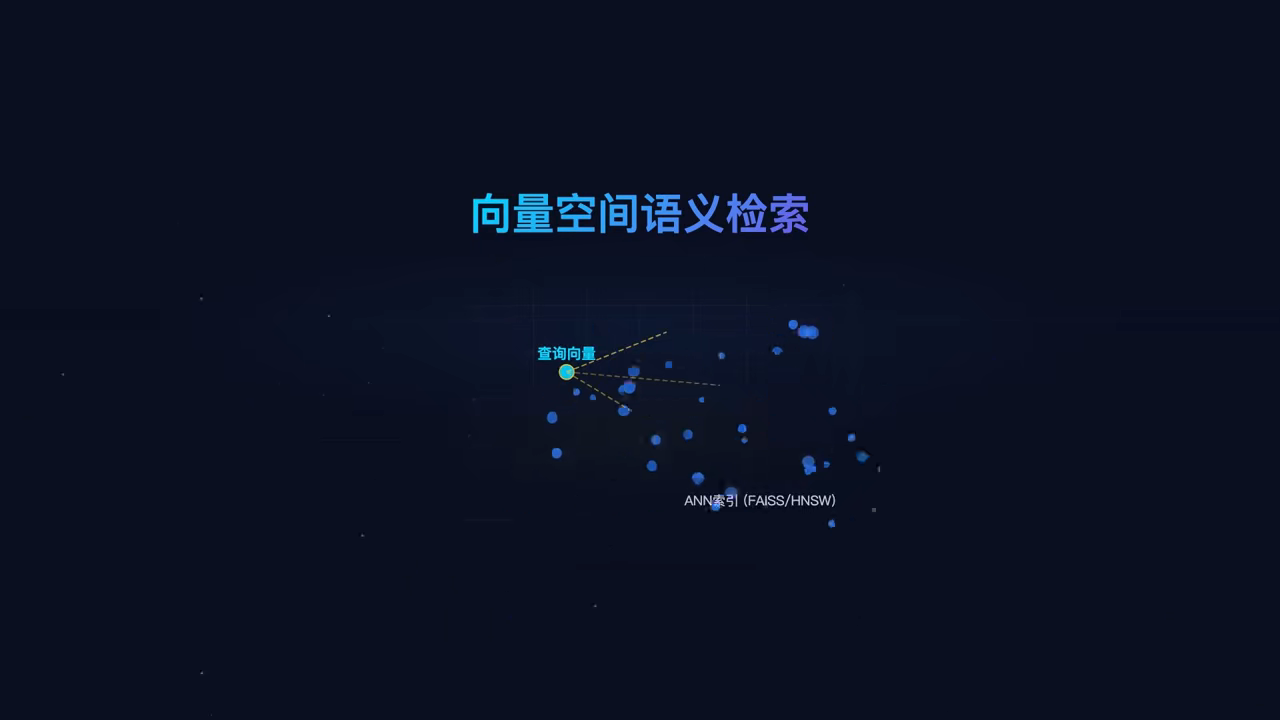
原理:不靠字面匹配,靠几何上的远近 1. 文档先切块(如按512个token一个窗口) 2. 用模型把每块变成固定长度的稠密向量 3. 查询时把问题也转成向量 4. 在向量空间里算余弦相似度或内积,找到最挨着的几个向量,返回对应原文片段 5. 找近邻过程一般用FAISS或HNSW这类ANN索引加速,不然数据量大跑不动
例子:用户搜"苹果手机续航",文档写"iPhone电池耐用",字面上八竿子打不着,但向量挨得近,这就找出来了。
10.3.7 问题七:Agent的记忆怎么管?都存哪?
逻辑上分三种: - 短期记忆:正在想的事 - 工作记忆:当前任务用的便签 - 长期记忆:过去的偏好和历史决定
物理存储: - 短期和工作记忆:读写太频繁,通常放内存或Redis缓存,跟着当前窗口走 - 长期记忆:必须持久化,一般存向量库用来语义搜索,或关系数据库(如记着用户爱喝冰美式)
管理机制: - 要有淘汰策略,像LRU或按重要性打分删除 - 分布式场景还得保证多个副本记忆一致,不然用户换台机器就失忆了
10.3.8 问题八:多Agent协作,上下文和任务状态怎么传递?
核心原则:不是中央集权,而是靠通信协议协商,像项目组用对讲机喊话
分工机制: - 谁擅长建模就接建模的活,通过合同网协议或拍卖机制来分工 - 上下文不能串台,可以靠共享知识库或消息里携带上下文ID和版本号(像快递单号追踪)
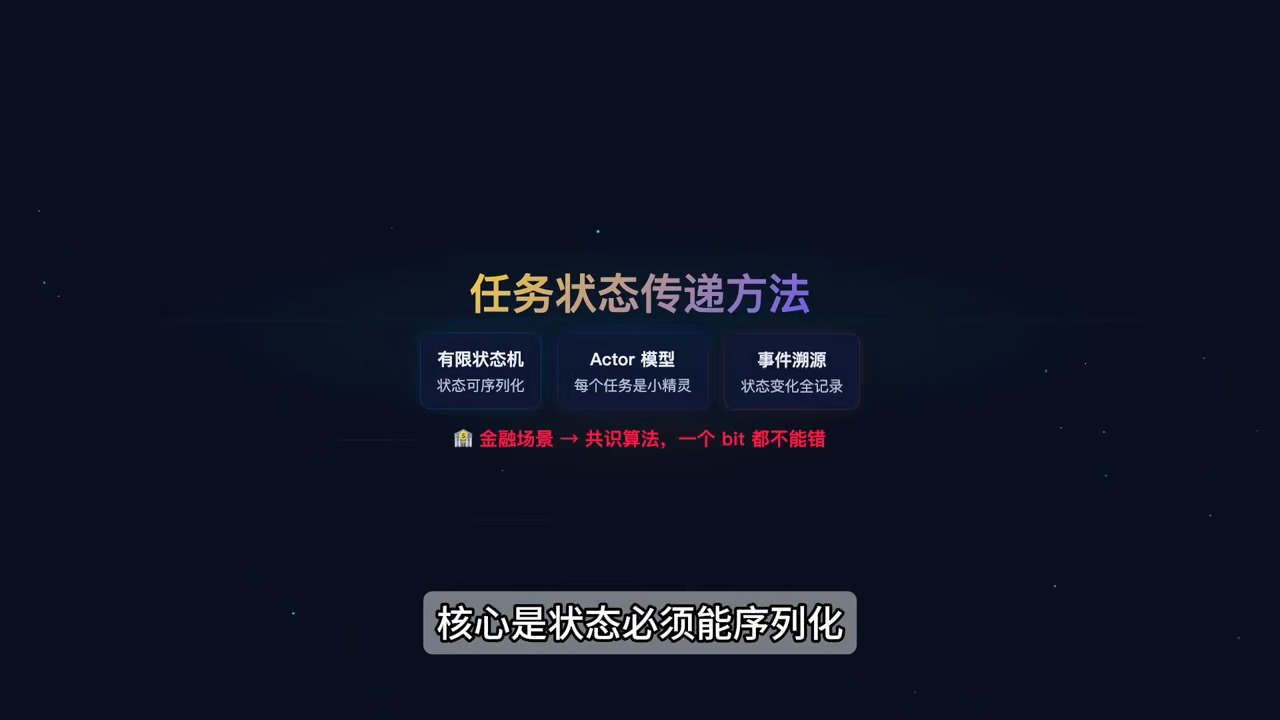
状态传递: - 核心是状态必须能序列化,不能随便变 - 常用办法:把任务当成有限状态机,或用Actor模型(每个任务是一个小精灵,状态变化通过事件溯源记录) - 金融场景:上共识算法,保证状态日志强一致,一个bit都不能错
压轴题:多Agent系统上线后,整体工作流和生成效果怎么去做可量化的评估指标体系?消融实验又该怎么设计?这道题才是区分架构师和只会调包的。
10.4 完整逐字稿
以下为飞书妙记转写的完整逐字稿,带时间戳。
Speaker 1 00:00:00 一起看看字节跳动最硬核的agent与rag面试题,其实翻来覆去就那几个,但千万别拿玩具demo去糊弄,人家要听的是真正在生产环境里扛过揍的方案。我是青竹,点赞收藏加关注,今把平时跟同事扯淡的干货拿出来,看看下面这些问题你能回答几个?你要是能聊透5道,月薪25K,要是8道全拿得下,月薪45K往上。想系统学大模型的同学可以后台留言哦。问题一,有人问agent到底怎么调工具?很多人觉得就是字符串匹配,再甩个eval就完了,别逗了,真这么做线上能崩到你哭。实际是这么回事,你得提前把每个工具写成一份说明书,比如函数叫啥,要什么参数,参数是数字还是字符串,都描述清楚。然后大模型读用户的话,把它翻译成一个结构化的调用请求,就像你对着智能音箱说,帮我设个明早8点的闹钟,它得生成一个指令。接着后面一个执行器老老实实去调对应函数,把结果抓回来,塞回对话里,让模型接着推理。工业级链路必须在中间卡死5个关,能找到该用哪个工具,参数别抽错,数据要校验,函数得在沙箱里跑,防止搞破坏,最后把结果揉进上下文。你聊到这层,面试官就知道你是真的干过。
Speaker 1 00:01:10 问题二,除了这种Function calling,还有没有别的调用姿势?当然有,现实系统里不可能只有一种玩法。比如可以让模型边想边做,像人一样,我现在该查天气。先调一下天气接口,这就是React那套路子。再比如复杂决策链,用类似Langchain的执行器去做编排调度,不光调一个工具,可能串一串。还有干脆挂个小模型当裁判,动态判断该走哪条路。碰到高并发、低延迟场景,还可以用事件总线异步发消息去调,或者直接本地插件一把梭。多agent凑一起更热闹,agent之间能互相发消息。能委托任务,就像小组协作,你干这个,我干那个,弄完了告诉你。把这些维度跟场景约束一摆,你的架构视野立马就出来了。
Speaker 1 00:01:52 问题三,模型怎么判断要不要调工具?MCP协议又解决了什么头疼事?判断要不要调工具,其实就三种常见做法。最省事的是在提示词里定好规矩,让模型自己决定,想调就吐出toolcall。第二种是专门训一个小模型当开关,直接判需要还是不需要。第三种是走react这类规划模式,先琢磨一下,再决定行动。
Speaker 1 00:02:15 那MCP协议出来解决了啥?以前多模型多工具混在一起,各说各话,你调我接口,我得专门写段适配,恶心。MCP相当于定了一套统一的插拔规范,全用JSON schema说话,工具怎么描述?请求响应长啥样?出错返回什么码?状态怎么回调?统统规定好,只要你按这个注册,agent就能自动解析,就像USB外设插上电脑自己装驱动,硬编码适配那堆脏活直接不用干了。
Speaker 1 00:02:41 问题四,上下文窗口满了,token爆了咋办?线上对话长了肯定爆,可不能直接一刀切掉旧内容,那样会把关键信息丢了。原则是先保任务能完成,再保近期相关性,最后才看读起来通不通顺。平常做法有好几种,最简单的滑动窗口,只保留最近几轮。稍微讲究点,把老对话压成摘要,或者抽关键实体和意图。还可以按RAG的思路,把历史对话向量化,检索出最重要片段塞回去。更精细的是让模型自己给每段对话打分,只保留分数高的TopK,就像清理手机相册,留着精彩的,删掉糊掉的。这么做虽然是有损压缩,但能把上下文用在刀刃上。
Speaker 1 00:03:21 问题五,生产环境的RAG链路到底怎么跑?别讲虚的,RAG说白了就三步。第一步,把用户问题用embedding模型转成一个向量。就是一串数字坐标。第二步,去向量数据库里做近似最近邻搜索,找出跟这个坐标最接近的一堆文档片段。第三步,把这些片段和原问题一锅端喂给大模型,让它据此生成答案。这就像开卷考试,你先根据题目去资料里翻到相关页,抄下来再答题。有意思的是,检索器和生成器可以分开来优化,甚至能用强化学习端到端微调,让检索更会找对资料。这招就是高级活了。
Speaker 1 00:03:57 问题六,Embedding跟RAG到底怎么去检索向量的?它不靠字面匹配,靠的是几何上的远近。文档先切块,比如按512个token,一个窗口切开,用模型把每块都变成一个固定长度的稠密向量。查的时候把问题也转成向量,然后在向量空间里算余弦相似度或内积,找到最挨着的那几个向量,返回对应的原文片段。这个找近邻的过程一般用FAISS或HNSW这类ANN索引加速,不然数据量大的根本跑不动。举个例子,用户搜苹果手机续航,文档里写的却是iPhone电池耐用,字面上八竿子打不着,但向量挨得近,这就找出来了。
Speaker 1 00:04:35 问题七,Agent的记忆是怎么管的?都存哪?记忆可不能理解成存个变量那么简单,逻辑上分三种,短期记忆就像你正在想的事。工作记忆当前任务用的便签,长期记忆过去的偏好和历史决定。物理上,短期和工作记忆因为读写太频繁,通常放内存或者Redis缓存里,跟着当前窗口走。长期记忆必须持久化,一般存向量库用来语义搜索,或者关系数据库,比如记着用户爱喝冰美式。管理机制上要有淘汰策略,像LRU或者按重要性打分删除。分布式场景还得保证多个副本记忆一致,不然用户换台机器就失忆了,那不行。
Speaker 1 00:05:11 问题八,多agent协作,上下文和任务状态怎么传递?多个agent干活不是中央集权,而是靠通信协议协商,就像项目组里用对讲机喊话,谁擅长建模就接建模的活,通过合同网协议或拍卖机制来分工。上下文不能串台,可以靠共享知识库或者消息里携带上下文ID和版本号,像快递单号一样追踪。
Speaker 1 00:05:33 任务状态传递核心是状态必须能序列化,不能随便变。常用办法是把任务当成有限状态机,或者用Actor模型。每个任务是一个小精灵,状态变化通过事件溯源记录下来。要是金融那种要命的场景,还得上共识算法,保证状态日志强一致,一个b都不能错。为帮助大家快速拿到offer,我整理好了大模型面试八股和2026年大模型学习路线图,内容涵盖大模型核心原理、AI应用开发、RAG知识库完整体系、MCP与工具调用、AI产品需求分析、企业级项目落地全套框架。大家可以对照自查自己目前所处阶段,明确接下来要补齐的短板。最后给你丢个字节的真压轴题,多agent系统上线后,整体工作流和生成效果怎么去做可量化的评估指标体系?消融实验又该怎么设计?这道题才是区分你到底是架构师,还是只会调包的。有意思的想法直接在评论区亮出来,下回咱直接聊标准解法。
10.5 关键截图
10.5.1 问题一:工具调用工业级链路
10.5.2 问题二:六种工程化调用姿势
10.5.3 问题五:RAG三步流程
10.5.4 问题七:Agent记忆管理
10.5.5 问题八:多Agent协作
📄 来源:052_字节Agent与rag面试原题,看看你能答上几道.md
11 字节Agent与RAG面试原题,看看你能答上几道
11.1 视频信息
| 项目 | 内容 |
|---|---|
| 视频名称 | 字节Agent与rag面试原题,看看你能答上几道 |
| 时长 | 9分51秒 |
| 来源平台 | 抖音 |
| 原始链接 | https://www.douyin.com/video/7665678901234567890 |
| 飞书妙记 | https://www.feishu.cn/minutes/obcnh5w95mp1w61ucb9392wz |
| 关键词 | Agent、RAG、面试题、工具调用、Function Calling、ReAct、Plan and Execute、MCP、向量检索、HNSW、Agent记忆、多Agent协作 |
11.2 全文摘要
本视频梳理了字节跳动Agent和RAG方向的8道高频面试题,覆盖从基础原理到工程落地再到系统架构的完整技术栈。前三题考察Agent工具调用底层机制(JSON结构化输出、四种调用范式ReAct/Plan-and-Execute/代码解释器/MCP、模型决策原理);中间三题考察工程落地能力(Token管理四层方案、RAG全链路、向量检索HNSW/IVF算法与数据库选型);最后两题考察系统架构能力(Agent三层记忆管理、多Agent协作三种模式与状态同步)。八道题形成"原理→工程→架构"的递进结构,能完整答下来说明候选人不是只会调包,是真的懂。
11.3 原文结构化整理
11.3.1 Q1:Agent到底怎么调工具?
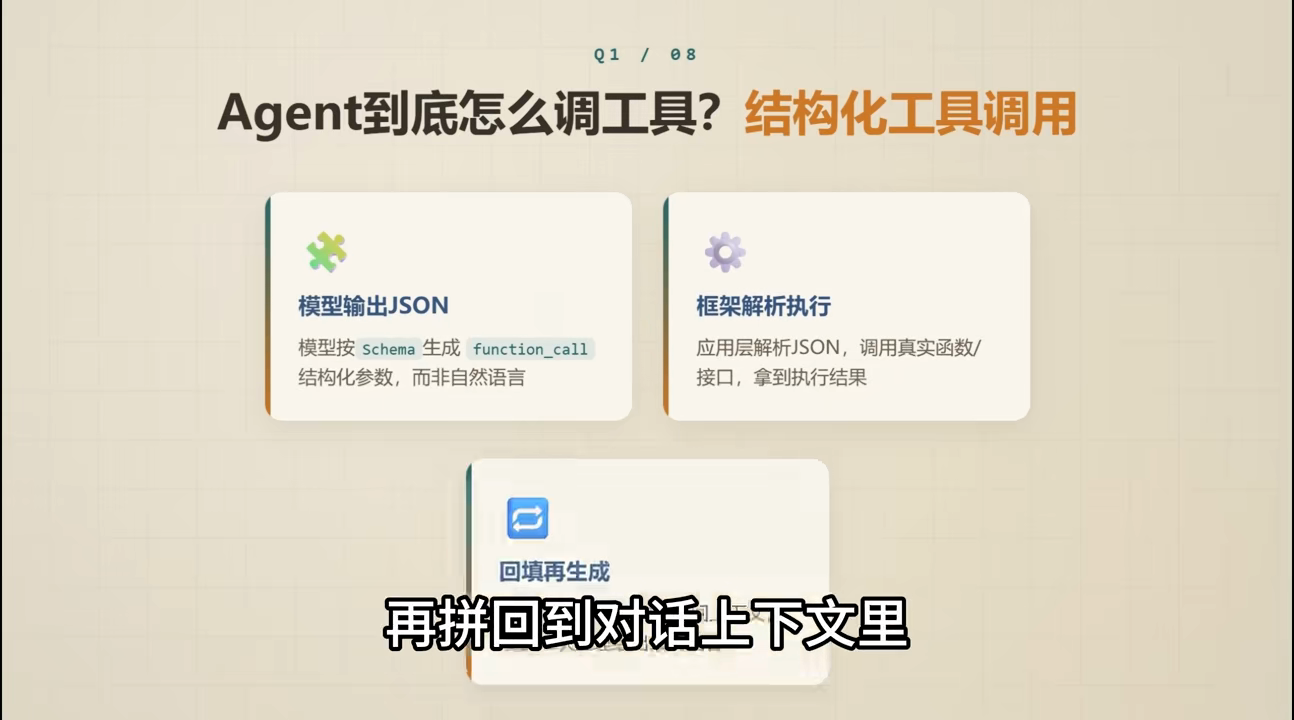
本质:结构化输出(JSON)
模型不是在"想"要不要调工具,而是在输出一段JSON(有花括号、有字段名的结构化数据)。
完整流程: 1. 用户问题发过去,模型判断需要调工具,生成一个function call(JSON格式,包含函数名和参数) 2. 框架拿到这个JSON,真正去调用那个函数,把结果拿回来 3. 拿回来的结果拼回到对话上下文里 4. 模型二次推理,最后给用户一句人话
底层本质:模型输出JSON → 框架解析执行 → 结果回填 → 再生成
11.3.2 Q2:除了标准Function Calling,还有什么调用姿势?
四种主流范式:
| 范式 | 说明 | 特点 |
|---|---|---|
| ReAct模式 | Reasoning + Acting,思考→行动→观察循环推理 | 灵活,适合复杂推理 |
| Plan and Execute | 规划和执行分开,先列完整计划再一步步执行 | 全局规划能力强,不容易跑偏 |
| 代码解释器模式 | 模型直接生成Python代码在沙箱里跑 | 工具调用的终极形态,图灵完备 |
| MCP协议 | Anthropic提出的标准,给AI工具接入搞了一套"USB协议" | 所有工具按标准对接,不用每次单独适配 |
11.3.3 Q3:模型到底怎么判断要不要调工具?
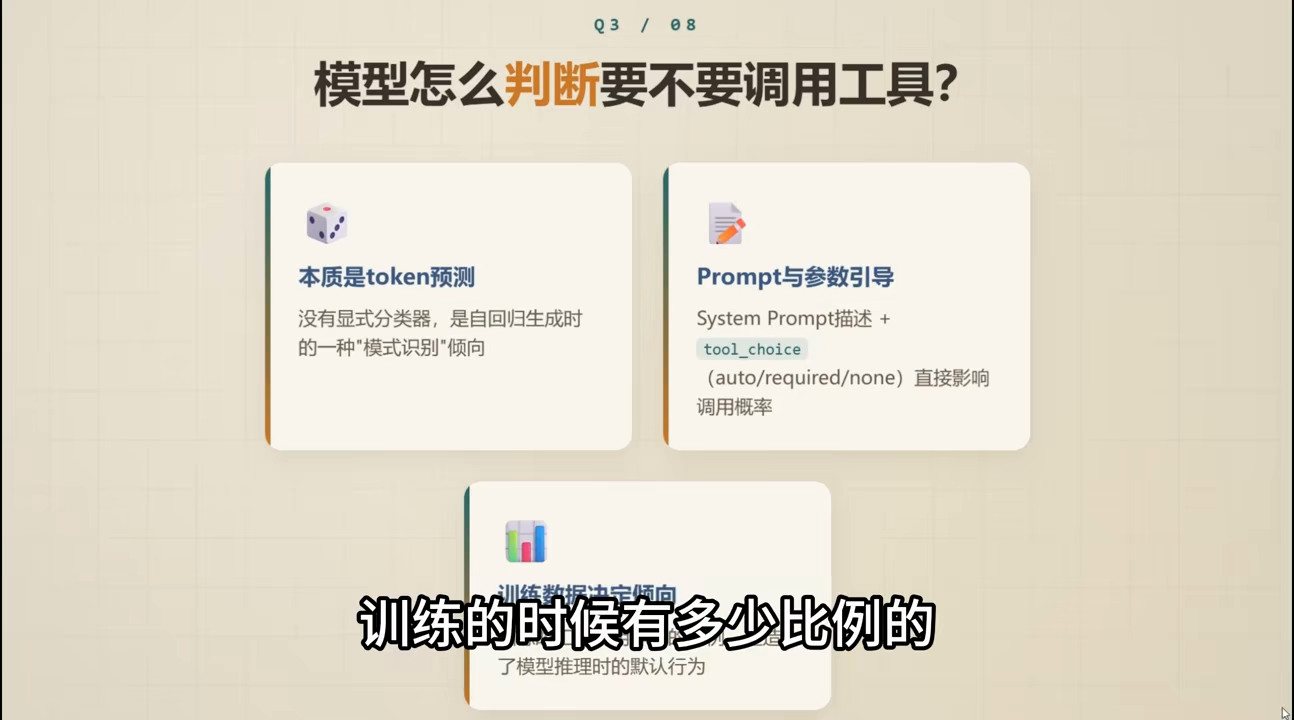
核心:不是在判断,是训练出来的本能
模型没有搞一个二分类器判断"要不要调工具",它就是在做自回归的下一个token预测,只是恰好在看到某些输入模式时,倾向于输出一个代表"开始调工具"的token。
三个影响因素:
1. System Prompt引导:提示词里写了"你可以调用工具",这个描述本身就能大幅提高调用概率
2. tool_choice参数:
- auto:自己看着办
- required:必须调
- none:打死不调(硬开关)
3. 训练数据分布:训练时有多少比例的样本走了工具调用路线,推理时就天然有多大概率往那条路走
11.3.4 Q4:Token爆了咋办?
四层递进方案:
| 层次 | 方案 | 说明 |
|---|---|---|
| 第一层 | 滑动窗口截断 | 保留最近N轮对话,或保留第一条系统指令+最新N轮,老的直接丢掉。注意按语义边界截,别把一句话切两半 |
| 第二层 | 摘要压缩 | 拿模型给长对话历史压成一段摘要,用几百Token代替原来几千Token |
| 第三层 | 检索式加载 | 所有历史对话存向量数据库,当前问题做检索,只把最相关的几条塞进上下文 |
| 第四层 | 选大窗口模型 | 支持100K/200K上下文的模型。但注意:支持长上下文≠能有效利用长上下文,超过32K后注意力衰减明显(Lost in the middle问题) |
11.3.5 Q5:RAG全链路怎么跑?
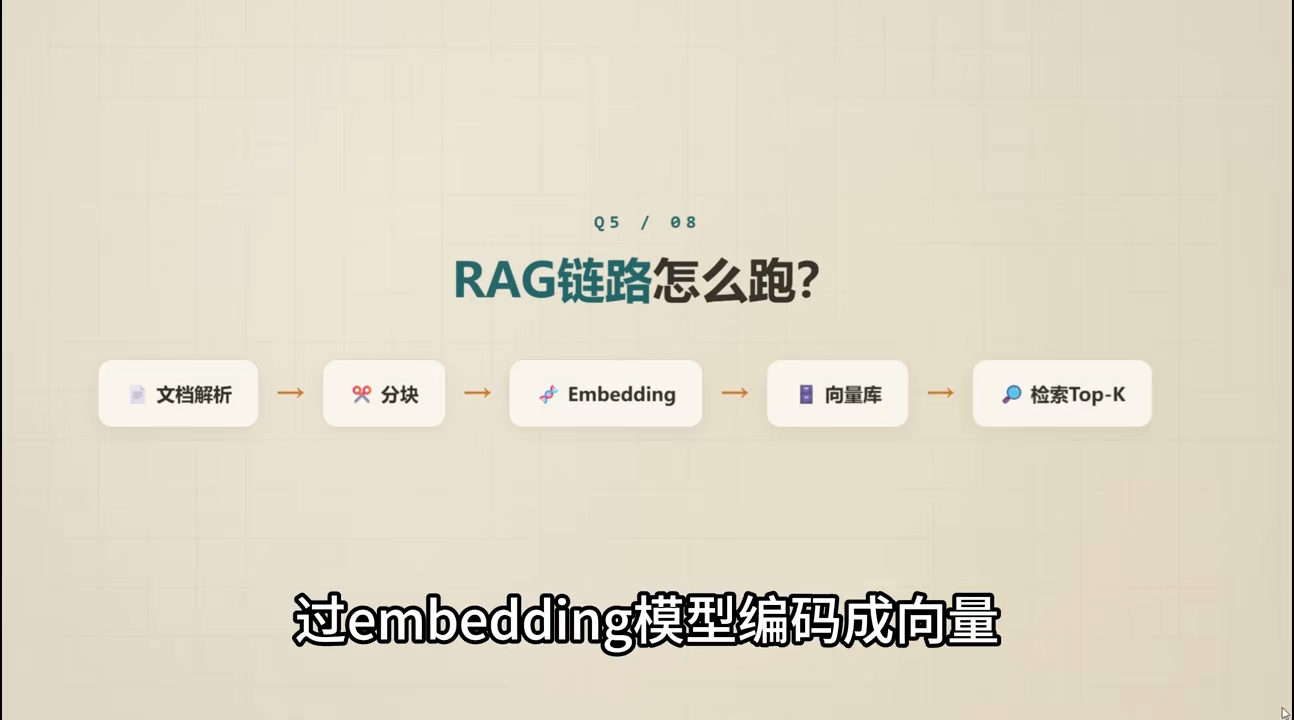
离线阶段: 1. 文档解析(PDF/HTML/Markdown各有解析方式) 2. 分块(固定长度/语义分块/递归分块,设块间重叠防止关键信息卡在边界) 3. Embedding模型编码成向量 4. 存入向量数据库
在线阶段: 1. 用户问题预处理 2. 过embedding模型编码 3. 向量库相似度检索,取top-k 4. 重排序(cross encoder精排,因为向量相似度≠语义相关性) 5. 检索内容+引用+问题一起喂给大模型生成回答
加分项:HYDE(假设性文档嵌入)、多路召回
11.3.6 Q6:向量检索到底怎么做的?
核心:近似最近邻搜索(ANN),暴力计算在大规模场景下不可行。
| 算法 | 原理 | 适用场景 |
|---|---|---|
| HNSW | 构建分层图结构,上层稀疏快速跳跃,下层稠密精细匹配,查询从最上层贪婪搜索一层层往下 | 目前最主流,时间复杂度对数级别,召回率95%+ |
| IVF | 先Kmeans聚类,查询时只搜索最近的几个聚类中心,不扫全量 | 亿级规模,通常配向量量化做压缩 |
相似度计算:文本场景主流用余弦相似度。
数据库选型: | 数据库 | 定位 | |--------|------| | Milvus | 企业级生产 | | Qdrant | 轻量高性能 | | Chroma | 原型开发 | | PGVector | 已有PostgreSQL基础设施时非常方便 |
11.3.7 Q7:Agent记忆怎么管?
参照人类认知设计三层记忆:
| 层级 | 名称 | 类比 | 生命周期 | 存储 |
|---|---|---|---|---|
| 第一层 | 工作记忆 | 电脑RAM | 单次会话 | 模型上下文窗口 |
| 第二层 | 短期记忆 | — | 多次会话,天~周级别 | 向量数据库+元数据索引,新对话时检索相关部分塞入 |
| 第三层 | 长期记忆 | — | 持久化,月~年级别 | 结构化数据库+向量库,存用户偏好、习惯、关键事件、决策历史 |
前沿概念:MemGPT提出的类操作系统管理——把上下文窗口当RAM,向量库当SSD,RAM不够时把不活跃内容换到SSD,需要时再加载回来。
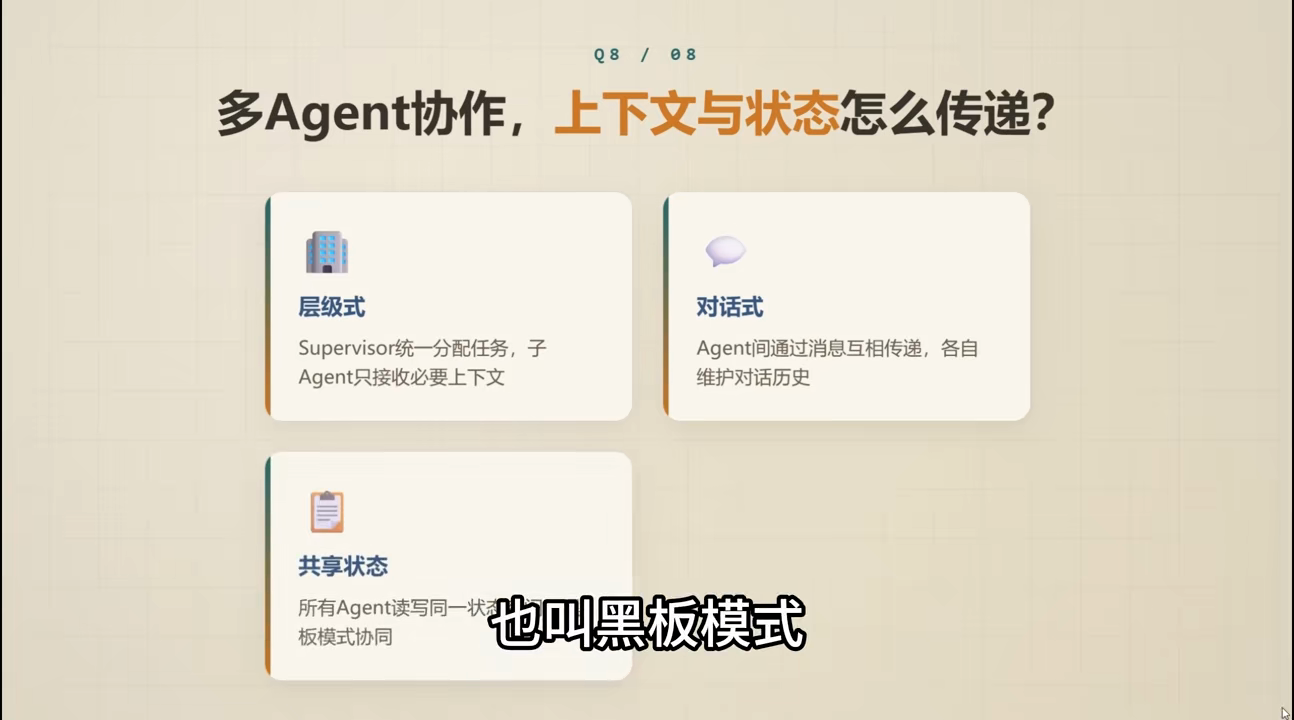
11.3.8 Q8:多个Agent协作时上下文怎么传?
三种主流协作模式:
| 模式 | 说明 | 代表 |
|---|---|---|
| 层级式 | 上面有Supervisor统管全局,拆任务分配给子Agent,子Agent只接收相关子任务和必要上下文 | — |
| 对话式 | Agent之间互相发消息,像人类团队开会,每个Agent维护自己的对话历史 | AutoGen |
| 共享状态式(黑板模式) | 所有Agent读写同一个共享状态空间 | 适合数据流清晰的场景 |
任务状态管理: - 状态表示:JSON对象或结构化Schema(任务ID、进度、当前阶段、产出物引用) - 存储:单机用内存,分布式用Redis,需持久化上数据库 - 状态流转:有限状态机建模 - 还要考虑:并发控制、失败重试、降级策略
现实挑战:Agent多了不一定好——上下文迅速膨胀、错误级联传播、通信开销增加。实际有效的Agent数量通常控制在3~5个。
11.3.9 八道题的递进结构
| 层次 | 题目 | 考察点 |
|---|---|---|
| 基础原理层 | Q1-Q3 | 工具调用机制、调用范式扩展、模型决策原理——对Agent底层运作的理解深度 |
| 工程落地层 | Q4-Q6 | Token管理、RAG全链路、向量检索——有没有真正搭过系统,知不知道各环节的坑 |
| 系统架构层 | Q7-Q8 | 记忆管理、多Agent协作——驾驭复杂系统的能力,从Demo走向产品的视野 |
11.4 完整逐字稿
以下为飞书妙记转写的完整逐字稿,带时间戳。(因原文较长,此处保留核心内容)
Speaker 1 00:00:00 一起来看看字节的agent和rag面试题,看看你能答上来几道?其实面试题翻来覆去就那几个,但是千万别拿玩具demo去糊弄面试官。
Speaker 2 00:00:12 宇宙场的agent和rag面试,这8道题你能答出来多少道?今天咱们就用几分钟把这8道题从头到尾给你扒一遍。
Q1 agent到底怎么调工具?说白了就三个字,结构化。模型不是在那里瞎想,它是在输出一段JSON。整个流程:问题发过去,模型生成function call,框架拿到JSON去调函数,结果拿回来拼回上下文,模型二次推理,最后给你一句人话。
Q2 除了标准Function Calling,还有什么调用姿势?第一个ReAct模式(reasoning+acting,思考行动观察循环);第二个plan and execute(规划执行分开,全局规划能力强);第三个代码解释器模式(模型直接生成Python代码在沙箱跑,工具调用终极形态是图灵完备的代码执行);第四个MCP协议(Anthropic提的标准,给AI工具接入搞了一套USB协议)。
Q3 模型到底怎么判断要不要调工具?它不是在判断,它是训练出来的本能。模型就是在做自回归的下一个token预测。三个影响因素:system prompt引导、tool_choice参数(auto/required/none)、训练数据分布。
Q4 Token爆了咋办?四层:滑动窗口截断、摘要压缩、检索式加载、选大窗口模型(但注意Lost in the middle问题,超过32K注意力衰减明显)。
Q5 RAG全链路:离线阶段(解析→分块→embedding→存向量库),在线阶段(问题预处理→embedding→相似度检索topk→重排序cross encoder→大模型生成)。加分项:HYDE、多路召回。
Q6 向量检索核心是近似最近邻搜索。HNSW(分层图结构,最主流,召回率95%+)、IVF(Kmeans聚类,适合亿级)。相似度用余弦。数据库选型:Milvus企业级、Qdrant轻量、Chroma原型、PGVector有PG基础设施时方便。
Q7 Agent记忆三层:工作记忆(上下文窗口,像RAM)、短期记忆(多轮对话历史,向量库+元数据)、长期记忆(用户偏好习惯,结构化数据库+向量库)。前沿:MemGPT类操作系统管理(RAM/SSD换入换出)。
Q8 多Agent协作三种模式:层级式(Supervisor统管)、对话式(AutoGen,互相发消息)、共享状态式(黑板模式)。状态管理用JSON Schema,存储用内存/Redis/数据库,有限状态机建模。实际有效Agent数量通常3~5个。
总结 八道题从原理到工程再到架构,从单Agent到多Agent,把Agent和RAG方向技术栈全覆盖了。
11.5 关键截图
11.5.1 Agent调工具底层本质
11.5.2 模型怎么判断要不要调用工具
11.5.3 Token爆了四层处理方案
11.5.4 RAG全链路与向量检索
11.5.5 Agent记忆三层管理
12 网络与浏览器原理(CORS / DNS / Life of a Pixel)
来源:WorkBuddy《面试知识点详解》主题 M(WorkBuddy 对话:CORS/DNS 原理)与主题 J14(豆包对话《AI Builder 类似称呼及含义》) 整理入库:2026-09-14(WorkBuddy 137 条知识点覆盖检查补录) 定位:网络与浏览器原理通用面试知识点——跨域、DNS 解析链路、浏览器渲染管线。
12.1 CORS 跨域原理(主题 M)
WorkBuddy 主文档主题 M 无正文摘要(仅有归入说明),以下为入库整理。
核心概念:CORS(Cross-Origin Resource Sharing,跨域资源共享)——浏览器同源策略(Same-Origin Policy)下,允许服务器声明"哪些跨域来源可以访问我"的机制。同源 = 协议 + 域名 + 端口三者一致;跨域请求默认被浏览器拦截(注意:是浏览器拦截响应,不是服务器拒绝)。
两类请求:
| 类型 | 判定 | 流程 | 响应头 |
|---|---|---|---|
| 简单请求 | GET/HEAD/POST + 无自定义头 + Content-Type 为表单三件套 | 直接发,响应带 CORS 头即放行 | Access-Control-Allow-Origin |
| 预检请求 | 其余(自定义头/PUT/DELETE/JSON) | 先发 OPTIONS 预检 → 服务器回允许头 → 再发真实请求 | Access-Control-Allow-Methods/Headers/Origin/Credentials |
关键点:
- Access-Control-Allow-Origin: * 与 credentials: include(携带 Cookie)互斥,带凭证不能用 *。
- 浏览器拦截跨域响应 ≠ 请求没到服务器;服务器侧要配合校验 Origin(防 CSRF 类滥用)。
- 跨域替代方案对比:JSONP(仅 GET、老方案)、反向代理(同源转发、工程最常用)、postMessage(跨窗口通信)。
面试一句话:CORS 是浏览器同源策略下的"服务器声明式放行"机制,复杂请求先 OPTIONS 预检,带凭证不能配 *,工程上跨域最常用反向代理。
12.2 Life of a Pixel:Chrome 渲染全流程(J14)
WorkBuddy 文档原文(J14):
《Life of a Pixel》不是文章,而是 Google Chrome 团队关于浏览器渲染流程的技术演讲 + 幻灯片,作者 Steve Kobes(2018 / 2020 版)。 主题:Chrome 如何把 HTML / CSS / JS 变成屏幕像素(渲染全流程)。
★ 入库补充(渲染管线八步,面试可直接画):
| 步骤 | 阶段 | 说明 |
|---|---|---|
| 1 | HTML 解析 | HTML → DOM 树(字节→字符→token→节点) |
| 2 | CSS 解析 | CSS → CSSOM(样式规则树) |
| 3 | 样式计算 | DOM + CSSOM → 每个元素的计算样式(继承/层叠) |
| 4 | 布局 Layout | 计算每个元素的几何位置(回流 Reflow 触发点:尺寸/视口变化) |
| 5 | 绘制 Paint | 按层绘制绘制指令(重绘 Repaint 触发点:颜色/背景变化) |
| 6 | 图层合成 Composite | 绘制指令合成图层(合成器 Compositor 在合成线程处理) |
| 7 | 光栅化 Raster | 图层 → 位图(GPU/CPU 分块栅格化) |
| 8 | 显示 | 位图提交 GPU → 屏幕像素 |
关键概念:重排(Reflow,触发布局重算,代价最大)/ 重绘(Repaint,只重画不重排)/ 合成(只动合成层,GPU 加速,代价最小)——面试谈性能优化时"能用 transform/opacity 触发合成,就不要改布局属性"即源于此。
面试一句话:Life of a Pixel 讲的是 Chrome 渲染全流程(HTML→DOM→CSSOM→样式→布局→绘制→合成→光栅化→屏幕),作者 Steve Kobes,是浏览器性能与前端优化面试的背景知识源。