005:容灾止损专项(SRE 稳定性工程・容灾体系・事故响应)
容灾止损专项(变更 / 监控 / 容灾三板斧・容灾等级与双活・混沌工程与演练・电商大促容灾・前端与 APP 端容灾・事故响应与复盘・14 篇行业实践精读)
体系定位:容灾止损专项(变更 / 监控 / 容灾三板斧・容灾等级与双活・混沌工程与演练・电商大促容灾・前端与 APP 端容灾・事故响应与复盘・14 篇行业实践精读) 来源文件数:16(原 005 拆分后保留容灾主体:13 个容灾小节 + 事故响应手册第 8 节 + 14 篇 QCon/行业大会 PDF 精读) 本章节数:3 大章(SRE 稳定性工程·容灾专项 / 事故响应手册·第 8 节容灾与止损 / 附录·14 篇行业实践精读)
📑 目录
- 1 SRE 稳定性工程:容灾专项(等级 / 混沌 / 大促 / 演练 / 前端 APP 容灾 / DNS / HTTPDNS / GTM / 网络架构 / 实践全景)【2026-09-09 补充】
- 1.1 容灾等级体系深挖:从冷备到双活(SHARE 78 / GB/T 20988 / 同城双活 / 两地三中心 / RPO=0)【2026-09-09 补充】
- 1.2 混沌工程:用故障演练量化验证三板斧【2026-09-09 补充】
- 1.3 容灾专项建设开展思路:盘家底 → 前端 / 后端分层防御 → 演练闭环【2026-09-09 补充】
- 1.4 电商大促容灾设计:秒杀 / 春节红包的分层削峰与预案体系【2026-09-09 补充】
- 1.5 容灾演练 vs 异常测试:异同点与区分方法【2026-09-09 补充】
- 1.6 前端与 APP 端容灾:域名 / CDN / 公网 / 内网 / 自研七层网关【2026-09-09 补充】
- 1.7 字节 APP 端 TNC 容灾组件:端云协同的云控容灾【2026-09-09 补充】
- 1.8 域名机房容灾:CNAME + GTM 智能解析的机制与边界【2026-09-09 补充】
- 1.9 HTTPDNS + 客户端拨测:机制与应用实践【2026-09-09 补充】
- 1.10 HTTPDNS vs Local DNS vs 传统 DNS:区别、优缺点与容灾选型【2026-09-09 补充】
- 1.11 网络架构基础概念:公网 / 内网 / 骨干网 / 公网 IP / 机房电力容灾(UPS)【2026-09-09 补充】
- 1.12 GTM 功能与 CDN/DNS 容灾实现【2026-09-09 补充】
- 1.13 容灾建设实践全景:9 大方向的核心理念(内部资料整理)【2026-09-09 补充】
- 2 SRE 事故响应与容灾止损 —— 面试知识手册(第 8 节:容灾与止损·架构防御措施全景)
- 2.1 容灾与止损:架构防御措施全景
- 3 附录:14 篇容灾稳定性行业实践文档精读(QCon / 行业大会 PDF)【2026-09-09 补充】
- 3.1 郭勇良《复杂业务场景下 RCA Agent 的探索实践》(快手,RCA Agent 从 0 到 1)
- 3.2 王硕《快手 AI 研发数字员工平台:从局部 AI 提效到全局 AI 提效》
- 3.3 鲜嘉麒《从人工到 AI 驱动:快手广告流量全链路可观测实践》
- 3.4 薛春雨《银行核心系统多活架构实践》(神州信息・新动力)
- 3.5 李翠霞《自建数字化交易平台提升研发效能》(汇丰科技)
- 3.6 付冰尧《米家故障应急保障体系实战:稳中求胜的构建之道》(小米)
- 3.7 刘凯宁《蚂蚁故障应急全流程体系构建及应用实践》
- 3.8 刘向阳《系统稳定与信息安全 —— 体系建设与实战经验》(美的 CISO)
- 3.9 刘昊《B 站轻量级容灾演练体系构建与业务实践》
- 3.10 艾瑞坤《基于 LLM 实现的线上项目自我修复与智能容灾的原理与实践》
- 3.11 季敏《下一代微服务架构的实践与探索》(阿里云,Seata 发起人)
- 3.12 赵威《Android WPS 十年架构演进》(金山办公)
- 3.13 刘一凡《快手全链路大数据安全平台建设》
- 3.14 刘裕惺《快手有状态服务规模上云实践》
1 SRE 稳定性工程:容灾专项(等级 / 混沌 / 大促 / 演练 / 前端 APP 容灾 / DNS / HTTPDNS / GTM / 网络架构 / 实践全景)【2026-09-09 补充】
| 监控 | 可发现、可告警、可定位 | 没有发现 = 问题度量不到;没有告警 = 发现了没人知道;没有定位 = 知道有问题查不出根因 | 可监控≈可发现 + 可告警 |
1.1 容灾等级体系深挖:从冷备到双活(SHARE 78 / GB/T 20988 / 同城双活 / 两地三中心 / RPO=0)【2026-09-09 补充】
框架:容灾等级本质是 RPO/RTO 目标的价格表—— 等级越高,RPO 越接近 0、RTO 越短,成本指数级上升。国际标准 SHARE 78 分 7 级(Tier 0-6),国标 GB/T 20988(2007 首版,2025 更新)分 6 级,从低到高大致:本地备份 → 异地数据备份 → 电子传输 + 部分设备 → 电子传输 + 完整设备(温备)→ 数据实时传输 + 完整设备(热备)→ 数据实时传输 + 零丢失(镜像站 / 双活)。
同城双活(企业主流选择,成本与高可用折中):同城两个数据中心都承载业务(Active-Active,不是一主一备),通过高速链路实时同步数据,日常同时分担流量,灾难时在基本不丢数据(RPO≈0)的情况下快速切换,保持业务连续。
两地三中心 = 同城双活(A/B 中心)+ 异地灾备(C 中心):
-
同城(A/B)扛 "单中心故障":同步复制,RPO≈0;
-
异地(C)扛 "城市级灾难":异步复制,RPO 分钟级 / 小时级、RTO 小时级;
-
关键设计:同城用同步复制、异地用异步复制—— 异地距离数百公里,同步复制延迟受光速物理限制无法接受。
RPO=0 的同步复制怎么做到(分层的机制)—— 一句话本质:提交之前,先让数据落到别处("先确认副本,再告诉客户端成功"):
| 层级 | 实现 | 机制 |
|---|---|---|
| 数据库层 | MySQL 半同步复制(至少一个备库 ack 才提交)、MySQL Group Replication / InnoDB Cluster、PostgreSQL 同步流复制、Oracle Data Guard SYNC 最大保护模式 | 事务提交前等备库确认 |
| 存储层 | SAN 同步复制(EMC SRDF/S)、分布式存储三副本多数派确认 | 块级镜像 / 副本确认 |
| 文件系统层 | DRBD(双机块级镜像) | 写盘时同步到对端 |
| 共识协议 | Raft/Paxos(同城三机房 2/3 仲裁) | 多数节点确认即不丢数据 |
同城双活三大难点(面试加分):
-
脑裂(split-brain):两中心光纤断了,双活变双主 → 数据分叉。解法:仲裁机制(第三方仲裁节点 / 多数派),断链后少数派自动降级只读或停机 —— 宁可不可用也不丢数据(CAP 取舍)。
-
同步复制的性能代价:每次写要等跨机房确认,写延迟 = 跨机房 RTT,所以同城距离要近(光速限制);RPO=0 的代价是可用性依赖链路—— 断链时要么降级(牺牲 RPO)要么停写(牺牲可用性)。
-
应用必须无状态:双活要求应用层无状态设计 + 分布式会话 / 分布式锁,否则流量切不过去。
选型铁律:先定 RPO/RTO 目标,再选方案(数据重要度 × 预算 → 等级)。面试表达:RPO/RTO 目标决定技术选型。
1.2 混沌工程:用故障演练量化验证三板斧【2026-09-09 补充】
定义与起源:混沌工程 = 在分布式系统上做受控实验,建立对系统抵御生产环境失控条件能力的信心(CNCF 定义)。起源于 Netflix 2011 年 Chaos Monkey—— 在生产环境随机终止 EC2 实例。经典类比是疫苗:注入小剂量故障,让系统产生 "免疫力"。核心心法:不是随机破坏,是带着假设做实验("We're not trying to break things. We're trying to build confidence.")。
五大原则(Bishop's Principles,面试直接背):
-
构建稳定状态假设:定义 "系统正常" 的可量化指标(如 "结账成功率 > 99.9%");
-
围绕稳定状态建立假设:预测 "杀掉一个支付服务 Pod,结账成功率仍 > 99.9%";
-
在真实环境(生产)做实验:测试环境太 "健康",发现不了真实问题;
-
自动化持续运行:一次性实验只发现一次性 bug,持续实验才能抓住回归;
-
最小化爆炸半径:先杀 1 个实例再杀全部,先注入 50ms 延迟再 5s 超时,实验开始前先准备好回滚。
四步实验流程:定义稳态 → 提假设 → 注入故障 → 测量对比(实际 vs 假设)→ 学习改进。
如何量化验证 "三板斧"(核心价值):演练的本质 = 用真实故障测出 "可切换 / 可恢复" 的实际耗时,而不是预案文档上写的时间;演练结果直接反哺 MTTR 目标。
| 三板斧 | 演练怎么测 | 量化指标 |
|---|---|---|
| 可发现 | 注入故障后,监控多久报警 | 实测 MTTD vs 目标 |
| 可告警 | 有没有漏报 / 误报 | 告警召回率、准确率 |
| 可定位 | 值班人员多久找到根因 | 实测 MTTI vs 目标 |
| 可切换 | failover 实际耗时 | 切换时间 vs 预案宣称 |
| 可恢复 | 数据 / 服务恢复耗时 | 实测 MTTR vs RTO 承诺 |
反哺闭环(把演练变成改进引擎):演练实测 → 与目标(RTO/MTTR 承诺)对比 → 找瓶颈 → 改进 → 再演练。举例:目标 RTO=30min,演练实测 failover 花了 45min,瓶颈在 "人工决策"→ 改成自动切换脚本 → 再演练 15min 达标。关键思想:演练不是 "证明系统没问题"(测试思维),是 "暴露问题并改进"(工程思维);演练结果应进入目标管理(OKR),实测值 ≤ 目标值才算三板斧真的可用。
落地形态:GameDay(游戏日 —— 固定周期、全员参与、真实流量的演练活动);工具链(Netflix Chaos Monkey、Chaos Mesh、阿里 CHAOSBLADE、Litmus);演练先测试环境小规模跑通,再上生产小爆炸半径。
1.3 容灾专项建设开展思路:盘家底 → 前端 / 后端分层防御 → 演练闭环【2026-09-09 补充】
第 0 步 盘家底(识别期):分析系统功能、系统架构、链路架构,产出四张清单:
-
核心链路:用户最关键业务路径(如红包场景 "拆红包→入账"),容灾投入按核心度排序;
-
核心功能 / 核心接口:核心链路上不可砍的(拆红包不可砍、发红包可砍);
-
强弱依赖:每个依赖标 "强 / 弱"。强依赖(DB/Redis/ 核心 RPC)必须 备份 + 降级 + 切换;弱依赖(推荐 / 埋点 / 送审)随时可降级。
前端平台容灾(平台类):域名容灾(多域名 + 客户端切换)、CDN 容灾(多 CDN + 回源容灾)、接口容灾(网关 API 降级 / 兜底)、HTTPDNS。
后端链路容灾(业务类):三层容灾拦截防御体系:
-
机房级:链路入口 → 系统(服务域)入口 → 服务入口,可切流(逐级切,像分闸一样一级级拉,先切链路再切系统再切服务);
-
系统级:强依赖组件(DB/Redis/MQ/ 第三方)可备份、可降级、可切换。降级分两种:功能降级(砍功能)与流量降级(降质量 —— 降低抽帧频率、降低送审频率,优先保证优质流量和高优模型,AI / 视频业务特色的 "降质保量");
-
服务级:核心接口可降级(缓存降级→快速失败)、限流(保护自身)、熔断(保护下游不被拖垮)、可切流(流量切到备用集群 / 机房)。
定期强弱依赖演练:周期性验证 "强依赖的备份 / 降级 / 切换真的可用、弱依赖降级后核心链路真的不受影响"—— 把上述能力逐项实测(衔接混沌工程方法论:生产实测 MTTD/failover/MTTR vs RTO 目标)。
1.4 电商大促容灾设计:秒杀 / 春节红包的分层削峰与预案体系【2026-09-09 补充】
案例背景:抖音支撑春晚 12 亿红包雨 —— 流量接入侧用融合加速线路方案(L1/L2 回源控制、专线 / 公网回源无缝切换、自动流量控制、运行时探测线路优选与自动容灾),底层分布式架构支撑低时延、高弹性、易维护。
核心方法论:分层削峰 + 分级降级 + 数据容灾 + 预案清单。
① 五层削峰(秒杀架构核心,每层挡掉一批流量):
-
前端层:按钮防抖 + 验证码,挡无效请求;
-
网关层:Nginx 限流 + IP 黑名单,控制进入后端速率;
-
Redis 层:DECR 原子预扣库存,过滤出真正能下单的请求;
-
MQ 层:异步削峰,下单转异步;
-
DB 层:最终扣减(防超卖)。
② 四级限流:网关层限流(按 IP / 用户 / 接口粗粒度,防恶意流量和突发洪峰)→ 服务层单机限流(Sentinel/Guava RateLimiter,保护单实例不被打垮)→ 分布式限流(Redis+Lua 全局 QPS 控制,关键接口用)→ 资源层限流(数据库连接池保护)。
③ 分级降级 + 熔断:核心链路(下单、支付、扣库存)绝不降级;次要链路(商品推荐、评价、足迹)可降级。降级手段:页面降级(动态变静态页)、功能降级(砍非核心)、数据降级(个性化推荐变通用推荐)。熔断三要素:错误率阈值(一般~50%)、最小请求量门槛、半开探测恢复;熔断后快速失败返回兜底(如 "支付通道繁忙"),避免线程堆积和故障传导。
④ 数据容灾:Redis 集群故障 → 切备用集群 / 核心业务降级为直查 DB / 非核心返回 "活动火爆,请稍后";库存一致性用 Redis 预扣 + MQ 异步最终扣减,防止超卖。
⑤ 预案清单(大促前必须写好并演练):流量超预期(QPS 20 万)→ 临时提高网关限流阈值、关闭非核心业务、扩容网关和订单服务节点;Redis 故障 → 切备集群 / 直查 DB / 非核心返回繁忙。
1.5 容灾演练 vs 异常测试:异同点与区分方法【2026-09-09 补充】
容易混淆的根本原因:两者都是 "故意制造异常",工具经常重叠(混沌工程工具 vs 故障注入测试框架),很多团队把 "跑一遍故障注入用例" 当成 "做了容灾演练"—— 这是最常见的误区。
| 维度 | 异常测试(Exception Testing) | 容灾演练(DR Drill / Chaos) |
|---|---|---|
| 目的 | 验证功能正确性:异常下行为符合预期(抛错 / 重试 / 回滚) | 验证生产韧性:故障下业务连续性(可发现 / 可切换 / 可恢复) |
| 环境 | 测试环境 / 预发 | 生产环境(或生产等同环境),小爆炸半径 |
| 是否有假设 | 有预期结果(断言) | 有稳态假设(指标不越界),但不预设必然通过 |
| 结果判定 | 用例通过 / 失败 | 实测 MTTD/MTTI/failover/MTTR vs RTO 目标,暴露瓶颈 |
| 频率 | 版本回归、CI 里跑 | 周期性(月度 / 季度 GameDay)+ 大促前专项 |
| 工具 | 故障注入测试框架、Mock | Chaos Monkey / Chaos Mesh / CHAOSBLADE |
| 心态 | "证明没 bug" | "暴露弱点并改进" |
区分一句话:异常测试问 "功能在异常下对不对"(测试环境、有断言、判通过 / 失败);容灾演练问"系统在真实故障下扛不扛得住、多久能恢复"(生产、有稳态假设、用实测时间对比 RTO 目标)。一个验证正确性,一个验证韧性。
1.6 前端与 APP 端容灾:域名 / CDN / 公网 / 内网 / 自研七层网关【2026-09-09 补充】
① 域名容灾(核心:不把命押在一个域名 + 一个解析商上):
-
多域名 + 客户端域名替换:客户端网络库内置域名列表(得物实践:CDN 域名收敛拦截器,请求失败时从域名列表选当前可用域名替换);
-
解析商解耦:域名托管在独立注册商,主解析商故障时切换 NS 记录接管解析权(Cloudflare 故障案例教训);
-
TTL 缩短:DNS TTL 调小(30-60s)让切换生效快,但 TTL 过短放大解析压力。
② CDN 容灾:
-
Multi-CDN:active-active(多 CDN 同时服务,DNS 加权 / Anycast 调度,故障平滑过渡,代价 = 复杂度 + 成本)或 active-passive(主 CDN 故障切备,简单但 DNS 缓存拖慢切换);
-
回源容灾:源站多活(CDN 背后多机房源站,回源可切);
-
客户端级调度:DNS 调度感知不了真实网络质量,进阶做法 = 客户端拨测 + 网络库自动换 CDN 域名(OkHttp 拦截器 + EventListener 多线路容灾,业务层无感)。
③ 公网容灾:多公网出口(多线路 BGP / 多运营商)、专线冗余、全局流量调度(字节 TrafficRoute GTM—— 基于 DNS 的全球负载均衡 + 智能调度 + 自动容灾,承载亿级流量)、高防清洗(公网入口防 DDoS)。
④ 内网容灾:机房内多链路(双上联 / 双交换机)、专线冗余(同城双活靠高速链路,断链靠仲裁降级)、内网 DNS 容灾(多级 DNS + 故障转移)、服务网格多集群路由(流量在多集群间调度)。
⑤ APP 端容灾(重点):
-
自研七层网关(TTNP/TTGW 类):字节请求链路 = CDN → TTGW(高性能 4 层负载均衡网关,集团公网流量统一入口,承载高防)→ TLB(七层负载均衡)→ AGW(统一业务 API 接入层)→ 业务服务 PSM。这类自研网关价值 = 统一流量入口 + 安全防护 + 智能调度 + 一键容灾切换(入口侧切流,业务无感);
-
HTTPDNS:客户端内置 HTTPDNS,绕开运营商 DNS 劫持 / 故障,配合 IP 直连容灾;
-
客户端本地降级:本地缓存(接口挂了读缓存)、离线包(页面兜底)、动态配置开关(服务端远程关闭非核心功能);
-
网络层自动容灾:超时重试、切换网络(WiFi→4G/5G)、降级域名列表、按线路质量选路。
1.7 字节 APP 端 TNC 容灾组件:端云协同的云控容灾【2026-09-09 补充】
一句话定位:TNC(云控容灾系统)是字节自研的端云协同容灾组件—— 核心是 "云端决策、终端执行":服务端把网络容灾策略以命令 / 配置形式实时下发给客户端,客户端网络库收到后秒级调整网络行为(切域名、切线路、走 HTTPDNS、降级),全程不依赖 App 发版、不受 DNS TTL 拖累。(字节青训营资料:云控容灾 = 云端交互、服务器 / 云上下发命令到终端,即字节 TNC 系统)
为什么需要 TNC(先理解痛点):
| 容灾手段 | 生效速度 | 痛点 |
|---|---|---|
| DNS 容灾(GTM 摘除故障节点) | 慢(TTL 缓存拖累,分钟级) | 切换生效慢;DNS 服务器感知不到真实网络质量 |
| App 发版改域名 / IP | 极慢(天级) | 故障时不可能等发版 |
| HTTPDNS | 快但需服务端实时更新 | 更新下发的 "通道" 本身要快 |
| TNC 云控容灾 | 秒级(长连接 / 推送直达终端) | 一条实时指挥通道 |
字节青训营把网络容灾体系总结为四类:专线容灾(环路)→ 接入节点容灾(GTM DNS 摘除)→ 云控容灾(TNC 下发命令到终端)→ cache 容灾(源站不可用降级到缓存)——TNC 是其中唯一的 "端到云" 实时通道。
原理:端云协同闭环(公开资料 + 通用机制推断):
-
云端:实时探测 / 监控(客户端拨测上报 + 服务端探活)→ 故障感知 → 决策引擎(切哪个域名、切多少流量、灰度还是全量)→ TNC 下发(域名列表 / HTTPDNS 开关 /stale cache 策略 / QUIC 域名 / 接口分级降级),长连接 / 推送直达终端,秒级生效;
-
终端:TNC 客户端组件 + TTNet 网络库接收命令 → 立即执行(换域名 / 换线路 / 走 HTTPDNS / 用过期缓存 / 接口降级)→ 执行结果与拨测数据上报云端 → 闭环迭代。
功能拆解(公开可查 + 合理推断):
-
云控下发:TNC 接口(如 tnc3-*.snssdk.com/get_domains)下发当前可用域名列表、ttnet_tt_http_dns(HTTPDNS 开关)、race_dns_stale_cache_config(DNS 过期缓存策略)、quic_radical_wildchar_hosts(QUIC 加速域名)等网络配置,客户端拿到即生效;
-
秒级容灾切换:服务端探测到域名 / 接入点 / CDN 故障 → TNC 下发新域名 / 新接入点 → 客户端立即切换(比 DNS TTL 快、比发版快);
-
降级控制:结合 BAM 接口分级管理平台(业务流量分级),高优接口走优质链路、低优接口降级(春晚 12 亿红包雨采用 AppSettings + TNC + TTNet + HTTPDNS 组合);
-
灰度与回滚:策略可灰度下发(小流量→全量)、可实时回滚(改配置即生效);
-
拨测反馈:客户端实时上报网络质量,云端基于真实终端数据决策调度。
与周边组件的关系(面试全家桶):
-
GTM(DNS 容灾):接入节点级,摘除故障节点,受 TTL 拖累;
-
TNC(云控容灾):终端级,秒级指挥客户端(本组件);
-
TTLB / ByteCDN(cache 容灾):源站不可用降级到缓存内容;
-
TTNet:TNC 的执行载体(字节自研客户端网络库,基于 Cronet 深度定制,覆盖调度容灾、性能调优、监控排错,为绝大多数 App 提供网络服务);
-
TTNP / TTGW:服务端入口侧七层网关(入口切流),TNC 是客户端侧(终端切流)——端侧切 + 入口侧切双保险。
事实边界:TNC 的定位(字节云控容灾系统)、在容灾体系中的位置、春晚组合使用均有公开资料可查;具体内部下发协议、调度算法细节无公开资料,执行链路为端云协同容灾通用机制的合理推断。面试讲 "云端决策→终端执行→秒级切换→拨测闭环" 框架是安全的。
面试表达:TNC 是字节端云协同的云控容灾系统 —— 云端把 "切哪个域名、走不走 HTTPDNS、要不要用过期缓存、哪些接口降级" 实时下发给客户端网络库(TTNet),秒级生效,不依赖发版和 DNS TTL;它与 GTM(DNS 容灾)、TTLB/ByteCDN(缓存容灾)、TTNP(入口网关)组成字节网络容灾体系,春晚 12 亿红包雨靠 AppSettings + TNC + TTNet + HTTPDNS 组合扛下来。
1.8 域名机房容灾:CNAME + GTM 智能解析的机制与边界【2026-09-09 补充】
结论:可以,但要分清 "CNAME 本身" 和 "CNAME + GTM" 的组合 ——CNAME 只是挂载点,容灾决策能力来自它背后的 GTM(全局流量管理 / 智能 DNS)。这也是业界和字节的标准做法。
原理:
-
CNAME 是什么:别名记录(Canonical Name),把
app.example.com的解析权 "委托" 给另一个域名(如lb.gtm.example.com)。它本身不做任何容灾判断,只是把解析请求转交出去; -
GTM 做两件事:① 健康检查(定时探测各机房源站,HTTP/TCP 探活,故障机房自动摘除);② 智能解析(按客户端来源 IP 地理 / 运营商 + 机房健康状态,返回当前存活且最优的机房 IP)。
-
容灾闭环:故障时 GTM 摘掉故障机房,解析结果自然只剩存活机房,无需人工改记录。字节 TrafficRoute GTM 即此机制(基于 DNS 的全球负载均衡 + 智能调度 + 自动容灾)。
四个边界(面试加分):
-
TTL 拖慢切换:GTM 摘节点秒级,但客户端和递归 DNS 缓存 A 记录到 TTL 过期才重新解析 ——TTL=60s 则切换最多拖 60s+;CNAME 记录本身也有 TTL,别只调 A 记录;
-
DNS 盲区:GTM 按 "来源 IP 地理 + 服务端探活" 决策,感知不到 "用户到该机房的真实链路质量"(可能绕路 / 丢包)—— 所以进阶是 HTTPDNS + 客户端拨测(衔接 TNC 组件);
-
CNAME 硬限制:RFC 规定 CNAME 节点不能与 MX/TXT 等其他记录共存(mail/app 混用要换方案);CNAME 链不宜过长(多级增加查询时间和故障点);
-
GTM 自身要容灾:
lb.gtm.example.com挂了解析就断 —— 所以 GTM 系统要多机房冗余 + 域名托管在独立注册商 + 主解析商故障时切换 NS 记录。
面试表达:域名机房容灾确实用 CNAME—— 但不是靠 CNAME 本身,而是 CNAME 把解析权委托给 GTM,GTM 做健康检查摘除故障机房、按来源 IP 智能返回存活机房 IP。边界:TTL 拖慢生效、DNS 感知不到真实链路质量(要 HTTPDNS / 客户端拨测补)、CNAME 有 MX 共存等硬限制、GTM 自身要冗余。一句话:CNAME 是挂载点,GTM 才是容灾大脑。
📄
来源:006_AI 时代 QA 完整对话与体系合集.md
1.9 HTTPDNS + 客户端拨测:机制与应用实践【2026-09-09 补充】
痛点:传统 DNS 两大死穴 ——① 客户端域名解析经过运营商 Local DNS,可能被劫持 / 污染 / 缓存错;② 调度依据是 "递归 DNS 出口 IP" 而不是客户端真实 IP,归属判断不准(可能调度到错误机房)。
HTTPDNS 原理:客户端绕过 Local DNS,用 HTTP (S) 请求直连 HTTPDNS 服务端(IP 直连),问 "这个域名给我最优 IP";服务端基于客户端真实出口 IP 精确调度(地理 / 运营商 / 负载 / 健康),返回 IP 列表;客户端拿 IP 直连,可配合 IP 直连、HTTPS 防篡改。火山 HTTPDNS Cache 2.0 公开数据:缓存命中率提升 15%、缓存量降低 70%、调度精准度提升 20%、解析成功率 99.995%(较传统 DNS 提升 3 个数量级)。
客户端拨测原理:客户端 / 边缘节点对候选 IP、线路做真实探测(TCP 建连、HTTP 请求,采集 RTT / 丢包 / 成功率),上报云端;云端基于真实拨测数据决策 "哪条线路最优";通过 TNC 下发 / HTTPDNS 调整执行。闭环:拨测 → 上报 → 决策 → 下发 → 执行 → 再拨测。
应用实践(大厂组合拳):字节链路 = AppSettings(配置下发)+ TNC(云控容灾)+ TTNet(网络库执行)+ HTTPDNS(解析),配合拨测数据支撑调度决策(春晚 12 亿红包雨场景);HTTPDNS 失败自动降级走 Local DNS,IP 直连失败换备用 IP。
1.10 HTTPDNS vs Local DNS vs 传统 DNS:区别、优缺点与容灾选型【2026-09-09 补充】
| 维度 | 传统 DNS(权威) | Local DNS(运营商递归) | HTTPDNS |
|---|---|---|---|
| 查询方式 | 标准 DNS 协议(UDP 53) | 标准 DNS 协议 | HTTP (S) 直连服务端 |
| 调度依据 | 递归 DNS 出口 IP(不准) | 递归 DNS 出口 IP | 客户端真实出口 IP(准) |
| 劫持 / 污染风险 | 可能被中间人污染 | 高发(运营商劫持) | 低(IP 直连 + HTTPS) |
| 生效速度 | 慢(TTL) | 慢(TTL + 缓存) | 快(可秒级 / 实时) |
| 容灾能力 | 靠 GTM / 健康检查 | 无 | 强(实时调度 + 多线路) |
| 成本 | 低 | 低 | 高(自建 / 买服务) |
容灾时最常用哪个:分层组合——DNS/GTM 容灾是底座(覆盖所有客户端,不依赖客户端改造);HTTPDNS + 拨测是增强(解决劫持、TTL 慢、链路质量盲区)。大厂实战就是两者叠加:DNS 容灾兜底 + HTTPDNS / 拨测做精细调度。
1.11 网络架构基础概念:公网 / 内网 / 骨干网 / 公网 IP / 机房电力容灾(UPS)【2026-09-09 补充】
| 概念 | 含义 | 要点 |
|---|---|---|
| 公网 | 全球互联公共网络(Internet) | 公网 IP 通信 |
| 内网 | 企业 / 机房内部网络 | 私网 IP(RFC1918:10.x/172.16-31.x/192.168.x),NAT 出公网 |
| 骨干网(Backbone) | 连接城市 / 机房 / 运营商核心节点的高速骨干链路 | 高容量、高冗余,网络 "高速公路" |
| 公网 IP | 全球唯一可路由 IP | IPv4 稀缺,IPv6 扩展 |
| 机房电力容灾 | UPS(Uninterruptible Power Supply,不间断电源) | 市电断电瞬间电池接管(秒级);配合双路市电(两路独立市电 N+1 冗余)→ UPS(秒级)→ 柴油发电机(分钟 - 小时级长时供电)→ PDU 配电单元 |
1.12 GTM 功能与 CDN/DNS 容灾实现【2026-09-09 补充】
GTM(Global Traffic Manager,全局流量管理 / DNS GSLB)五大功能:
-
多机房 / 多云负载均衡:按权重 / 地理 / 运营商分发流量;
-
健康检查:TCP/HTTP 探活各机房源站,摘除故障节点;
-
智能调度:按客户端来源 IP 地理 / 运营商 / 负载返回最优机房 IP;
-
自动容灾:故障机房自动摘除,流量自动切到存活机房;
-
统一流量管理:多域名、多机房全局视角。字节 TrafficRoute GTM 承载亿级流量。
CDN 容灾实现(五层):
-
多 CDN 厂商:active-active(双 CDN 同时服务,DNS 加权 / Anycast 调度)或 active-passive(主故障切备);
-
回源容灾:源站多活(多机房源站 + 健康检查 + 回源切换);
-
CDN 内部 GSLB:CDN 厂商自调度(边缘节点健康检查、故障节点摘除、就近调度);
-
客户端级降级:CDN 故障时客户端换备用域名 / 直连源站(多域名 + 客户端替换);
-
缓存降级:源站不可用降级到 CDN 缓存内容(TTLB/ByteCDN cache 容灾)。
DNS 容灾实现(五层):
-
权威 DNS 冗余:主备权威 DNS、多节点 Anycast;
-
GTM 健康检查摘 IP:CNAME 委托 GTM(详见上节);
-
多 IP + 健康检查联动:A 记录多 IP,故障 IP 自动移除;
-
TTL 缩短:加快切换生效(注意 TTL 过短放大解析压力);
-
客户端 HTTPDNS 兜底:绕过 Local DNS 缓存与劫持,配合客户端拨测感知真实链路。
三层叠加 = 完整链路容灾:DNS 容灾管 "域名→哪个机房"(GTM 决策);CDN 容灾管 "静态资源→哪个节点 / 缓存";HTTPDNS + 客户端拨测补 "最后一跳的真实链路质量"。
1.13 容灾建设实践全景:9 大方向的核心理念(内部资料整理)【2026-09-09 补充】
主线:容灾是保障系统稳定性、业务连续性的核心能力,主流实践覆盖从基础架构设计到智能自动化修复的全链路场景。按 "架构设计(①④⑦⑧)→ 平台与评估(③⑥)→ 自动化与智能化(②⑤⑨)" 三条线组织,对应容灾能力的三级跃迁:
从 "设计不坏" 到 "坏了能感知" 再到 "坏了自动修"
。
1.13.1 ① 基础架构层容灾设计原则
📄 来源飞书文档(内部 wiki):https://bytedance.feishu.cn/wiki/ZyyBwmKvUiAQYHkEPHlcqX5nnUe
多机房容灾,支持单机 / 机房 / 城市级切流演练,同时搭配全链路压测、监控告警、安全防护等配套能力,共同保障高并发场景下的系统稳定性。
1.13.2 ② K8s+Ray 协同跨层自动化容灾
📄 来源飞书文档(内部 wiki):https://bytedance.feishu.cn/wiki/EgCUwWrAki8ZGNkpGanc4EEAnZd
通过 Ray Cluster 的 Head 节点、Worker 节点与 K8s 的 apiserver、Kuberay 组件配合,由节点内故障感知同步至日志服务,触发故障标记后完成故障机替换,最终实现任务重启续训的全自动化容灾流程(AI 训练场景:跨层自动恢复,无需人工介入)。
1.13.3 ③ 四层稳定性容灾保障体系
📄 来源飞书文档(内部 wiki):https://bytedance.feishu.cn/wiki/Te86wuuCbitOepksLYHcDlINnTd
从平台层、集群层、节点层、业务层四个维度落地容灾能力:
-
平台层:搭建完善的全链路监控告警体系;
-
集群层:实现组件高可用与异常自愈;
-
节点层:完成核心组件监测、内核版本基线化管理;
-
业务层:支持一键多地域多可用区容灾部署与多集群协同编排调度。
1.13.4 ④ 面向失败的架构容灾设计
📄 来源飞书文档(内部 wiki):https://bytedance.feishu.cn/wiki/ESz0woT4hibY1OknO9Acj8J9nkh
通过部署冗余架构消除硬件、存储、网络、机房等各类单点风险;搭配冷备 / 热备的多级别灾备设计,实现数据级、应用级、业务级容灾;支持两地三中心、三地五中心的异地多活部署模式。(核心思想:预设失败是常态,先在架构层面消灭单点。)
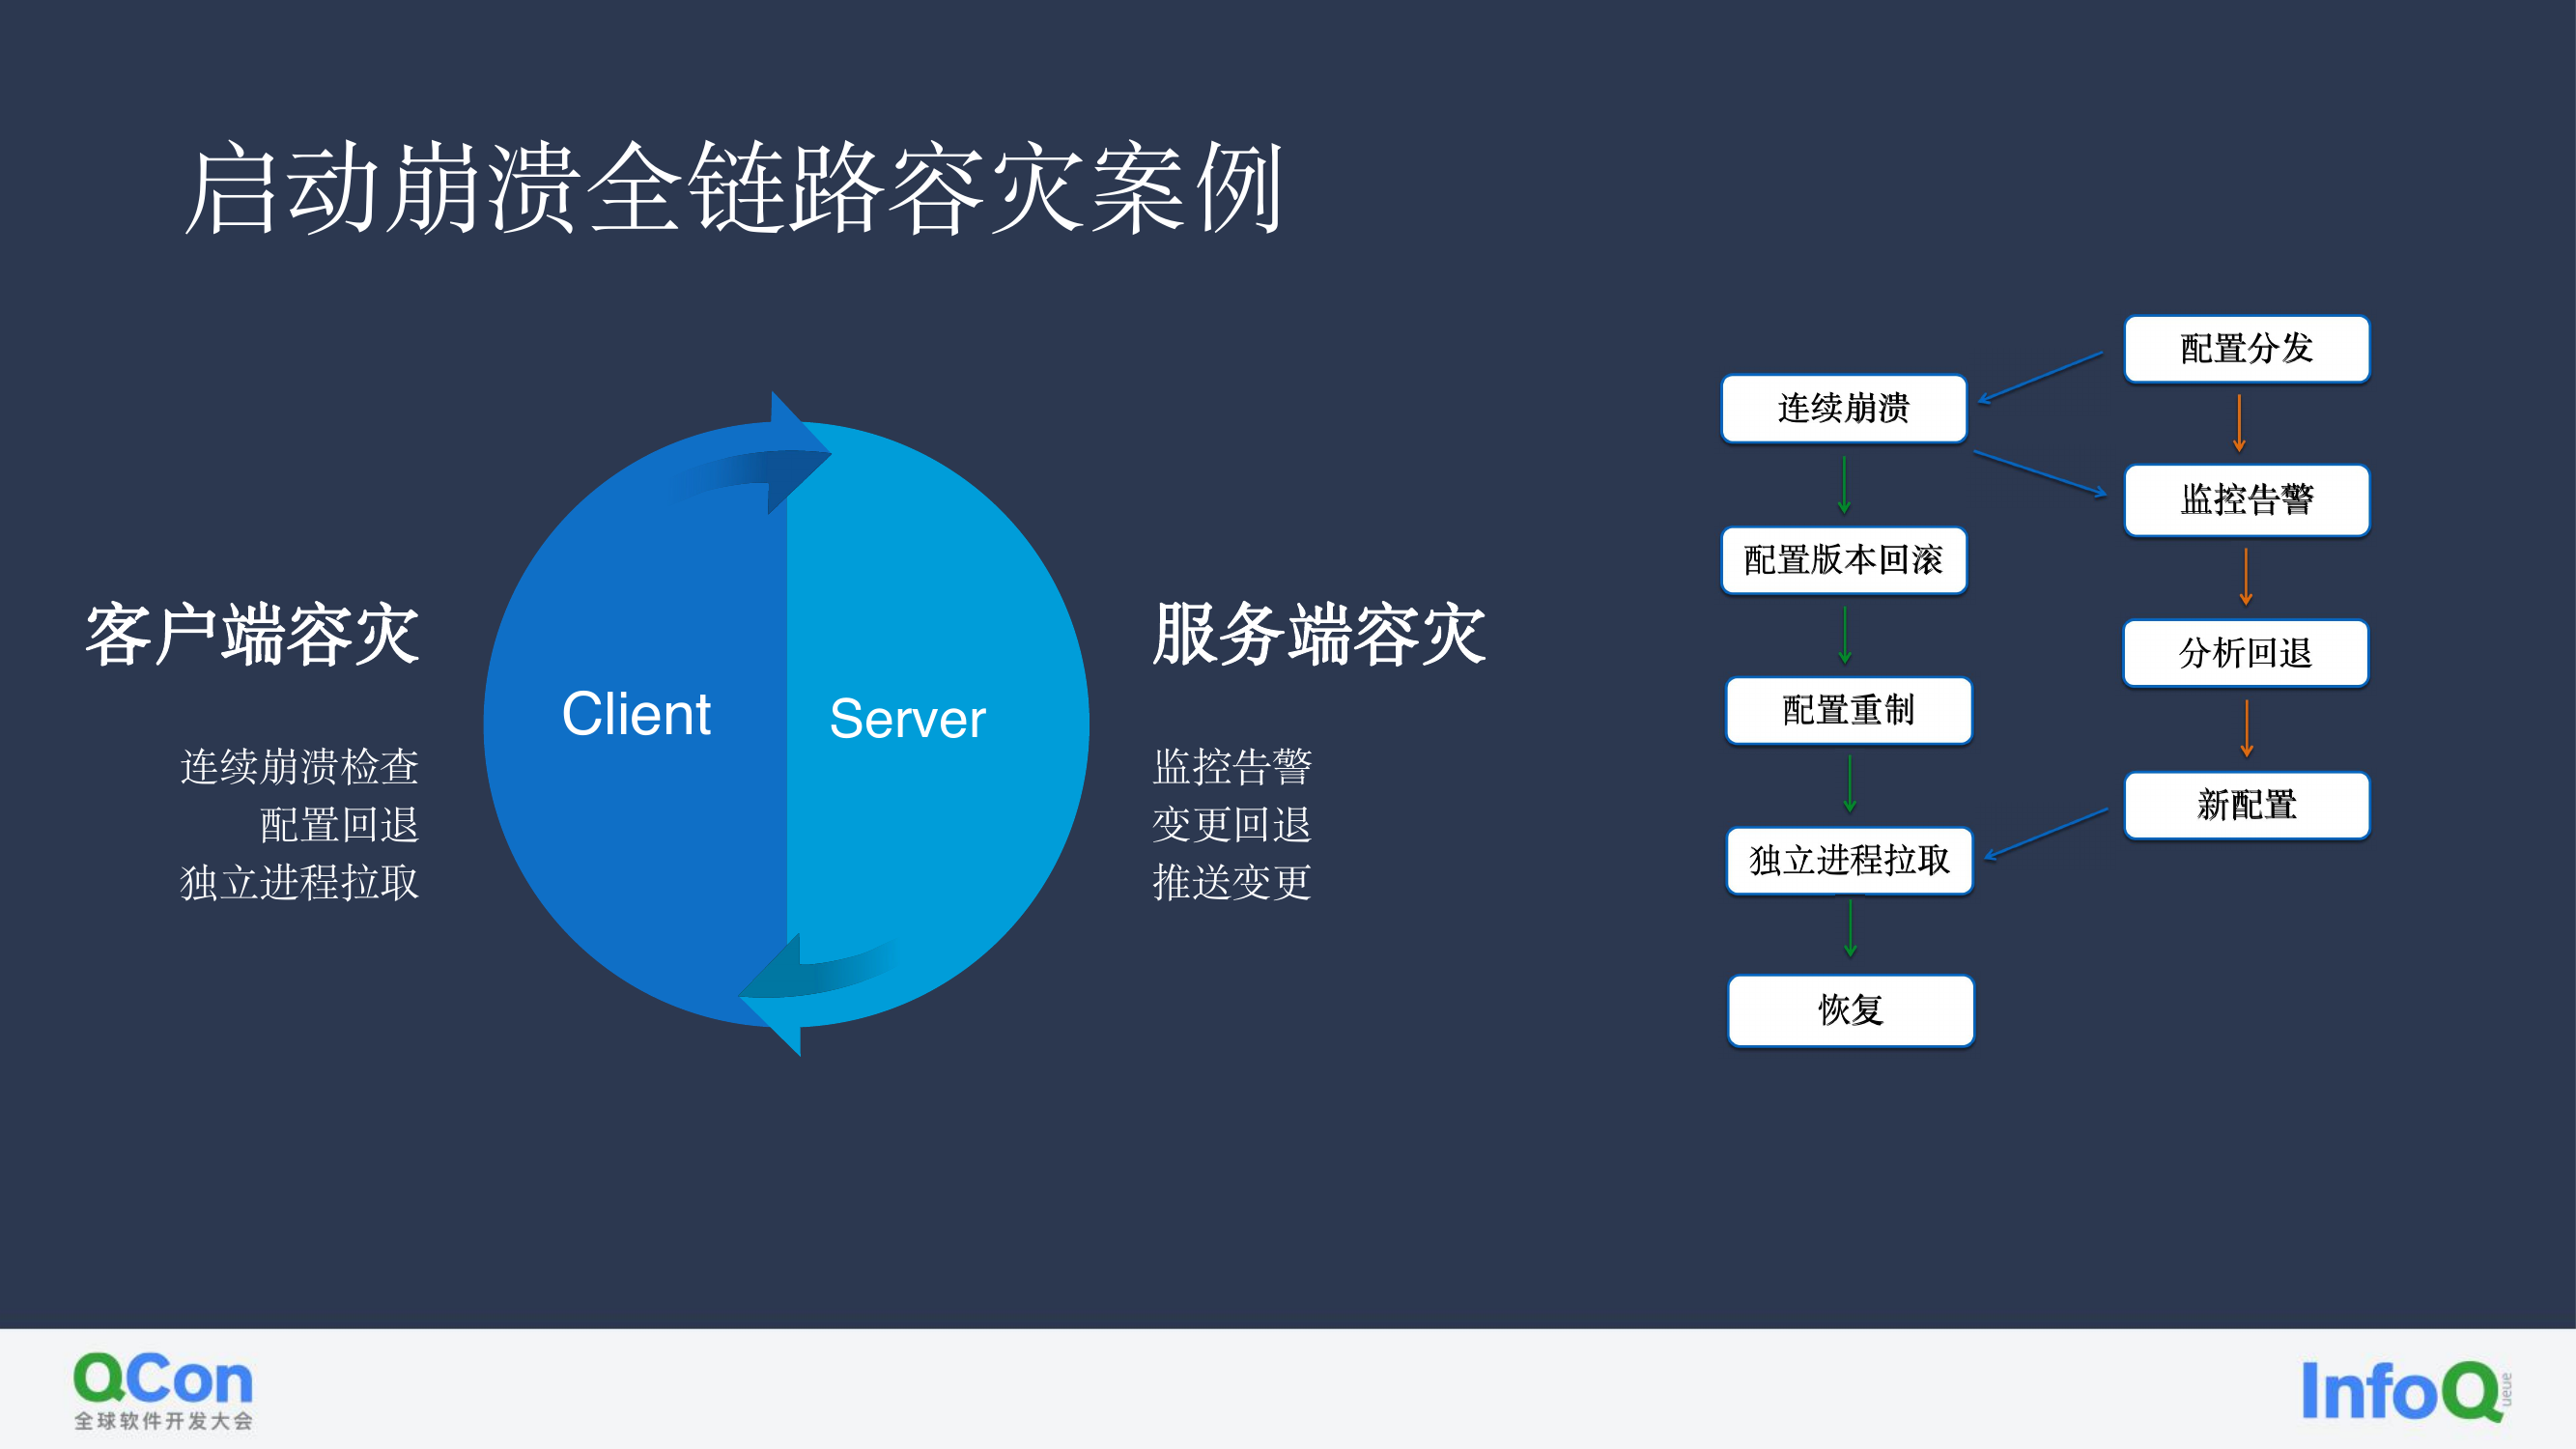
1.13.5 ⑤ 客户端启动崩溃全链路容灾
📄 来源飞书文档(内部 wiki):https://bytedance.feishu.cn/wiki/T2JPwv24AiGMkUkloX0czA8Nn2R
-
客户端侧:连续崩溃检查、配置回退、独立进程拉取能力;
-
服务端侧:监控告警、变更回退、推送变更机制;
-
形成两端协同的启动故障快速恢复流程(典型场景:客户端因配置 / 版本问题启动即崩,靠服务端推送回退 + 客户端本地回退快速恢复)。
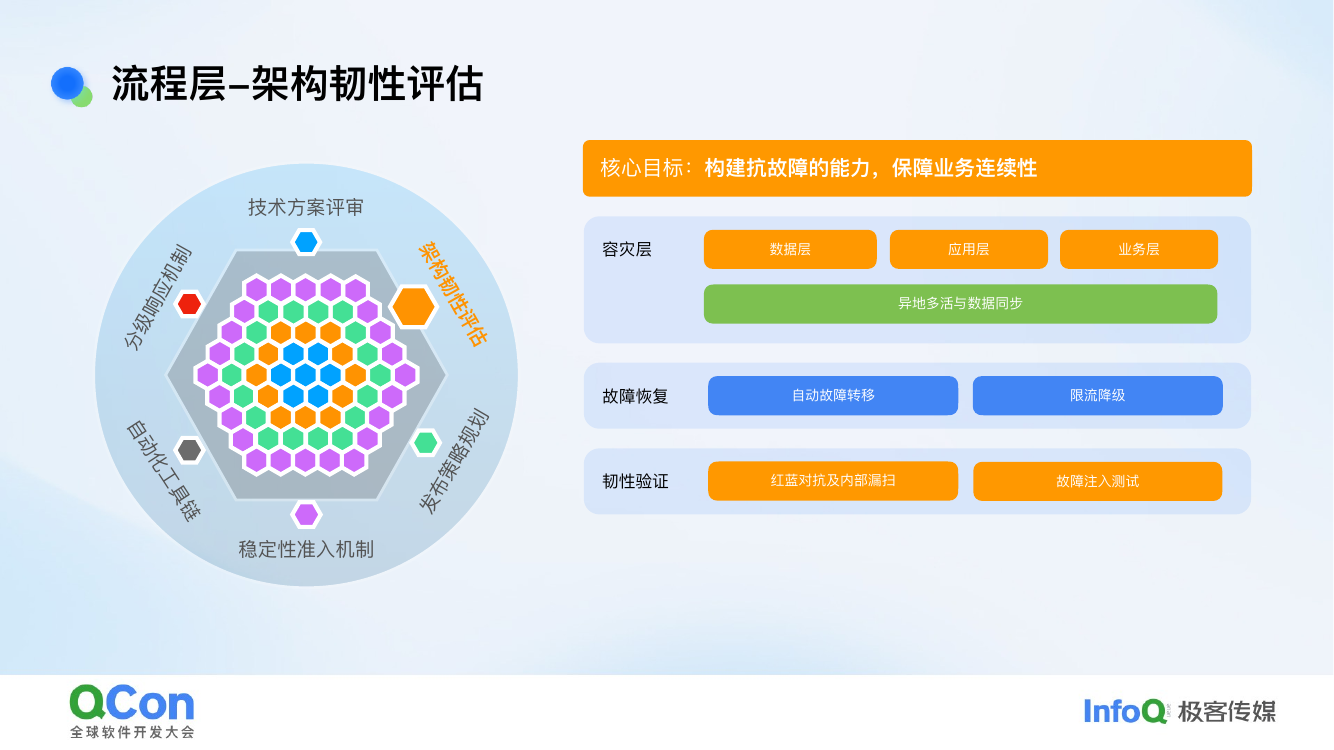
1.13.6 ⑥ 架构韧性容灾评估体系
📄 来源飞书文档(内部 wiki):https://bytedance.feishu.cn/wiki/A1zAw3PnYihj3Ok2wc0cpa2lnPe
核心目标:构建抗故障能力、保障业务连续性。三大模块:
-
容灾层:数据源、应用层、业务层及异地多活数据同步;
-
故障恢复:自动故障转移、限流降级;
-
韧性验证:红蓝对抗及内部演练、故障注入测试。
1.13.7 ⑦ 银行单元化快速切换容灾方案
📄 来源飞书文档(内部 wiki):https://bytedance.feishu.cn/wiki/K0tqwUMWaiRPIOk9gIRcSEtrnhd
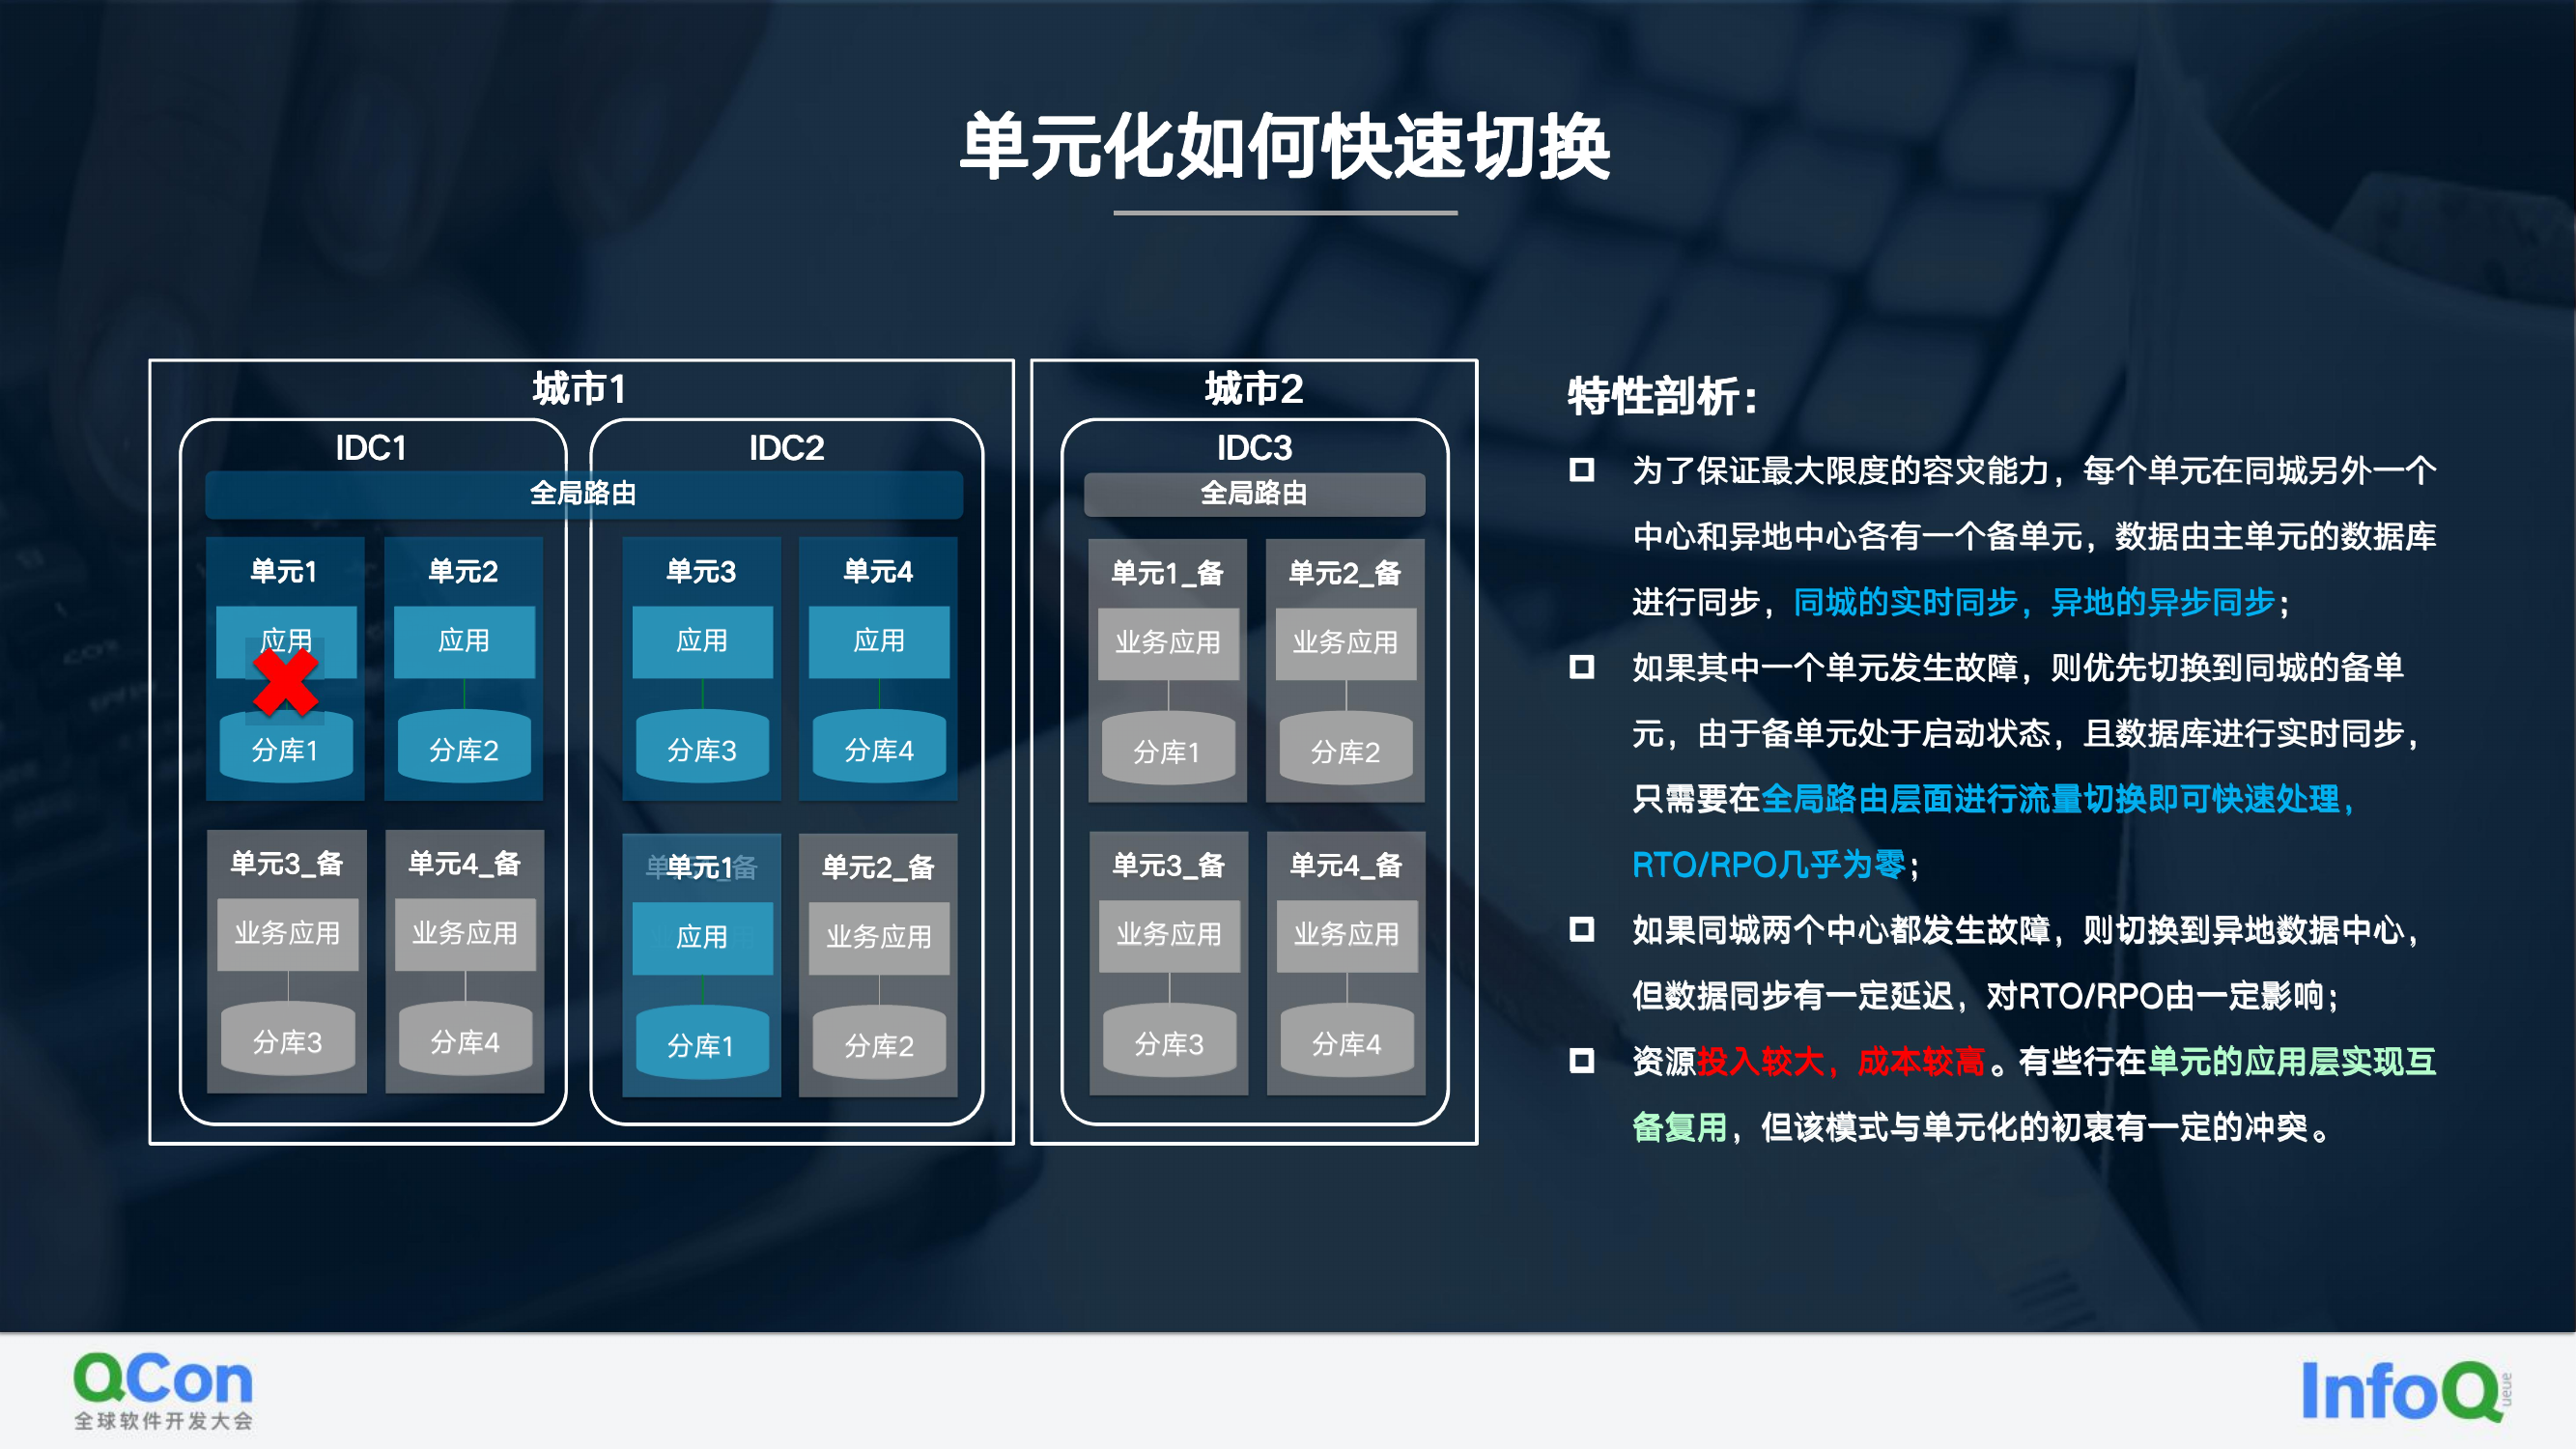
每个业务单元在同城另一个中心和异地中心各配置一个备单元,同城数据实时同步、异地数据异步同步;单单元故障时优先切换至同城备单元,仅需在全局路由层面切换流量即可实现近乎为零的 RTO/RPO;同城双中心均故障时可切换至异地数据中心。(金融级强一致 + 极速切换的标杆方案。)
1.13.8 ⑧ 阿里电商多活容灾体系
📄 来源飞书文档(内部 wiki):https://bytedance.feishu.cn/wiki/FiNTw3aLhixToUkgrATcZdunnAb
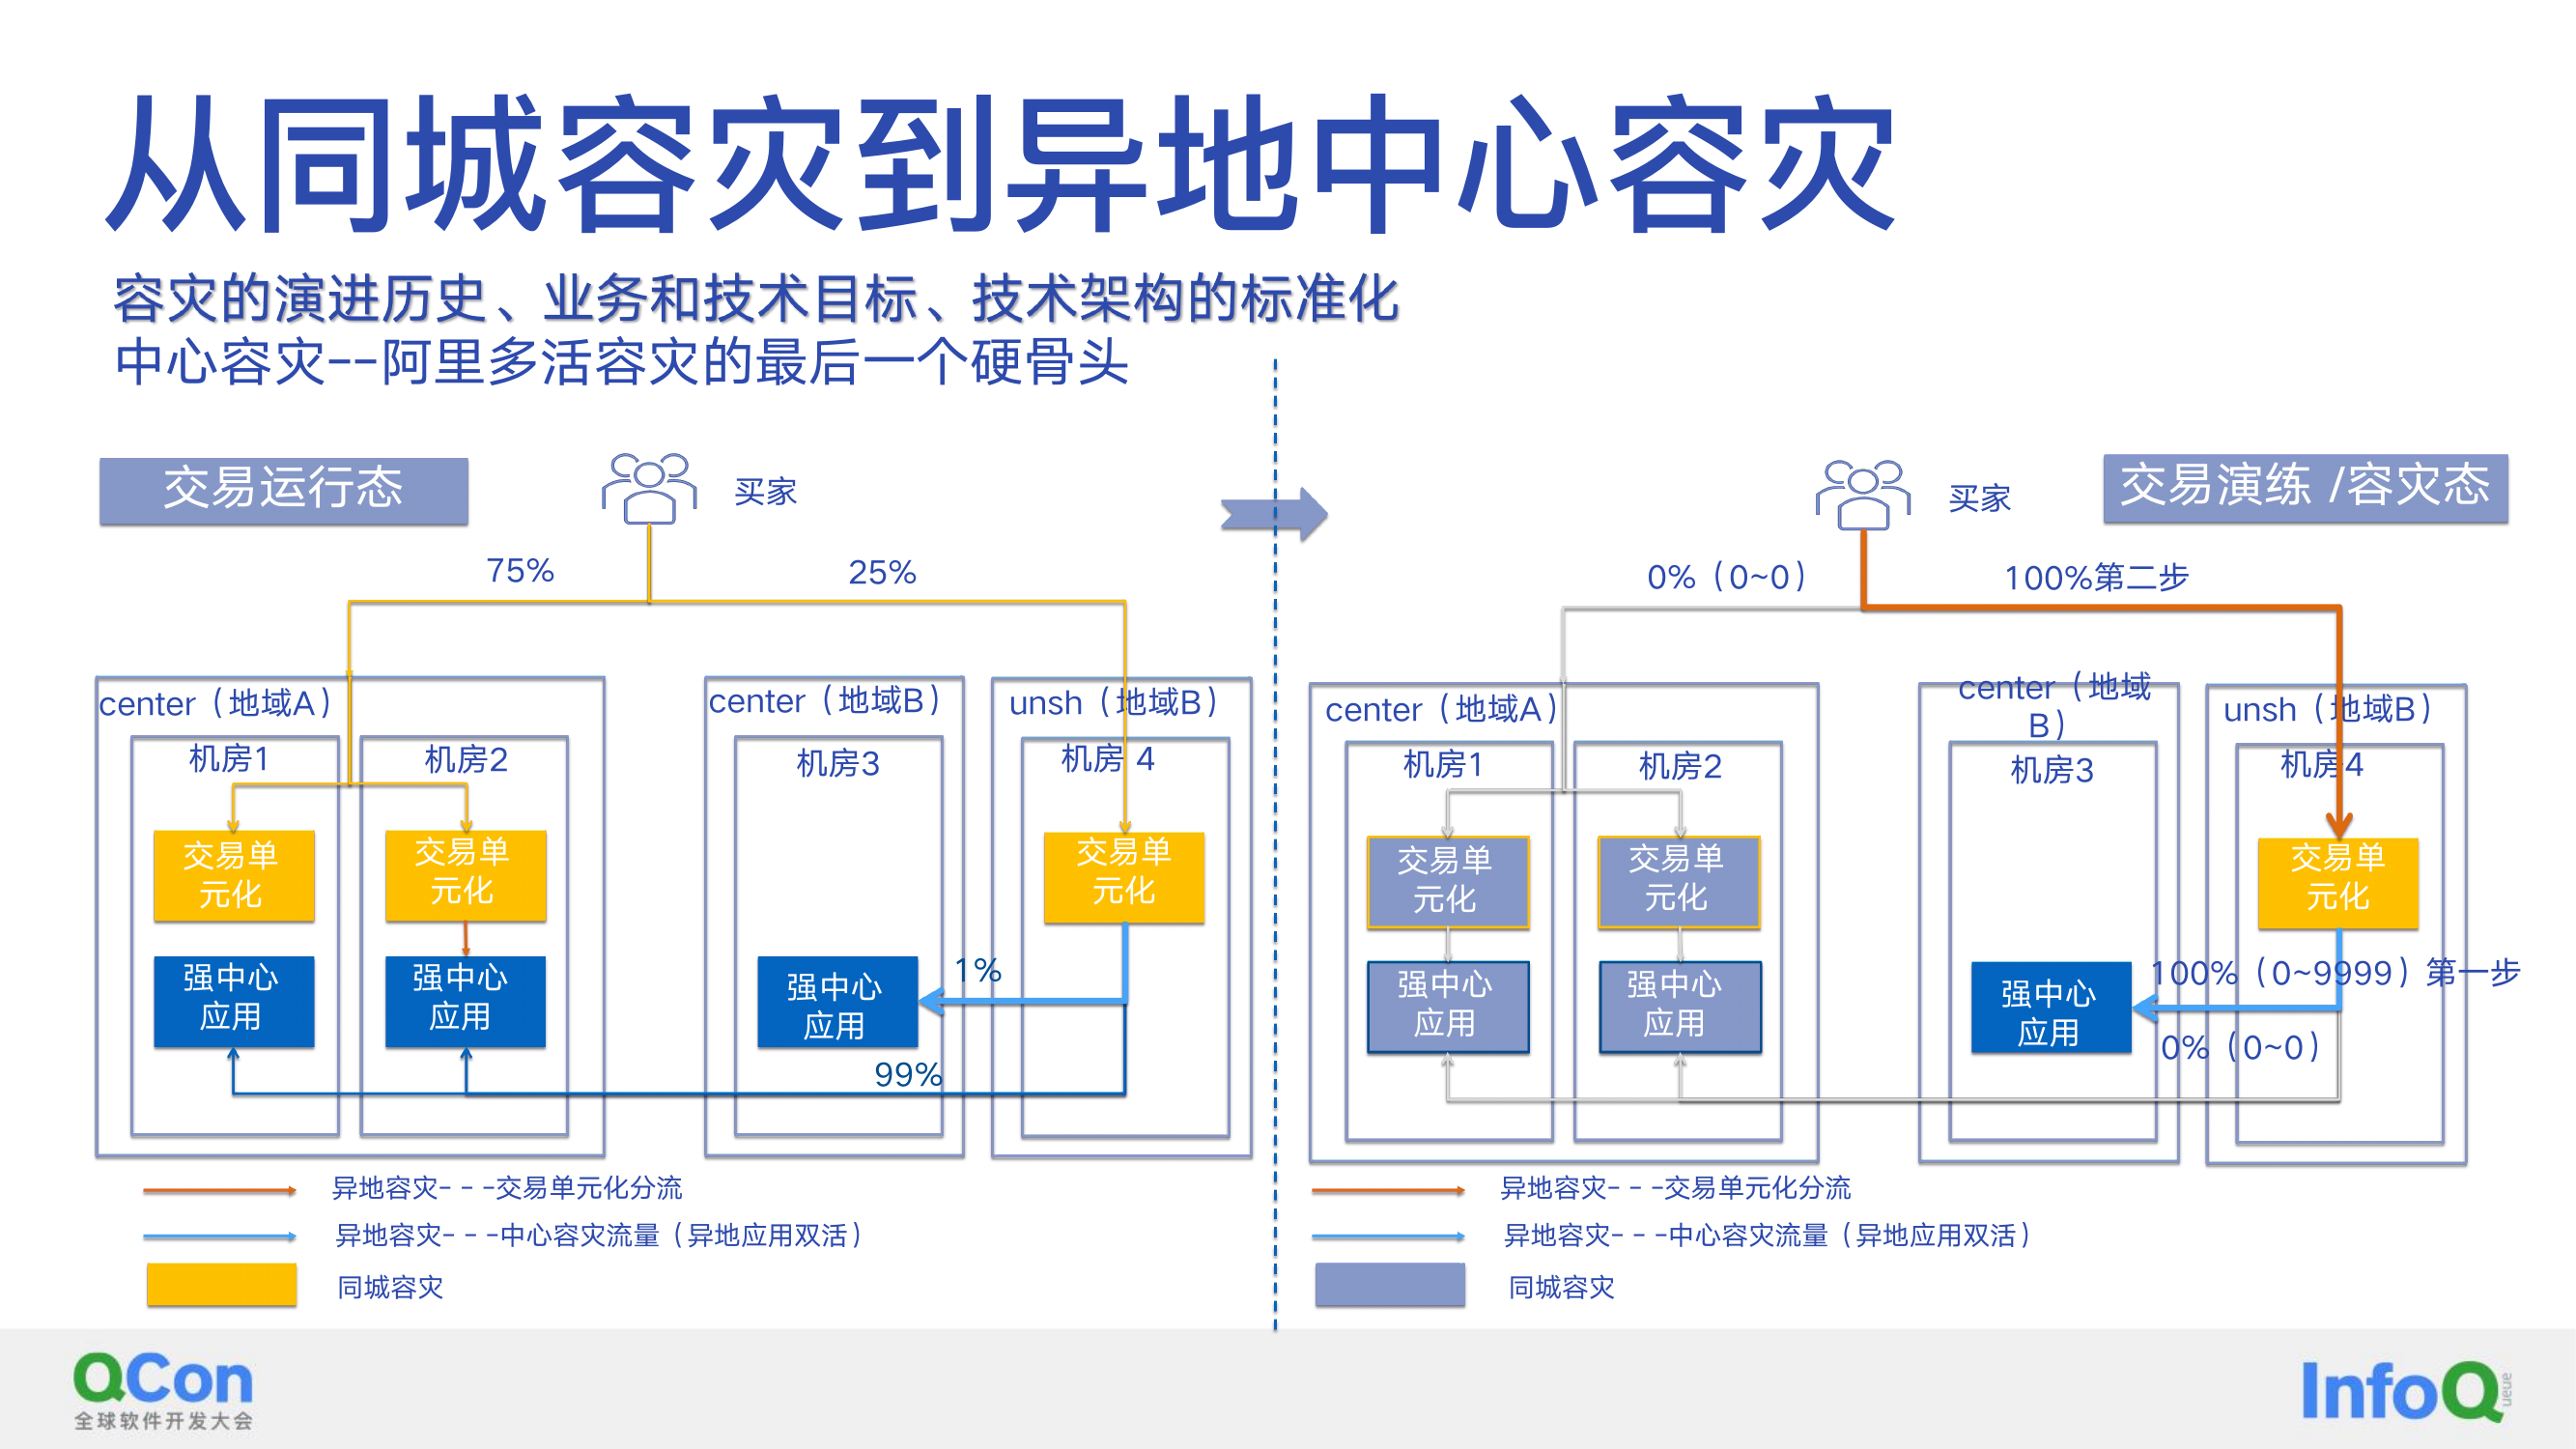
支持从同城容灾到异地中心容灾的全场景覆盖,通过交易单元化分流、异地应用双活、同城容灾三类流量调度策略,实现不同故障场景下的业务平稳运行。
1.13.9 ⑨ 基于 LLM 的智能容灾与自我修复
📄 来源飞书文档(内部 wiki):https://bytedance.feishu.cn/wiki/U85CwvGPqihYW7kCmbrcNkuNnOd
-
错误捕获上报阶段:通过全局错误事件捕获异常,获取完整错误栈信息后完成错误归类统计、等级判断与趋势分析;
-
智能修复阶段:将源码、报错行数、错误信息等标准化后输入 LLM,由 LLM 分析生成修复后的代码,自动触发 DevOps 流水线完成代码检查、部署上线与后续监控,实现故障无人值守自动修复。
9 篇参考资料(内部 wiki):
-
https://bytedance.feishu.cn/wiki/ZyyBwmKvUiAQYHkEPHlcqX5nnUe
-
https://bytedance.feishu.cn/wiki/EgCUwWrAki8ZGNkpGanc4EEAnZd
-
https://bytedance.feishu.cn/wiki/Te86wuuCbitOepksLYHcDlINnTd
-
https://bytedance.feishu.cn/wiki/ESz0woT4hibY1OknO9Acj8J9nkh
-
https://bytedance.feishu.cn/wiki/T2JPwv24AiGMkUkloX0czA8Nn2R
-
https://bytedance.feishu.cn/wiki/A1zAw3PnYihj3Ok2wc0cpa2lnPe
-
https://bytedance.feishu.cn/wiki/K0tqwUMWaiRPIOk9gIRcSEtrnhd
-
https://bytedance.feishu.cn/wiki/FiNTw3aLhixToUkgrATcZdunnAb
-
https://bytedance.feishu.cn/wiki/U85CwvGPqihYW7kCmbrcNkuNnOd
2 SRE 事故响应与容灾止损 —— 面试知识手册(第 8 节:容灾与止损·架构防御措施全景)
2.1 容灾与止损:架构防御措施全景
2.1.1 止损手段优先级(按生效速度排序)
| 优先级 | 手段 | 生效时间 | 适用场景 | 风险 |
|---|---|---|---|---|
| 1 | 回滚变更 | 秒~分钟 | 变更引发(占故障 60-70%) | 数据不兼容时不可回滚 |
| 2 | 开关降级(Feature Flag) | 秒级 | 单功能异常 | 需预埋开关 |
| 3 | 限流 / 熔断 | 秒级 | 流量洪峰、下游雪崩 | 主动牺牲部分请求 |
| 4 | 切流 / 摘除节点 | 分钟级 | 单 AZ / 单机房故障 | 需多活能力 |
| 5 | 扩容 | 分钟~十分钟 | 容量不足 | 慢,且冷启动可能加剧 |
| 6 | hotfix 发布 | 十分钟~小时 | 无法回滚的代码缺陷 | 最慢、最易引入二次故障 |
面试要点
:能把这张表按「生效速度」而非「技术先进性」排序,说明你真的在追 MTTM。
hotfix 永远是最后手段
。
2.1.2 架构层防御措施
2.1.2.1 故障域隔离(Blast Radius Control)
-
单元化 / Set 化:把用户按维度切分到独立单元,单元内自闭环,故障只影响一个单元。
-
舱壁隔离(Bulkhead):核心与非核心共享资源时物理隔离连接池 / 线程池。TikTok 案例中「非核心统计 SQL 打垮核心链路」就是舱壁缺失的典型。
-
依赖分级:强依赖(挂了就不可用)必须冗余;弱依赖必须可降级。定期做「弱依赖强依赖化」审计 —— 很多故障源于本该弱依赖的组件被写成了强依赖。
2.1.2.2 多活与容灾等级
| 等级 | 能力 | RTO | RPO |
|---|---|---|---|
| 冷备 | 备份数据,需手工重建 | 小时~天 | 小时 |
| 热备(主备) | 备用环境常驻,需切换 | 分钟 | 分钟~秒 |
| 同城双活 | 两 IDC 同时承载,可互切 | 秒~分钟 | \~0 |
| 异地多活 | 跨地域多单元同时服务 | 秒 | \~0(需解决数据一致性) |
RTO
(Recovery Time Objective)= 可容忍的恢复时长;
RPO
(Recovery Point Objective)= 可容忍的数据丢失量。面试必答。
2.1.2.3 韧性模式(Resilience Patterns)
-
熔断(Circuit Breaker):下游连续失败达阈值即快速失败,避免线程堆积。三态:Closed → Open → Half-Open。
-
重试 + 退避 + 抖动:必须带指数退避 + 随机抖动,否则重试风暴会把恢复中的下游二次打死。
-
超时:任何跨进程调用必须设超时,且上游超时 > 下游超时之和(否则无效)。
-
降级:预设兜底数据(缓存快照、静态页、只读模式)。
-
背压 / 限流:令牌桶 / 漏桶 / 自适应限流(如基于 BBR 的过载保护)。
2.1.2.4 混沌工程(Chaos Engineering)
-
原理:在受控条件下主动注入故障,验证系统韧性假设。
-
注入类型:实例宕机、网络延迟 / 丢包、依赖慢化、AZ 级断网、DB 主从切换。
-
实践要点:先在预发跑 → 有明确的 abort 条件 → 有稳态指标(steady state)定义 → 逐步扩大爆炸半径。
-
关键价值:演练过的预案才是预案。TikTok 案例的核心教训之一就是迁移后缺演练。
3 附录:14 篇容灾稳定性行业实践文档精读(QCon / 行业大会 PDF)【2026-09-09 补充】
来源:用户提供的 14 篇飞书 wiki PDF(QCon 上海 2025 / QECon / GOPS 等大会分享),逐篇通读后结构化提炼 "原理 + 实践 + 关键页截图"。截图均为原 PDF 关键页渲染,非中间过渡页。 覆盖主题:RCA Agent、AI 研发数字员工、广告可观测、银行多活、交易平台 DevOps、IoT 应急、蚂蚁应急体系、稳定性与安全体系、B 站容灾演练、LLM 智能容灾、微服务架构、Android WPS、大数据安全、有状态上云。
3.1 郭勇良《复杂业务场景下 RCA Agent 的探索实践》(快手,RCA Agent 从 0 到 1)
📄 来源飞书文档:郭勇良《复杂业务场景下 RCA Agent 的探索实践》(https://my.feishu.cn/wiki/J3x0wIKqQihFi7kNUiIc32uunTh)
背景与痛点
-
AI Coding 已大体解决编码问题,下一个待解问题是排障(RCA):业务层问题是 "无法预测步骤数量" 的开放问题,必须由 LLM 动态决策,无法用固定 SOP 穷举。
-
四个核心挑战:① 理解业务;② 对抗噪声;③ 衡量不确定性;④ 对抗幻觉。
挑战一:理解业务 = 建立业务上下文
-
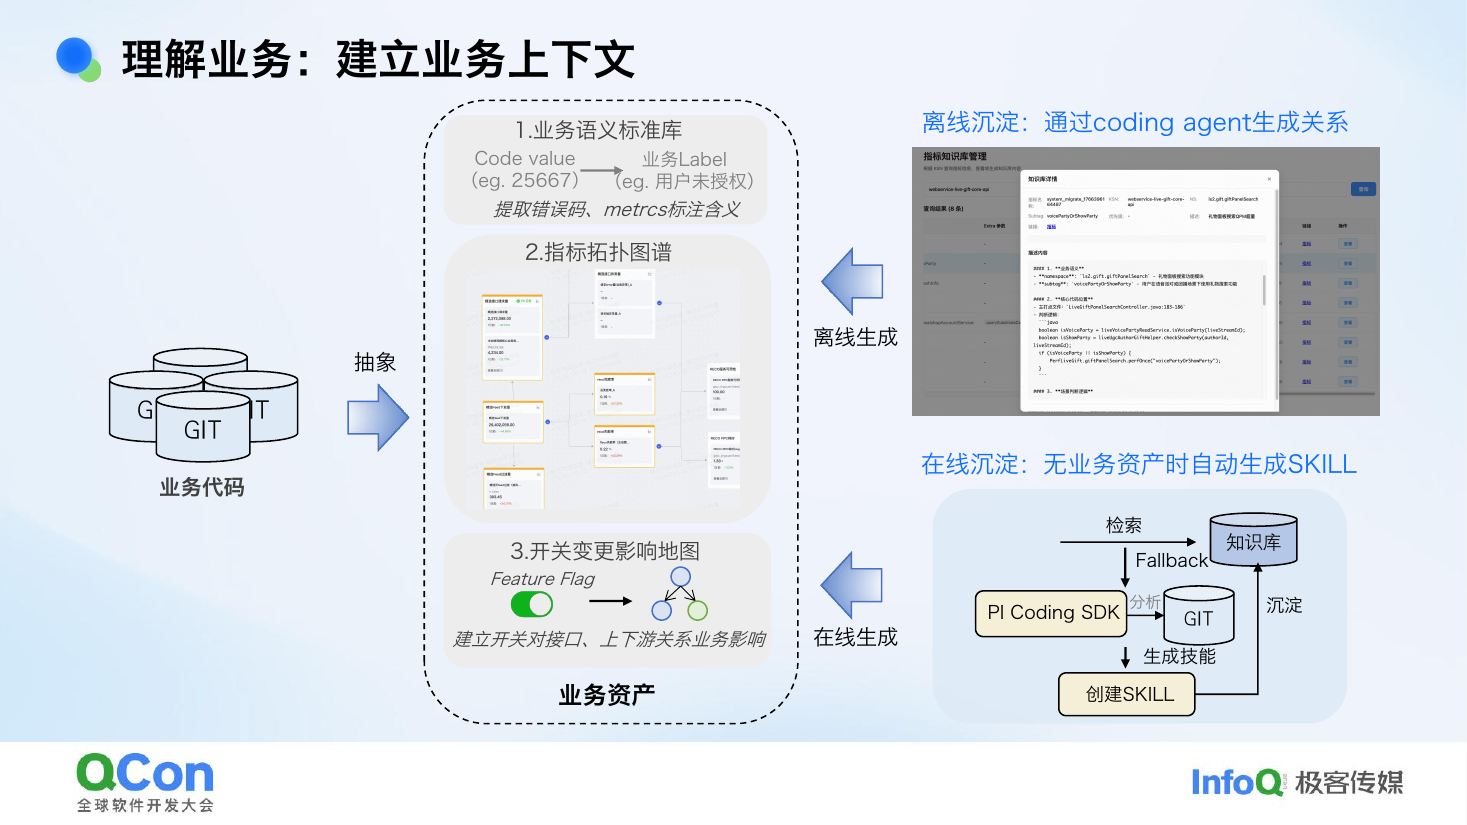
业务语义标准库 / 指标拓扑图谱 / 开关变更影响地图 = "业务上下文三件套",消除人和 AI 的 Context 代差。
-
离线:coding agent 沉淀;在线:自动生成 SKILL。让 AI 拥有与资深工程师对等的业务上下文。
挑战二:对抗噪声
-
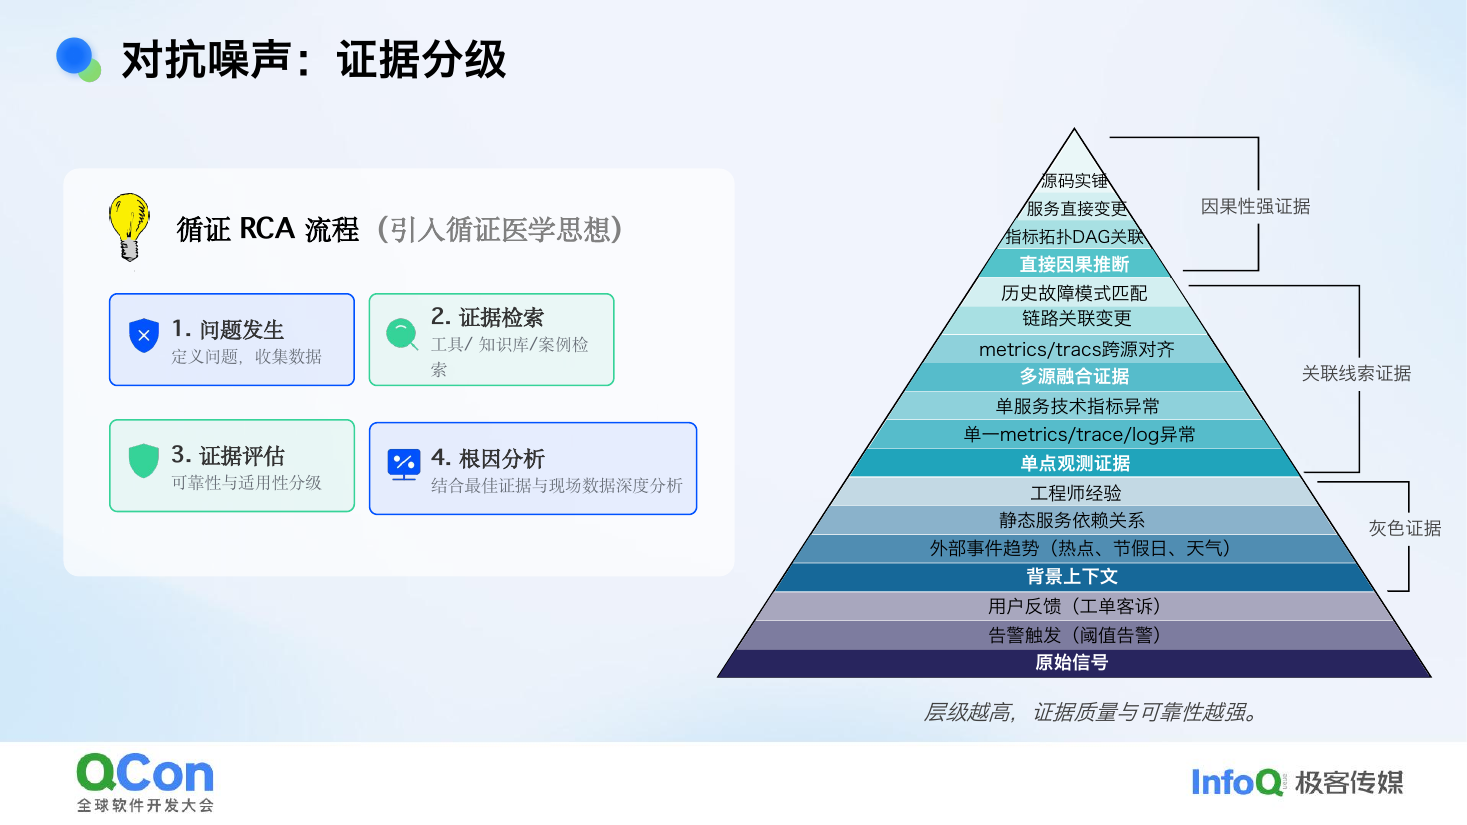
现实噪声占比 >75%;告警疲劳严重(7 天 15 次静默);全量 Agent 推理月均 100 亿 + Token,成本不可控 → 必须在 "入水口" 做置信度评估过滤,而不是让 Agent 处理全部告警。
-
循证 RCA 证据分级金字塔:因果性强证据 > 关联线索证据 > 灰色证据 —— 只信强证据,线索当线索用。
挑战三:衡量不确定性(Benchmark 平台)
-
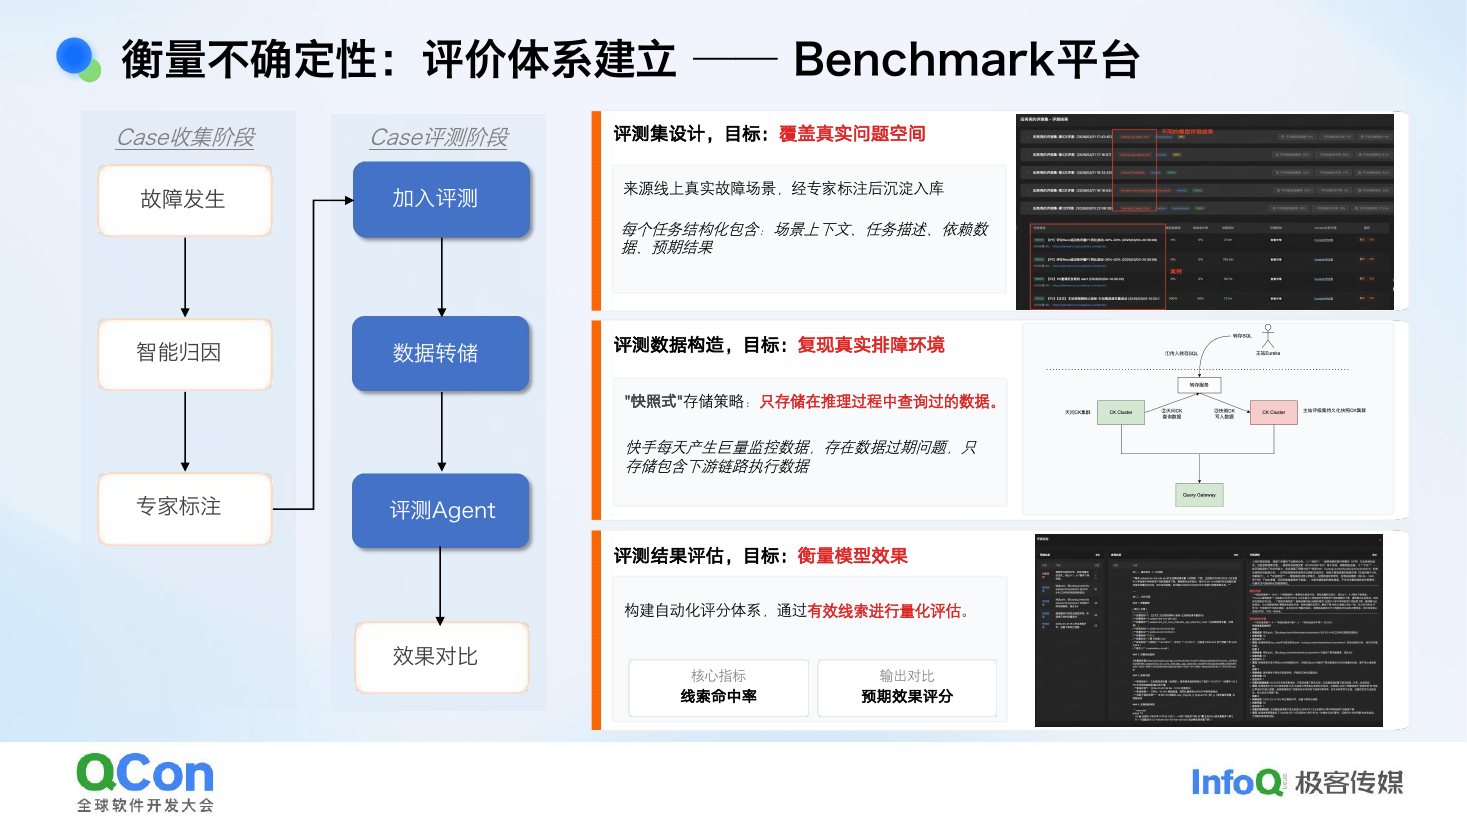
现实:优化 1 个 bad case 引入 3 个新的 → 必须建 Benchmark 平台量化。
-
Case 收集(故障发生 → 智能归因 → 专家标注)+ Case 评测(加入评测 → 数据转储 → 评测 Agent → 效果对比);快照式存储只存推理中查过的数据;核心指标 = 线索命中率。
挑战四:对抗幻觉
- LLM 不擅长数值计算(如时间戳换算),用工具约束 > 直接询问;工程化封装 Tool/Skill 优于裸 Prompt;算子库 + AutoResearch/CodeAct 实现自进化。
架构设计
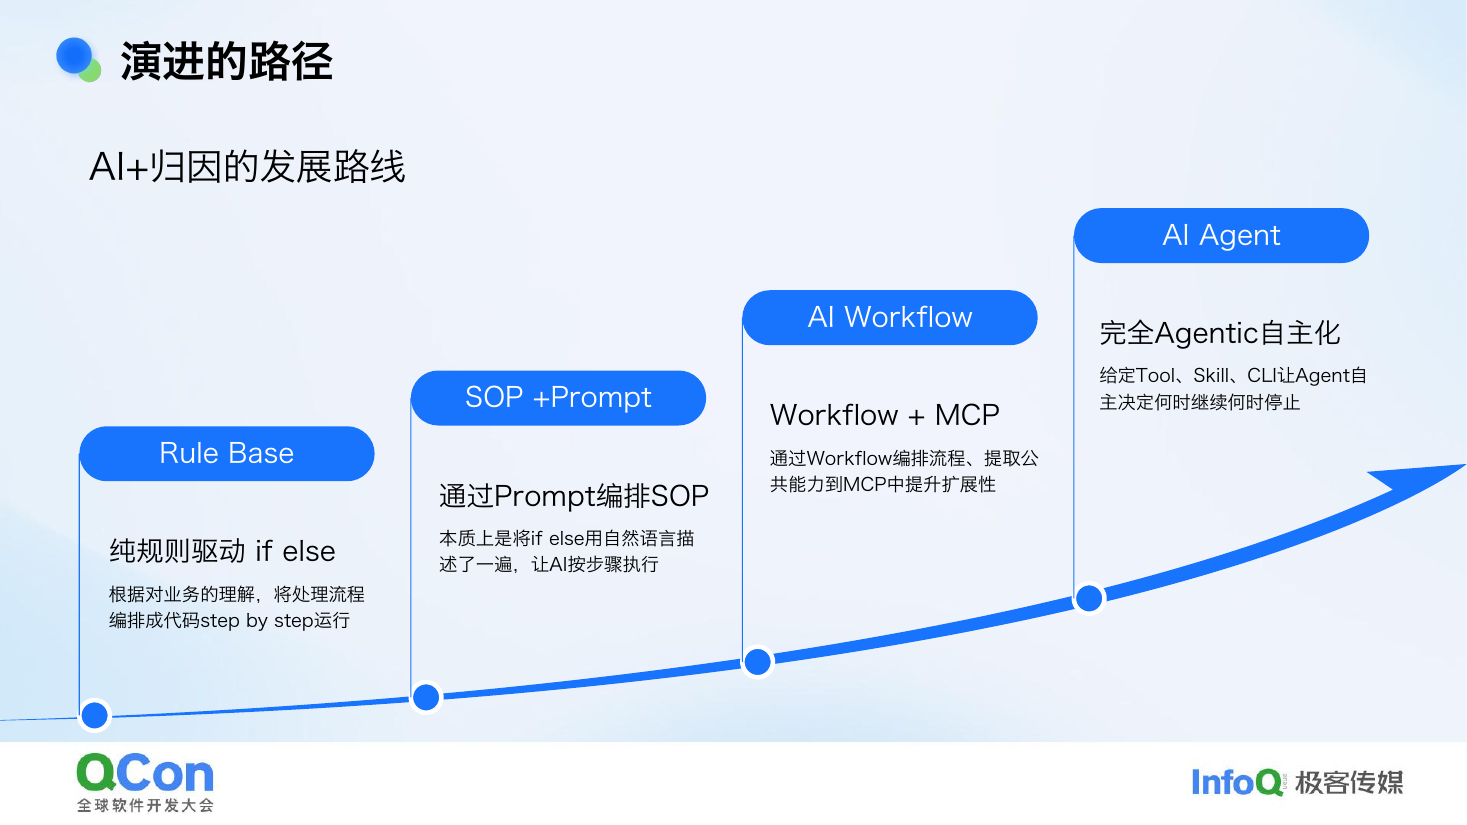
- 演进路径:Rule Base → SOP+Prompt → AI Workflow → AI Agent;Workflow 确定可控 vs Agent 灵活但需工程约束。
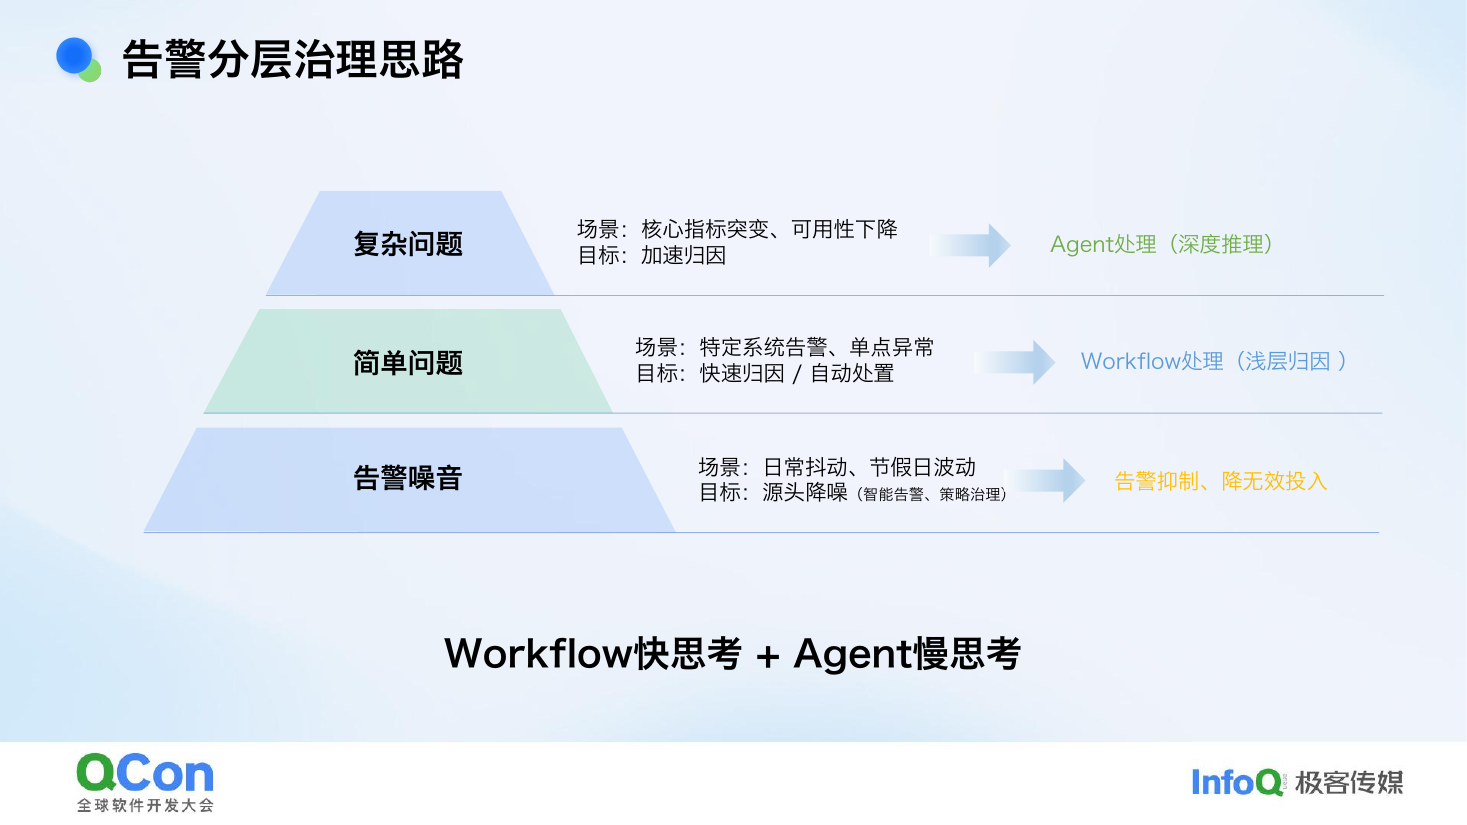
- 告警分层治理:复杂问题 → Agent 深度推理;简单问题 → Workflow 浅层归因;告警噪音 → 源头降噪。
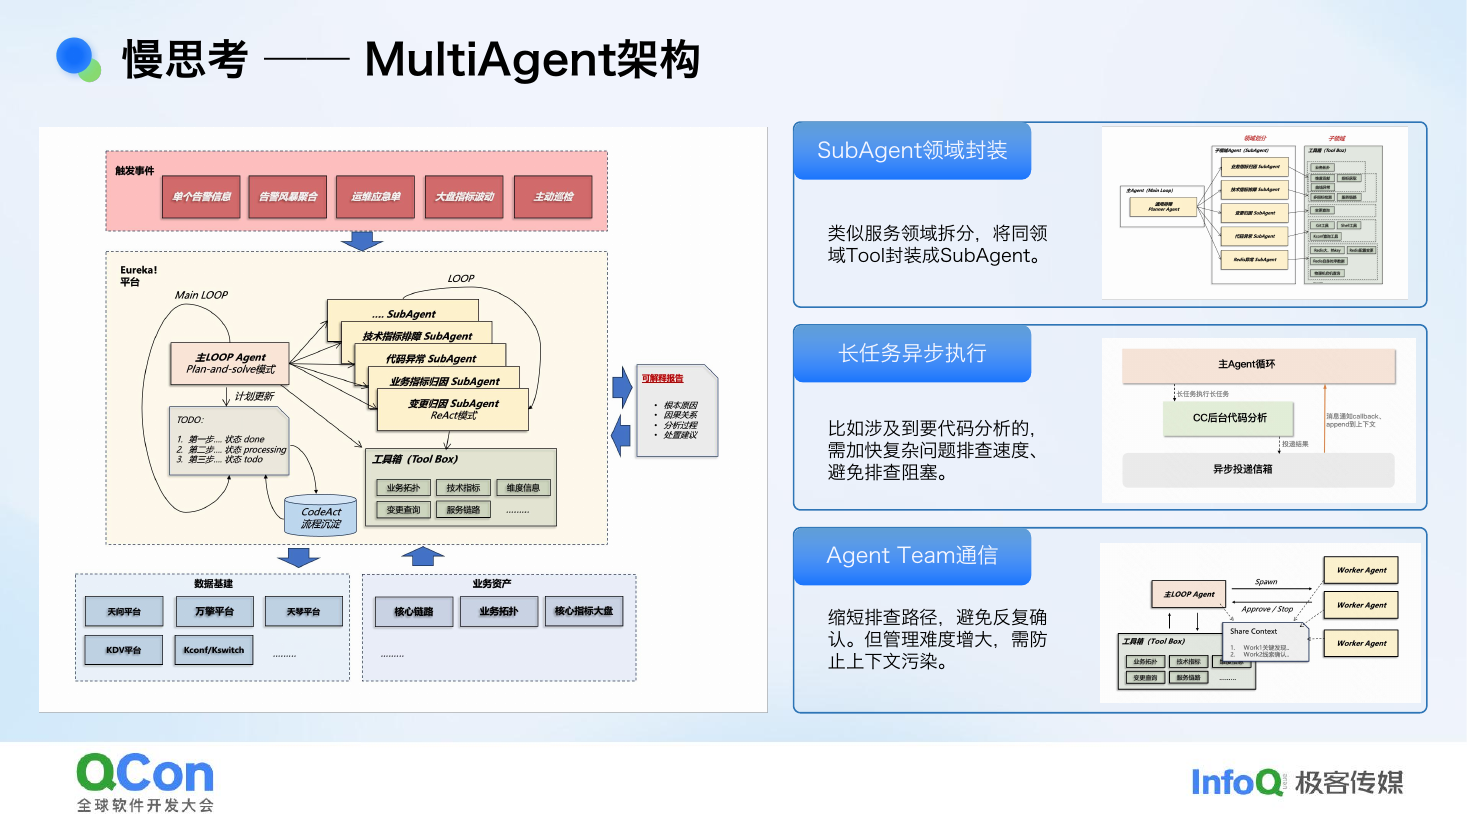
- 快思考 Workflow + 慢思考 MultiAgent:SubAgent 领域封装、长任务异步执行、Agent Team 通信防上下文污染。
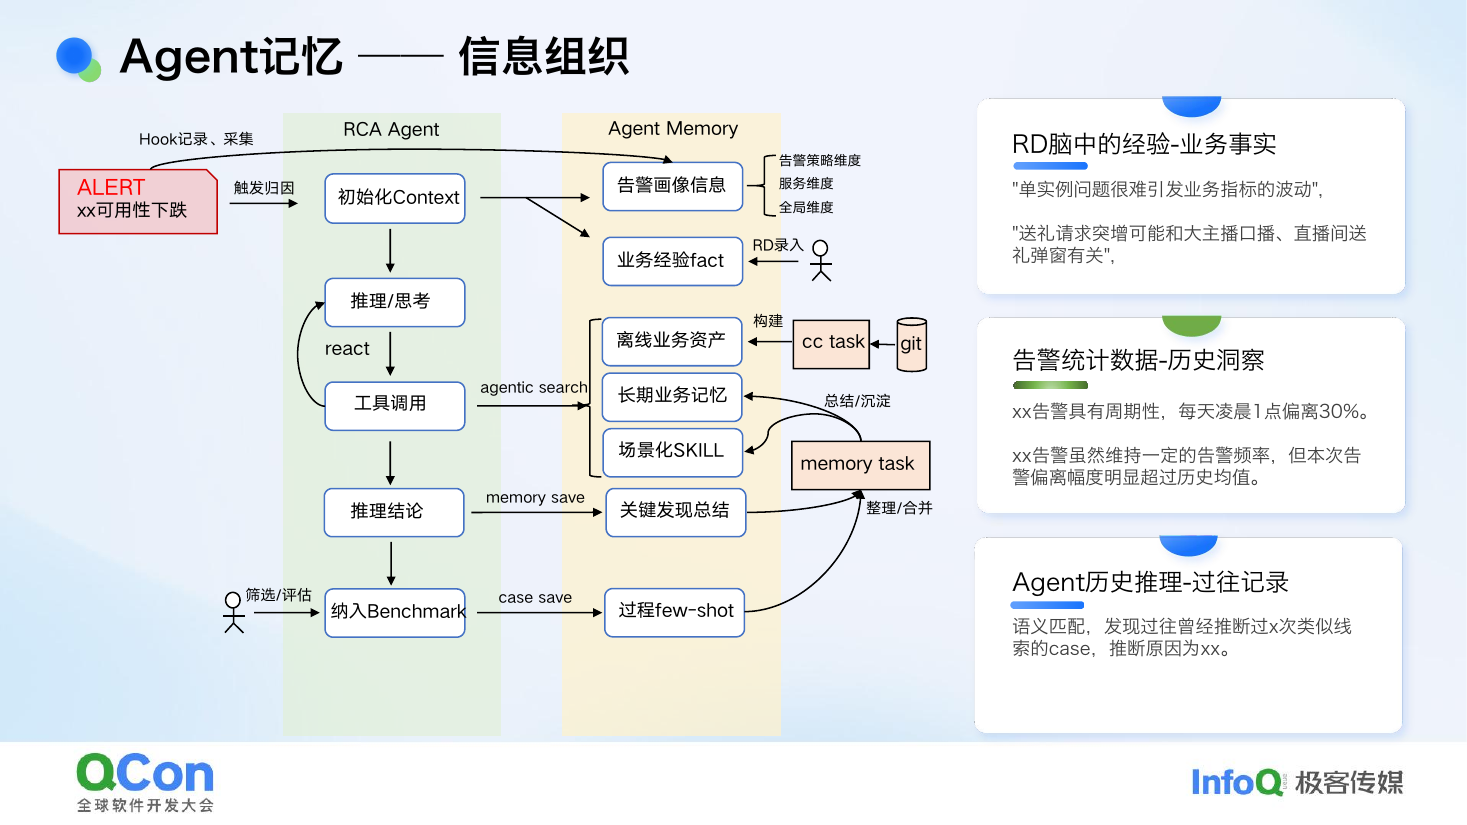
- Agent 记忆 = 告警画像 / 业务经验 fact / 离线业务资产 / 场景化 SKILL / 关键发现 / 过程 few-shot 六类信息组织。
产品交互与落地
-
ChatBot → AI Native(自动拉群、实时推送);问题感知 → 归因排障 → 协同处置 → 经验沉淀,形成自闭环。
-
落地成果:整体准确率 80%+、推理准确率 60%+(含线索);过程指标 = 有效线索率 / 归因准确率 / 归因时长。
-
踩坑 5 条:LLM 频繁失败需 Failover;API 接口不匹配;模型性能差异;数据缺失降级追问而非幻觉;重试 vs Fail Fast 防钻牛角尖。
-
总结:从面向人到面向 Agent(上下文有限→无限、高度分工→上下文同步成本低、信息即权利→透明即效率);可复用稳定层 vs 易变层分离;未来演进 = 辅助决策 → 自主执行 → 自我进化;关键挑战 = 可解释性 / 安全边界 / 人机信任。
3.2 王硕《快手 AI 研发数字员工平台:从局部 AI 提效到全局 AI 提效》
📄 来源飞书文档:王硕《快手 AI 研发数字员工平台:从局部 AI 提效到全局 AI 提效》(https://my.feishu.cn/wiki/Uoy9wZwLhiHl3xk7kdecSeq6nmd)
WHY / HOW
-
不开展 AI 研发提效 = 技术代差(Gartner 预测 2027 年 70% 企业 SDLC 应用 AI)。
-
阶段一 AI 局部提效 → 阶段二 AI 全局提效。
-
第一性原理 = 回归软件工程本身:传统确定性 + 质量护栏 vs AI 概率性 + 更强质量护栏(CR 成本高→智能 CR、单测成本高→智能单测、提示词编写成本高→AI 需求理解 / 工程理解 / 技术设计)。
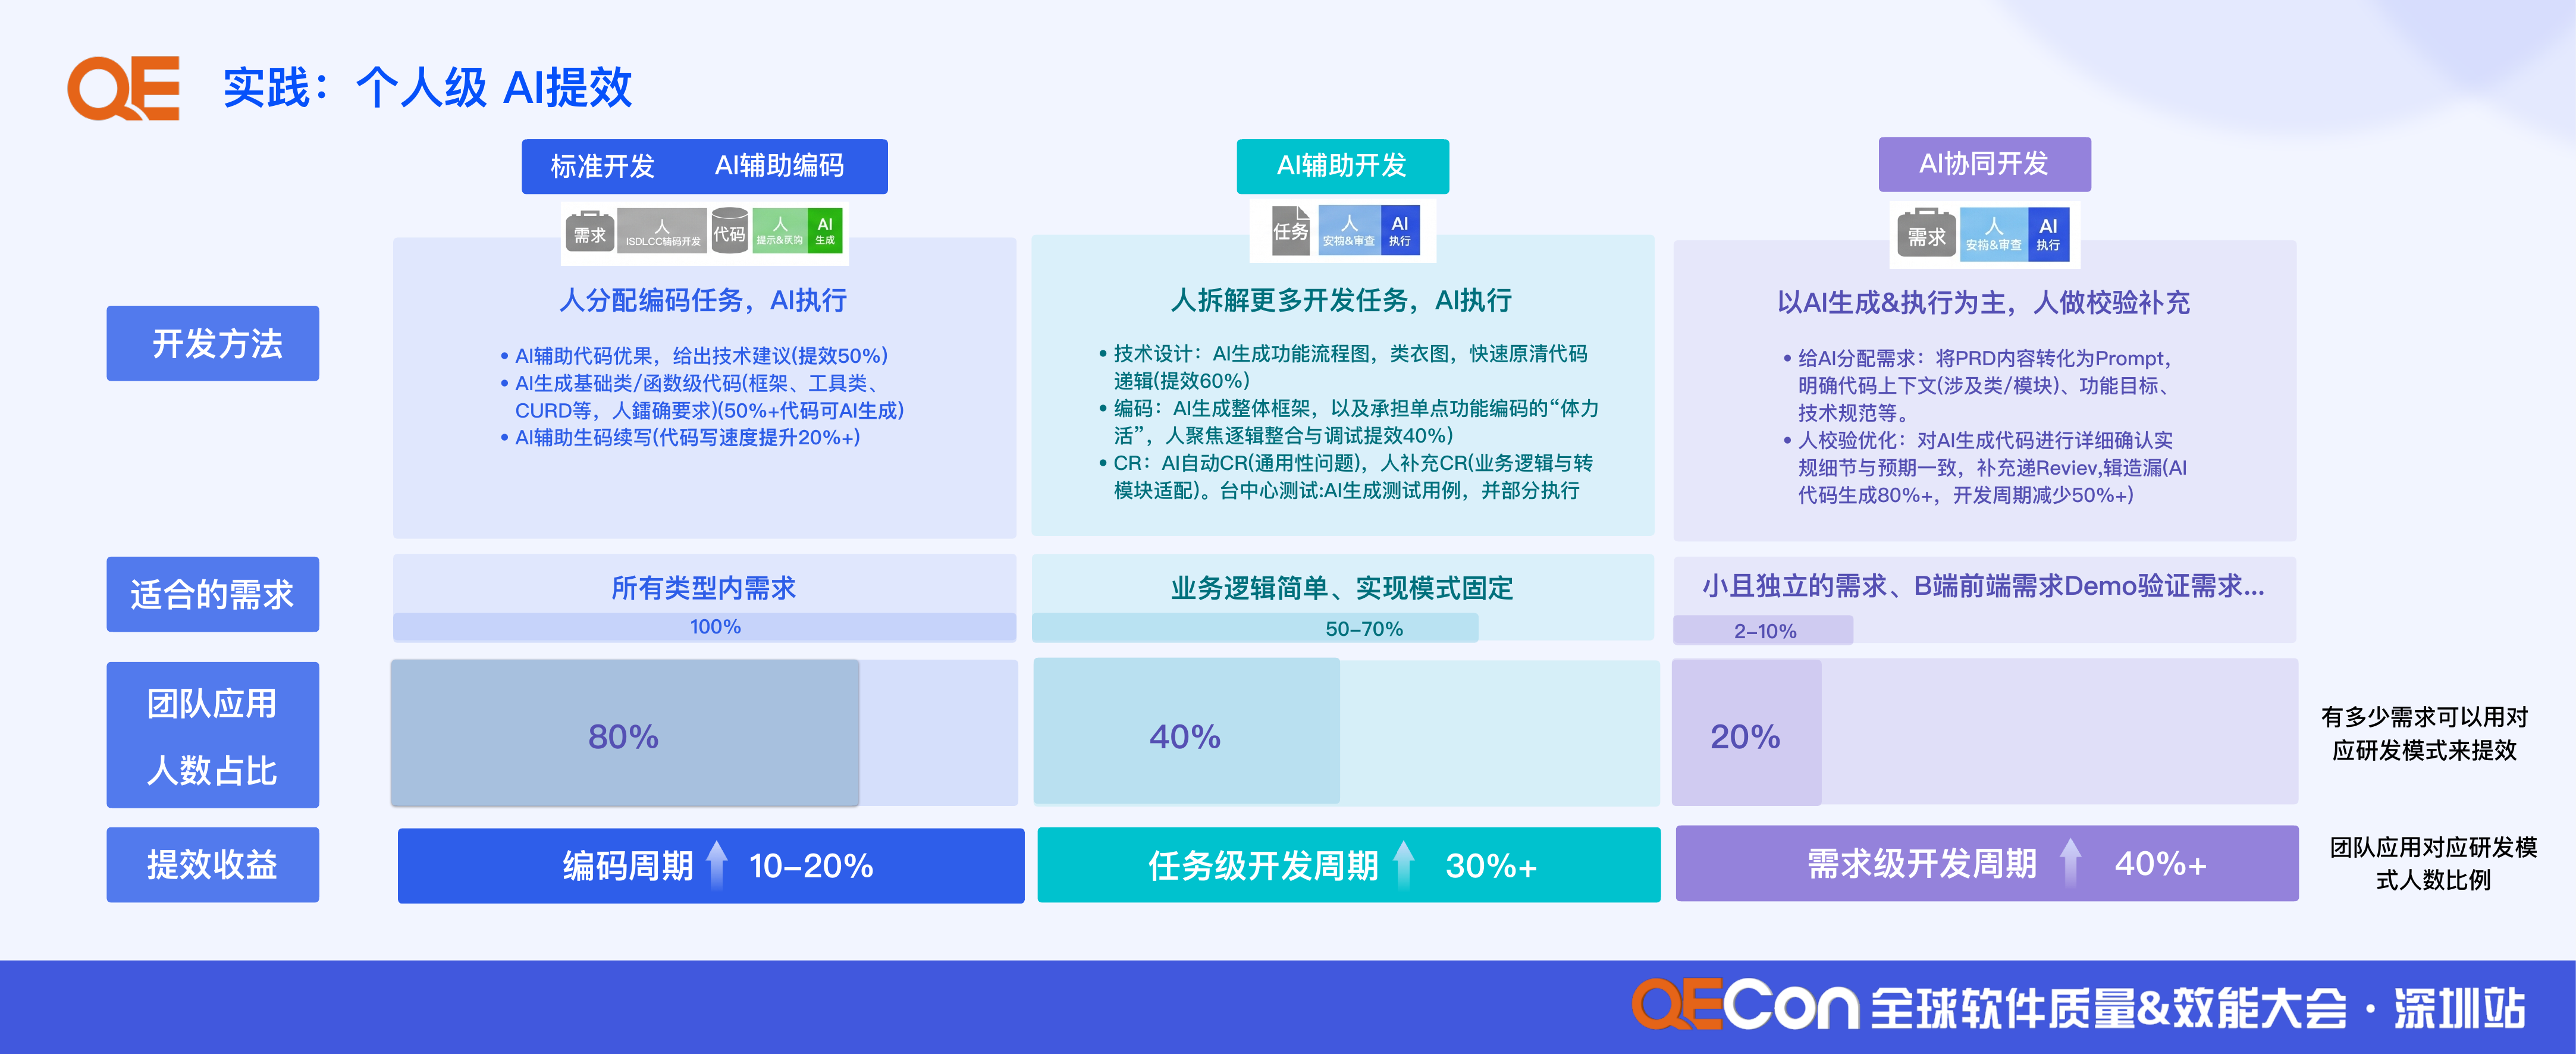
个人级 AI 提效四档(含占比与提效数据)
-
标准开发(AI 辅助编码):人分配编码任务 AI 执行,提效 50%,适合所有类型需求(100%),团队占比 80%。
-
AI 辅助开发:人拆解任务 AI 执行(技术设计提效 60%、编码 40%),适合业务逻辑简单 / 实现模式固定(50-70%),团队占比 40%。
-
AI 协同开发:以 AI 生成 & 执行为主人做校验(AI 代码生成成功率 80%+、开发周期减少 50%+),适合小且独立需求 / Demo(2-10%),团队占比 20%。
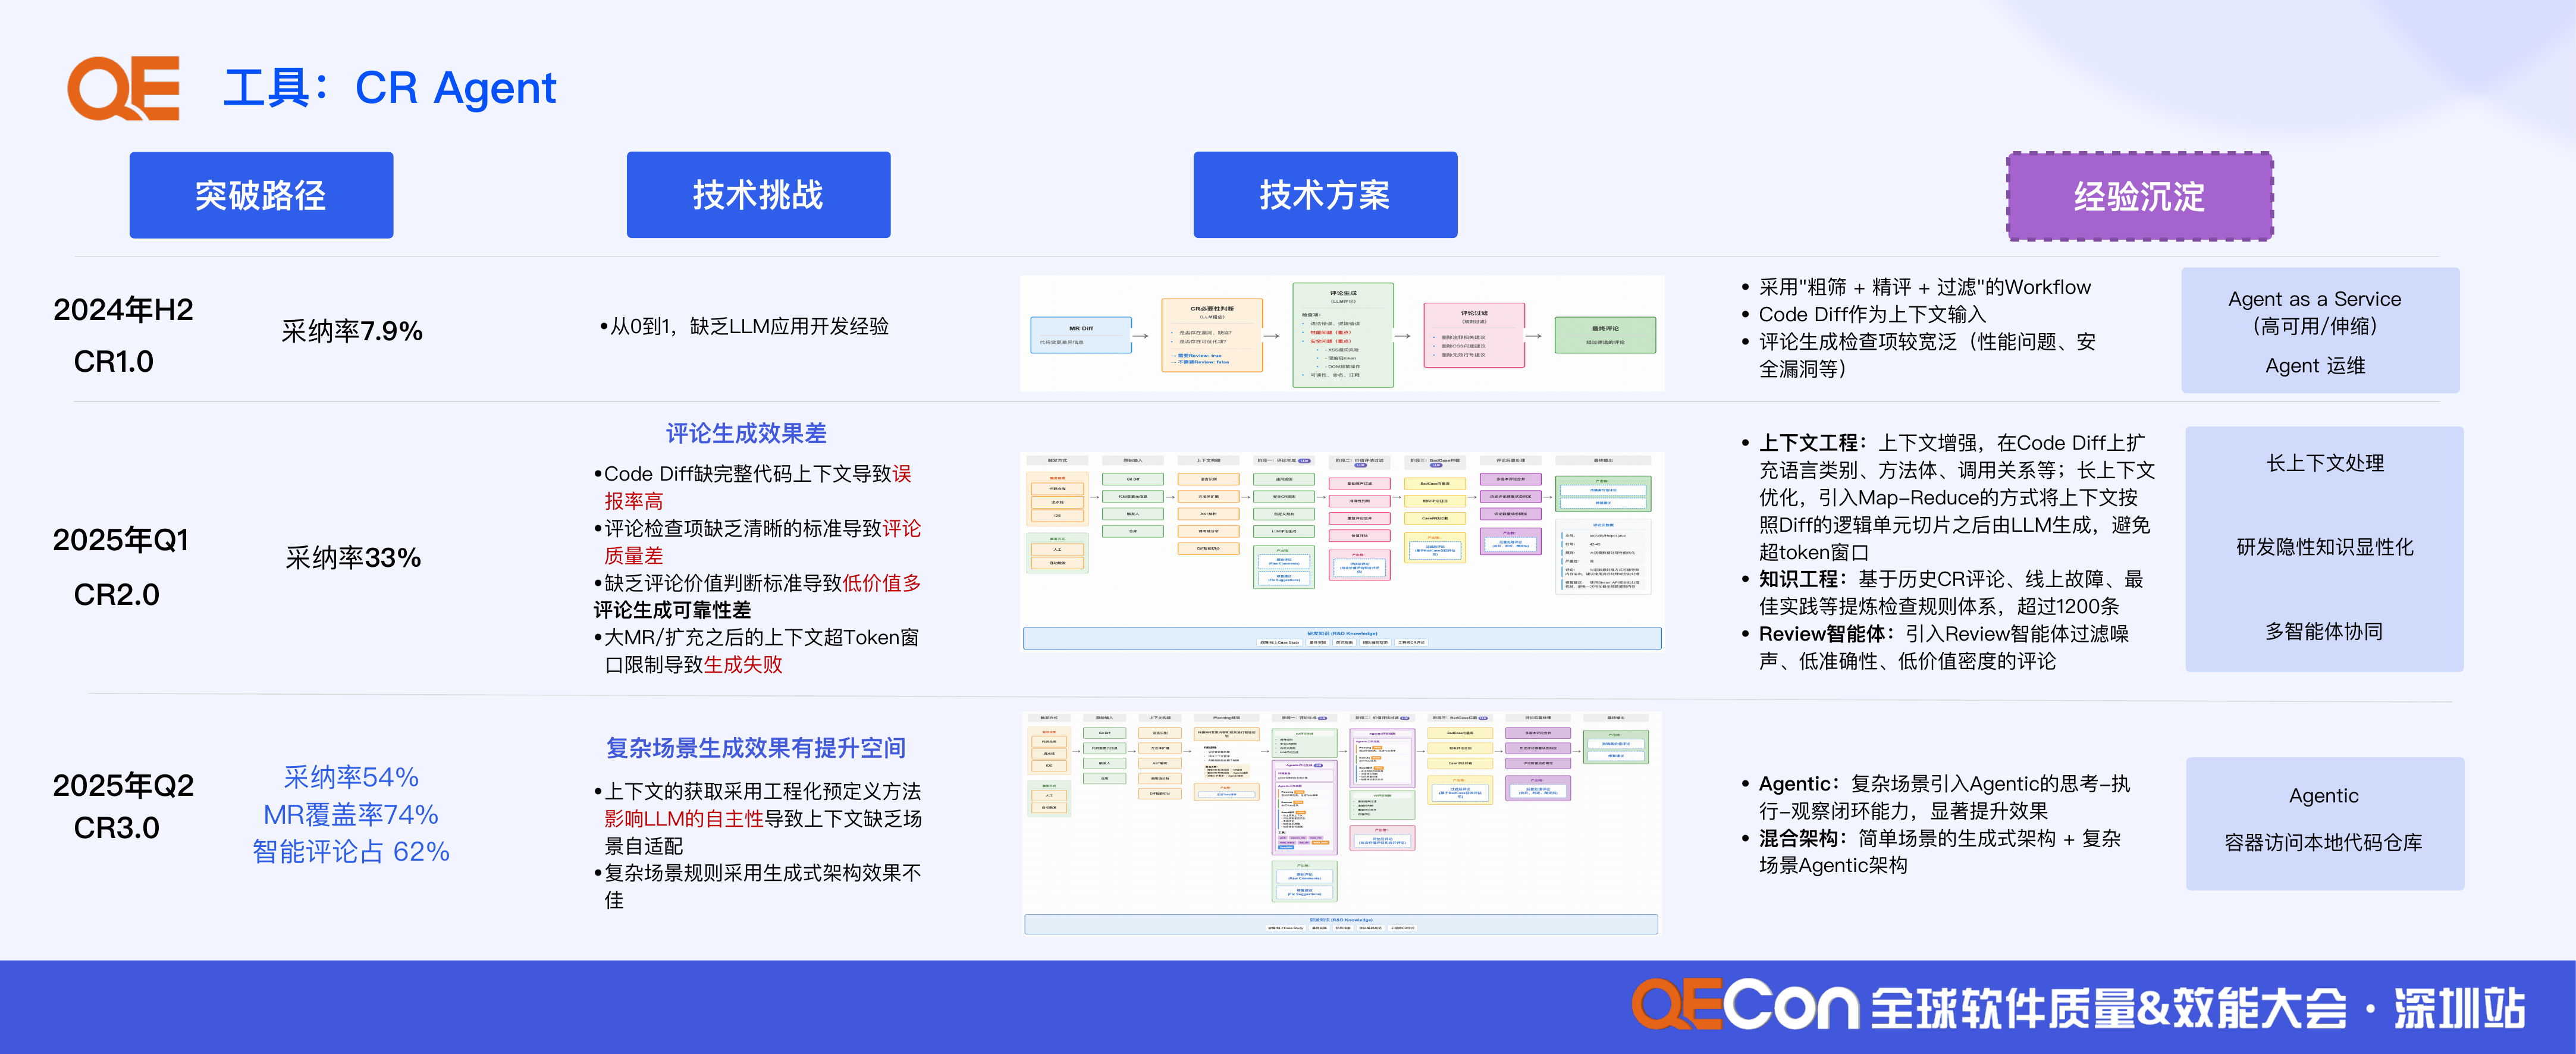
CR Agent 三版演进(知识工程驱动的采纳率跃升)
-
1.0:粗筛 + 精评 + 过滤,采纳率 7.9%。
-
2.0:知识工程沉淀 1200+ 规则 / Skills + Review 过滤,采纳率 33%。
-
3.0:生成式 + Agentic 混合架构、Map-Reduce 上下文切分防超 Token 窗,采纳率 54%、MR 覆盖率 74%、智能评论占 62%。
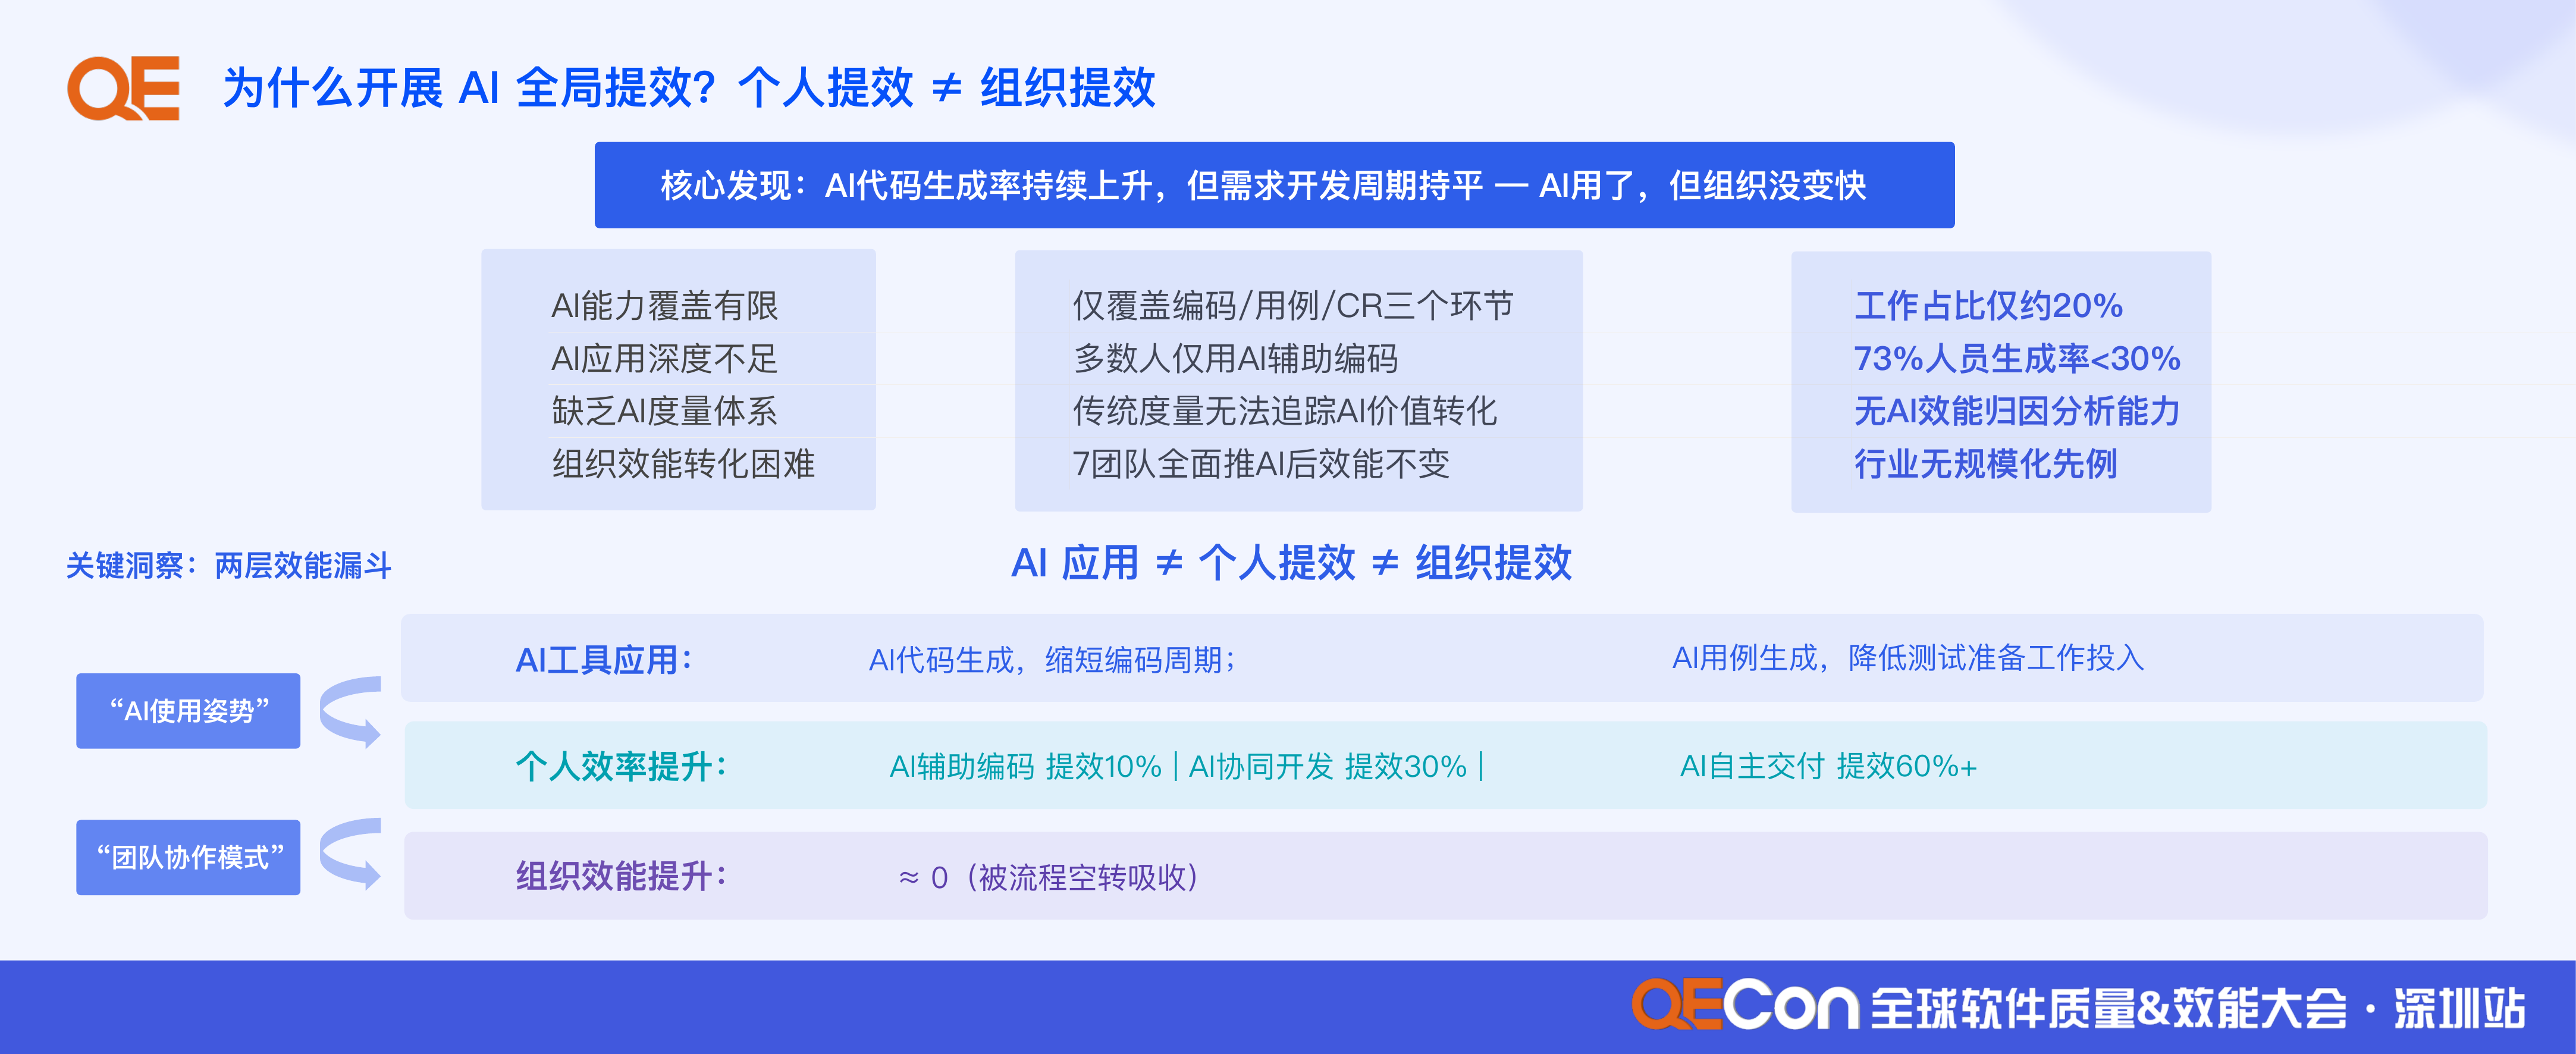
全局提效核心发现:两层效能漏斗
-
AI 代码生成率上升但需求交付周期持平(AI 用了组织没变快)→ 组织效能≈0 被流程空转吸收。
-
漏斗:AI 工具应用 ≠ 个人提效 ≠ 组织提效(个人 AI 辅助 10% / 协同开发 30% / 自主交付 60%+)。
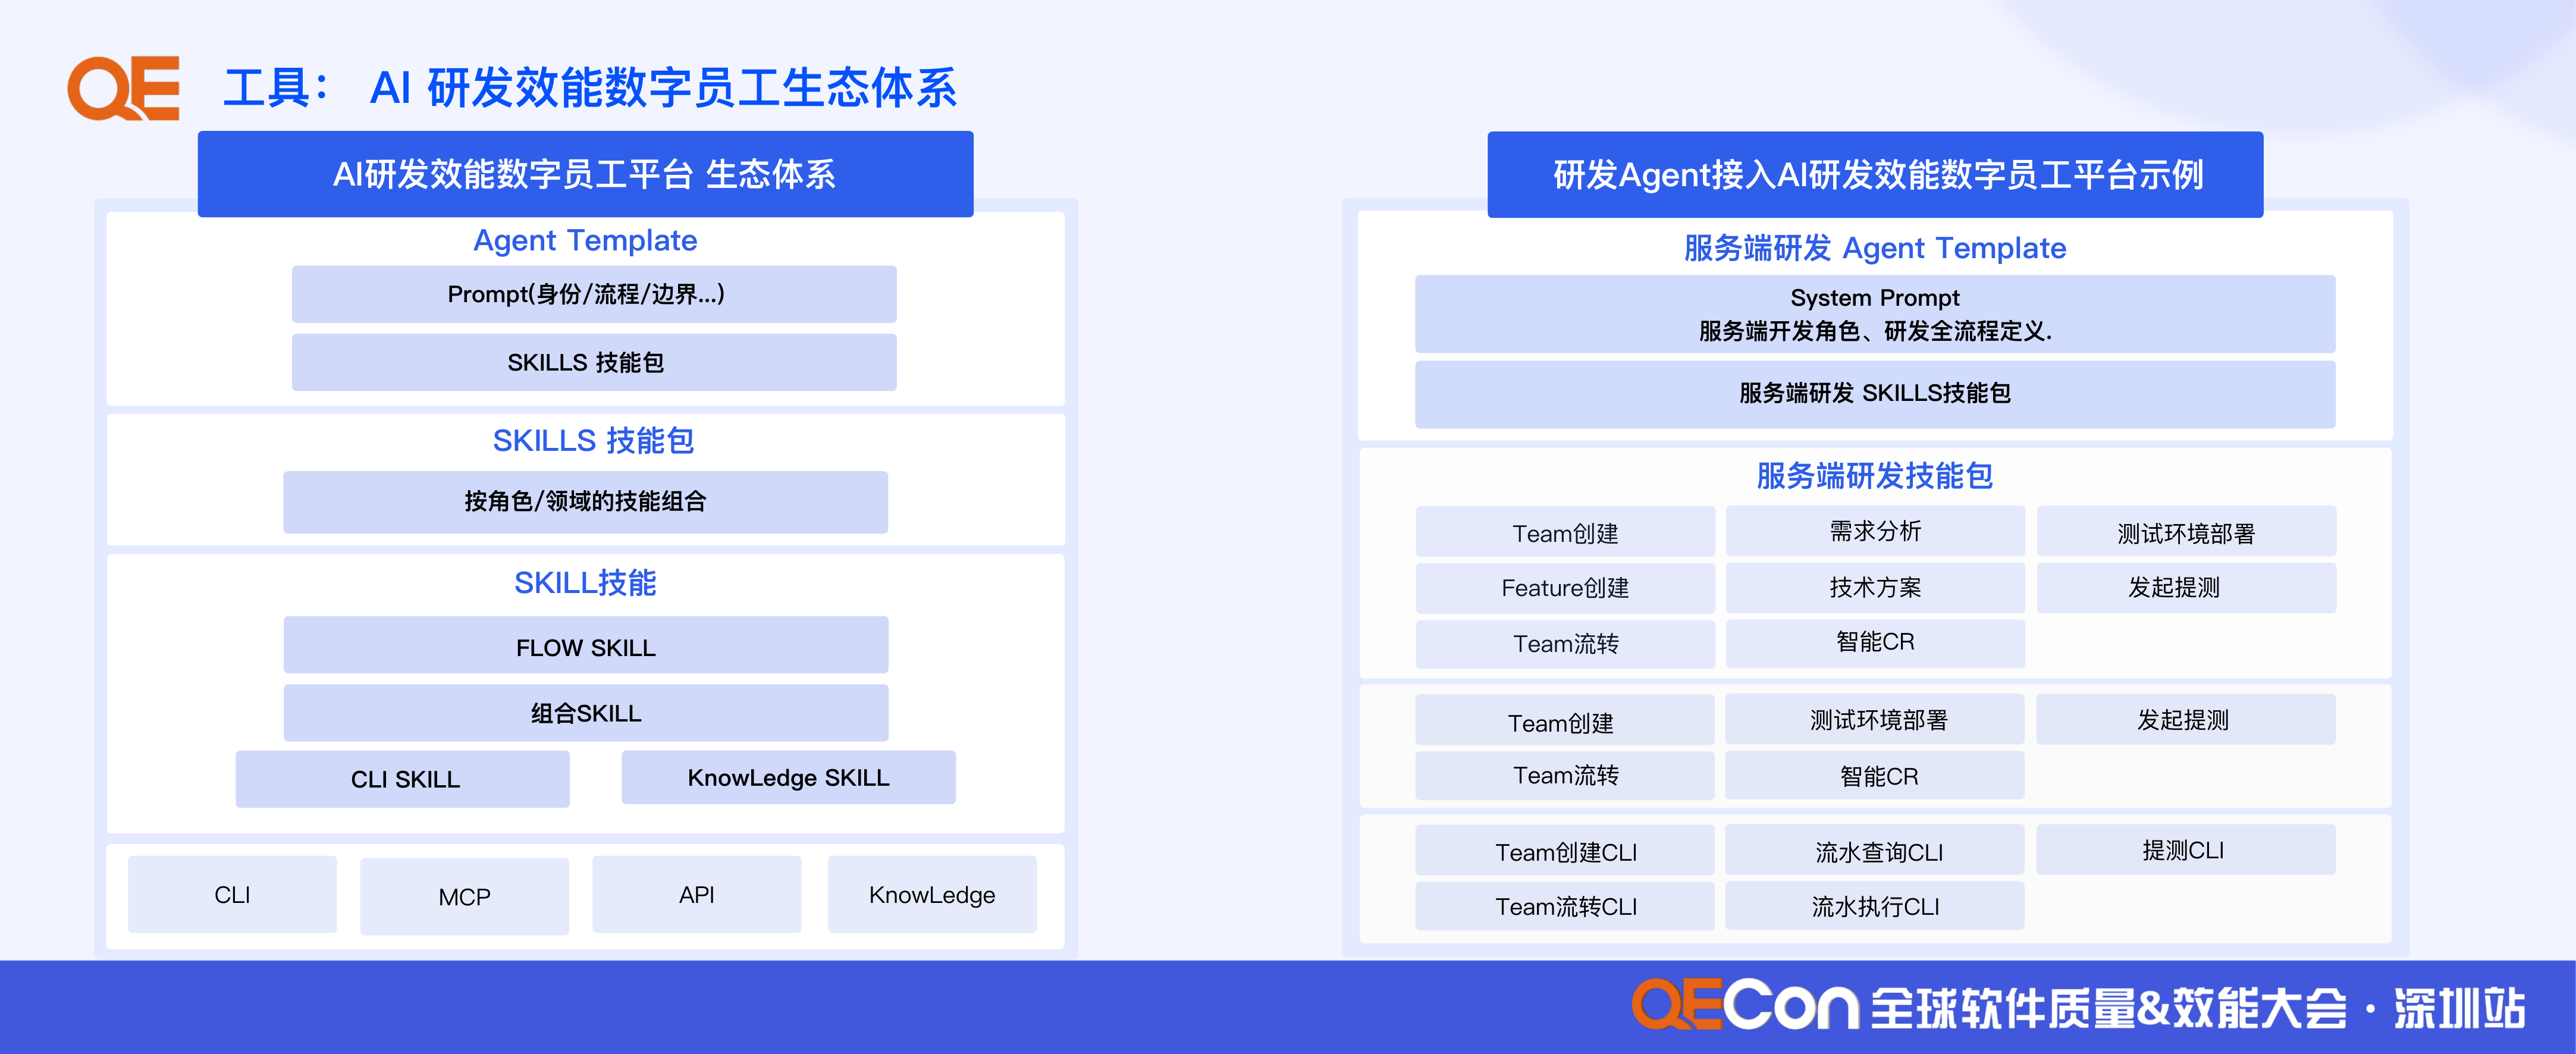
数字员工平台生态
-
Agent Template(Prompt 身份 / 流程 / 边界)+ SKILLS 技能包(SKILL / FLOW SKILL / 组合 SKILL / CLI SKILL / Knowledge SKILL,CLI/MCP/API/Knowledge 接入方式)。
-
度量 = 需求 AI 渗透率;北极星指标 = 人均交付需求数提升 5.98%。
-
2026 战略 = AI 员工 × 全域工具 × 组织提效;核心指标 ROI = 价值 / 成本(Token),量化每个部门 AI 使用 ROI。
3.3 鲜嘉麒《从人工到 AI 驱动:快手广告流量全链路可观测实践》
📄 来源飞书文档:鲜嘉麒《从人工到 AI 驱动:快手广告流量全链路可观测实践》(https://my.feishu.cn/wiki/PCfuwo7VIi7MO6kcPmMcfgUbnVh)
背景
-
广告推荐链路可解释性三难:模型依赖重 / 业务指标多 / 数据链路复杂。
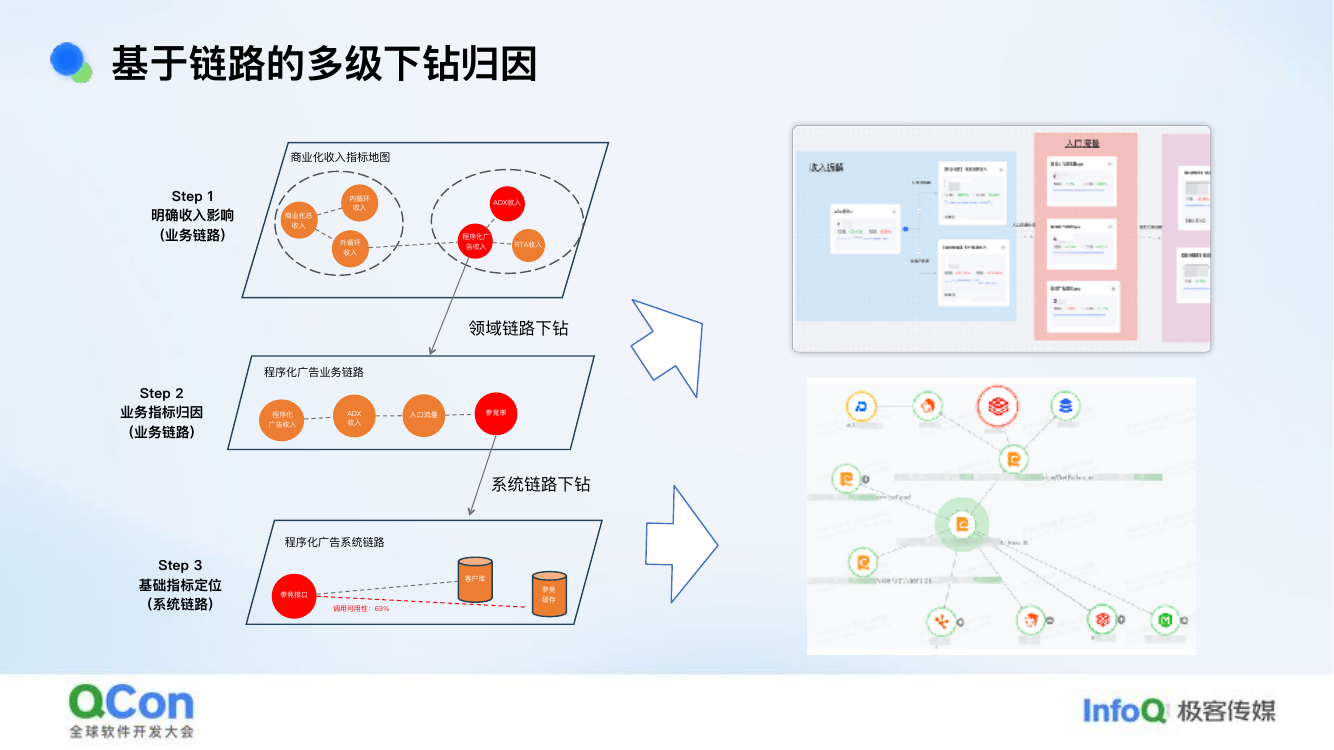
-
消耗 / 成本率归因链路:商业化总收入 → 程序化广告收入(ADX/RTA 内外循环);MTL 归因扩展 = 结果指标拓扑 + 过程指标拓扑 + 系统链路三层。
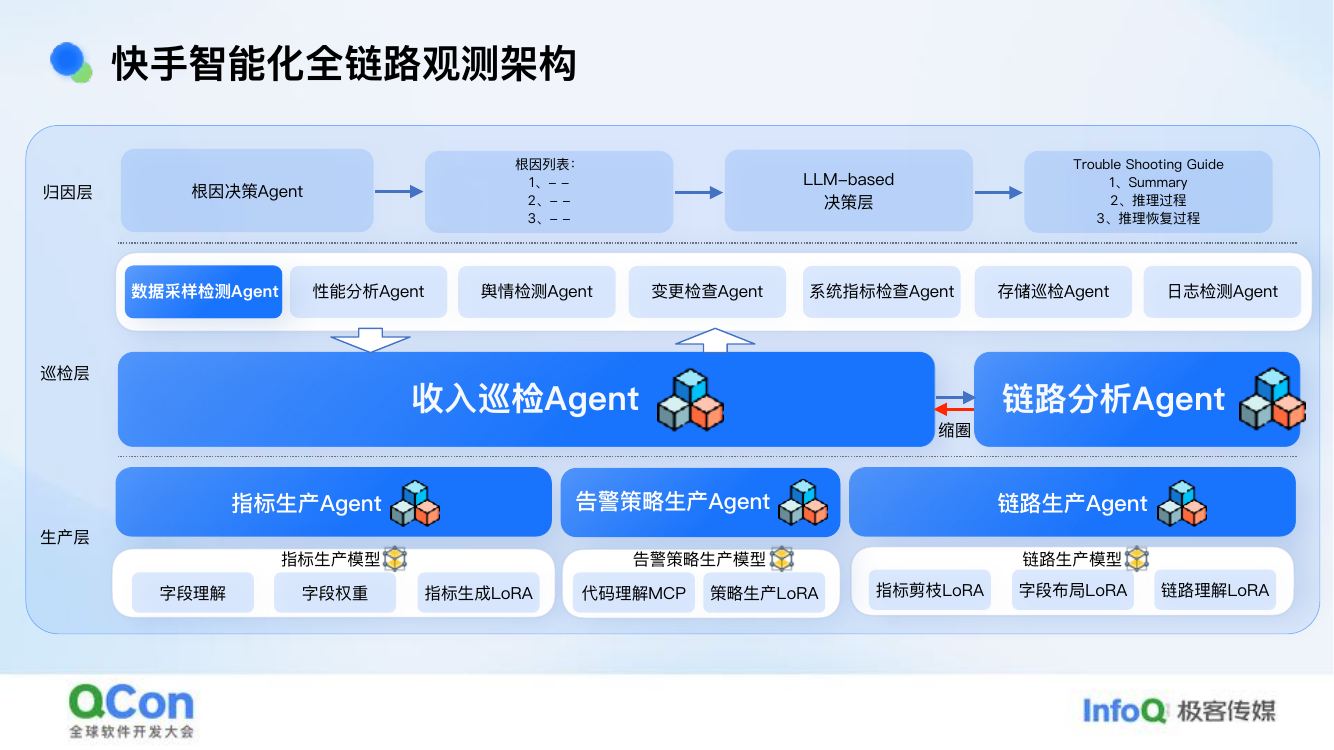
智能化全链路观测架构三层
-
产层:指标 / 告警策略 / 链路三个生产 Agent(LoRA 家族:字段理解、字段权重、指标生成、代码理解 MCP、策略生成、指标剪枝、字段布局、链路理解)。
-
巡检层:数据采样 / 性能 / 舆情 / 变更 / 系统指标 / 存储 / 日志检测 + 巡检 Agent + 链路分析 Agent。
-
归因层:根因决策 Agent 输出根因列表 + Trouble Shooting Guide(Summary / 推理过程 / 推理恢复过程)。
问题归因流程:监控告警 / 定时任务 → 维度拆解 Agent → 链路分析 Agent → 根因决策 Agent → 解决方案 Agent。
多方观测:接口出参(分布比例 / 格式 / 浮点 / 数组长度稳定检查)+ 离线数据表 + Trace 日志(预算区间 / 容量区间 / 异常数量分布)三类采样;指标生产 Agent 用 role/context/task Prompt 三段式。
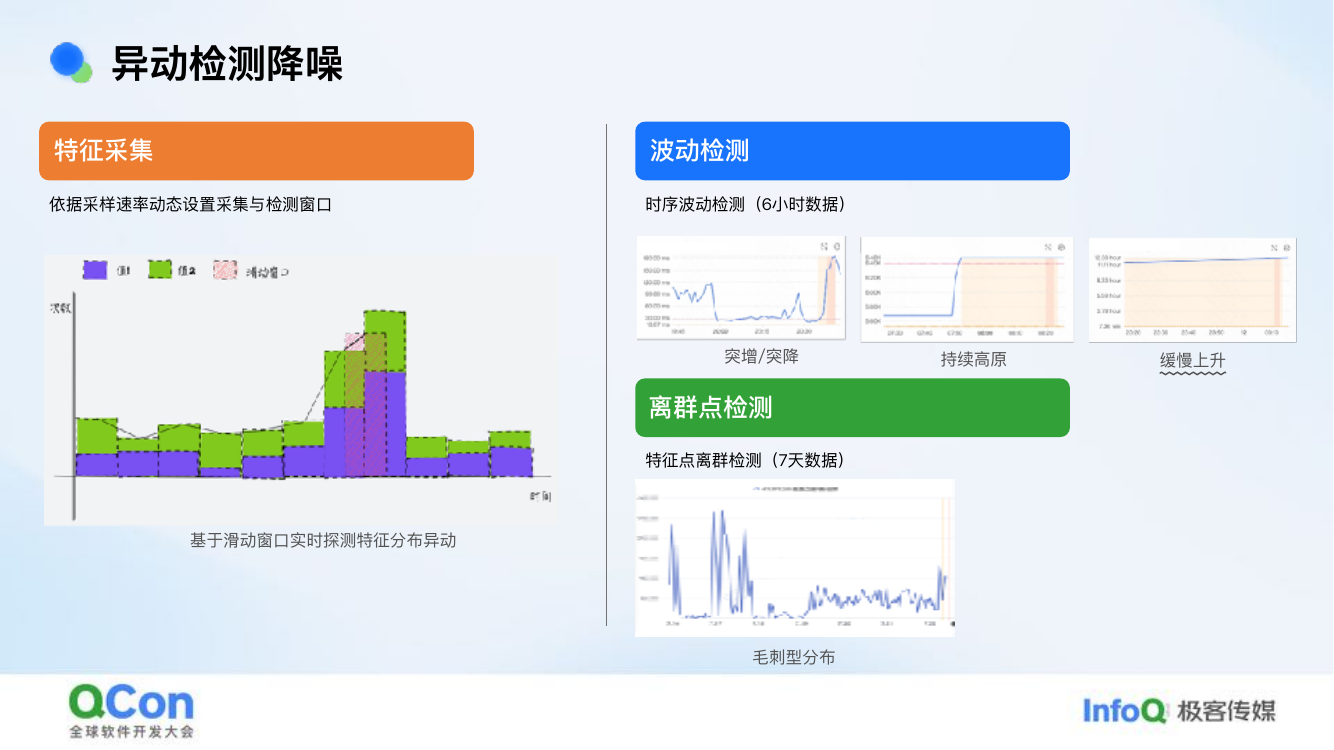
异动检测降噪:依据采样速率动态设采集与检测窗;6 小时短时序波动检测 + 7 天特征点离群检测 + 滑动窗实时探测。
业务链路 vs 系统链路
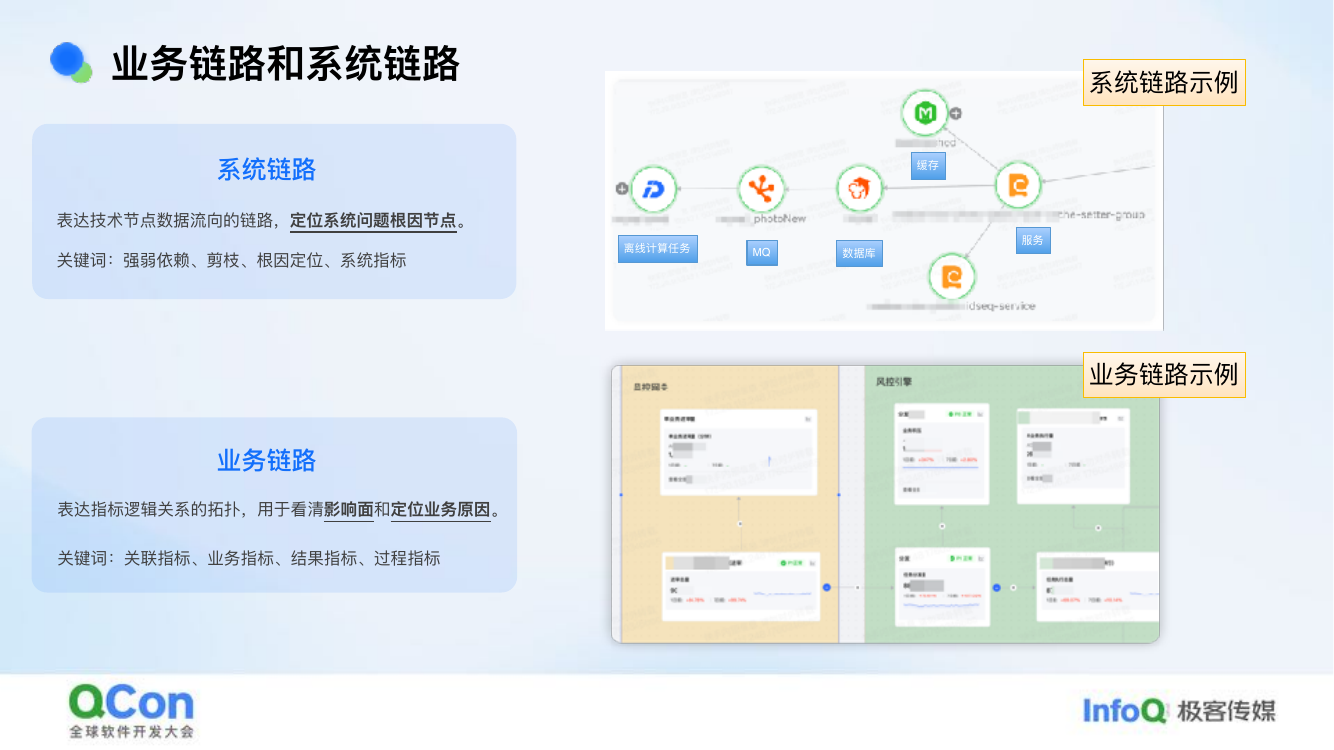
- 业务链路 = 指标逻辑拓扑(关键词关联,结果 / 过程指标);系统链路 = 技术节点数据流向(关键词强弱依赖 / 剪枝 / 根因定位)。
链路生成流水线:系统链路生成 → 业务指标生成 → 指标关联 → 指标剪枝(弱权重折叠 / 告警节点高亮 / 波动节点高亮;权重推演 = QPS / 可用性 / 语义权重 / 语义重复度 / 调用链 / 代码实现贴合)→ 业务链路生成 → 关联结果指标 → 持续训练 → 用户微调。
效果:召回率 80%+、准确率 90%+;未来 = AIOps 系统运维交付(数据融合 + AIGC + 推荐)。
3.4 薛春雨《银行核心系统多活架构实践》(神州信息・新动力)
📄 来源飞书文档:薛春雨《银行核心系统多活架构实践》(https://my.feishu.cn/wiki/K0tqwUMWaiRPIOk9gIRcSEtrnhd)
多活发展三阶段
-
基本的活着:各业务系统分中心部署、核心冷备、逻辑主中心。
-
更好的活着:同城双活、IDC1 主库 ADG 同步、主库宕切 IDC2、RPO/RTO 与 ADG 有关、跨中心网络消耗。
-
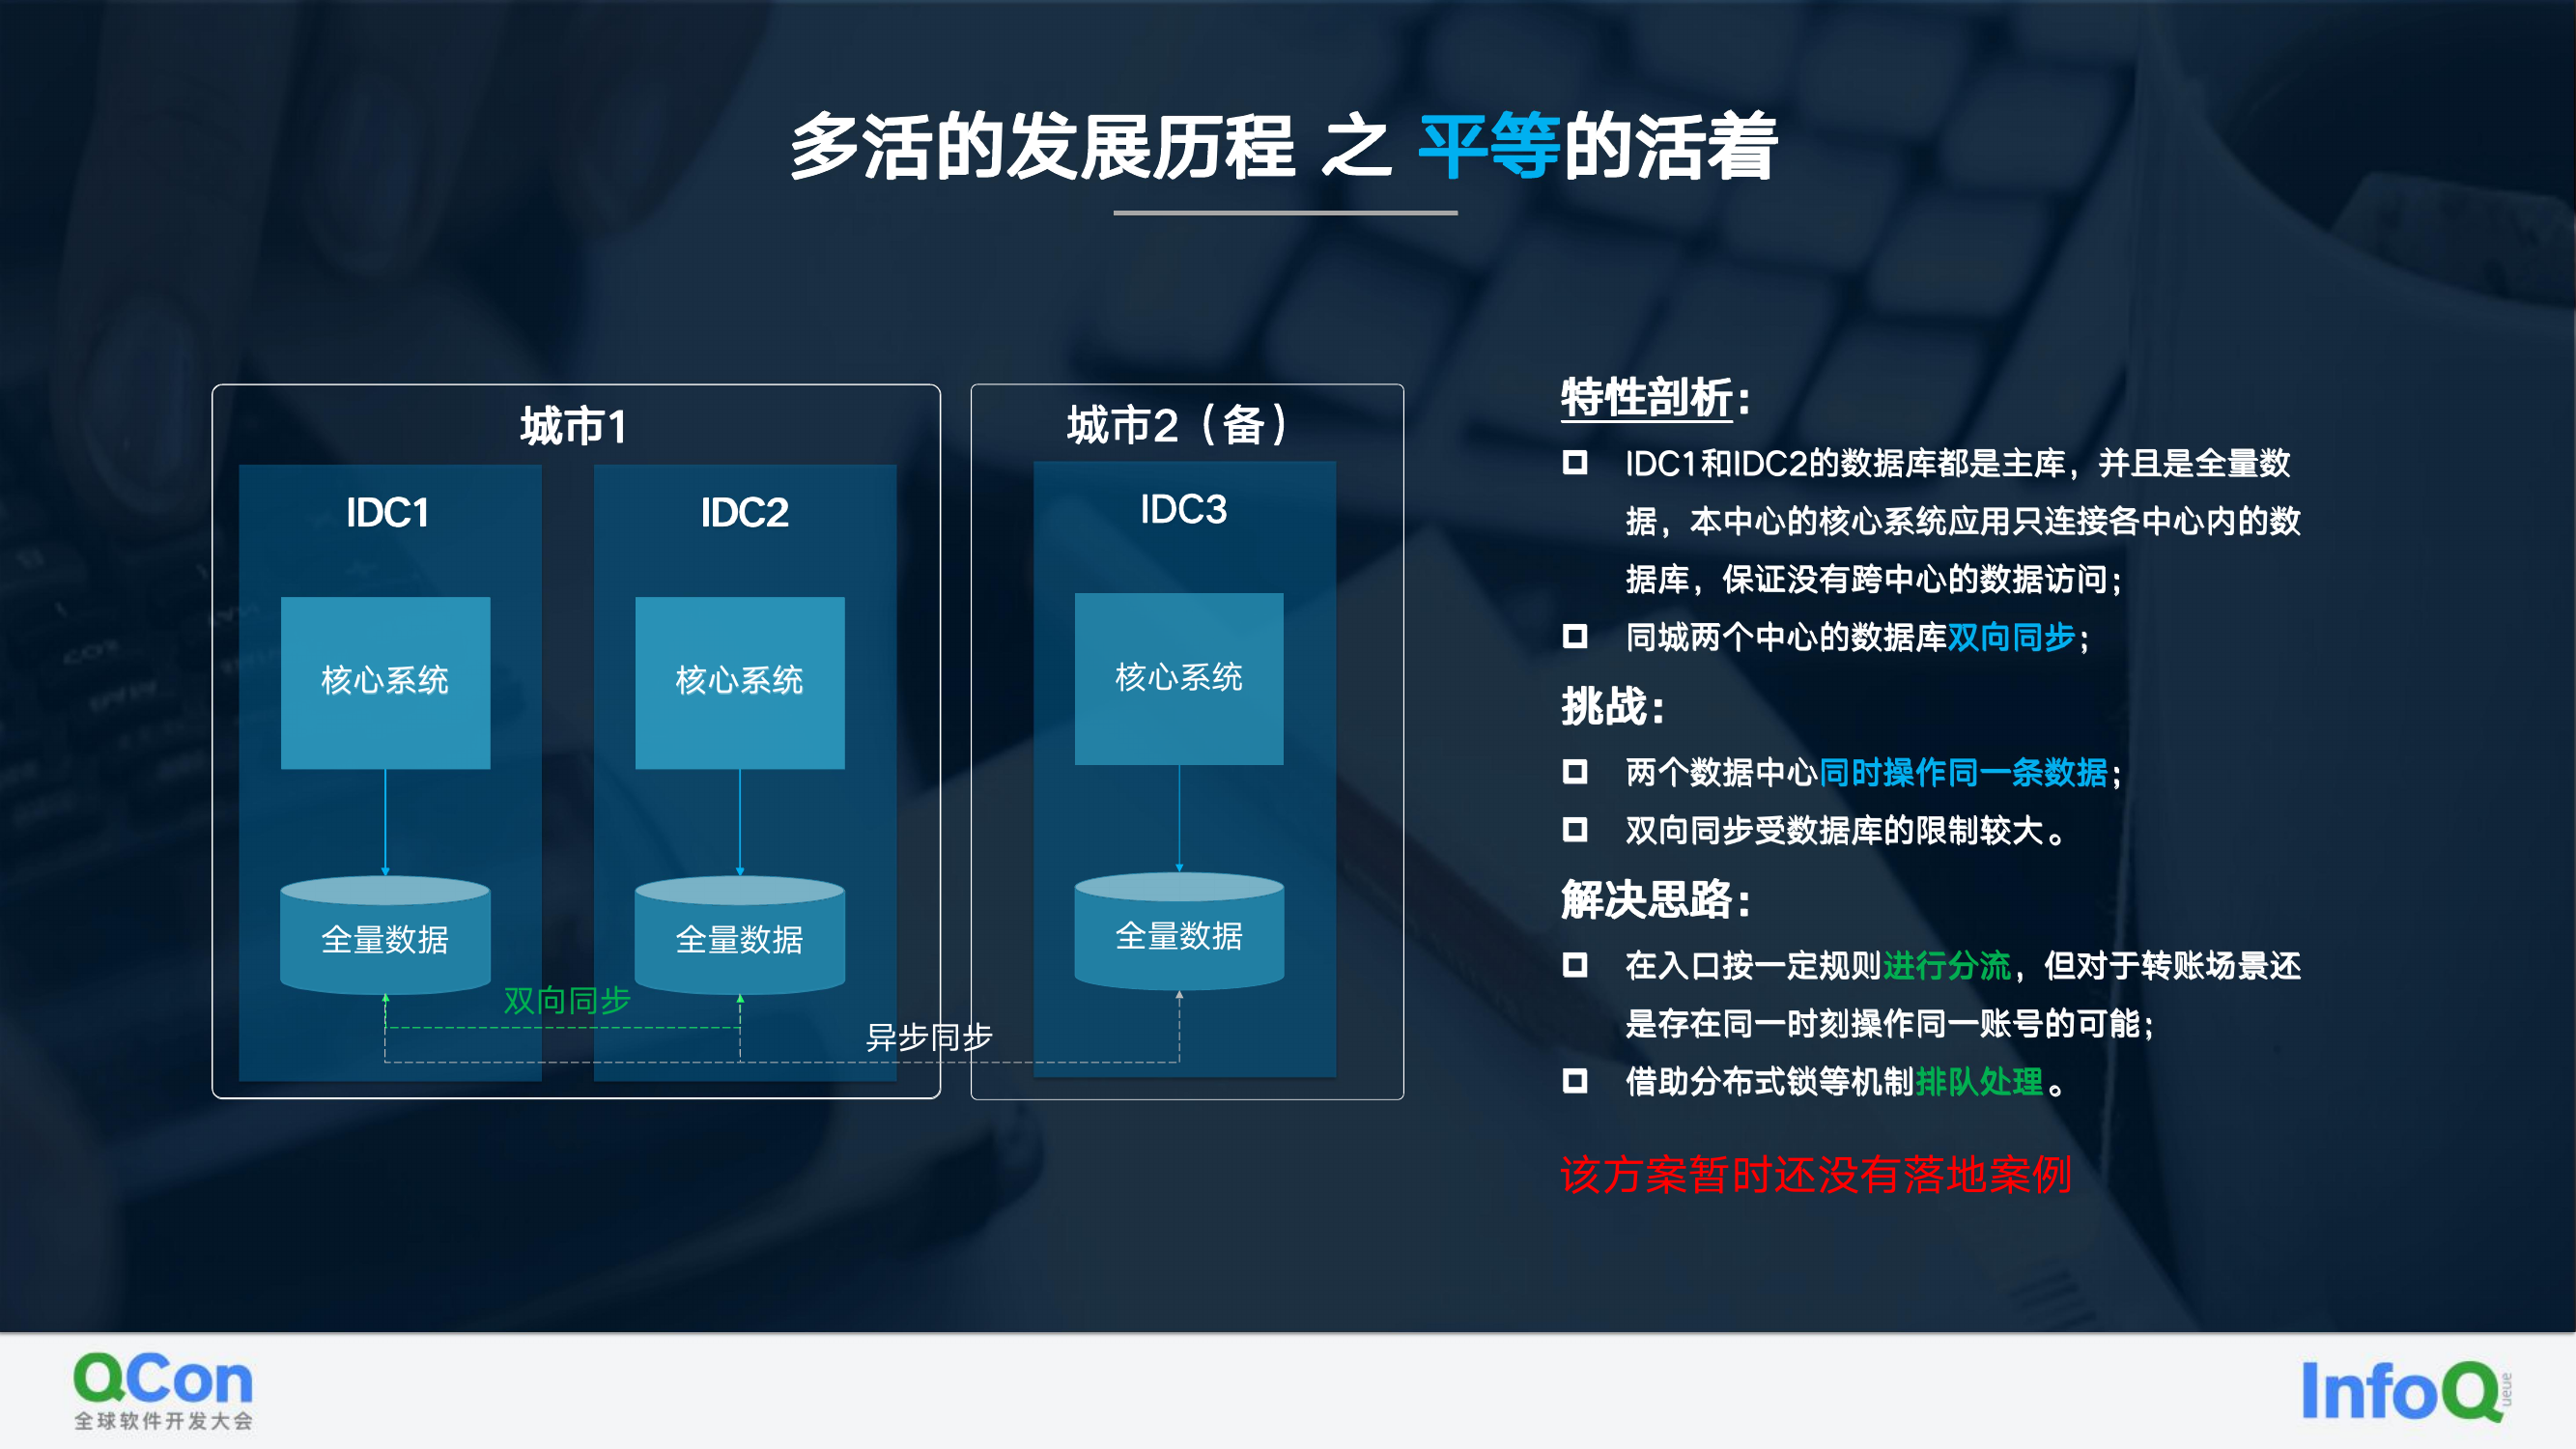
平等的活着:双主全量、本中心应用连本中心库、双向同步、同刻操作同一条数据挑战、无落地案例。
第一性诉求
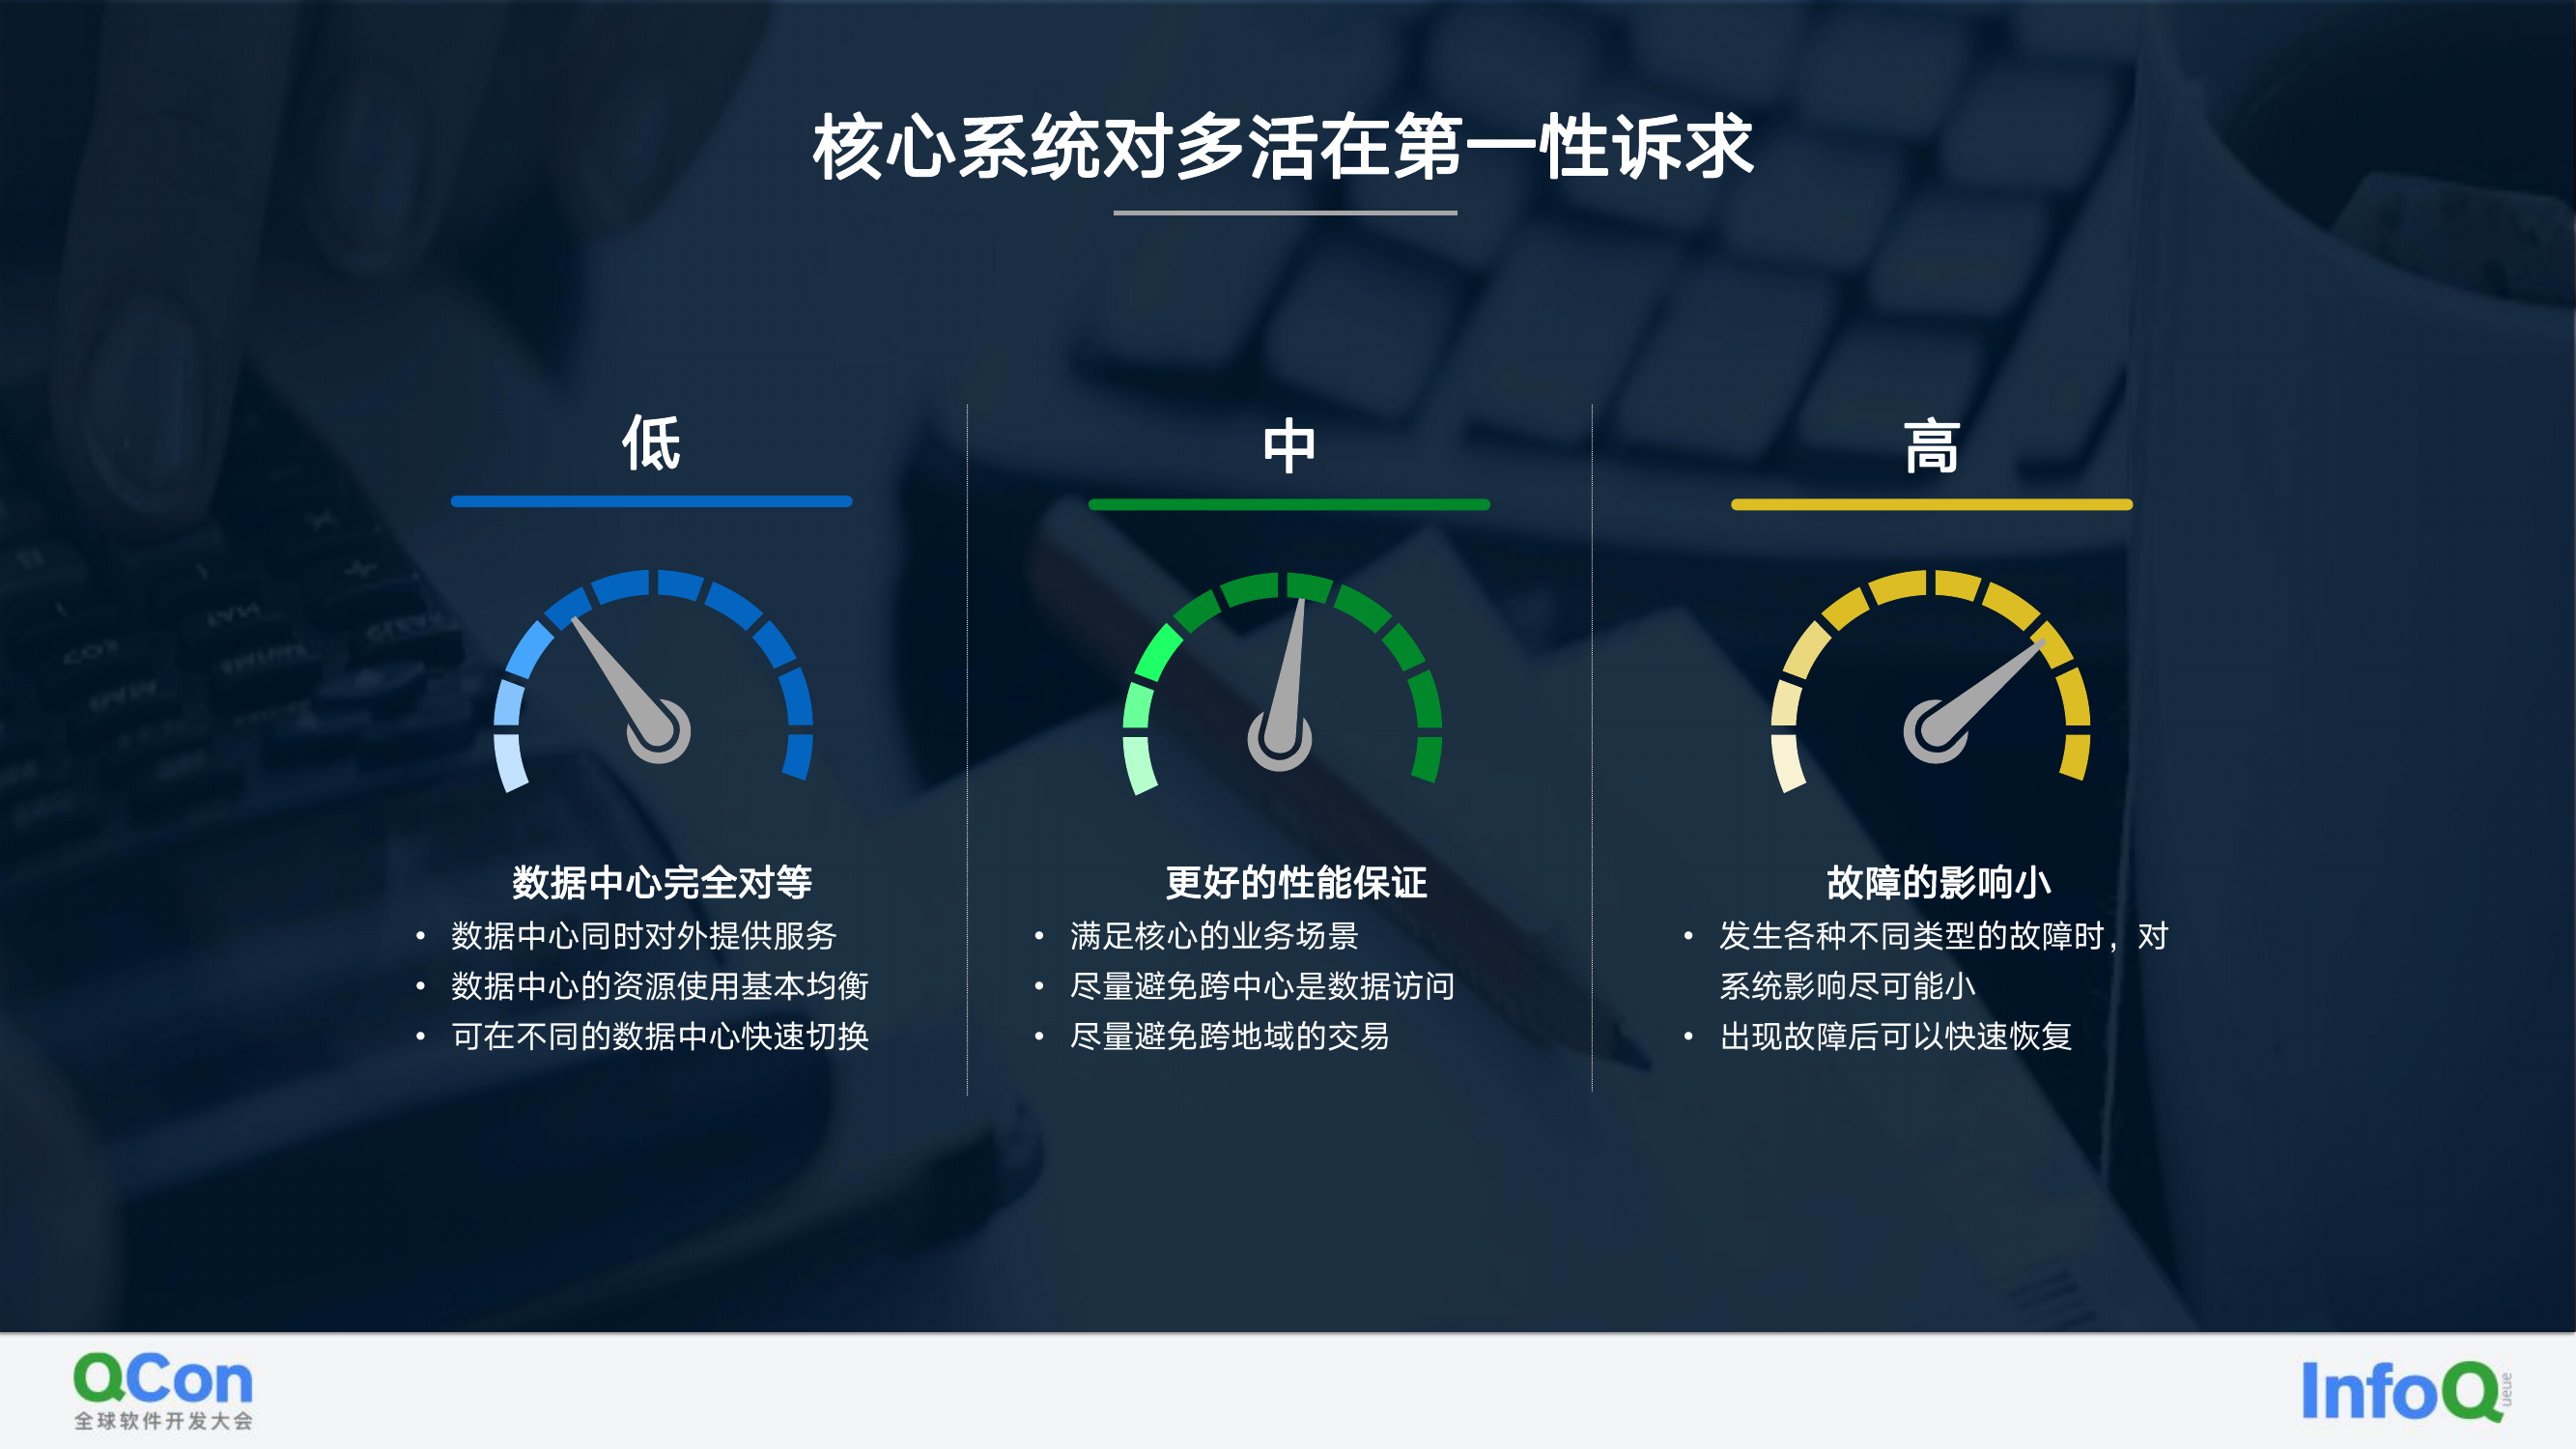
- 数据中心完全对等 / 更好性能(避免跨中心数据访问与跨地域交易)/ 故障影响小。
单元化实践
-
单元化本质 = 数据层分布式(架构级方案,应用只访问本单元数据)。
-
解决多活四步:先定单元数 → 分配数据中心 → 全局路由转发 → 每单元 1/n 数据规避跨中心访问。
-
快速切换:每单元同城 + 异地各一备单元(同城实时同步 / 异地异步同步);单单元故障仅全局路由切流即可 RTO/RPO≈0;同城双中心均故障切异地(受影响)。
-
单元数量权衡:100 单元 ×1 分片 vs 10 单元 ×10 分片 —— 过多则成本复杂度高,单元内需支持再拆分。
-
数据库影响:非分布式 TDSQL 按租户服务 vs 分布式 TDSQL 单元内再拆分。
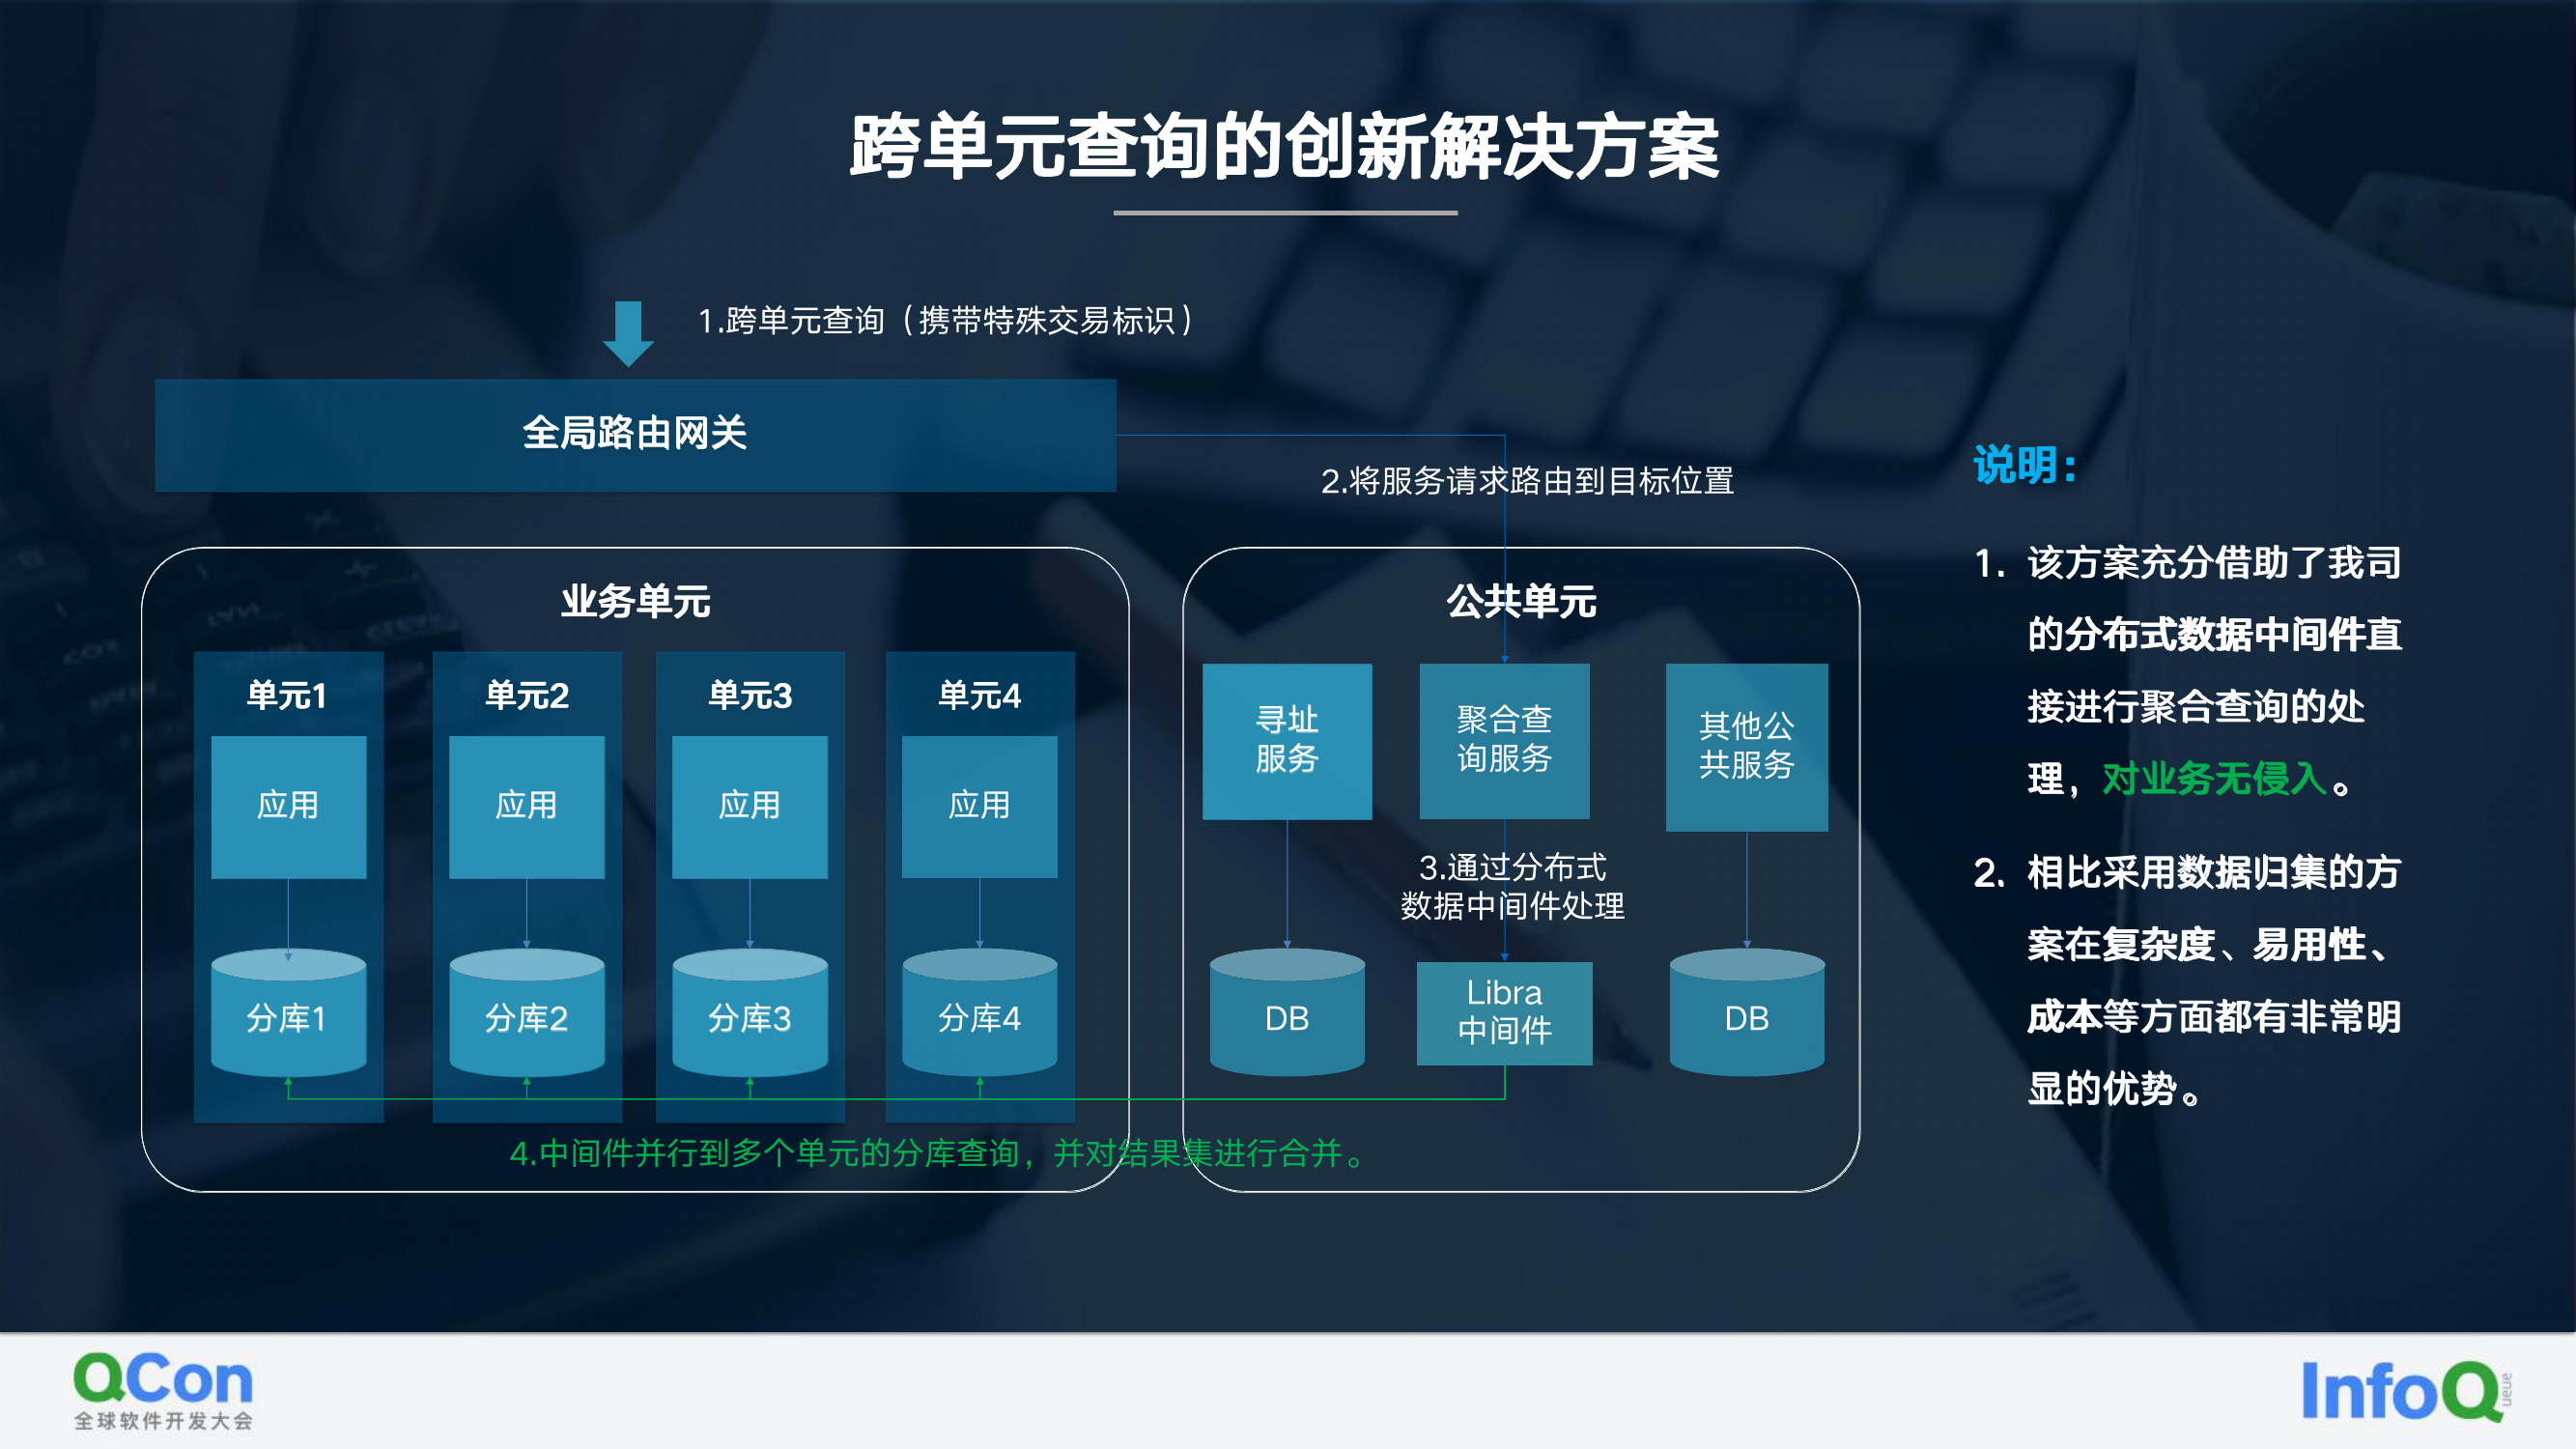
- 跨单元查询创新:特殊交易标识路由到公共单元 → 分布式数据中间件(Libra)并行查询多分库合并(对业务无侵入)。
轻量化方案(替代单元化)
-
标准分布式架构增强:核心数据多分库 / 每中心一半分库 / 应用可访问所有分库 / 分库同城互备;缺点 = 跨中心访问 + 连接数多。
-
增强点:跨中心路由、本中心优先(仅跨分库业务才有跨中心访问)→ 分布式数据库(同一集群 / 按需水平拆分 / 主备切换对应用透明)。超级容量 = 4 分库 ×5 分表。
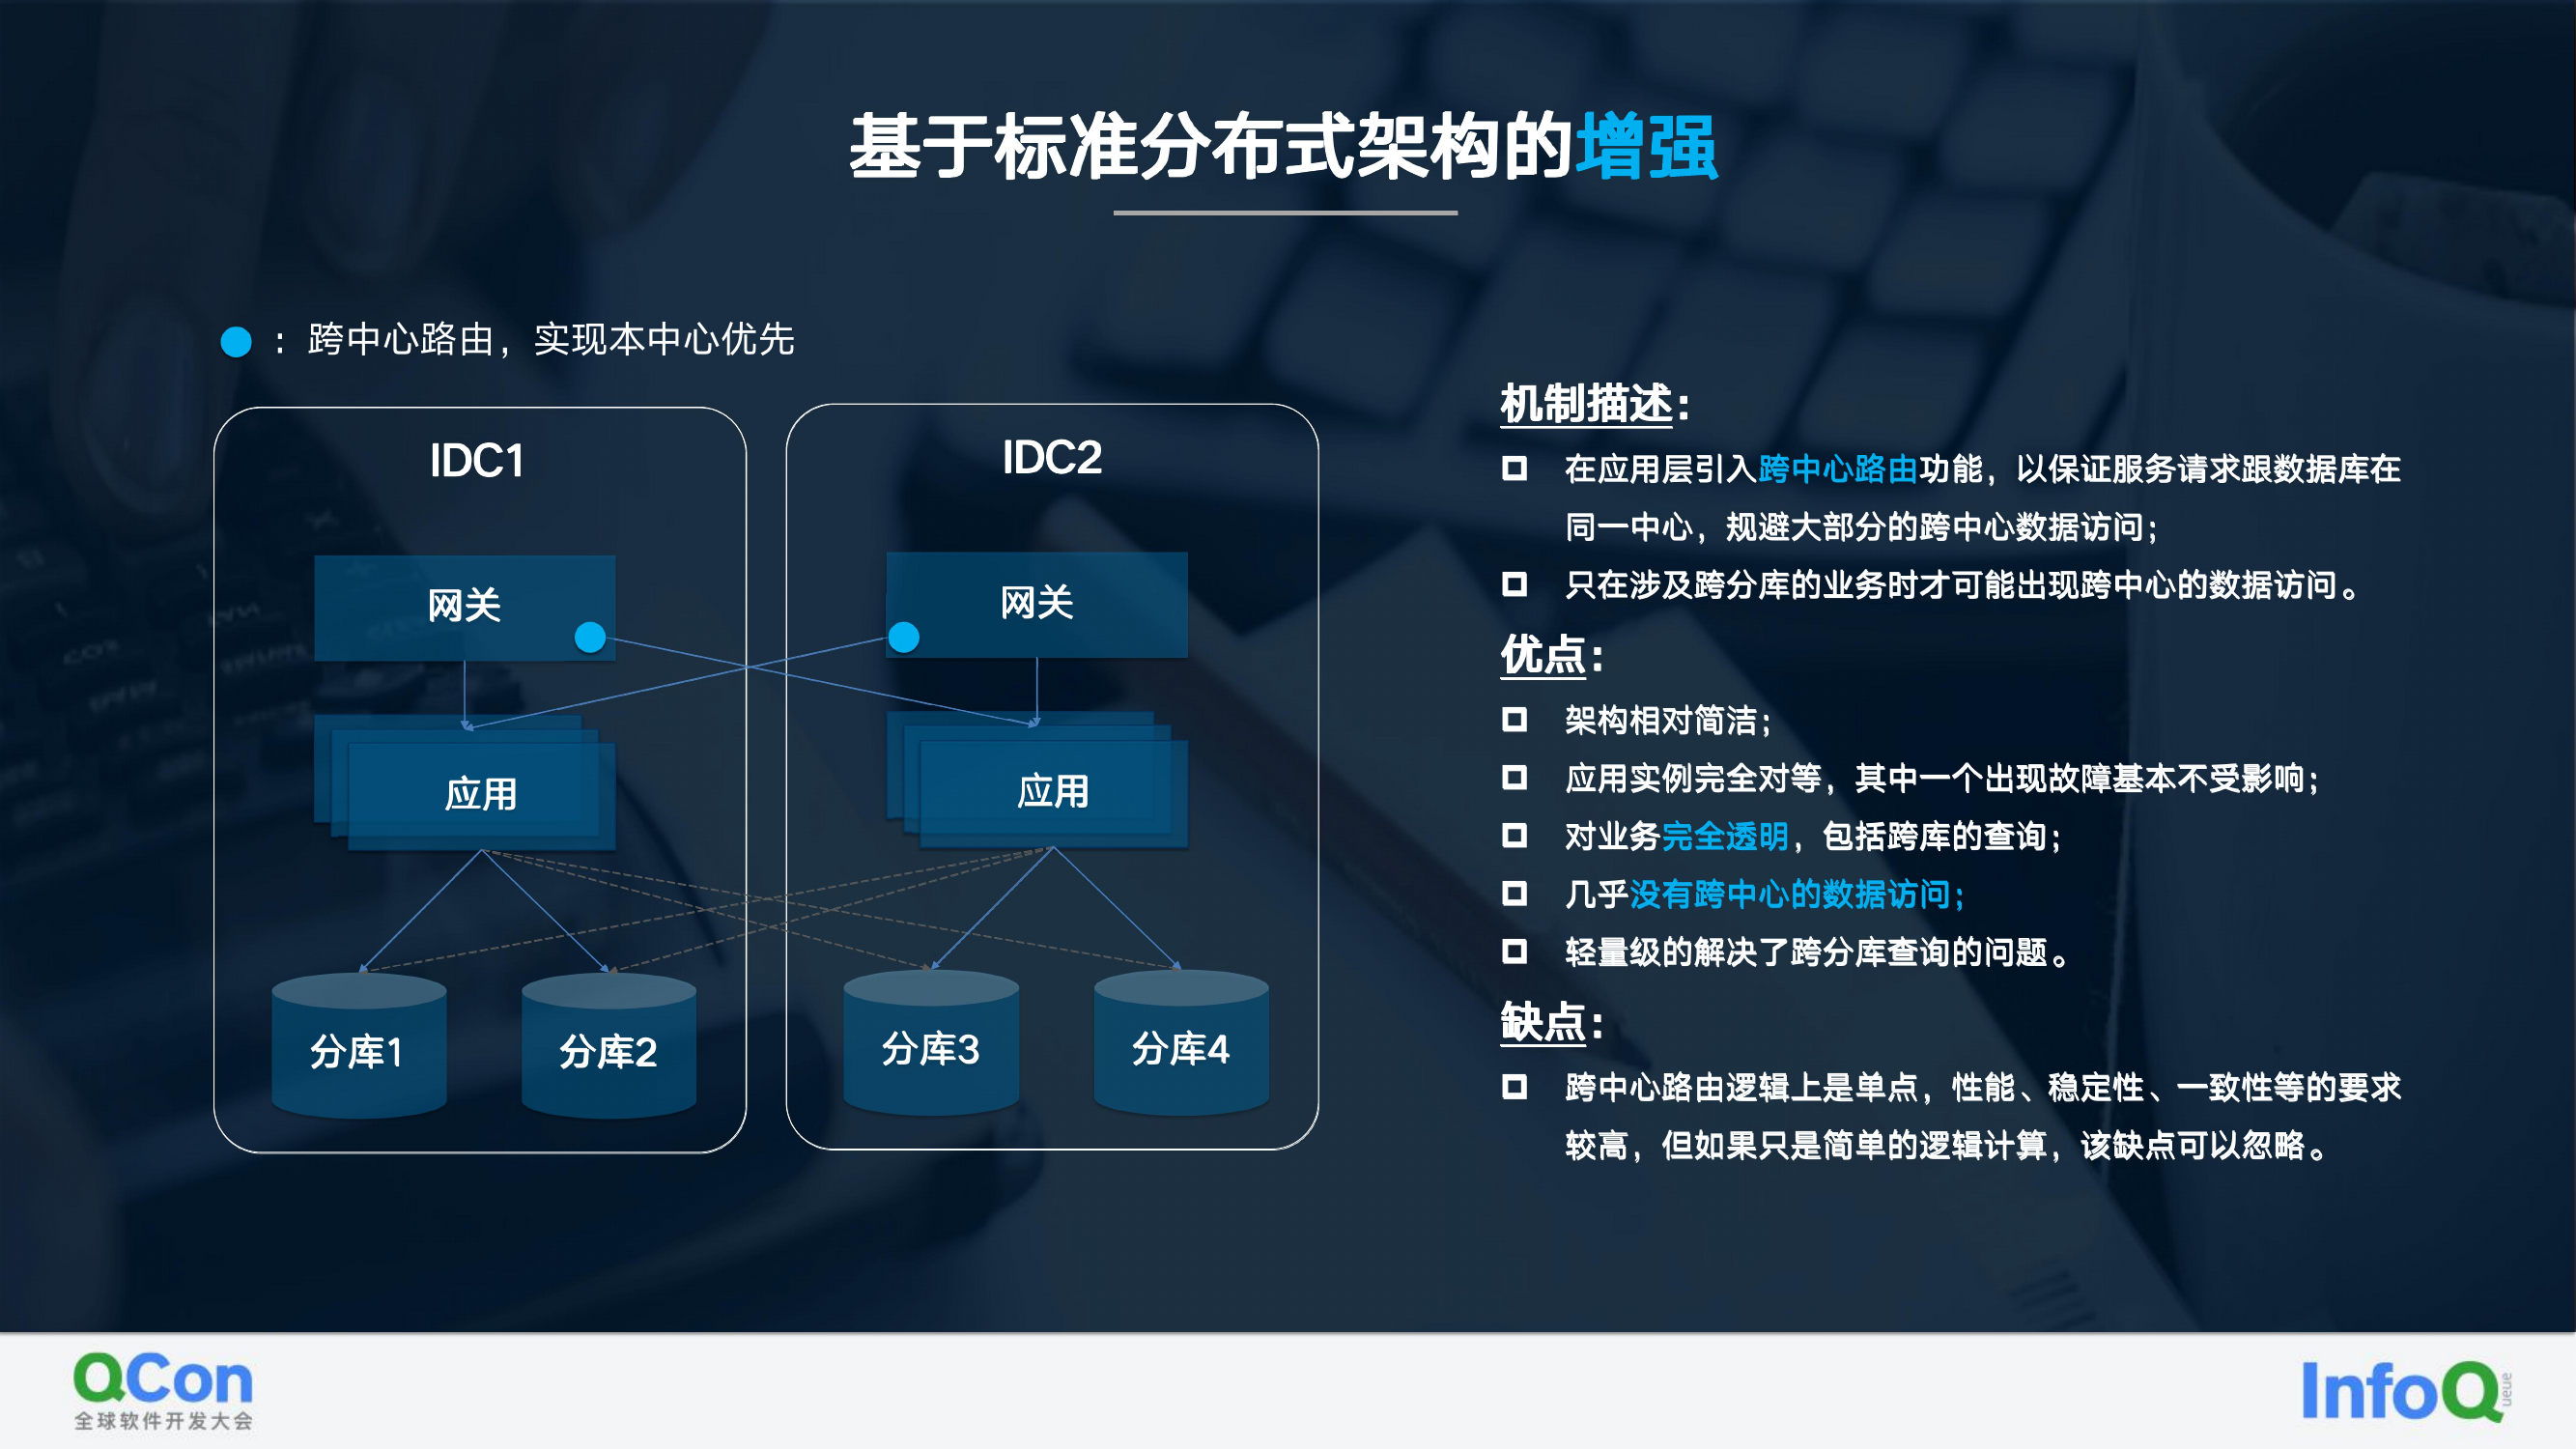
总结与思考三问:数据中心完全对等 / 本中心调用 / 故障影响面比单元化还小 / 硬件投入少 / 支持亿级数据量;思考 = 单元化与分布式数据库是否矛盾?库成熟后还需要单元化吗?本中心优先是否够用?
3.5 李翠霞《自建数字化交易平台提升研发效能》(汇丰科技)
📄 来源飞书文档:李翠霞《自建数字化交易平台提升研发效能》(https://my.feishu.cn/wiki/UwLewPaRriadMXk1hZIcpCrKnLc)
DevOps 业界标准四项(DORA 四指标)
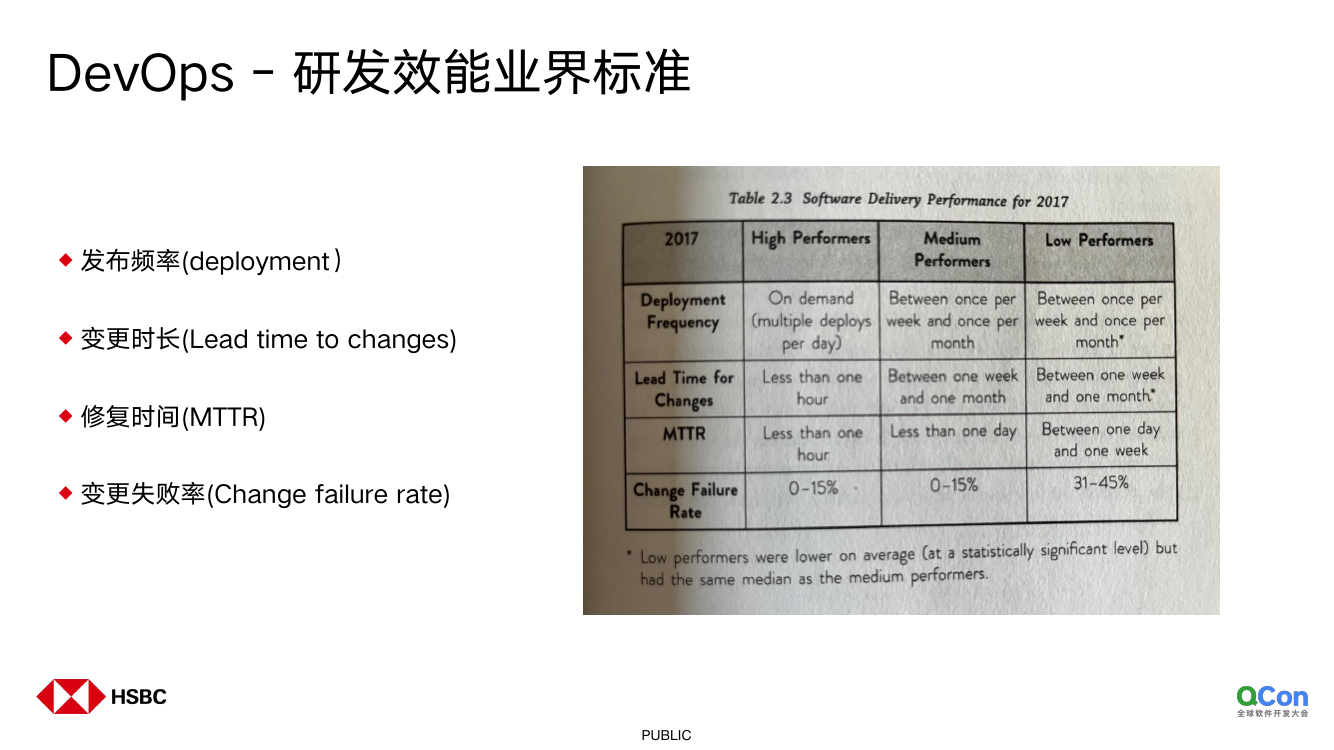
- 发布频率(deployment frequency)/ 变更时长(lead time)/ MTTR / 变更失败率(change failure rate)。
团队落地指标
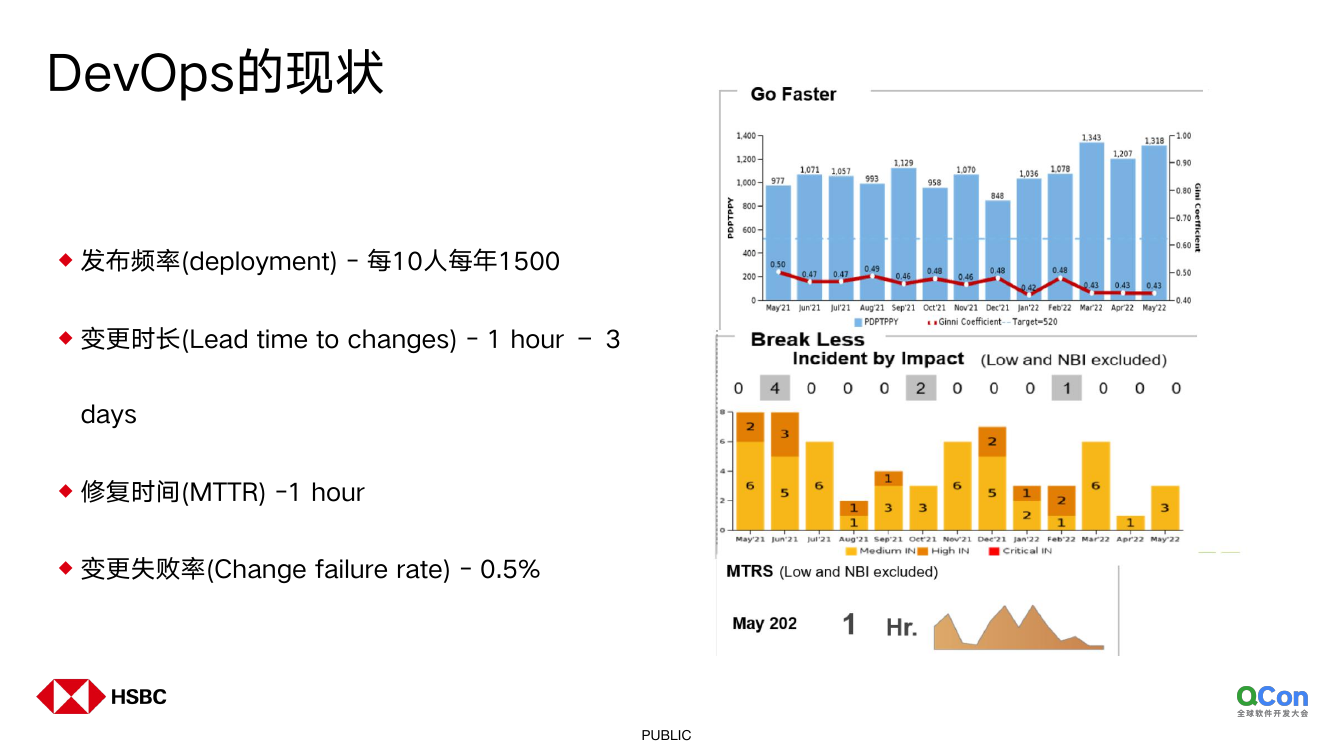
- 每 10 人每年发布 1500 次;变更时长 1h-3days;MTTR 1h;变更失败率 0.5%。
DevOps 历程与交付原理
-
"Be agile, don't do agile";敏捷宣言;变更尽可能小;缩短开发周期、促进产品经理与研发协作。
-
实践意义 = 打破流程壁垒、工程文化变革。
平台现状与自研开源框架
-
超 1000 服务、超 300 PG DB、自主服务器 + 云、全自动监控。
-
Cranker(负载均衡,github.com/hsbc/mu-cranker-router + cranker-connector)。
-
PGMaker(基于 API 的 DB 创建管理 / 容灾练习零中断 / 多点备份 / 自动监控)。
工具链哲学:不要等别人解决问题;不用完美工具、够用就好;API 导向;人人都可开发自己的工具;工具文化比用什么工具重要。
未来挑战:安全法规 / 可扩展性与可控制性冲突 / 运维压力。
3.6 付冰尧《米家故障应急保障体系实战:稳中求胜的构建之道》(小米)
📄 来源飞书文档:付冰尧《米家故障应急保障体系实战:稳中求胜的构建之道》(https://my.feishu.cn/wiki/A1zAw3PnYihj3Ok2wc0cpa2lnPe)
IoT 规模与架构
-
8.61 亿设备接入 / 1 亿月活 / 1.3 万开发者 / 全球 6 区域本地化部署。
-
架构:设备层 → 系统层 → 接入层(IoT 系统网关 / OT 网关)→ 业务层(绑定 / 事件上报 / 控制)→ 平台服务层(设备绑定 / 管理 / 影子 / 控制 / 联动 / SPEC 标准库)→ 基础层(ZK/ETCD/K8s/RMQ/MySQL/Redis/Pegasus)。
四层接入容灾
- 四层 LB 跨机房切流 → 七层 NG 容器化弹性伸缩 / 物理集群 → API Gateway 鉴权路由熔断限流降级 → 业务 / 基础服务层熔断限流降级;存储中间件 MiProxy 动态调控穿透回写 + 主从同步。
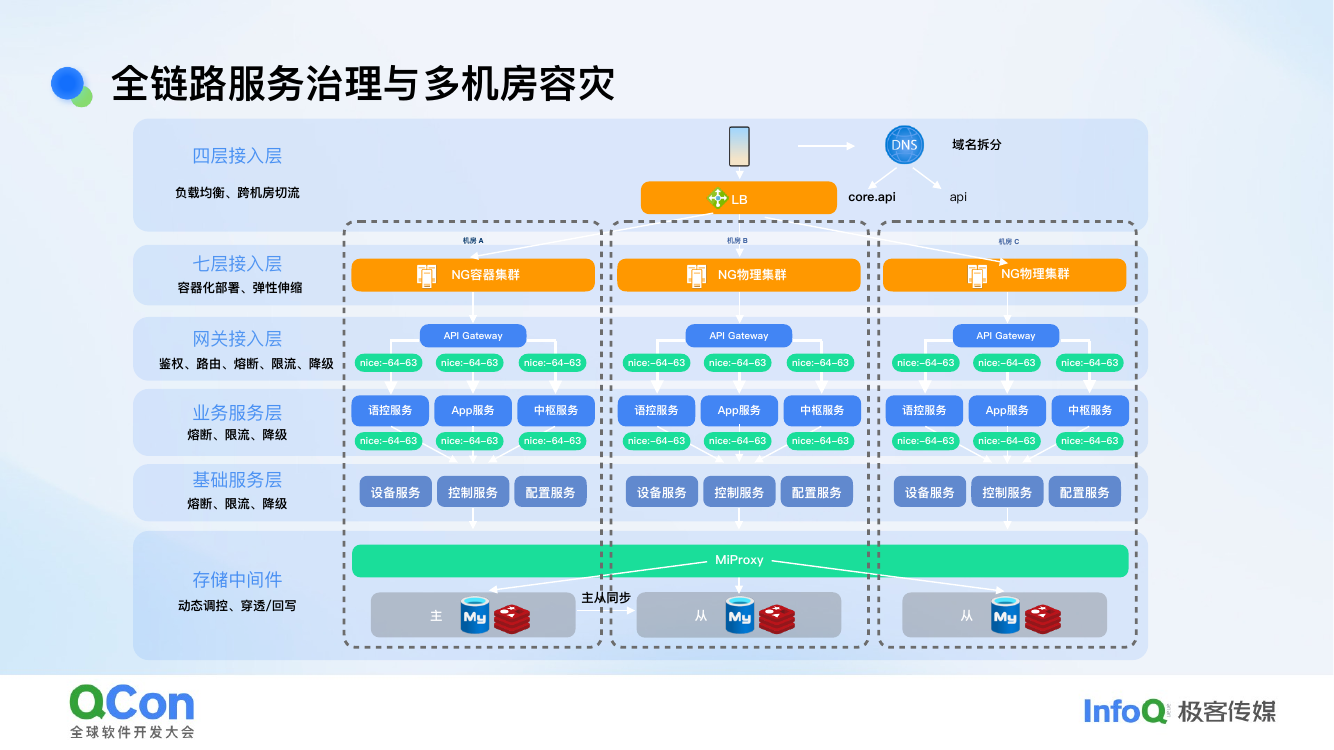
质量困境:核心服务 QPS 200W+、PV 200 亿 +、年增 30%+、设备品类多协议多样、客诉快速冲热搜。
三层体系(组织层 + 工具层 + 流程层)
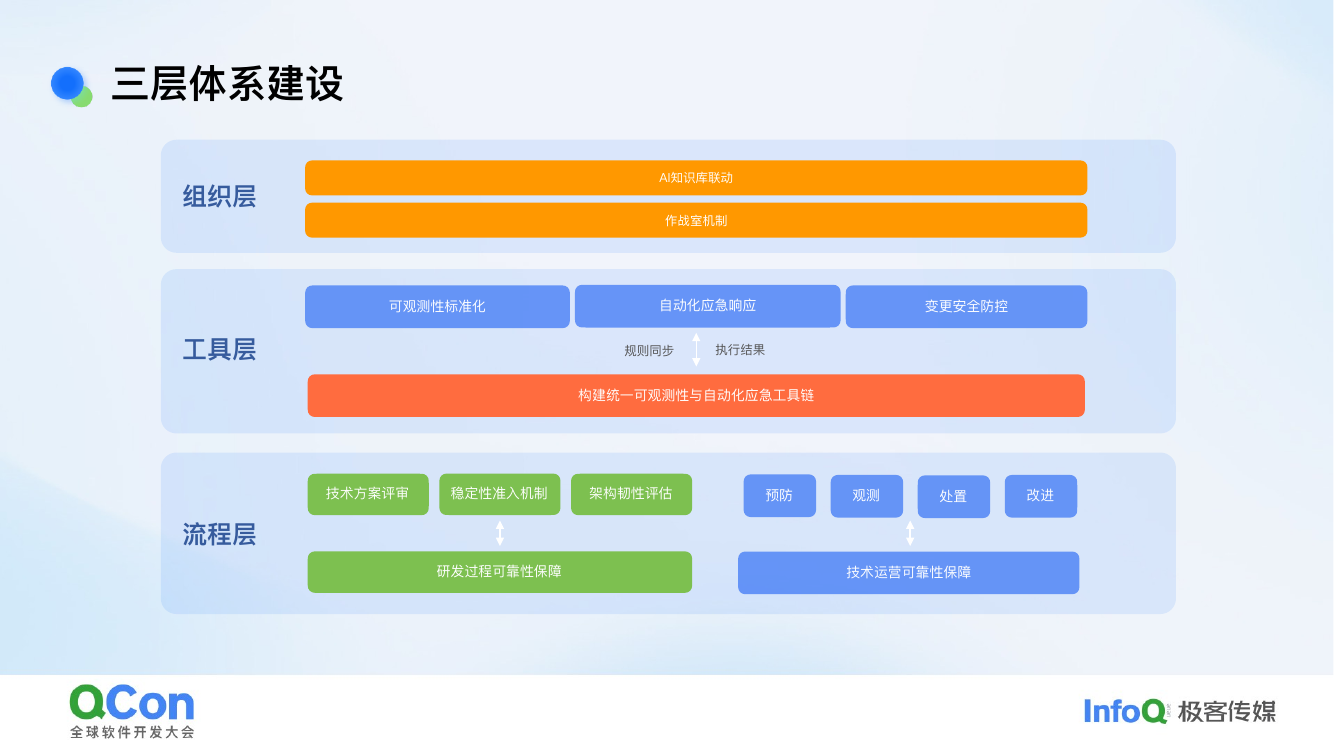
- 流程层四机制:技术方案评审(评审单元 / 评审对象 / 参审要素 + FMEA + CheckList);架构韧性评估(容灾层数据 / 应用 / 业务异地多活 + 故障恢复自动转移限流降级 + 韧性验证红蓝对抗故障注入);发布策略规划(渐进 / 灰度 / A-B + 回滚 / 预警回滚 / 数据一致性 + 盒测试 / 流量回放);稳定性准入机制(SLA/SLO + 容量压测 + 容量模型 + 混沌工程 + 监控告警 + 告警降噪)。
-
工具层:研运一体化平台 DevX(GitLab/Artifactory/SonarQube/CI-CD + AI 编程助手 / 授权 / 审批 / 防呆)+ 智能运维平台(SLA-SLO / 自动化 IAC / 可观测 / 监控 OnCall / 变更发布 / 链路监控 / 智能巡检 / 预案管理 / 账单分析 / 资源优化 / 全局搜索 / SRERobot/AI Coder / 变更检测 / RCA 预测)。
-
RCA 方案:OTel Collector + Time Series/Trace/Dependency Graph/Column 数据 → causalml → RootNode\&Confidence\&CausalChain。
-
组织层分级响应(升级阈值 + 时效闭环):
-
重大级别:领导 + 专家组 / 部门经理 / 收入 + 核心功能 / 5 分钟内集结;
-
严重级别:研发 Leader+SRE / 部门总监 / 核心功能 / 15 分钟内闭环;
-
一般级别:值班 OnCall / 团队内决策 / 局部功能异常 / 30 分钟内闭环处置。
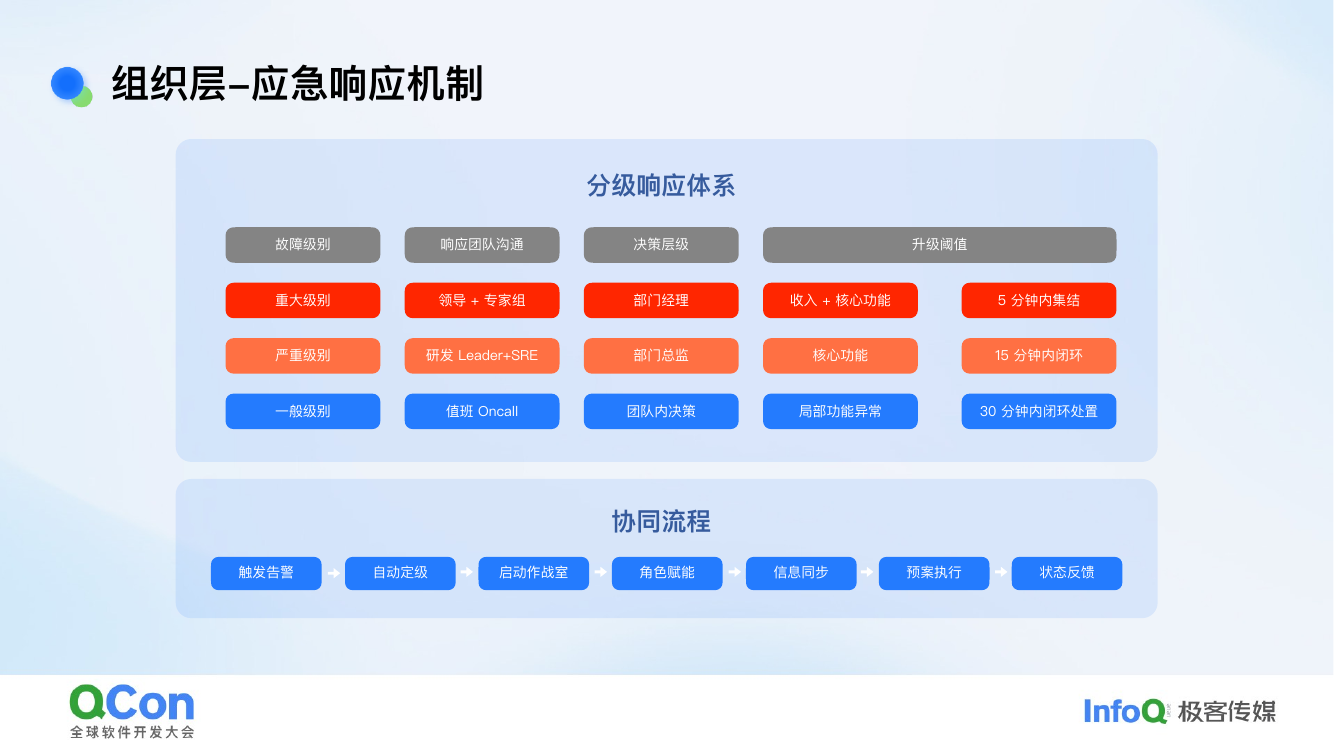
协同流程:触发告警 → 自动定级 → 启动作战室 → 角色赋能 → 信息同步 → 预案执行 → 状态反馈。
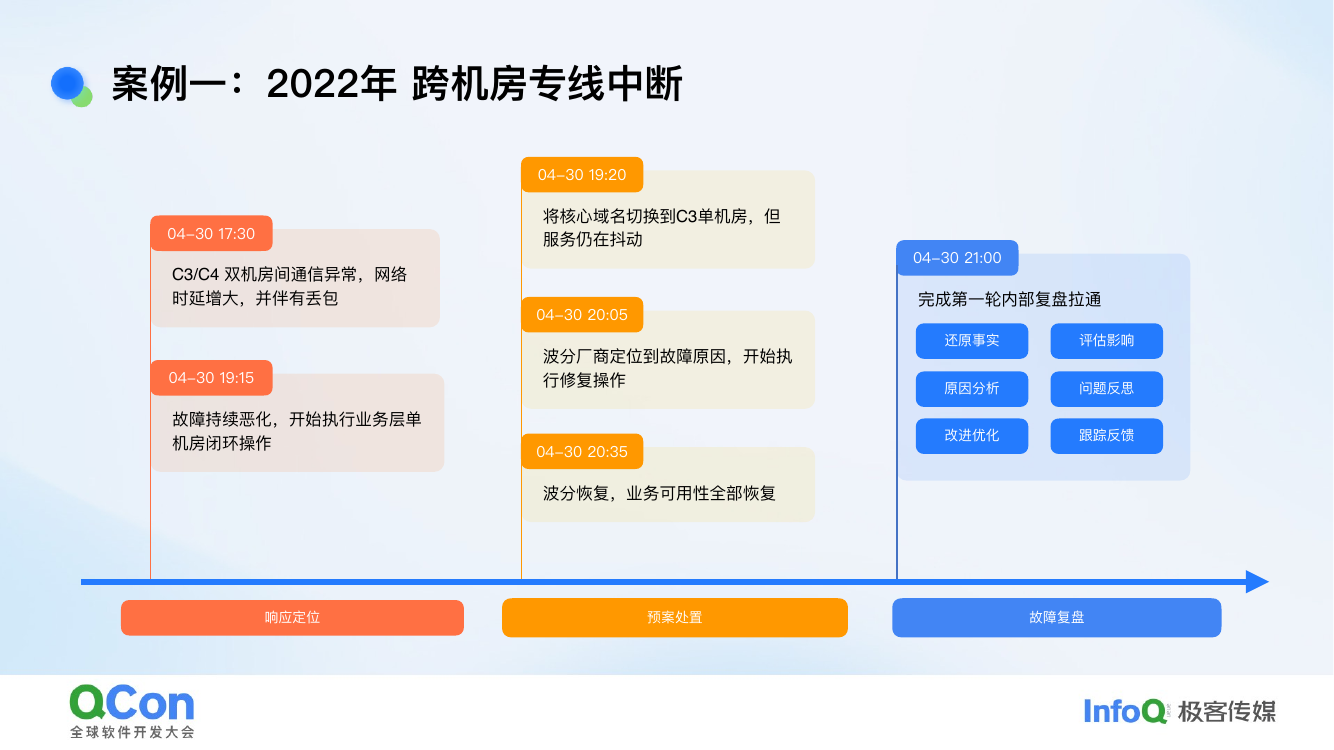
案例 1(2022 跨机房专线中断):C3/C4 通信异常 → 机房闭环 → 切 C3 单机房仍抖 → 波分厂商修复 → 恢复 → 复盘六步。
案例 2(云商灾备触发数据锁定):可用区 C 波动 → 预案作战室扩容 A|B 缩容 C → 切换缩容 → OSS 读写异常拉通云商恢复 → 部分读数据锁定 → 数据抢救修复。
3.7 刘凯宁《蚂蚁故障应急全流程体系构建及应用实践》
📄 来源飞书文档:刘凯宁《蚂蚁故障应急全流程体系构建及应用实践》(https://my.feishu.cn/wiki/NktNwJAHUinVIZkVqyicS0win0c)
稳定性灵魂三问:故障是什么 / 谁负责 / 如何评价。
故障定义:服务中断 / 品质下降 / 体验下降;不包括用户侧环境与自身操作;无论自身还是第三方原因均按故障管理。
故障等级:数字越小级别越高(P5\<P4\<P3\<P2\<P1);四维影响度 = 客诉量 / 资损 / 受影响用户数 / 数据错误量,按就高原则;业务铁三角(GOC / 业务稳定性接口人 / SRE);每半年 review 邮件公示。
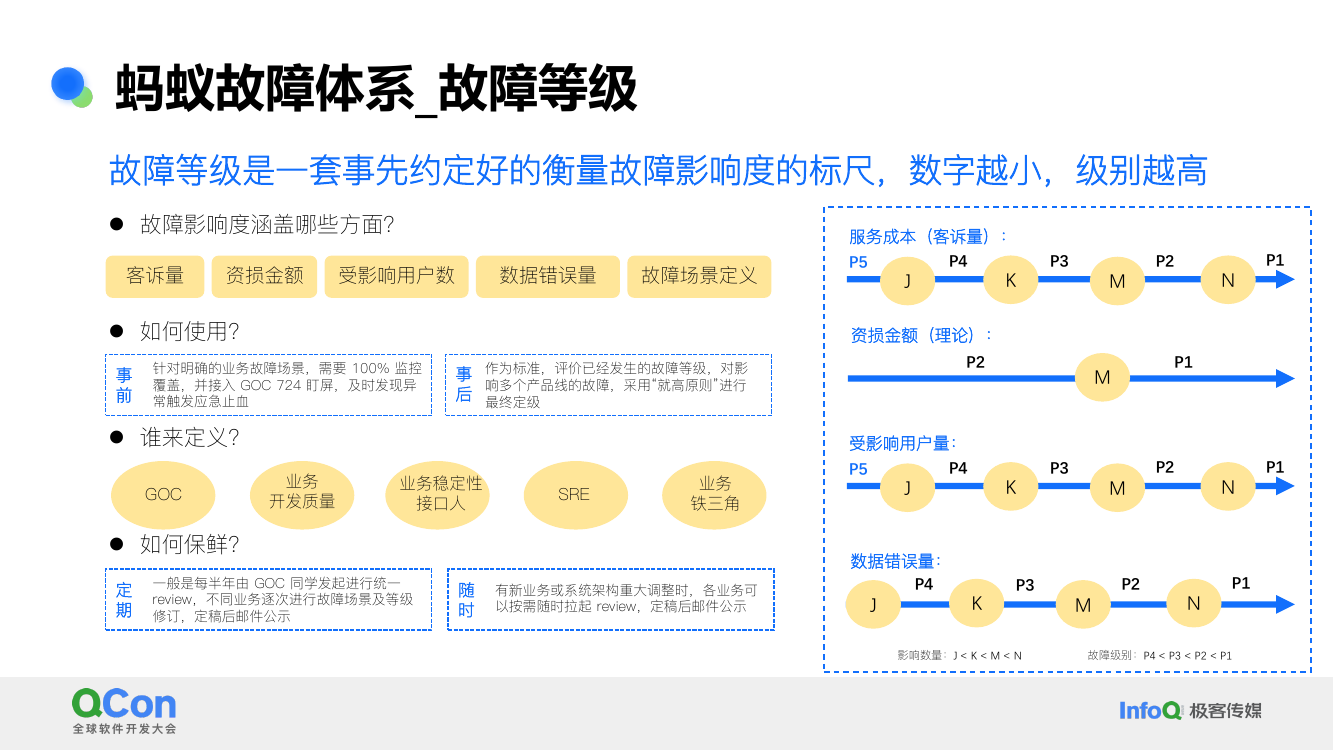
故障序列:P(技术主责,计入 Quota,复盘)/ T(试运行不计)/ W(外部责任不计)/ S(技术非主责)/ C(无业务影响)。
相关指标:1-5-10-30、监控发现率、根因定位能力、Action 完结率。
GOC 故障点:关键服务 / 功能 / 接口 / 结果点按下跌比例 × 持续时长分级。
故障数据运营:结果指标 + 过程指标 + 文化运营(奖惩 / 制度 / 组织)。
应急演进历史:2017 海豹突击队依赖专家 → 2020 应急值班长体系(工具期)→ 2024 全站统一 1-5-10 技术体系。
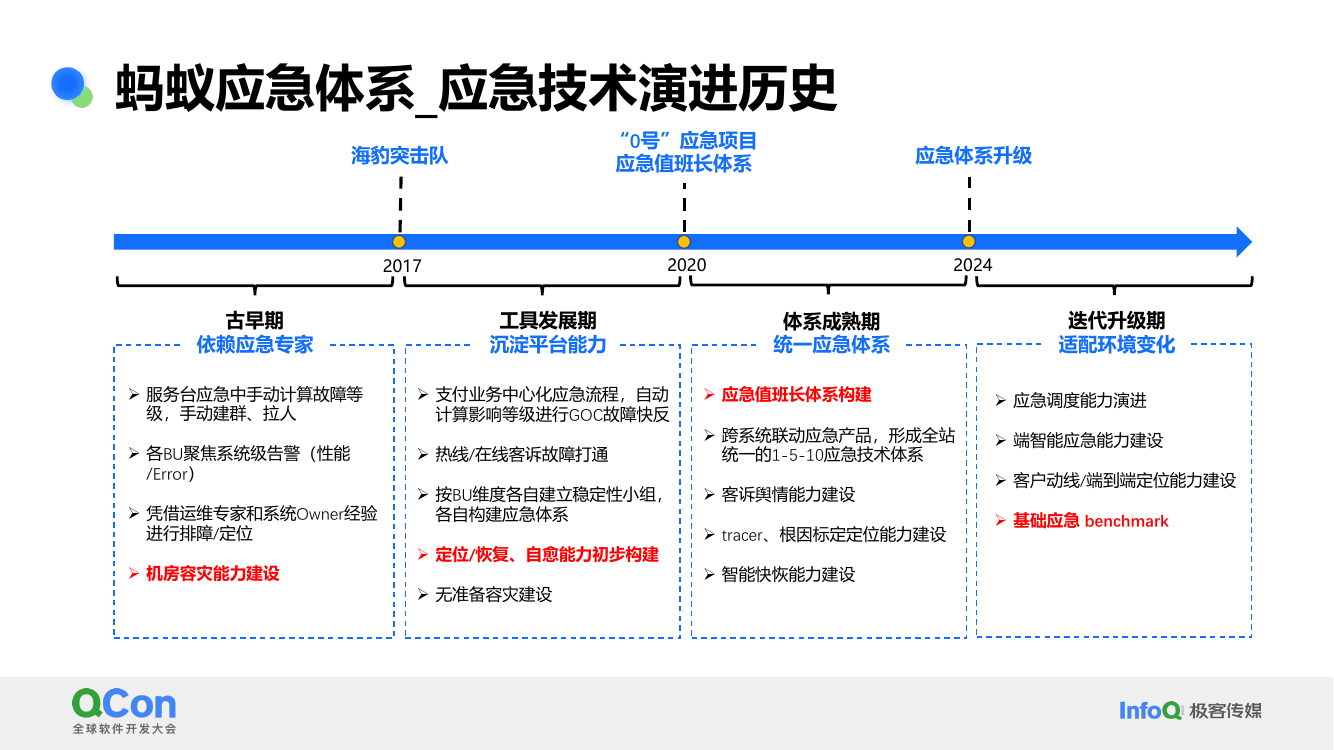
应急角色:全站值班长 / 部门值班长 / 一号位 / 部门 GOC(确认通告启动协同记录复盘)。
应急值班长机制:3 次以上预期应急处置 + 考试持证 + 年度换届 + 一次替换 ≤50% + CTO 授牌。
应急快恢架构(1-5-20-30):<2min 告警(时效性召回率)/ 5min 响应(响应率完结率)/ 20min 定位(根因采纳率)/ 30min 止血(止血时长);三层 = L1 客诉兜底 / L2 场景定义 GOC 7×24 / L3 自动异常识别端智能。
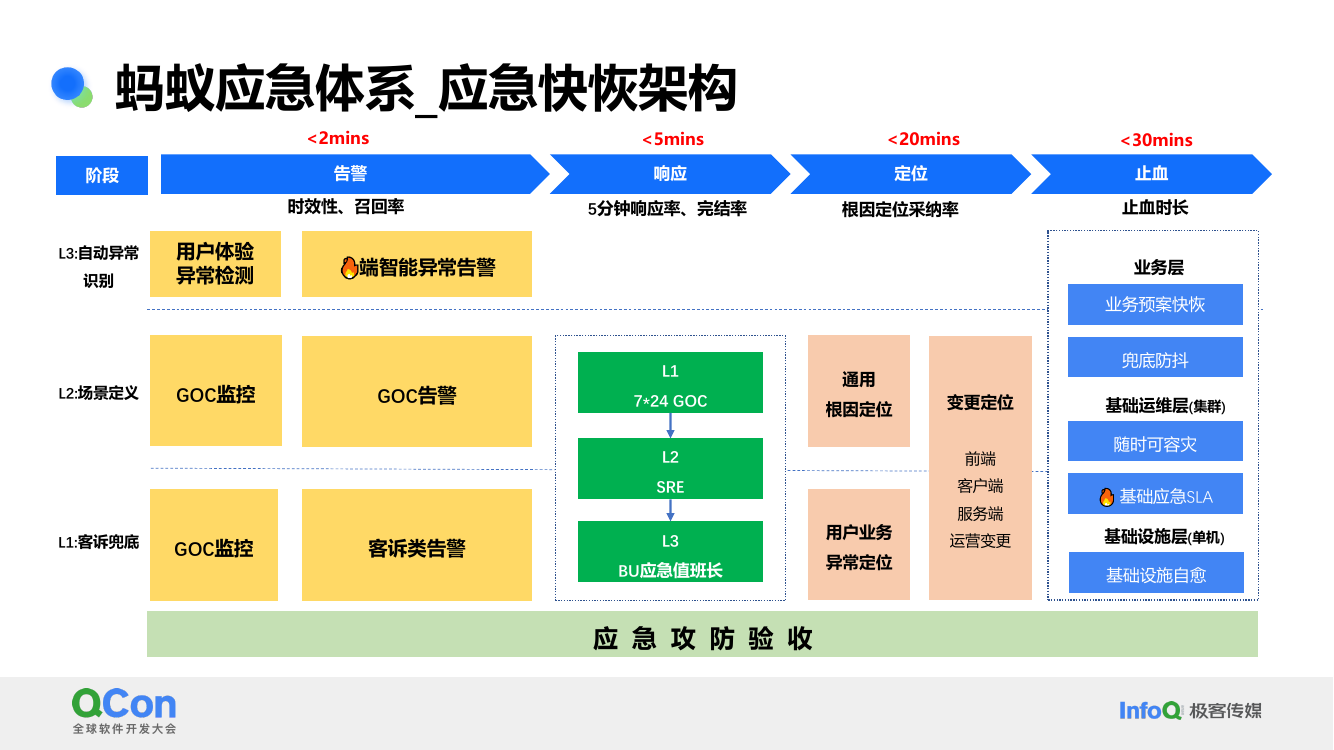
止血五类:业务预案(整体 / 单功能 / 异步 / 链路弱依赖降级等)/ 基础运维(扩容 / 重启 / 限流 / SQL 限流 / DB 切主)/ 容灾切流(机房 / 链路 / 单应用 / 基础设施切流)/ 变更回滚(服务端 / 前端 / 客户端 / DRM / 运营 / DB/VIP 回滚)/ 其他(停压测 / 停自愈 / 查杀任务 / 预热 / 订正 / 迁移)。
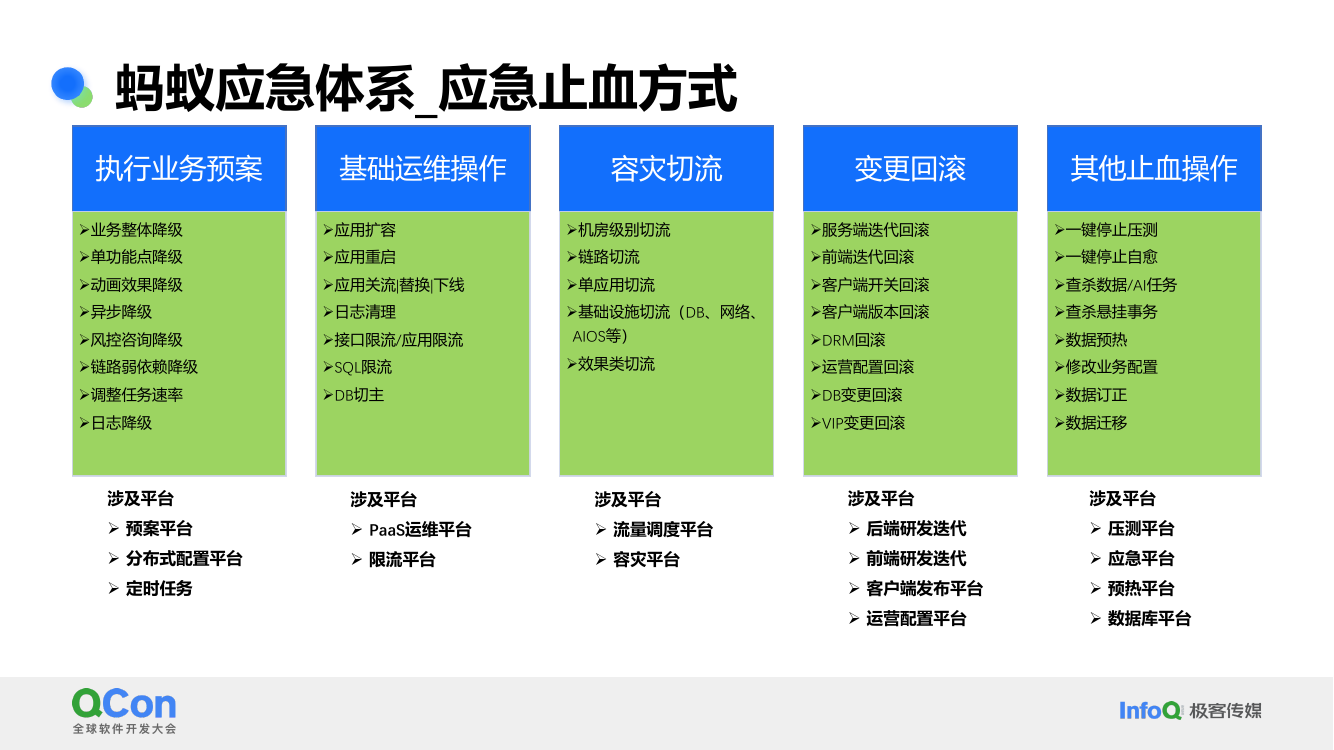
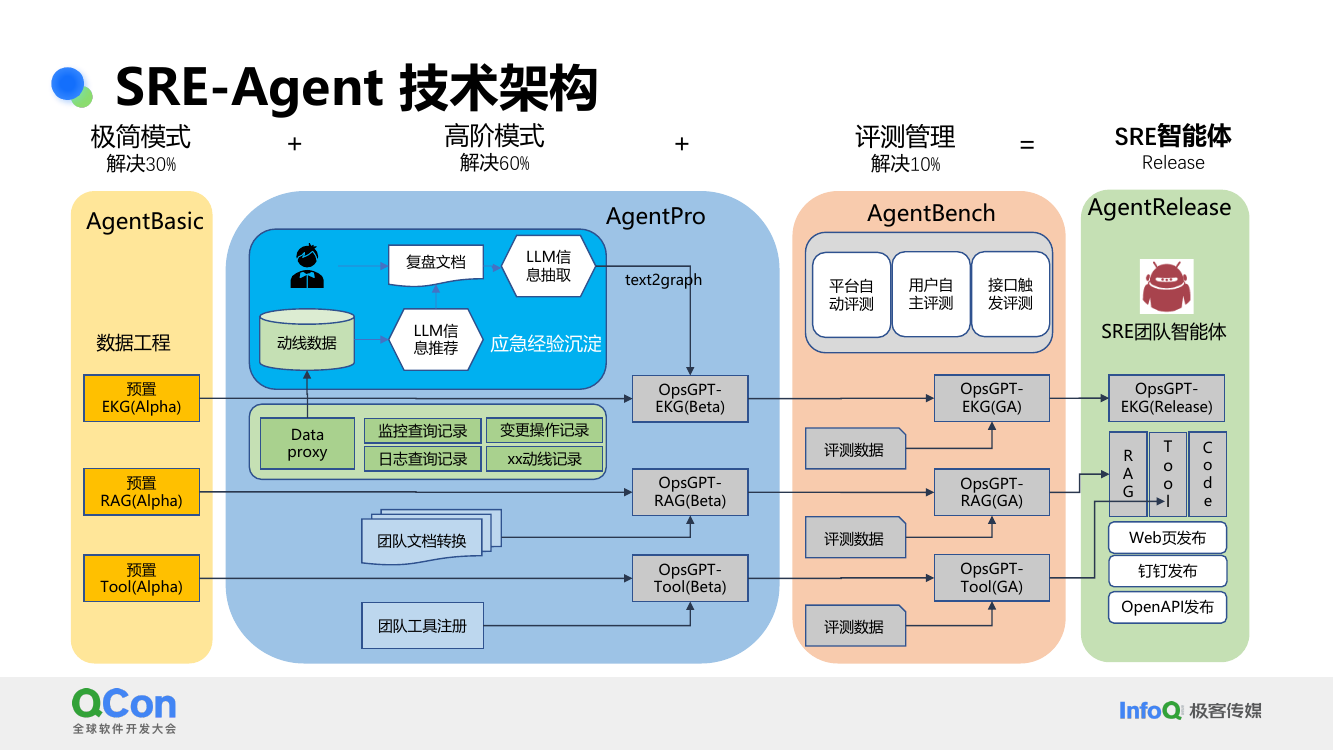
SRE-Agent:AgentBasic 极简 30% + AgentPro 高阶 60% + AgentBench 评测 10% = Release;预置 EKG(监控 / 日志 / 变更 / 动线记录 Data proxy)+ RAG(团队文档)+ Tool(团队工具注册);评测数据 → Web / 钉钉 / OpenAPI 发布。
核心理念:Fix the Problem, Not the Blame(对事不对人)。
3.8 刘向阳《系统稳定与信息安全 —— 体系建设与实战经验》(美的 CISO)
📄 来源飞书文档:刘向阳《系统稳定与信息安全 —— 体系建设与实战经验》(https://my.feishu.cn/wiki/ESz0woT4hibY1OknO9Acj8J9nkh)
稳定性度量体系
-
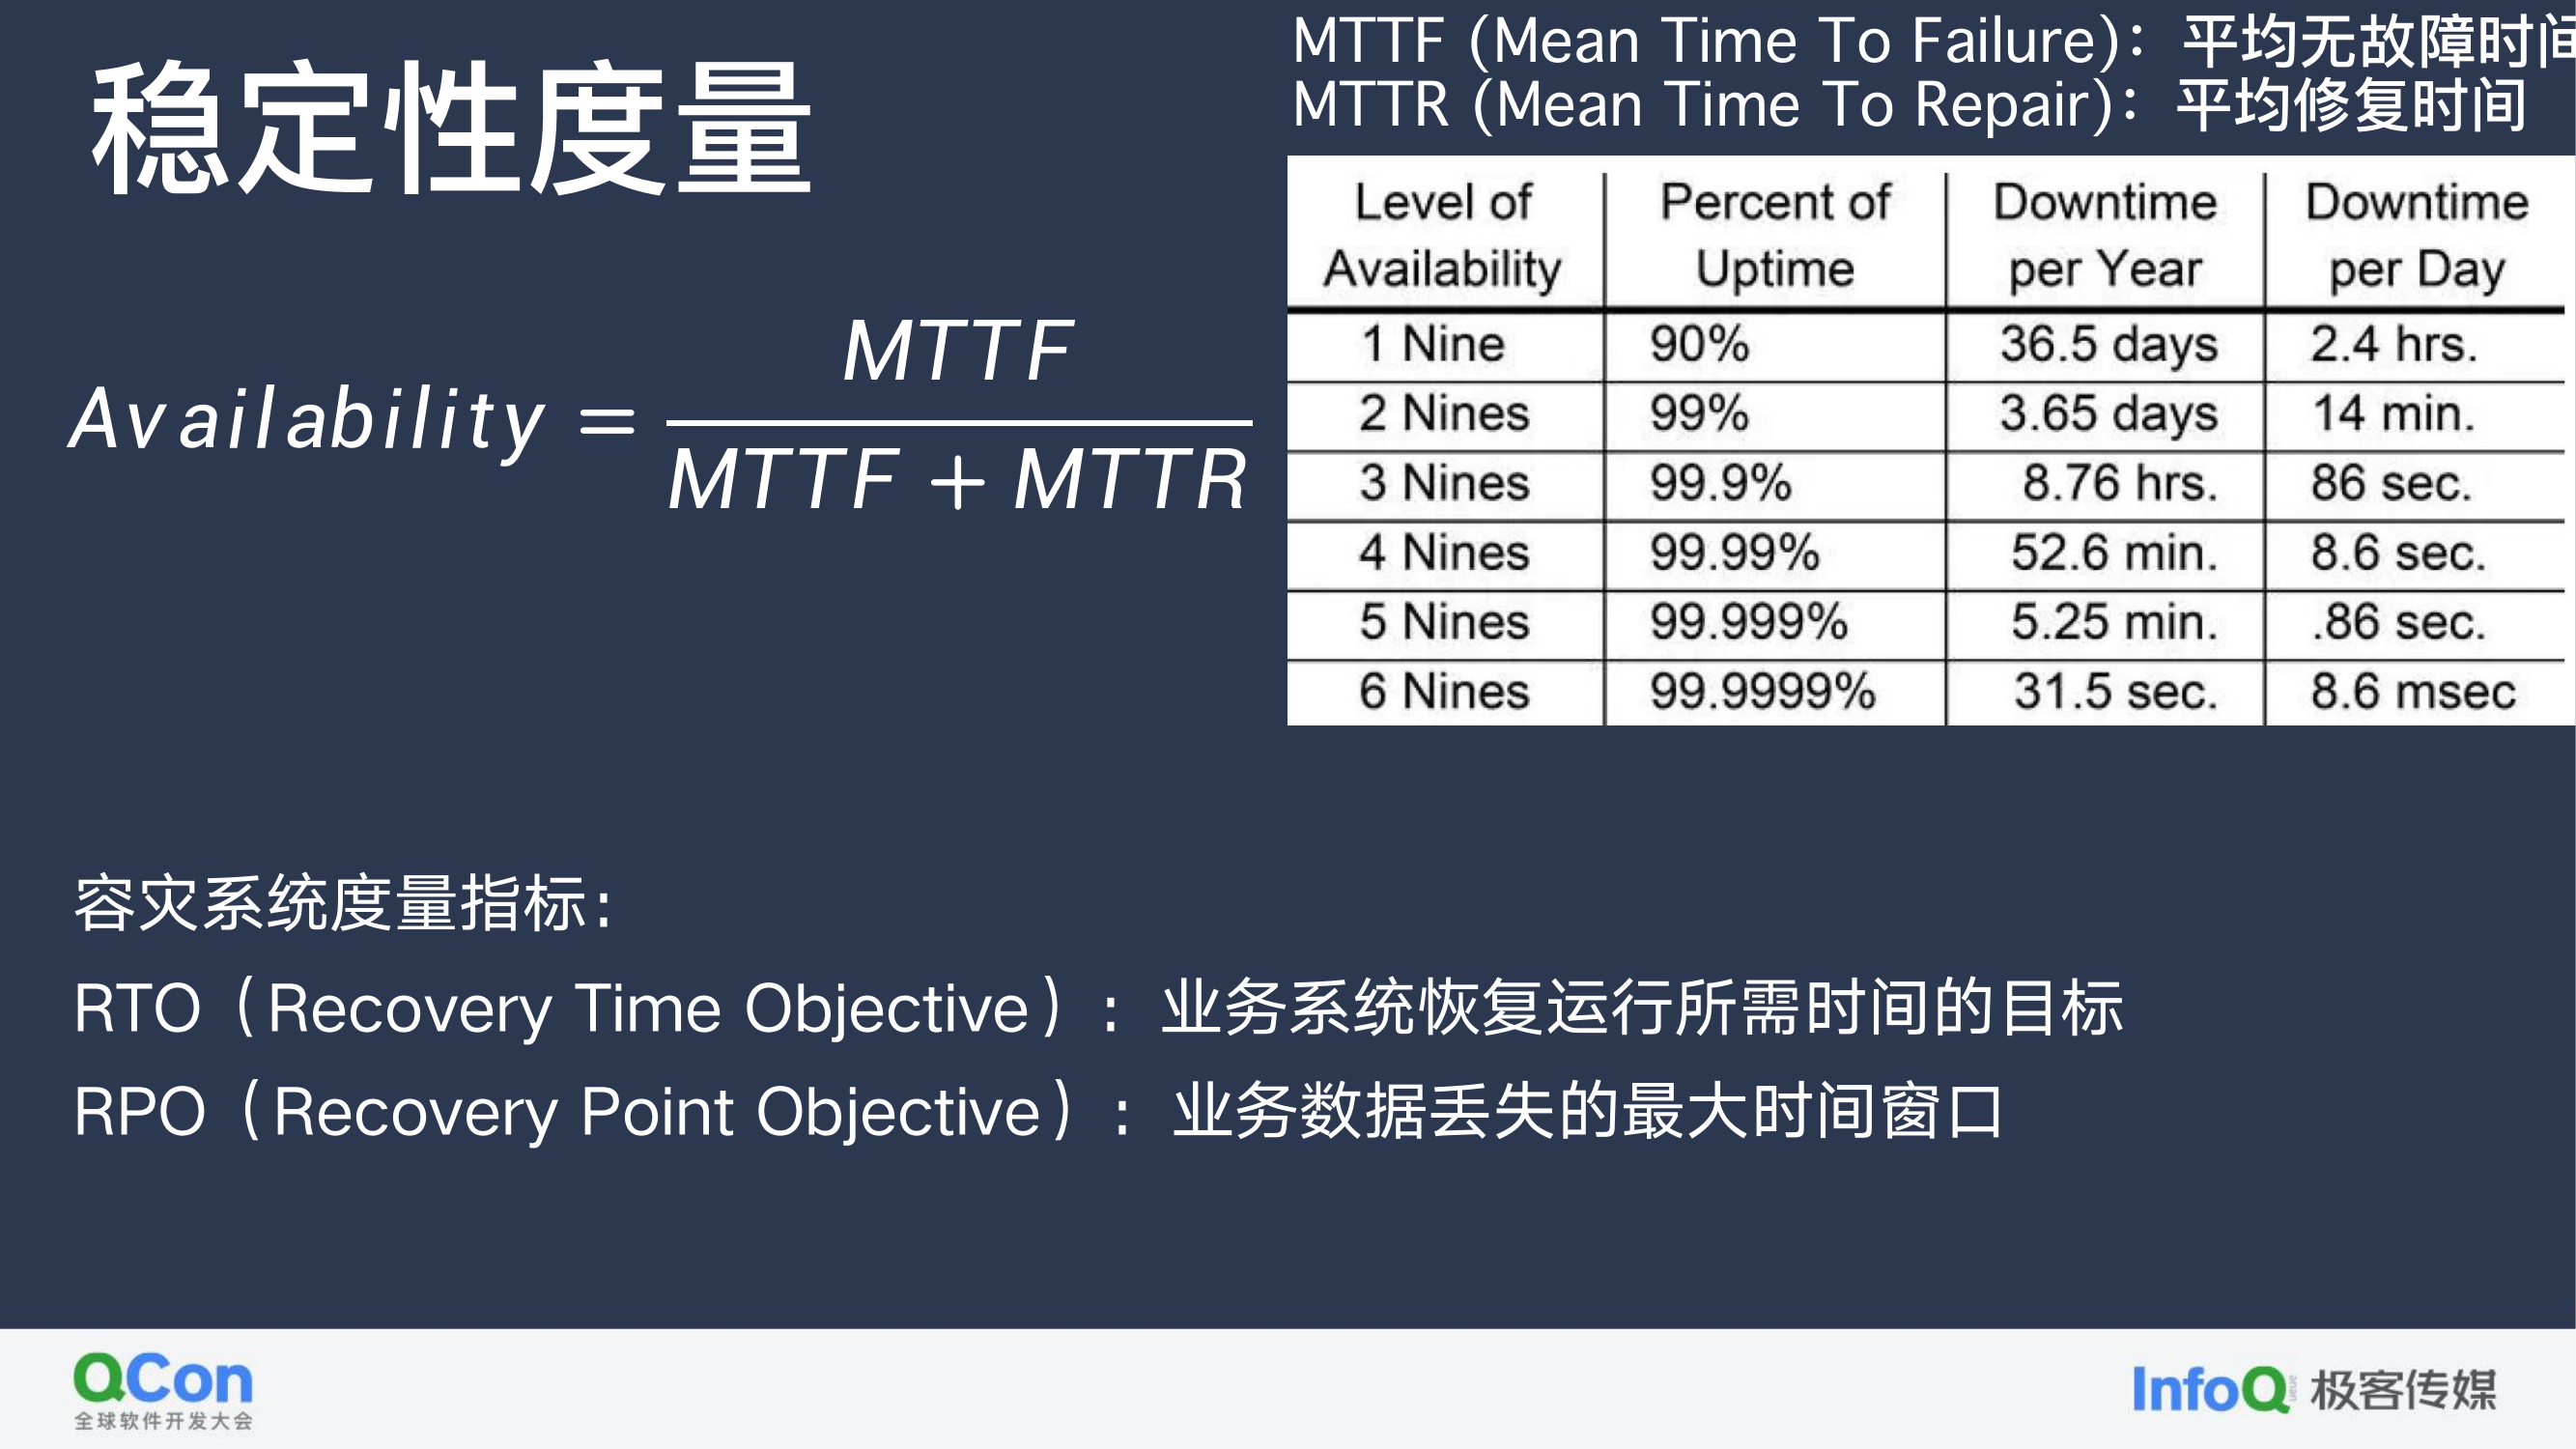
MTTF(平均无故障时间)/ MTTR(平均恢复时间)/ Availability = MTTF / (MTTF + MTTR);容灾指标 RTO / RPO。
-
故障 = 风险 + 触发(必然 + 偶然)—— 风险是必然的,触发是偶然的,预防抓风险、处置抓触发。
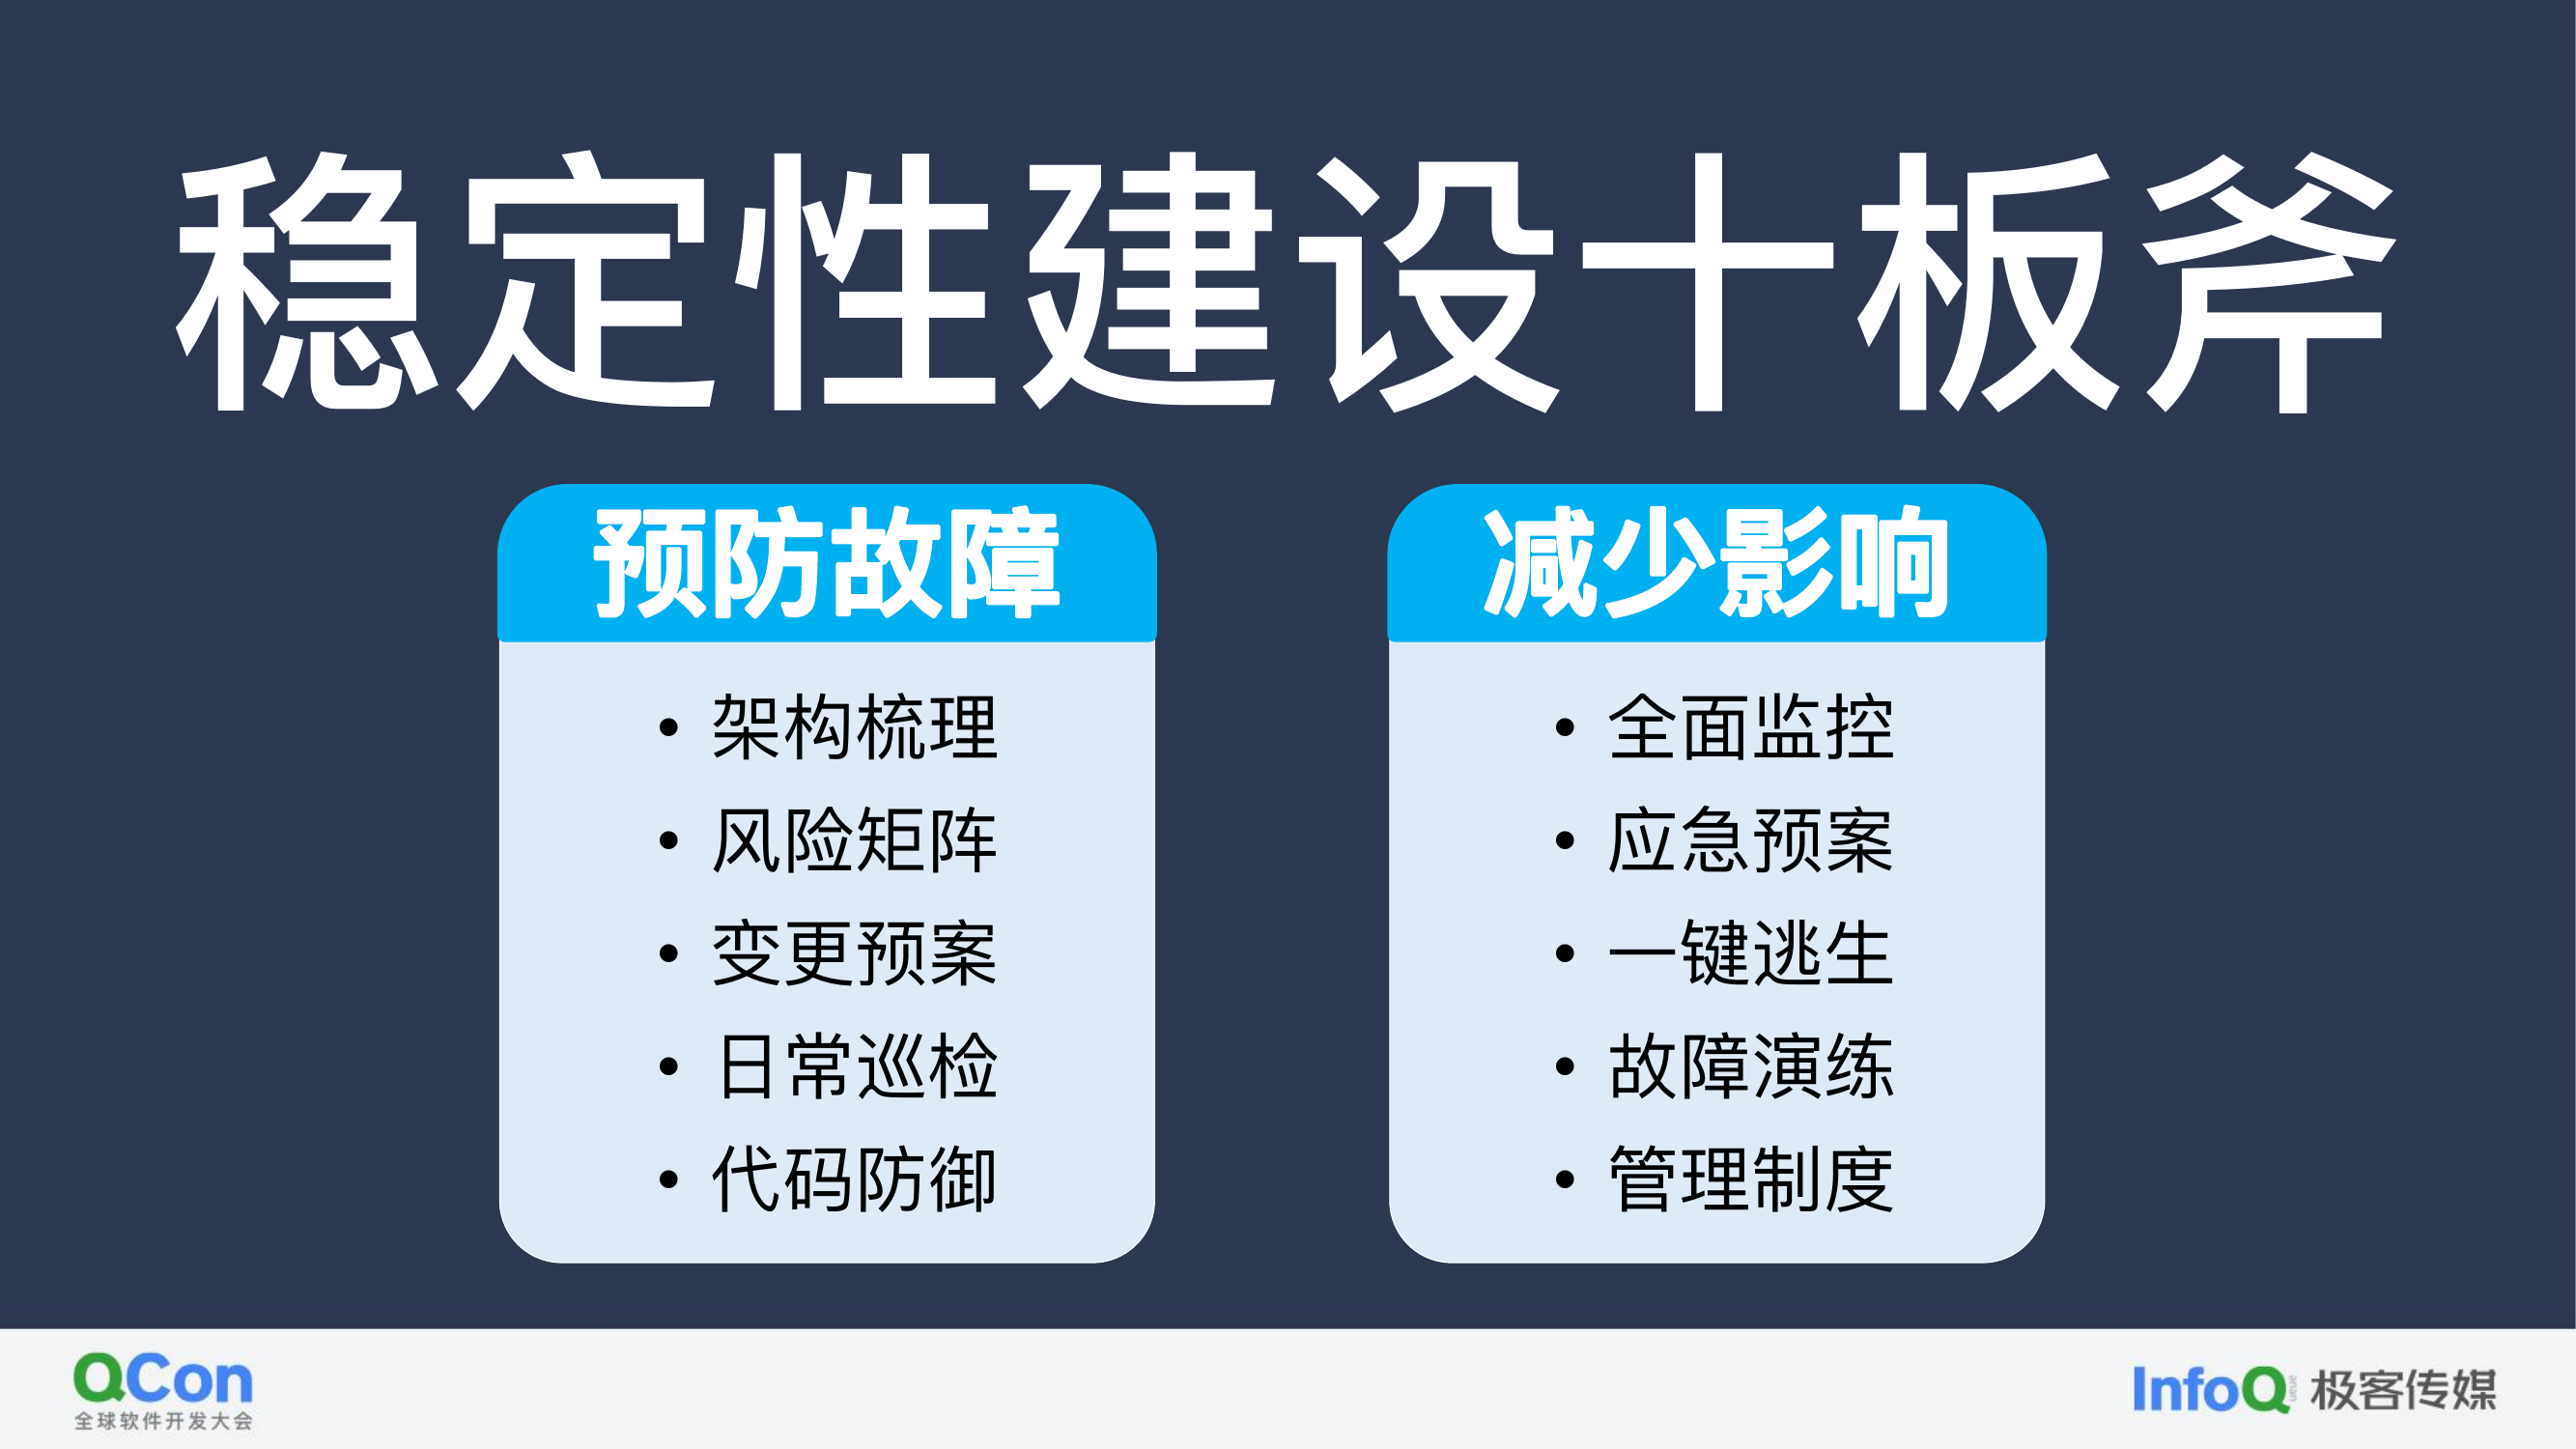
稳定性建设十板斧(预防 5 + 减少影响 5)
-
预防故障:架构梳理 / 风险矩阵 / 变更预案 / 日常巡检 / 代码防御。
-
减少影响:全面监控 / 应急预案 / 一键逃生 / 故障演练 / 管理制度。
关键板斧要点
-
架构梳理 = 面向失败设计:单点消除(硬件 / 存储 / 网络 / 机房 / 依赖 / 注册);冗余设计(数据一主多备 / 计算 / 网络 / 存储);弱化依赖 / 分库分表 / 限流降级熔断 / 动态扩缩容 / 链路分析;高性能(索引 / CDN / 冷热分离);灾备(冷备热备、数据 / 应用 / 业务级容灾、两地三中心三地五中心)。
-
风险矩阵 = 死法理全,树状逐层分析(风险信息 / 故障预防 / 故障发现 / 应急预案)。
-
变更预案 = 走灰度、备回滚、盯监控。
-
日常巡检 = 基础信息 / 集群状态 / 业务状态,人工 → 自动 → 平台。
-
代码防御 = 防御性编程(防别人 / 上游 bug)+ 输入检查 + 异常处理 + 自愈代码 + 日志规范 / 幂等 / 资源泄露 / 事务 + 流量回放 Fuzzing。
-
全面监控 = 系统(主机 / 网络 / 中间件 / DB)+ 应用(五慢监控:慢查询 / 慢消息 / 慢响应 / 慢调用 / 慢缓存,全链路字节码增强)+ 业务(指标拉取 / 日志读取 / 拨测)+ 终端。
-
应急预案 = 无脑化止血流程图 + 止损兜底降级开关 + 谁通知谁协调谁决策 + 快速止血优先非查根因 + 保留现场 + 资金损失第一时间升级。
-
一键逃生 = 防火墙 / WAF / 上网行为管理 / SSLO 等阻断性设备备好 bypass。
-
故障演练 = 演练种类(故障 / 灾难)+ 严控爆炸半径 + 混沌工程 + 全链路压测(场景编排 / 压力模型 / 生产压测流量透传 / 数据隔离 / 服务挡板 / 风险保护)。
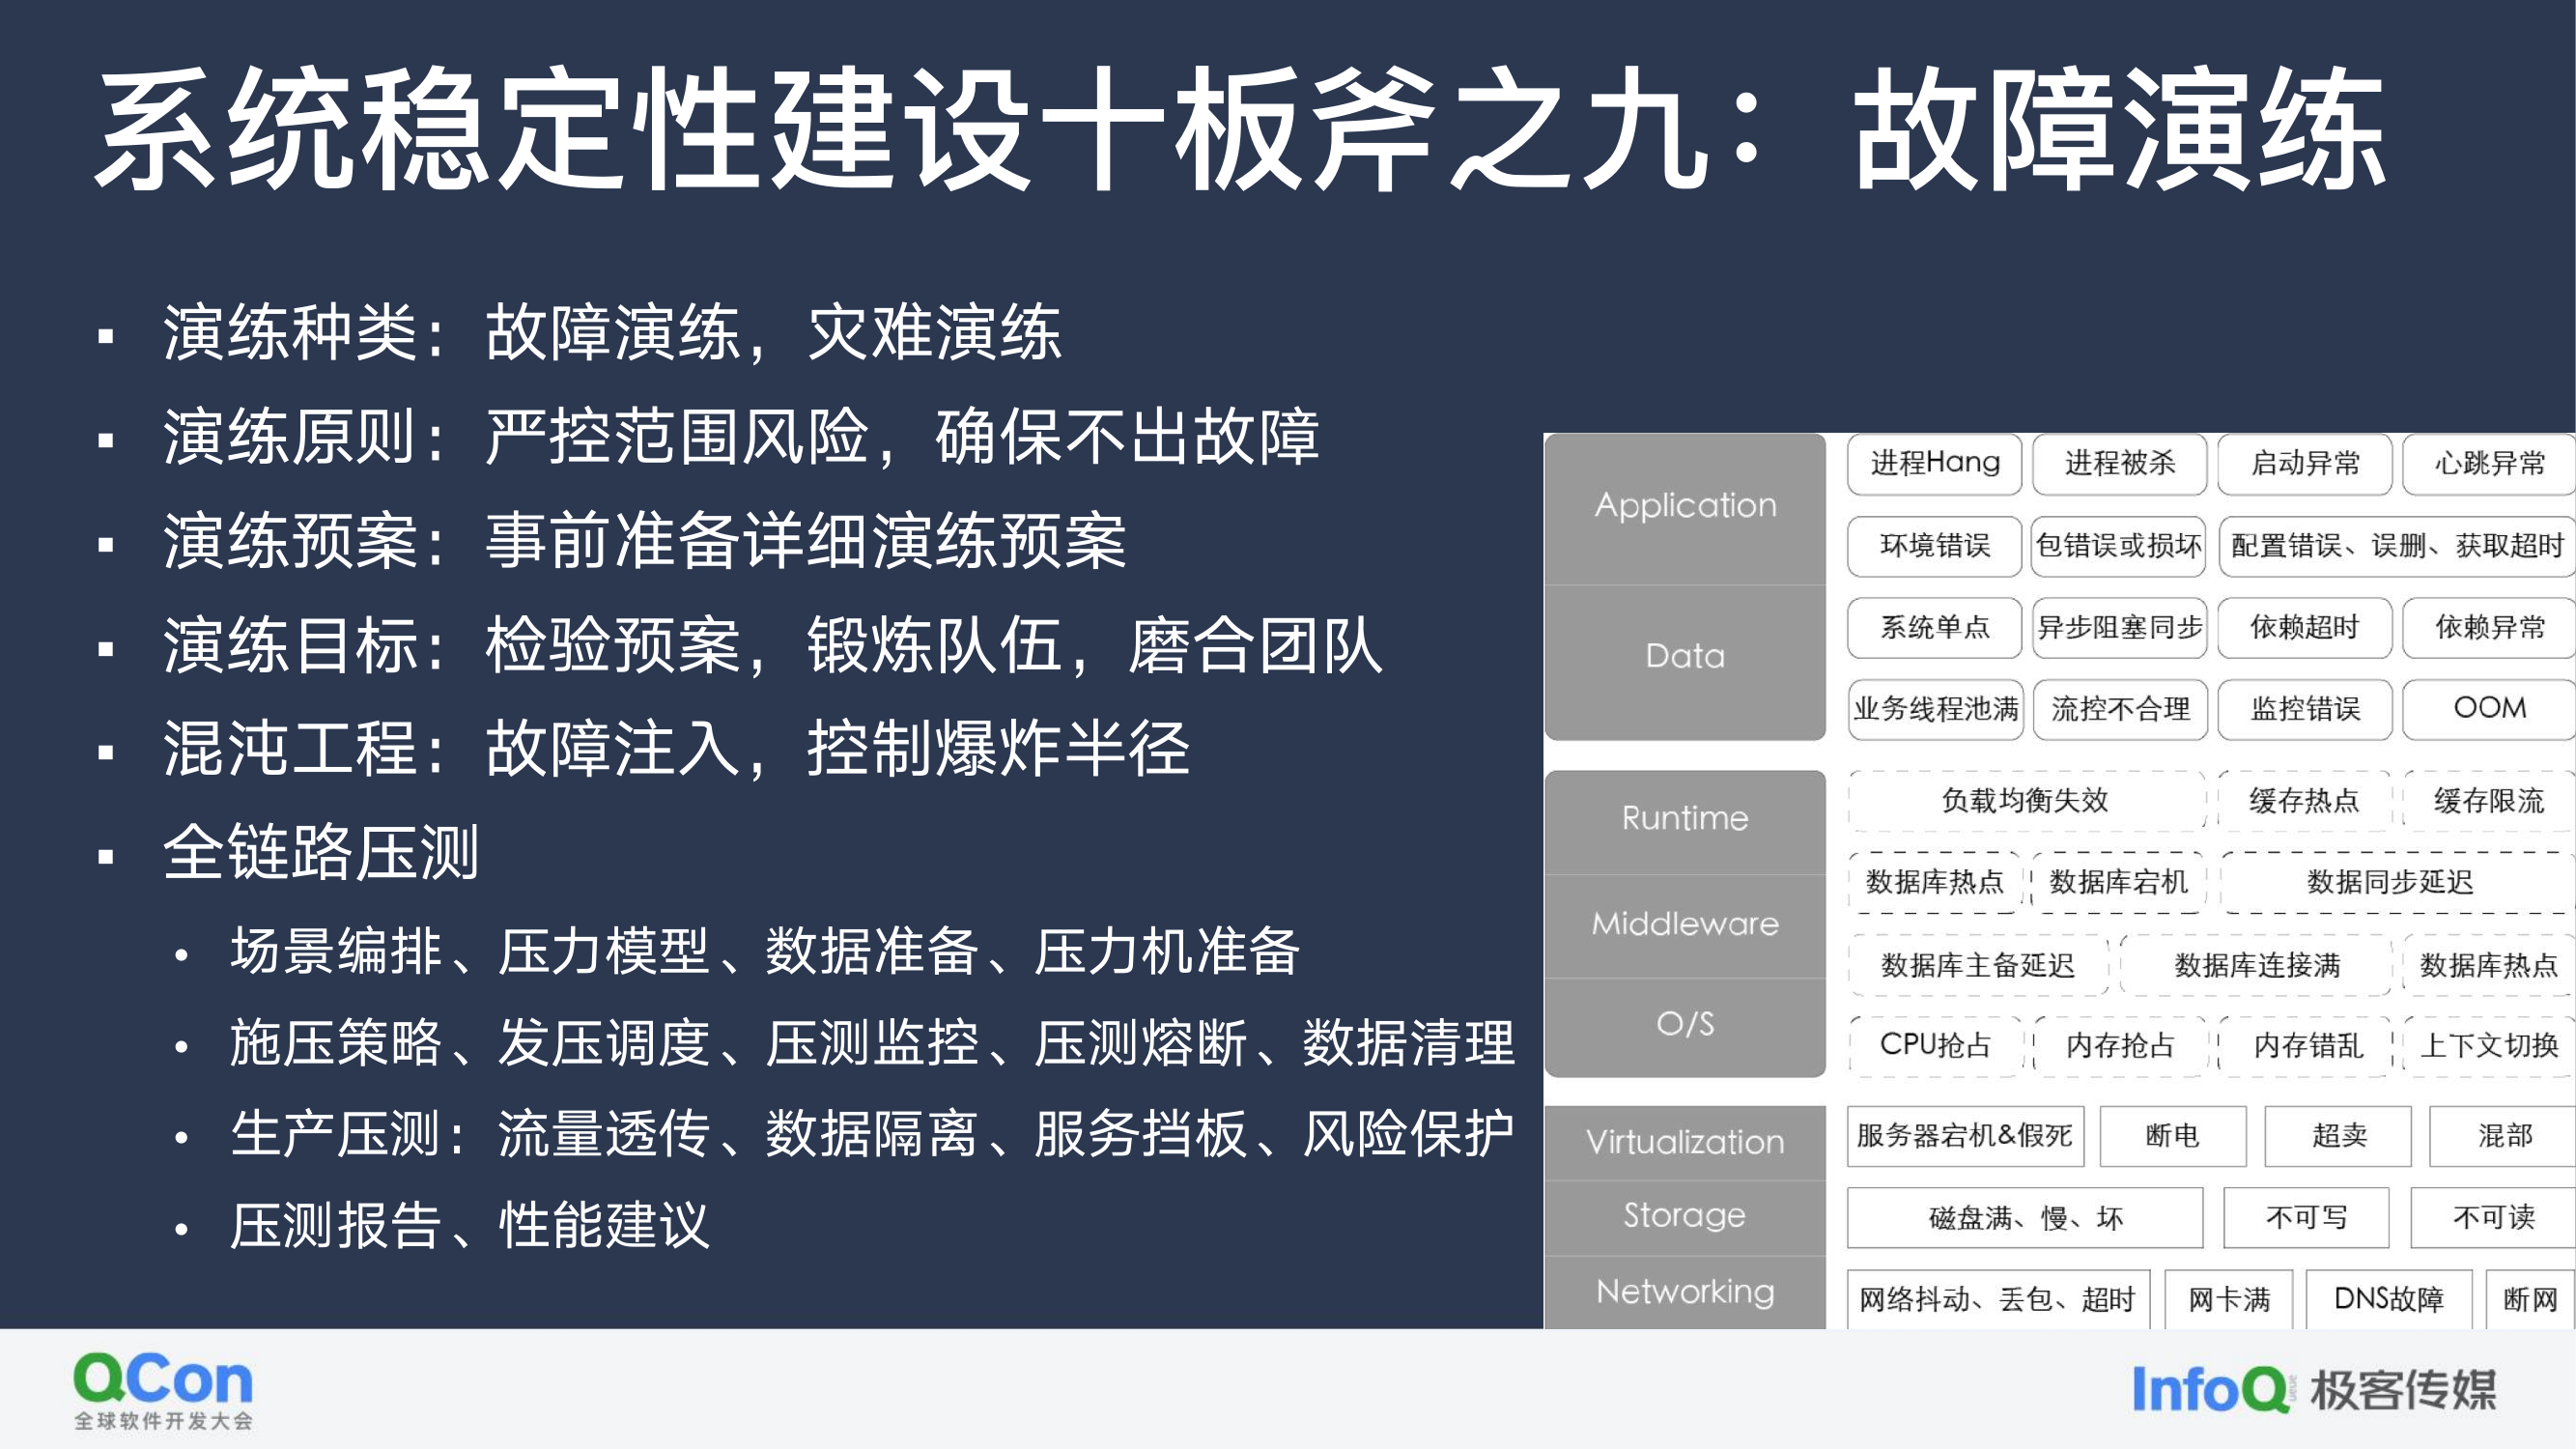
- 管理制度 = 7×24 值班 / 故障复盘(自己的 + 别人的)/ 风险矩阵核查(遗漏还是被击穿,两者都举一反三)/ 监控检讨(谁先发现)/ 应急检讨 / 举一反三。
信息安全五板斧
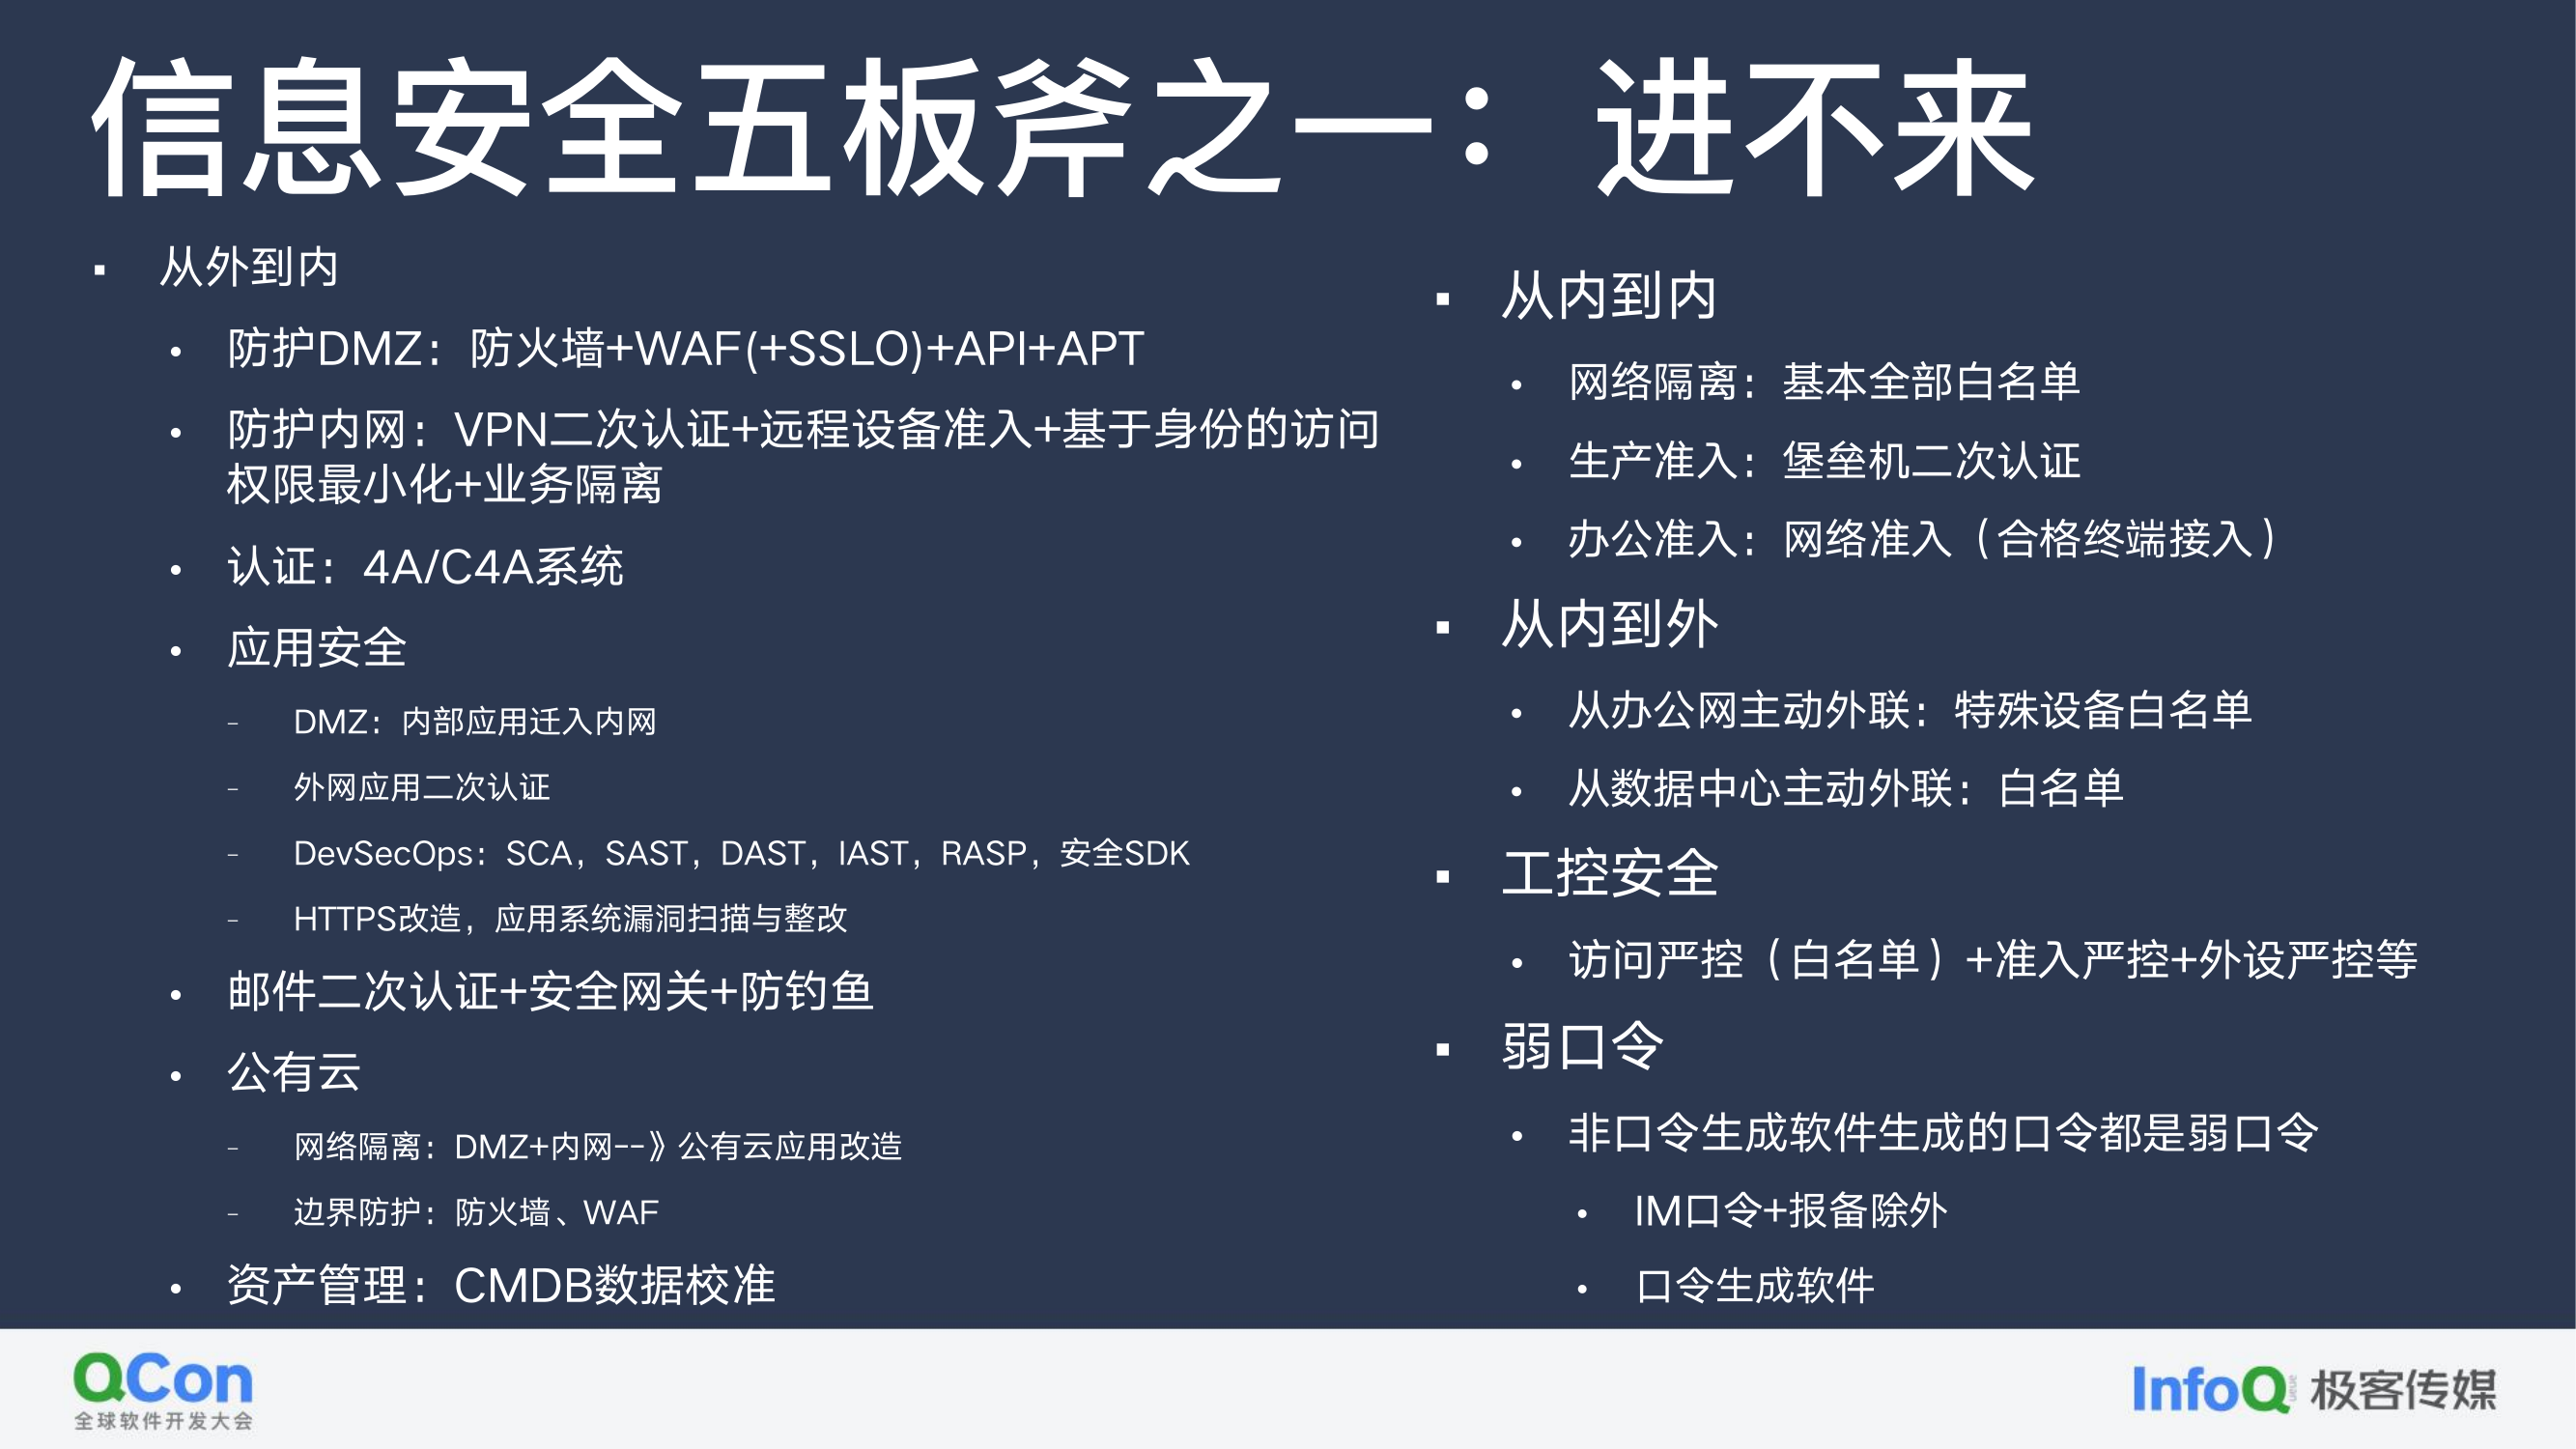
- 进不来:DMZ 防火墙 + WAF + SSLO + API + APT、VPN 二次认证 + 准入 + 最小权限、4A/C4A、DevSecOps(SCA/SAST/DAST/IAST/RASP)、白名单网络隔离、堡垒机、CMDB。
-
能发现:HIDS/EDR + 内存安全 / 流量探针 / 沙箱 / API 安全 / APT 检测 / DLP/UEBA/SOC。
-
防泄漏:终端 DLP / VPN 准入 / 防拖库 AI 监控 DRA / 加密 KMS / 分类分级。
-
保合规:隐私设计指引 / DPIA / 等保七项 / 数据跨境非必要不出境 / APP 隐私治理重点。
-
重运营:CISO 体系 / 7×24 / 及时止血、刨根问底、举一反三 / SOC+BAS 平台 / 推土机精神。
3.9 刘昊《B 站轻量级容灾演练体系构建与业务实践》
📄 来源飞书文档:刘昊《B 站轻量级容灾演练体系构建与业务实践》(https://my.feishu.cn/wiki/YKqpwH3HNiinofkoiX2cGqban3g)
行业挑战与多活分层映射
-
业务复杂 + 基础设施故障增多(案例:商业 CDN 回源级联 / IDC 专线异常未多活 / 代码变更回源过载 / 机房专线异常 / 光缆中断单可用区脱网)。
-
多活分层映射:DCDN/CDN 三方 → SLB/API GW → BFF/Service → 缓存 DB KV / 中间件 → PaaS/IAAS 混合云,对应容灾手段:灾备降级 / 容灾多活 / 微服务治理 / Failover / 基础多活。
演练演进时间线:2018 演练 1.0 故障注入 → 2020-2021 演练 2.0 统一混沌平台五大原则 → 2022 演练 3.0 轻量级容灾演练全覆盖。
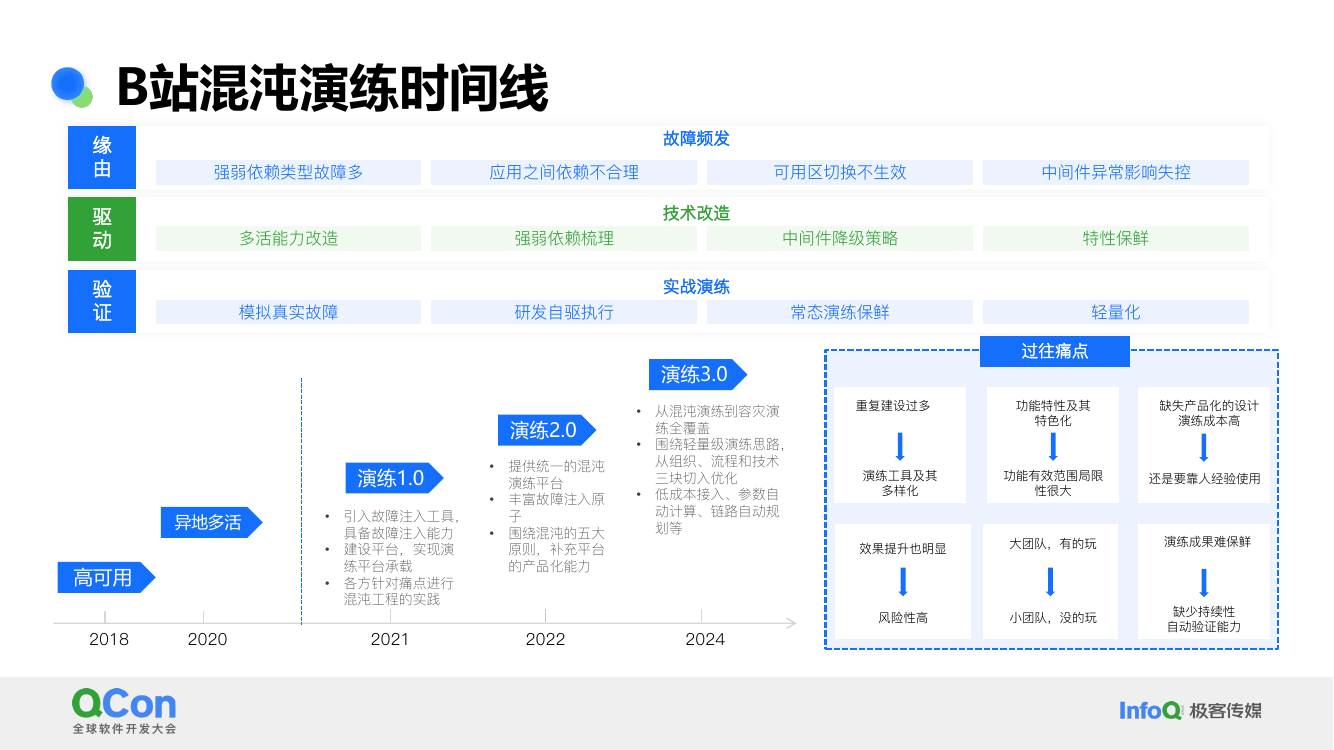
演练 3.0 三支撑(流程 / 技术 / 组织)
-
流程:固化组织 + 技术流程标准化 + 产品化降低心智负担。
-
技术:丰富可观测 + 自动回收验证 + 严控爆炸半径(智能计算范围 + 影响面评估 + 监控告警快速介入 + 紧急中止)。
-
组织:协同机制 + 收益认识 + 培训。
体系全景:基础混沌工具 + 高级混沌工程 + 一站式能力(演练计划 / 任务 / 编排 / 实验 / 观测 / 报告 + 演练管理 + 实验关联执行 + 经验沉淀)+ 组织文化(CI 流程 / 应急响应 / 容灾演练 / 攻防演练 / 制度 / 文化宣贯 / 大模型问答 / 场景缺陷分析);原子故障库(CPU / 内存 / 磁盘 / 网络 / 应用 / 容器异常)。
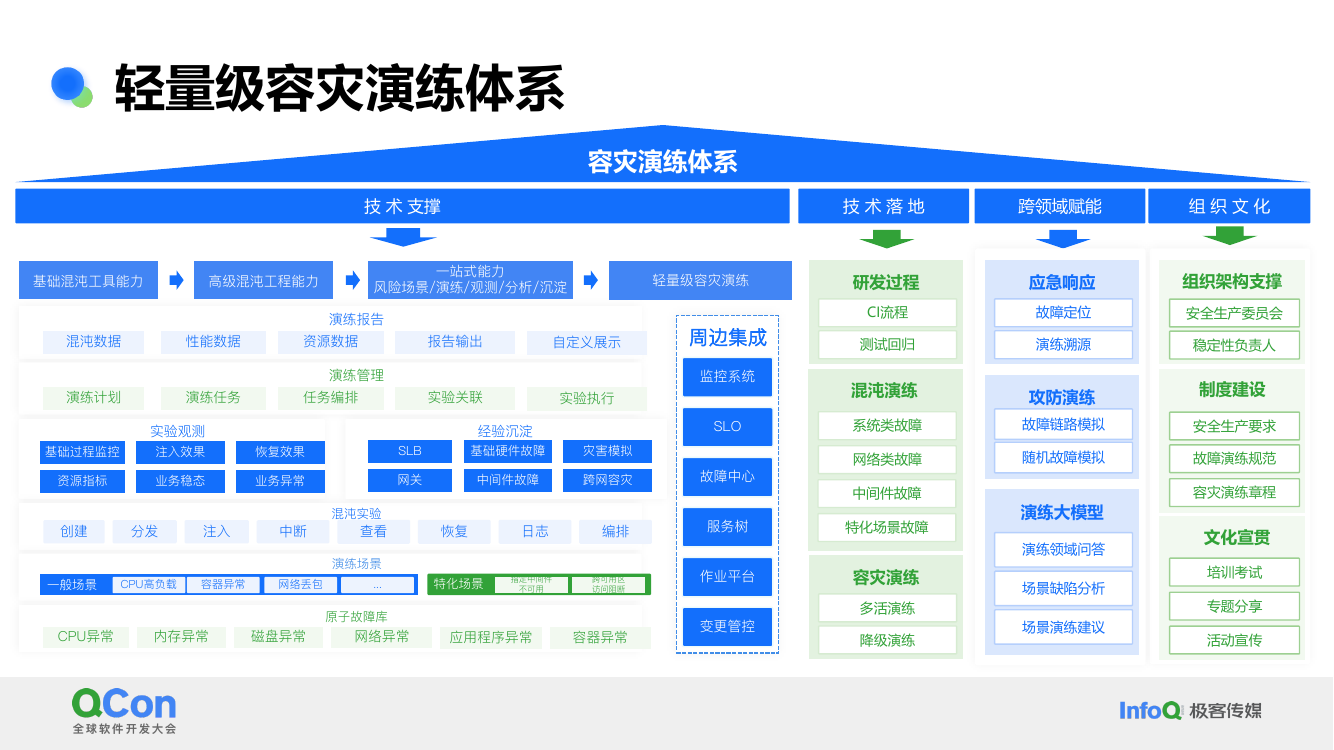
技术六化(技术支撑核心)
-
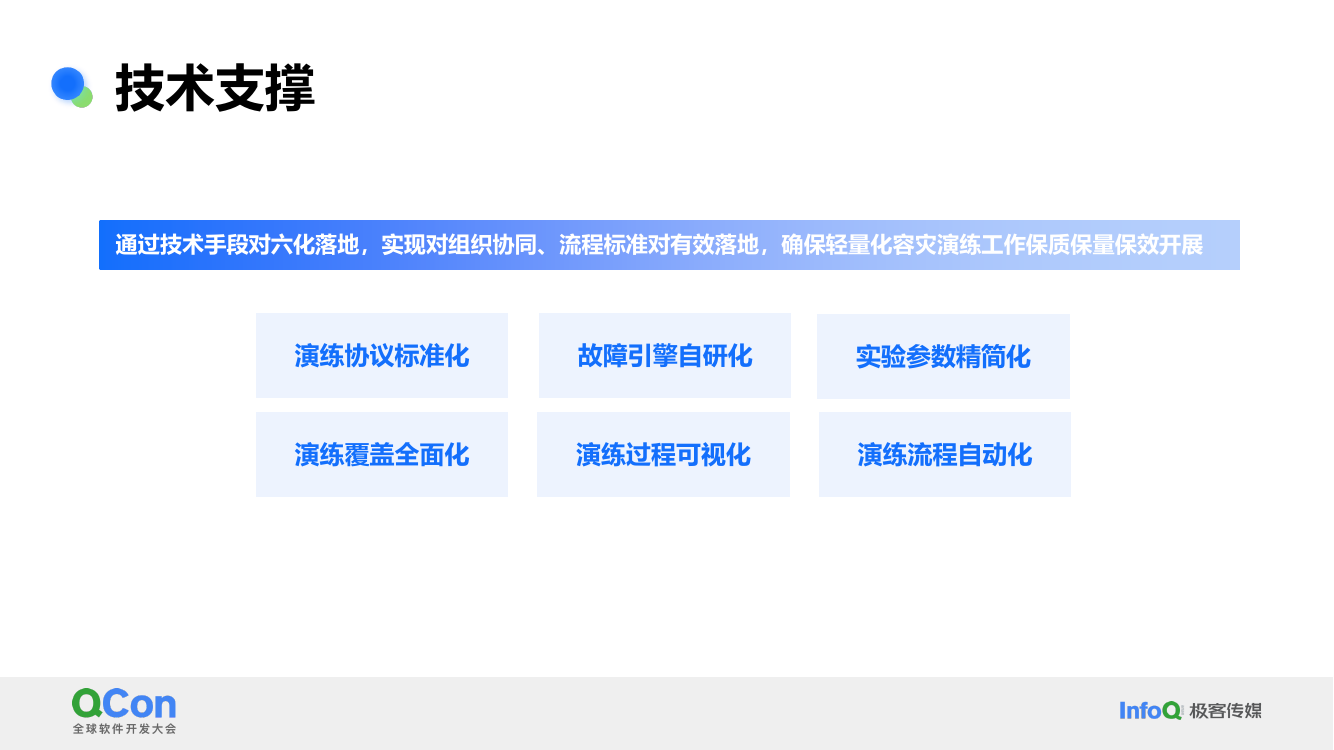
协议标准化:抽象统一描述模型 + 交互模型 + 适配器归一化(标准实验描述 / 交互协议:注入 / 恢复 / 查询 / 验证)。
-
故障引擎自研化:ChaosBlade 二开(修复 DNS 干扰逃逸 / 超长命令失败 / CPU Load 步长不匹配 /tc 恢复不达预期;补状态上报 / 鉴权 / 观测)。
-
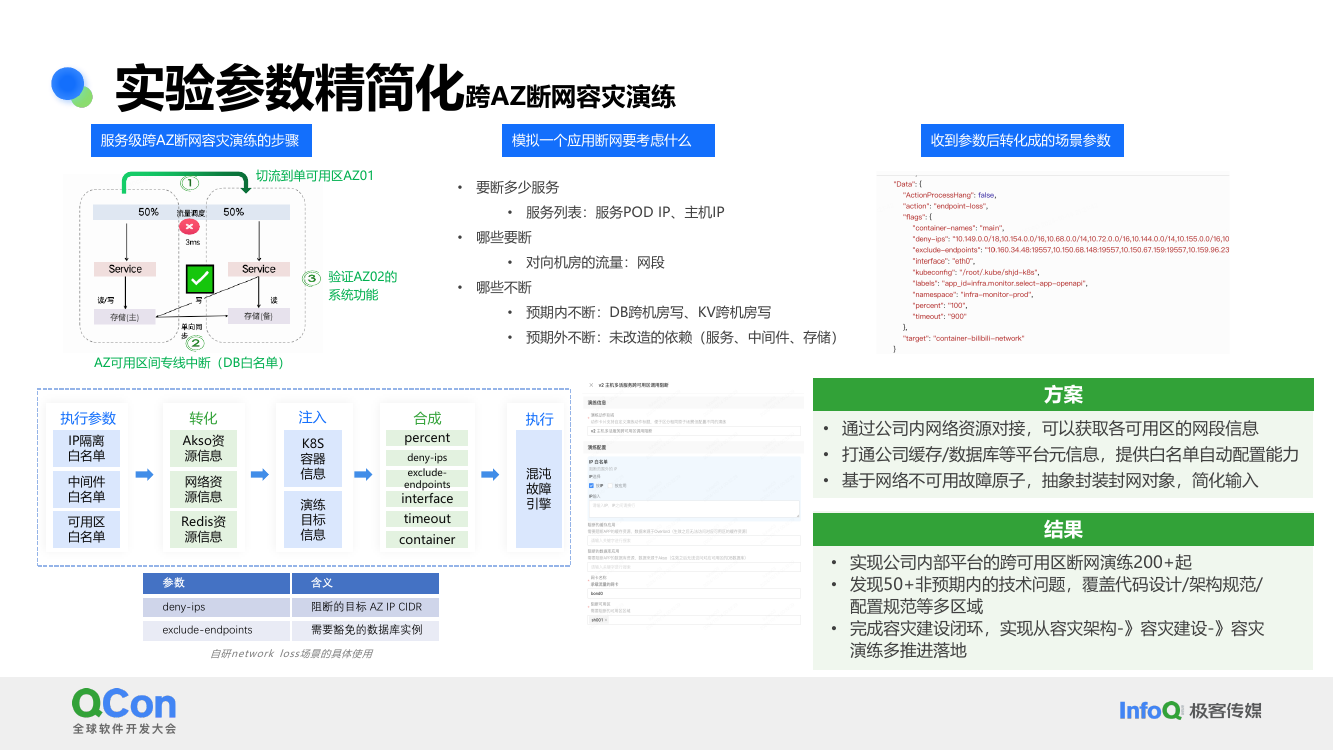
实验参数精简化:声明式替代过程式(deny-ips/exclude-ips/deny-endpoints/exclude-endpoints/exclude-ports)。
-
覆盖全面化:统一 region/zone + CMDB 自动圈选 + helm 规范化(1W+ 服务 / 20+ 集群种类 / 10W+ 集群 / 几十万容器)。
-
过程可视化:Adapter → 标准监控模型 + 关联上下游告警 + 动态 / 静态拓扑。
-
流程自动化:UI 自动化 + 多场景 / 单应用接口测试 + 定时调度器分钟级 + 护栏 + 预期自动验证回收报告。
业务场景演练实践
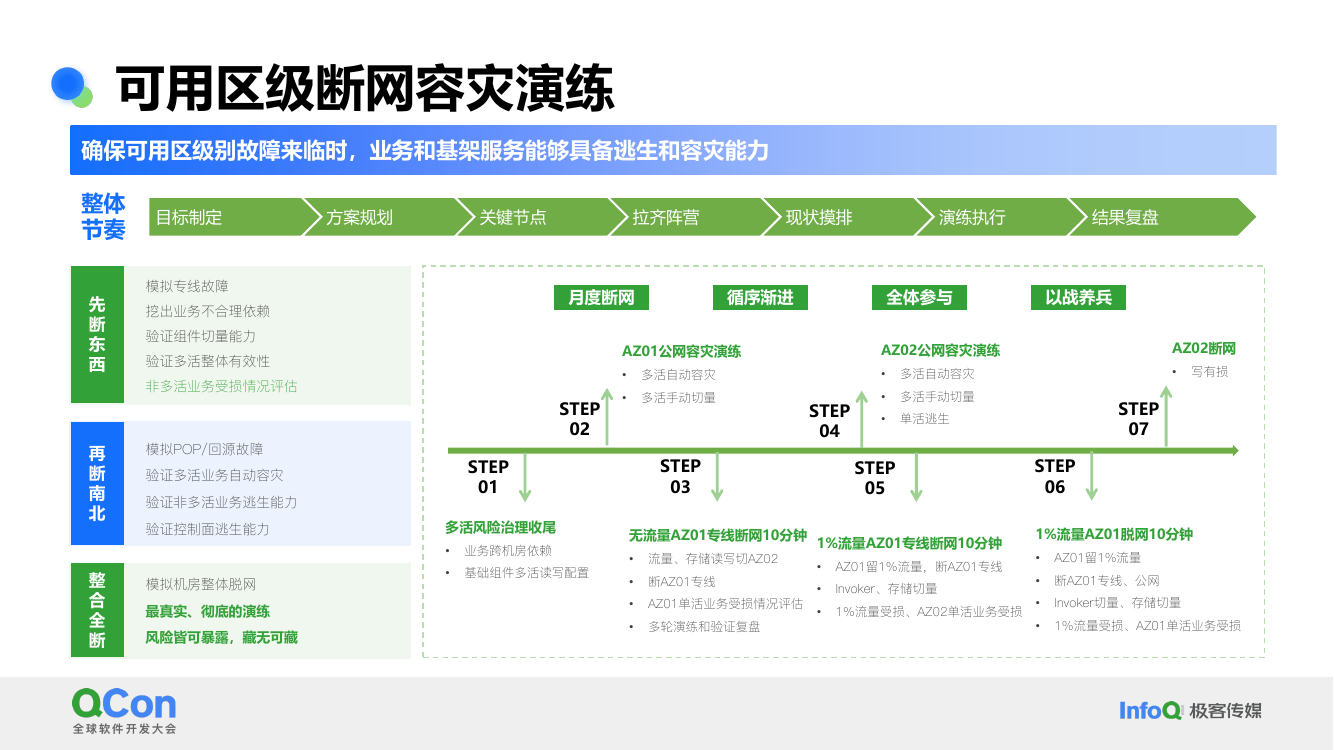
- 可用区级断网容灾演练:先断东西 / 再断南北 / 整合全断;月度断网循序渐进 = 无流量 AZ01 专线断 10 分钟 → 1% 流量断网 → AZ01/AZ02 公网容灾多活自动 / 手动切量 → AZ02 断网单活逃生写有损 → 1% 脱网。
-
集成测试演练:平台 OpenAPI + QA 设计用例 + 染色自动圈定 CI 打通 + 自动化开启关闭实验;关键 = 强弱依赖场景流水线验收 + 极短时长 + 复用既有自动化。
-
S 赛演练:场景分级 L0/L1/L2 + 场景地图 5w2h 梳理 + 专项演练暴露问题(弱依赖误实现 / 降级未考虑 / 降级不生效 / 客户端强依赖容错)。
-
收效:规划周 → 天;覆盖率头部 → 全覆盖;频次季度 → 周;验收成本天 → 分钟;32 混沌原子 / 10+ 部门 / 3000+ 演练 / 100+ 隐患。
实践反思:明确目的 / 结合业务特性量身定做 / 三类高价值演练 / 自动化关键 = 护栏有效性 + 验证自动化 / 面向演练场景用例 / 流量录制转接口用例 / 不同阶段不同实验。
3.10 艾瑞坤《基于 LLM 实现的线上项目自我修复与智能容灾的原理与实践》
📄 来源飞书文档:艾瑞坤《基于 LLM 实现的线上项目自我修复与智能容灾的原理与实践》(https://my.feishu.cn/wiki/U85CwvGPqihYW7kCmbrcNkuNnOd#page_number=8&bbox=%5B0%2C0%2C1%2C1%5D)
落地四件事:研发提效 / 智能审核(稿件负向评论成功率 73%)/ 智能 OnCall(覆盖率 30%)/ 智能容灾(300 人 + AI > 1000 人)。
智能修复四步闭环
-
全局错误事件捕获 → 获取完整错误栈(报错信息 / 编译后文件路径 /trace)。
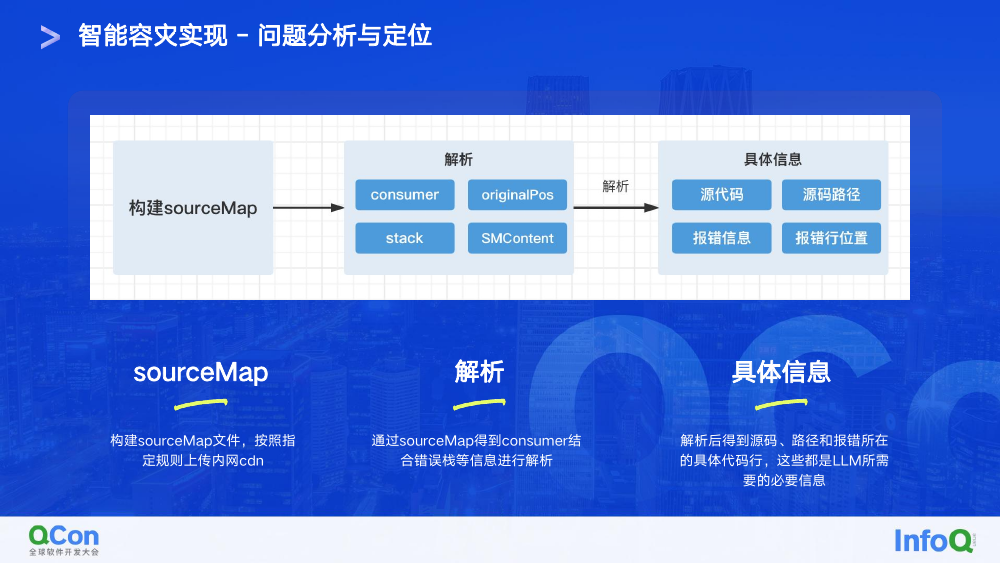
-
归类统计判断趋势紧迫 → 构建 sourceMap 上传内网 CDN → consumer 结合错误栈解析 → 得到源码 / 路径 / 报错行(LLM 必要信息)。
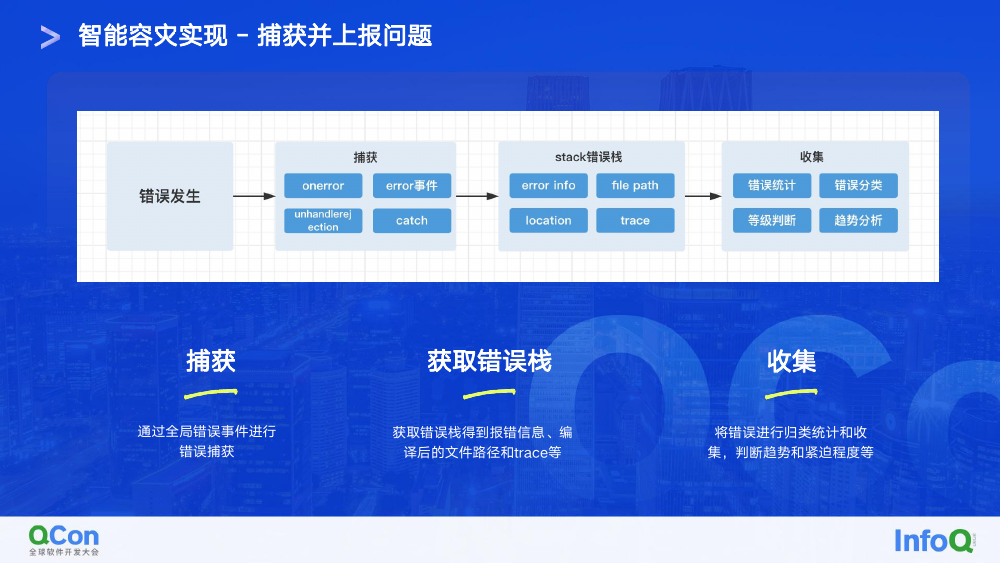
- 数据标准化透传 LLM(源码 / 报错信息 / 行数 /prompts)→ LLM 输出修复代码。
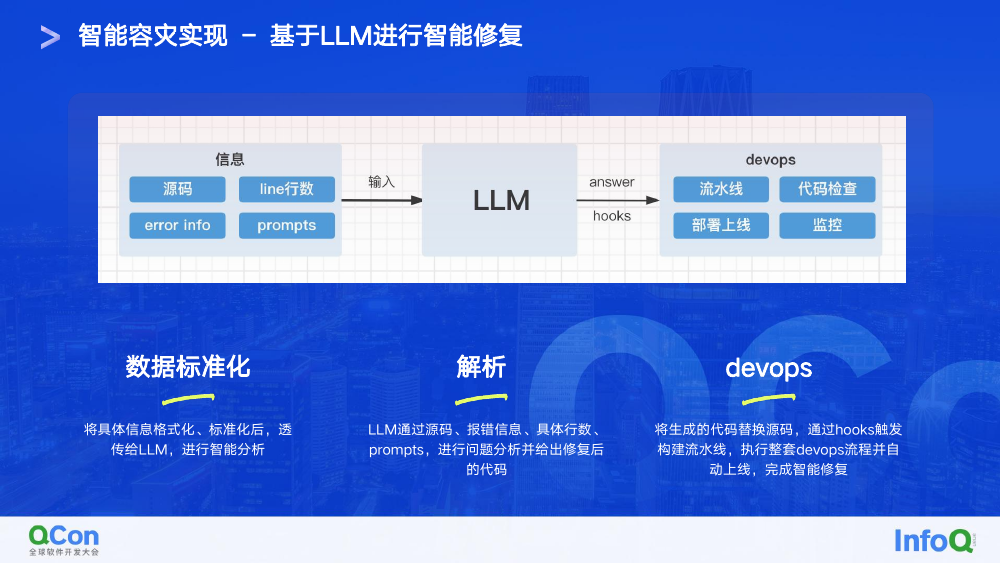
- 替换源码 hooks 触发构建流水线 devops 自动上线(LLMOps)。
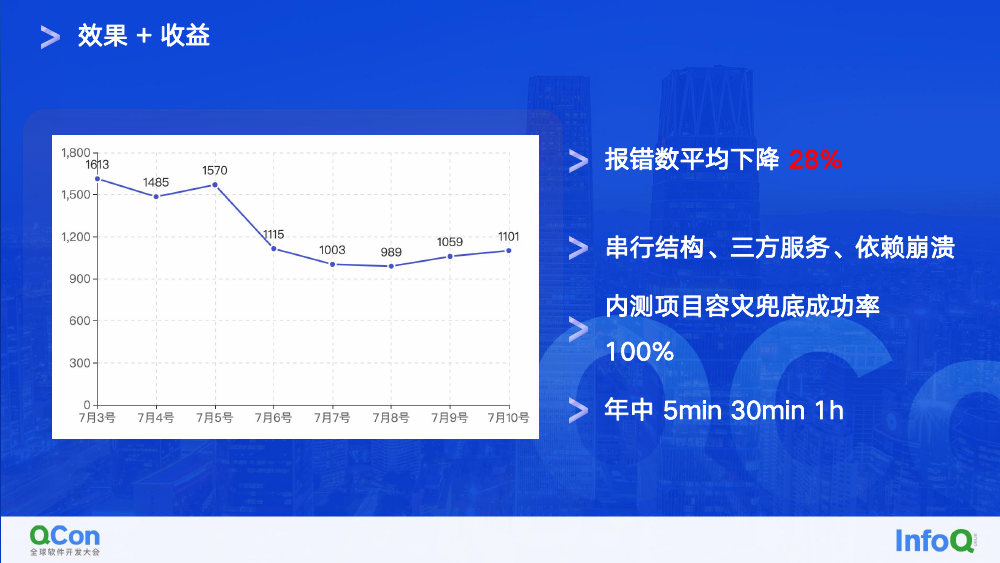
效果 + 收益:报错数平均下降 28%、内测项目容灾兜底成功率 100%。
研发提效
-
AST 精准修改代码:parser → traverse → Declaration+Specifier → Generator。
-
ChatGPT 结合:智能 CR / 单测 / 错误检测 / 解释 / 重构 / 加类型 / 注释 / 生成代码 / 文档。
-
LLM + tensorflow 识别手画稿生成代码:fromPixel 预测 → 特征 schema → 模板代码 AST 插入。
-
理念:让 AI 帮我们把 30% 不喜欢的事情做完(捡苹果理论)。
-
应对内卷:AI + 工程化 + shell 脚本。
-
安全风险:黑产刷数据 / 绕过验证 / 代码泄露(key token)/ 数据泄露 → 内部规范与流程 + 代码安全扫描下部分使用。
-
未来:Lowcode + 原子化开发、prompt 工程师 = 超级个体、LLMOps 持续建设、为 AI 加上眼耳手实现 0.3 人力。
3.11 季敏《下一代微服务架构的实践与探索》(阿里云,Seata 发起人)
📄 来源飞书文档:季敏《下一代微服务架构的实践与探索》(https://my.feishu.cn/wiki/FiNTw3aLhixToUkgrATcZdunnAb)
微服务架构演进(阿里电商)
-
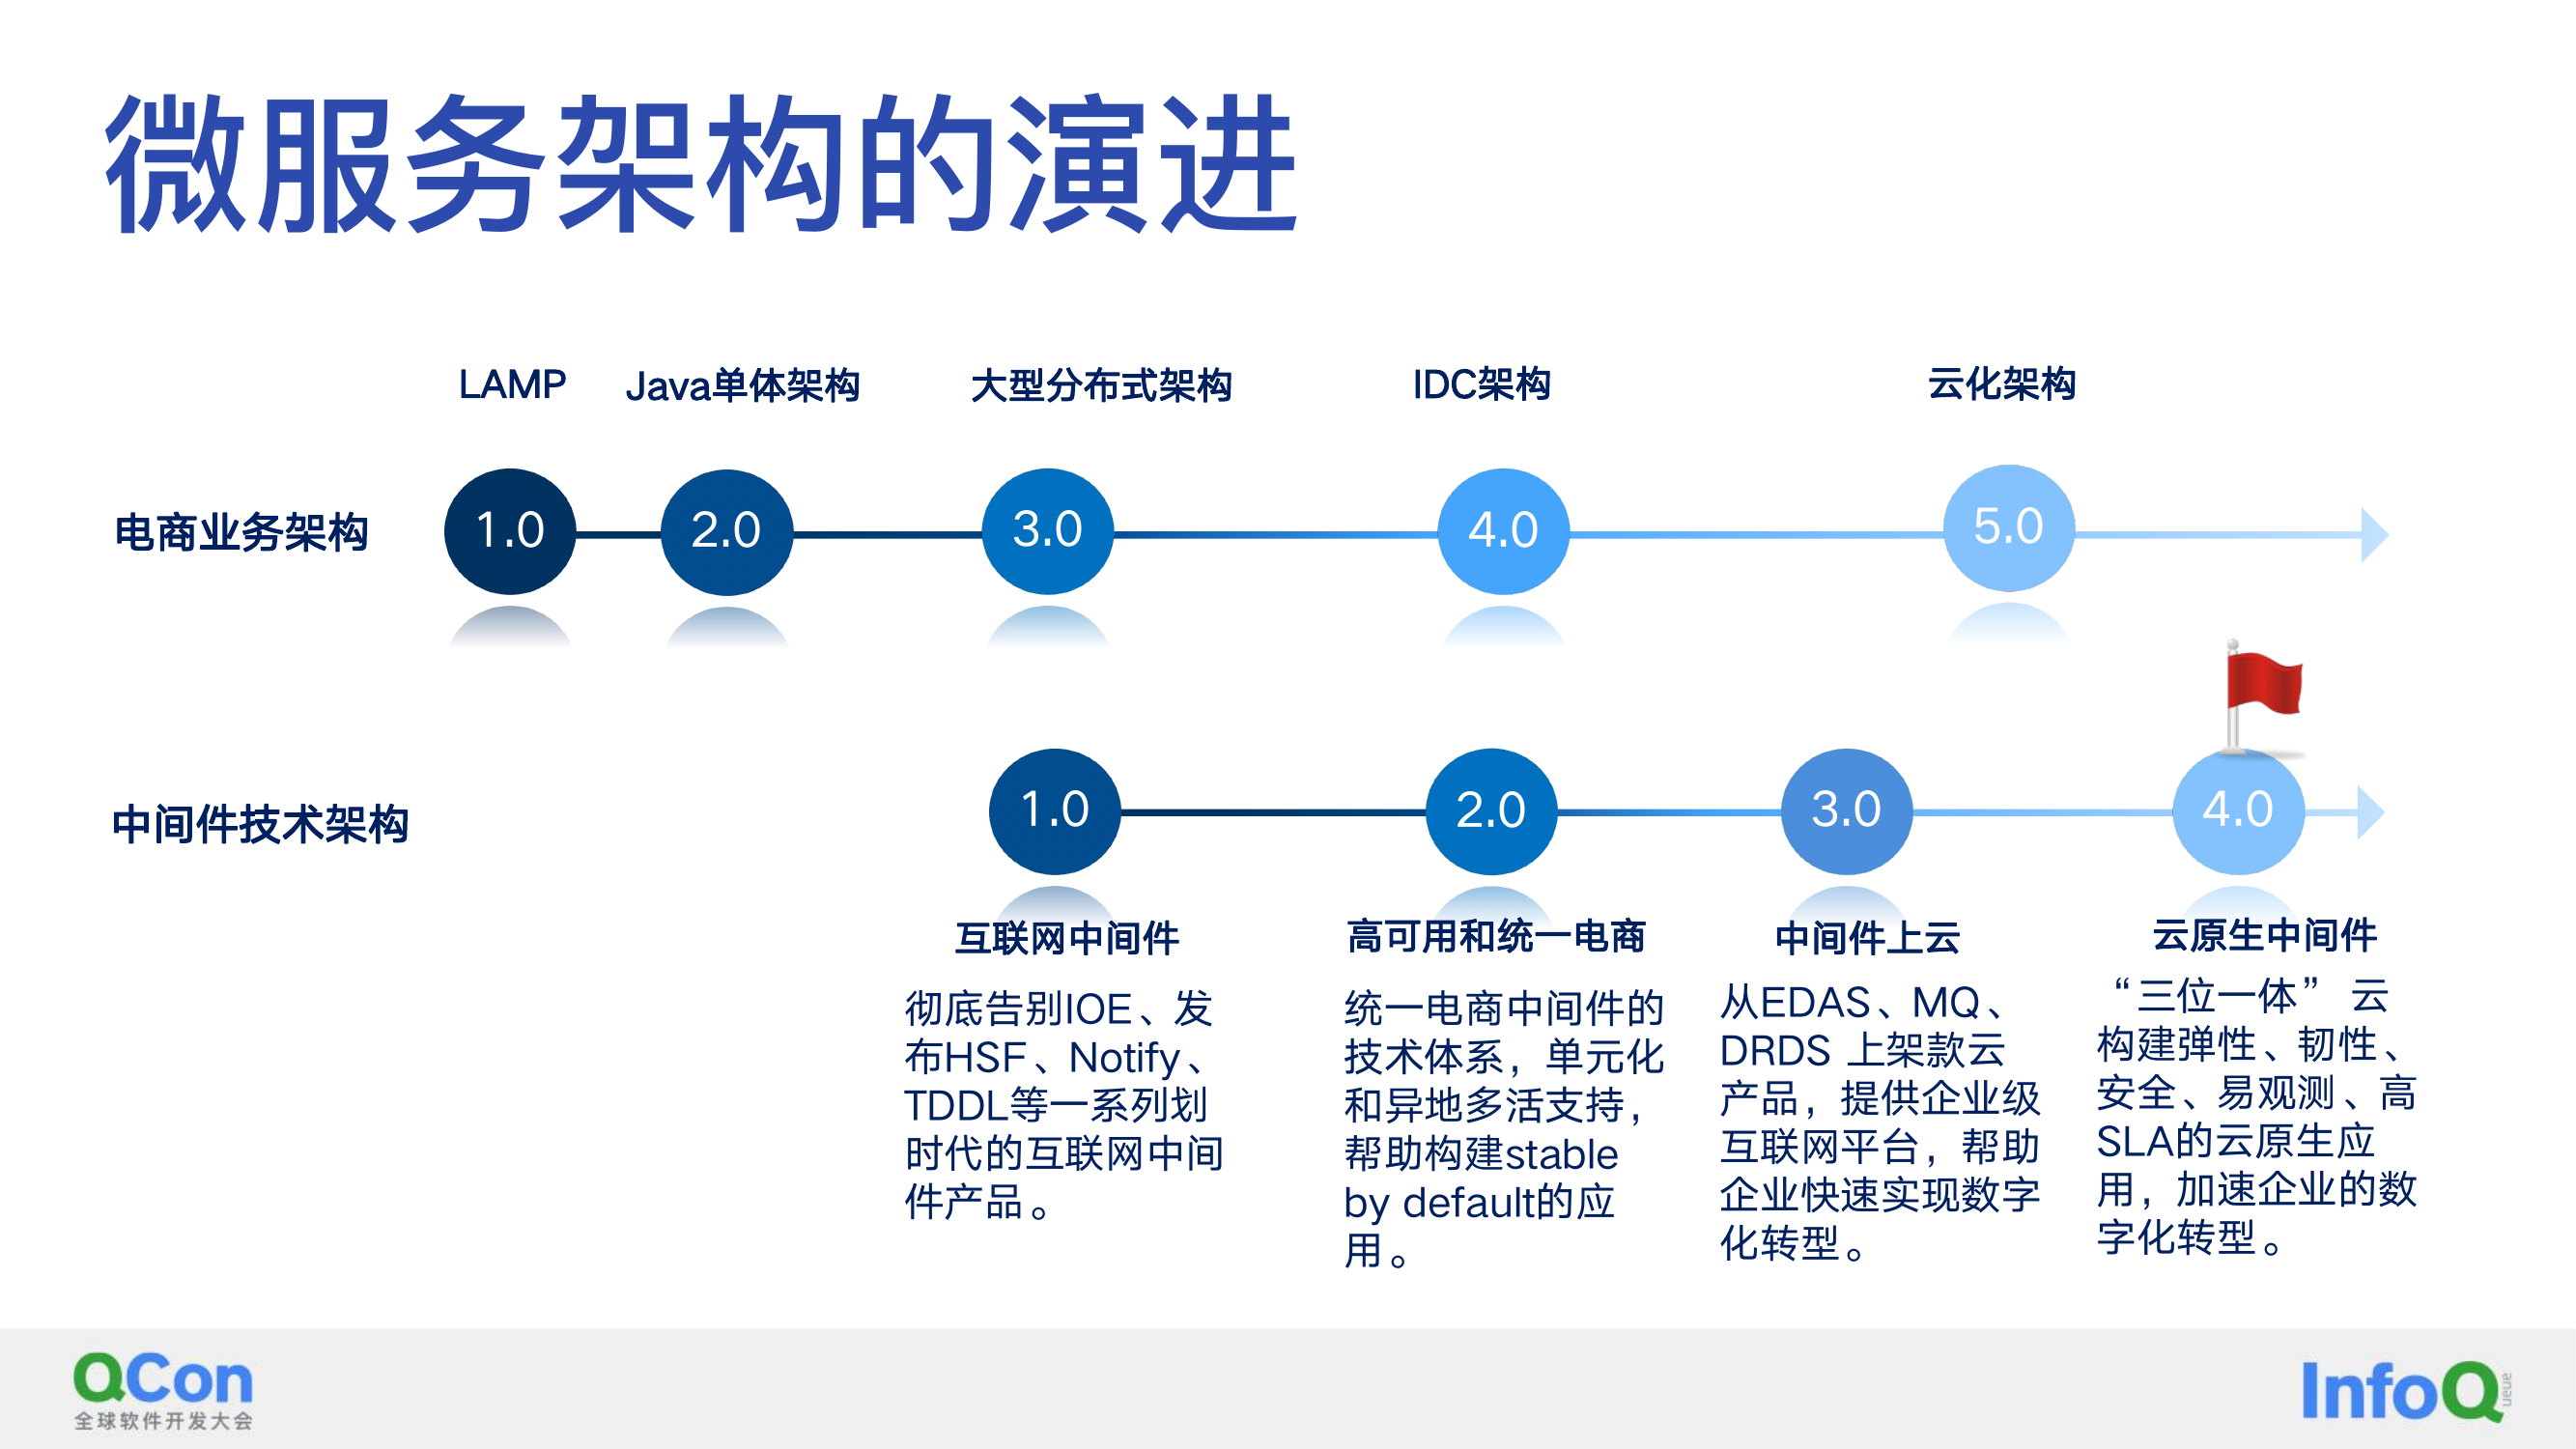
LAMP → Java 单体架构 → 大型分布式架构 → IDC 架构 → 云化架构(电商业务 1.0-5.0)。
-
中间件 1.0:告别 IOE、发布 HSF/Notify/TDDL;2.0:单元化异地多活;3.0:上云 EDAS/MQ/DRDS;4.0:云原生三位一体。
-
微服务 1.0(1w 级实例、99.9% 高可用、多级容灾、同城双活、就近访问、隔离环境)→ 微服务 2.0(10w 级实例、异地单元化双活容灾、稳定性平台:业务审计 / 强弱依赖 / 容量规划 / 全链路压测 / 弹性伸缩 / 故障演练 / 限流降级 / 线上开关)。
-
微服务 4.0 演进:K8s 管理容器调度(向上 OAM+GitOps 标准化自动化运维、向下屏蔽 IaaS)、微服务管理流量(向上单机般编程效率、向下屏蔽分布式复杂度)、Serverless 免运维。
容灾演进:从同城容灾到异地中心容灾
- 交易单元化分流(center 地域 A 75% /unsh 25%)→ 异地应用双活(第一步 100% 切到异地、第二步 0%)—— 中心容灾是阿里多活容灾最后一个硬骨头。
规模化后内核稳定性问题(千万级地址链接)
-
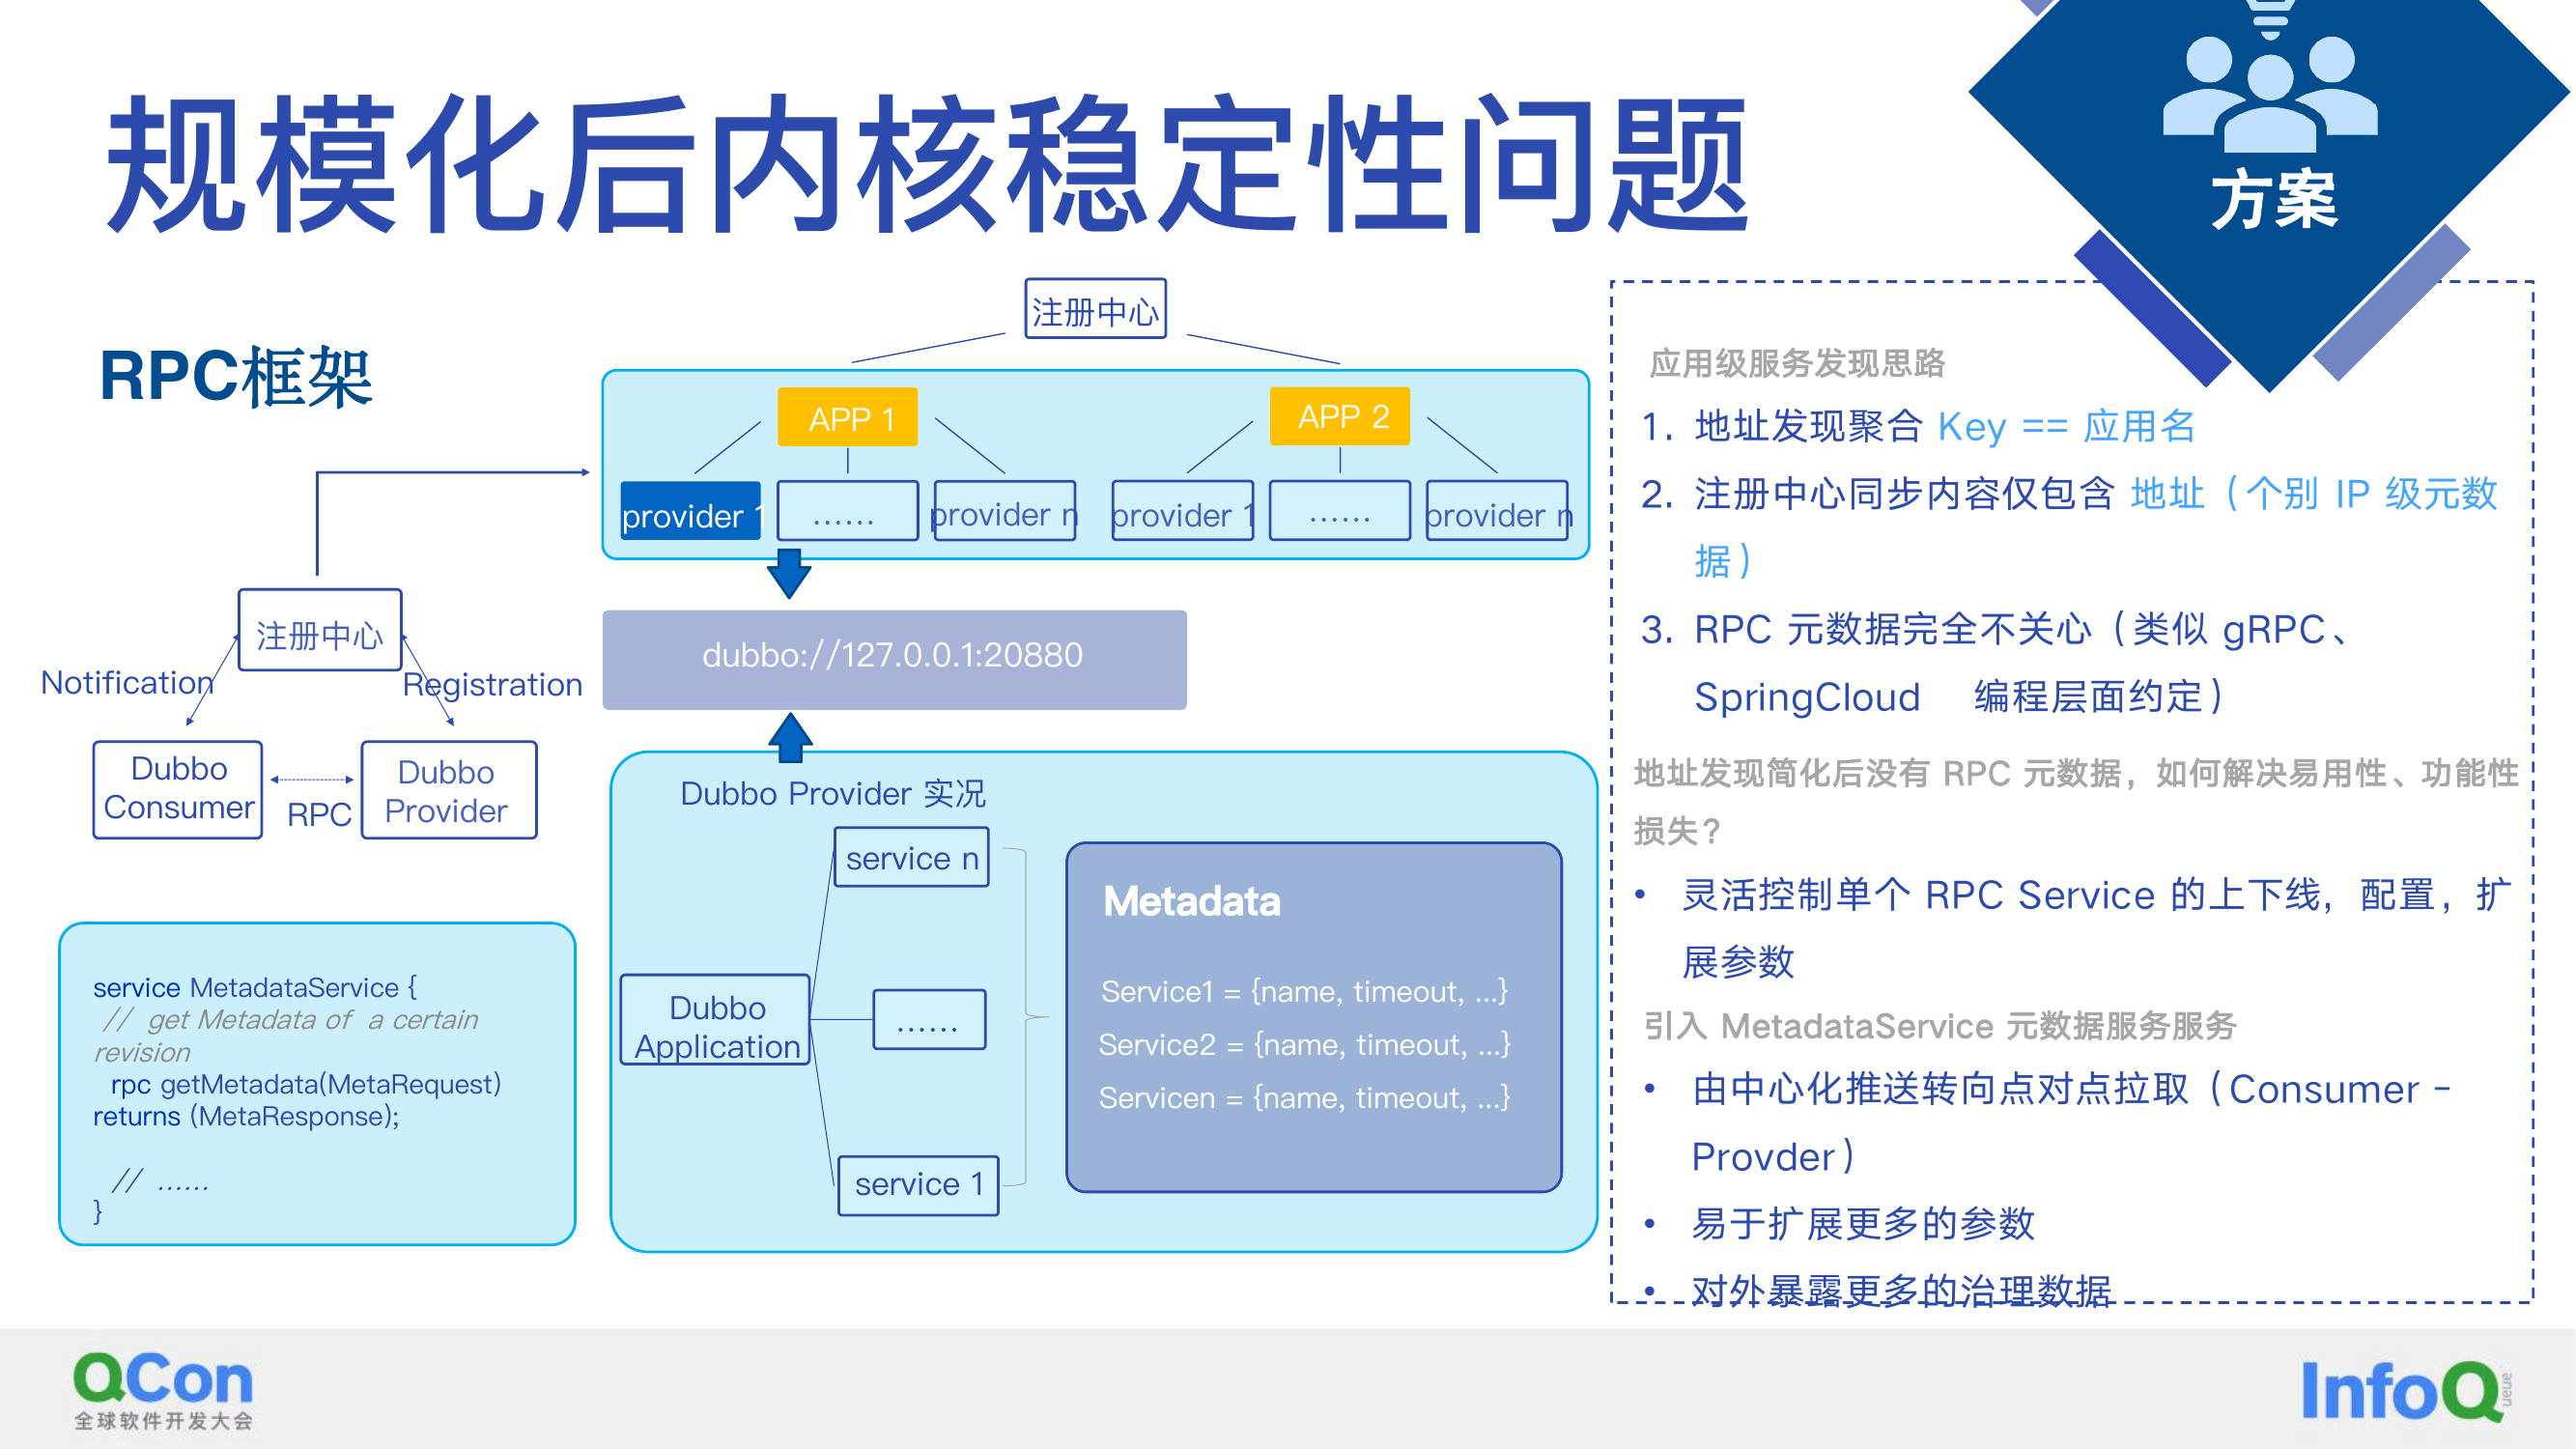
问题:ConfigServer 容量极限 / 传输量过大瞬时打满网卡 / 应用内存地址元数据占用过大。
-
方案 - 应用级服务发现:地址发现聚合 Key== 应用名;注册中心同步内容仅包含地址;RPC 元数据完全隔离(类似 gRPC/SpringCloud 编程层面约定);引入 MetadataService 元数据服务(中心化推送转点对点拉取 Consumer→Provider、易于扩展参数、对外暴露更多治理数据)。
-
落地:Dubbo3 默认双注册(接口级地址 + 应用级地址)、-Ddubbo.application.register-mode=all;交易应用常驻内存↓50%、推送↓80%、业务网关内存↓60% 推送↓95%、注册中心 key 数量↓15 倍。
-
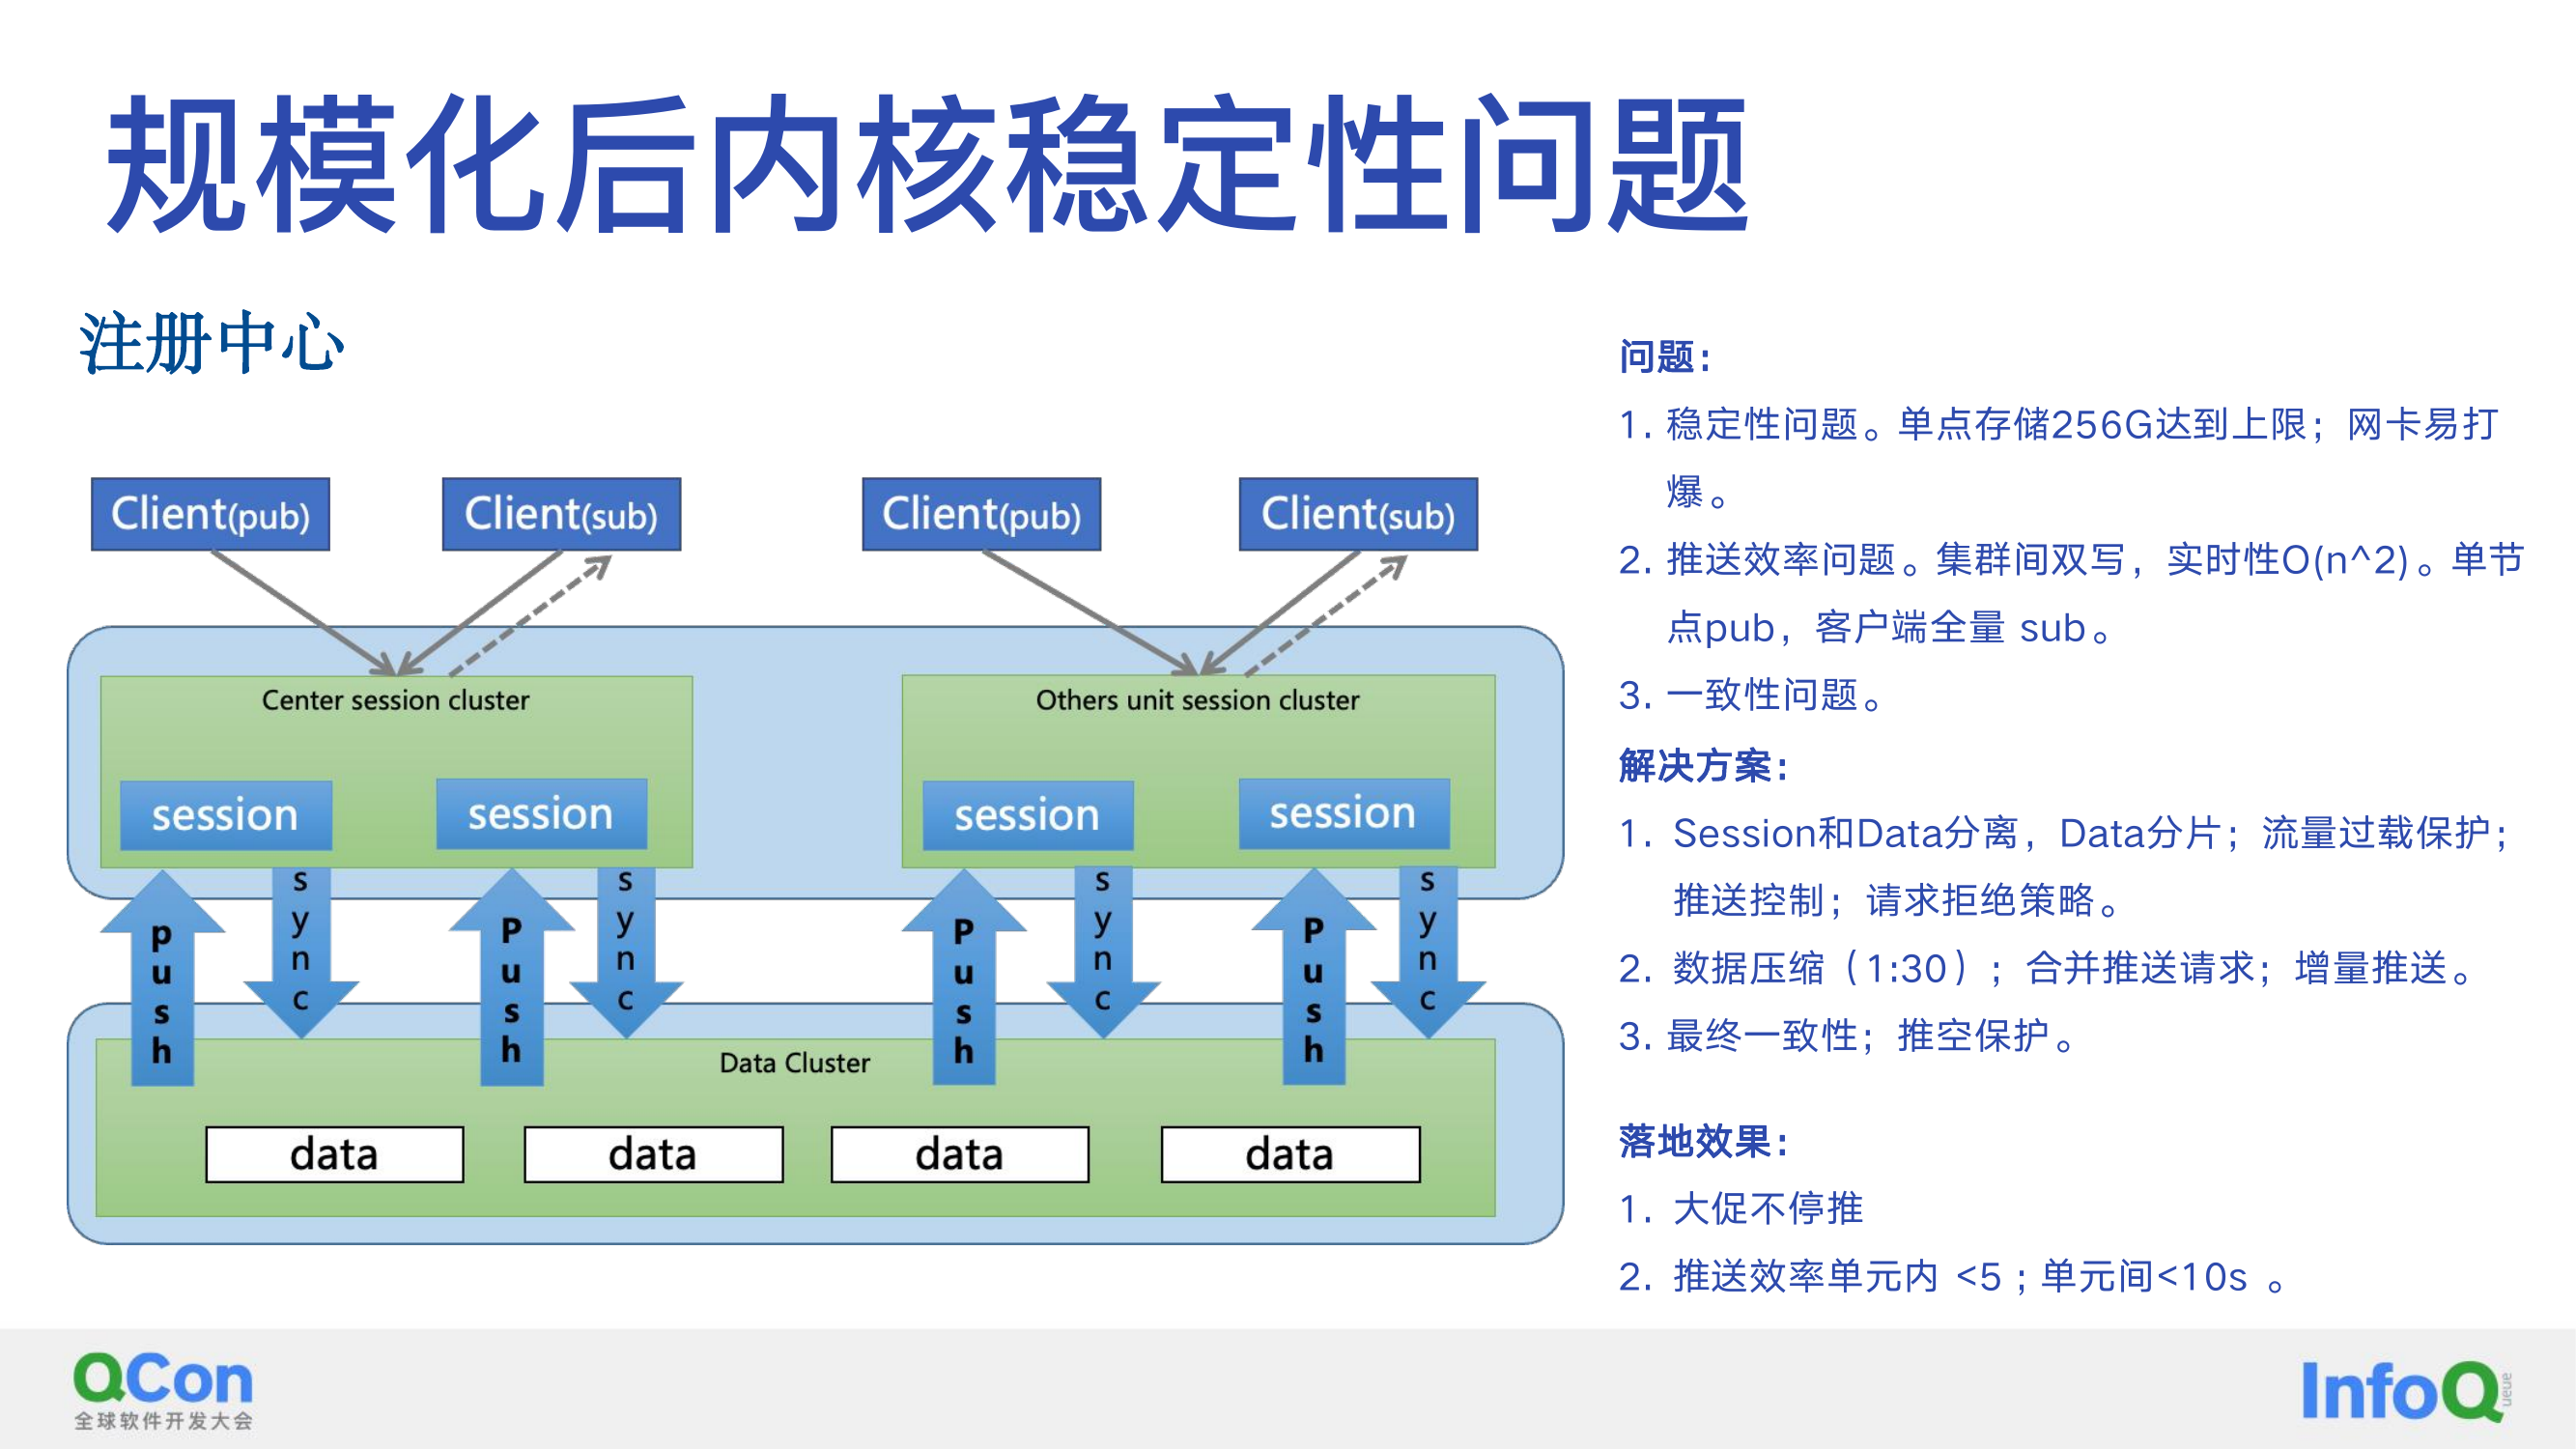
注册中心三难题:稳定性(Session/Data 分离、Data 分片、流量过载保护、推送控制)→ 推送效率(数据压缩 1:30、合并推送请求、增量推送)→ 一致性(最终一致性、推空保护);落地 = 大促不停推、单元内 <5s、单元间 <10s。
- Seata AT 事务热点数据:加锁(insert/update 锁)→ 1st update+select 减少 IO → 2nd commit on success /rollback on fail;热点 hint 处理(//+txc({\$rules})//update...);无锁化相对传统 AT 提升 10 倍。
三位一体架构:商业化(MSE/GTS)+ 开源(Dubbo/SCA/Nacos/Higress/OpenSergo/Sentinel/Seata)+ 集团内(HSF/VIPServer/Diamond/ConfigServer)+ 插件化。
下一代微服务 - 统一控制面
-
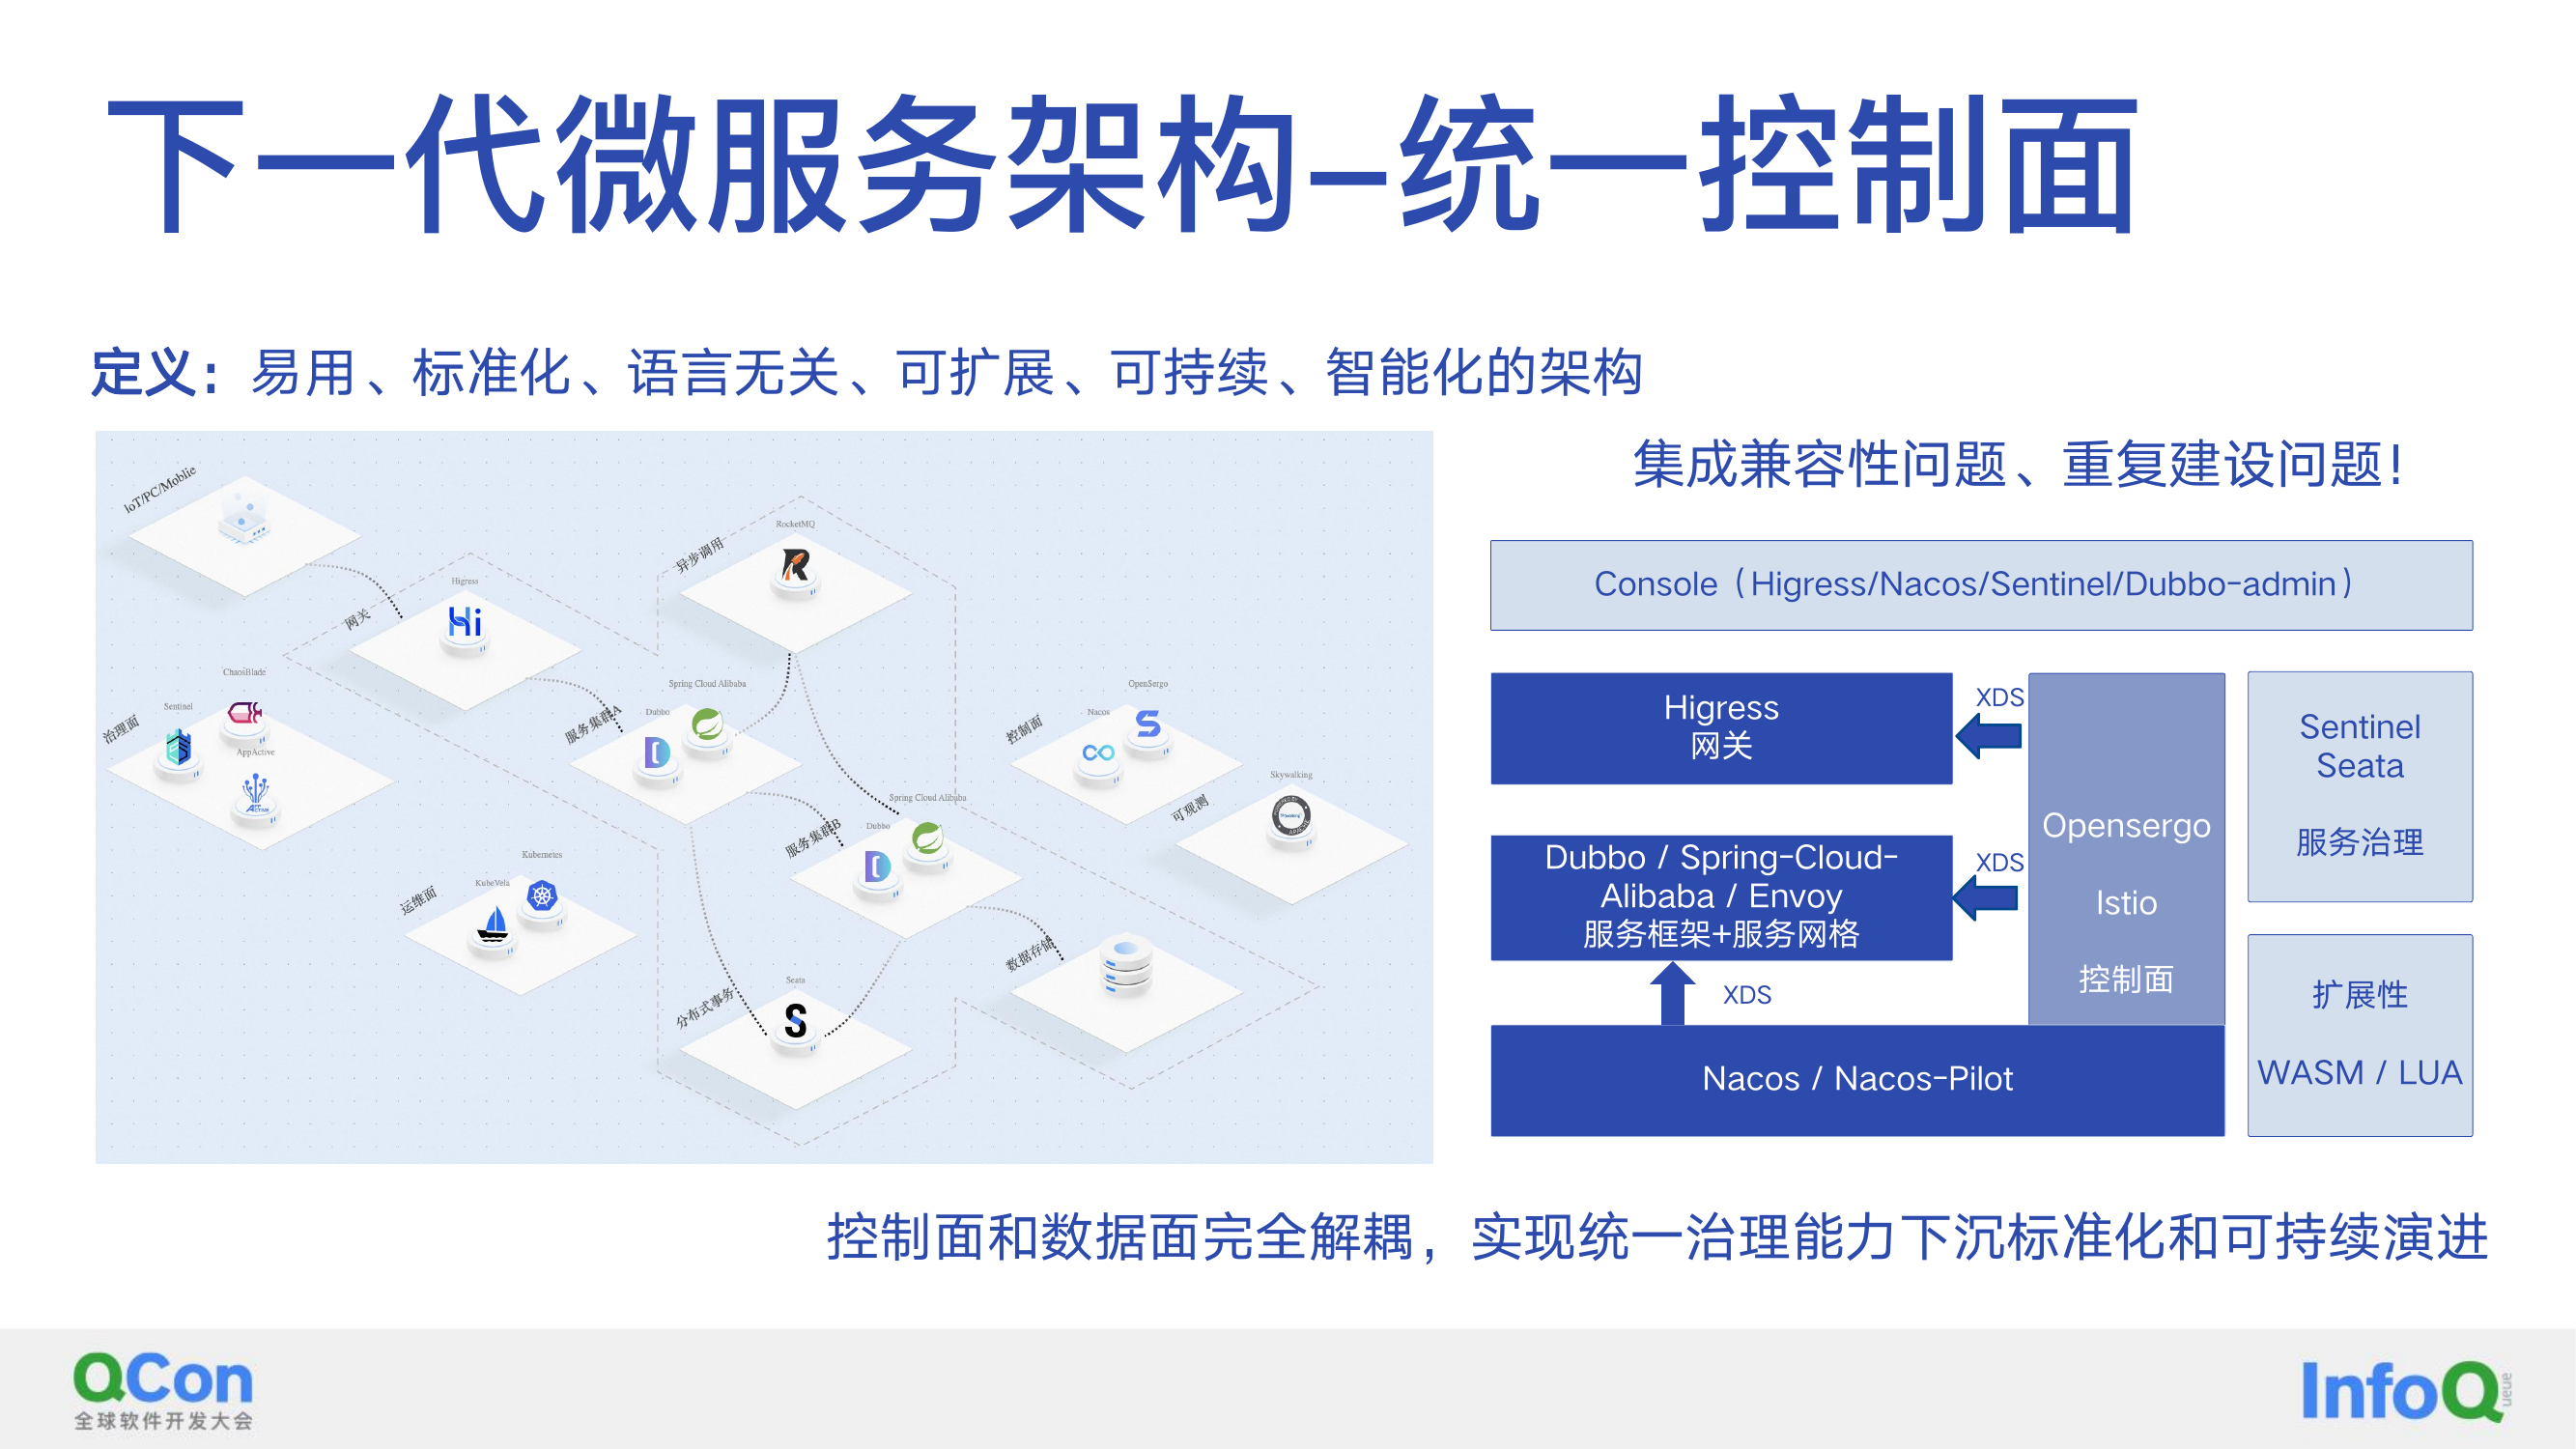
定义:易用、标准化、语言无关、可扩展、可持续、智能化;解决集成兼容性问题、重复建设问题。
-
Console(Higress/Nacos/Sentinel/Dubbo-admin)通过 XDS 下发给网关 / 服务框架 + 服务网格 / 服务治理(Istio/OpenSergo/Envoy),控制面与数据面完全解耦,统一治理能力下沉,WASM/LUA 扩展。
云原生网关:2020 阿里 "本地生活战役"(阿里域与蚂蚁域 RPC 互访,痛点 = 链路 RT 增加 100+ms 不稳定);阶段一(2020 双 11 日请求百亿级别、孵化 Dubbo 3.0 Triple 协议、东西向流量分发);阶段二(南北向 HTTP/HTTPS、Higress error page 平替 Nginx)。产品形态:网关直连业务 Pod IP 不经过传统 Cluster IP、HTTPS 支持 QPS 提升 80%、插件热加载多语言自定义插件、自研 Multi-Ingress Controller 复用同一网关实例。
智能化:开发测试态 AIGC(自然语言 → 编排 DSL、模块化代码、脚手架 Initializer、架构评估)+ 发布部署态(CloudToolkit、智能部署 / 伸缩 / 故障自愈 / 负载)+ 运行态 AIOps + 运营交付态(数字人直播、智能答疑、交互式文档)。
实践建议:不盲目跟风,选择适合业务和组织的架构;重构遵循方法论(重构面可控、小步慢跑、逐步递推);保证测试用例覆盖率(RD 信心来源);完整灰度发布方案;随时保证线上改动可降级、事故可止损;一定要有自己的监控体系;小微企业可从自研转向开源二次开发。
3.12 赵威《Android WPS 十年架构演进》(金山办公)
📄 来源飞书文档:赵威《Android WPS 十年架构演进》(https://my.feishu.cn/wiki/T2JPwv24AiGMkUkloX0czA8Nn2R#page_number=44&bbox=%5B0%2C0%2C1%2C1%5D)
Android 应用架构变化:Web → Native → Hybrid → 组件化。
演进三阶段:架构 1.0(从 0 构建)→ 架构 2.0(单进程到多进程)→ 架构 3.0(大型项目工程化)。
1.0 架构与挑战
-
移植 vs 重写:移植成本 / NDK 完成度 / 移植产物 / PC 是否适合移动。
-
移动 Office 基本要求:"天下武功,唯快不破"—— 产品试错要快(两周一个迭代、大小版本交替)、App 响应要快(首屏响应、滚动帧率)。
-
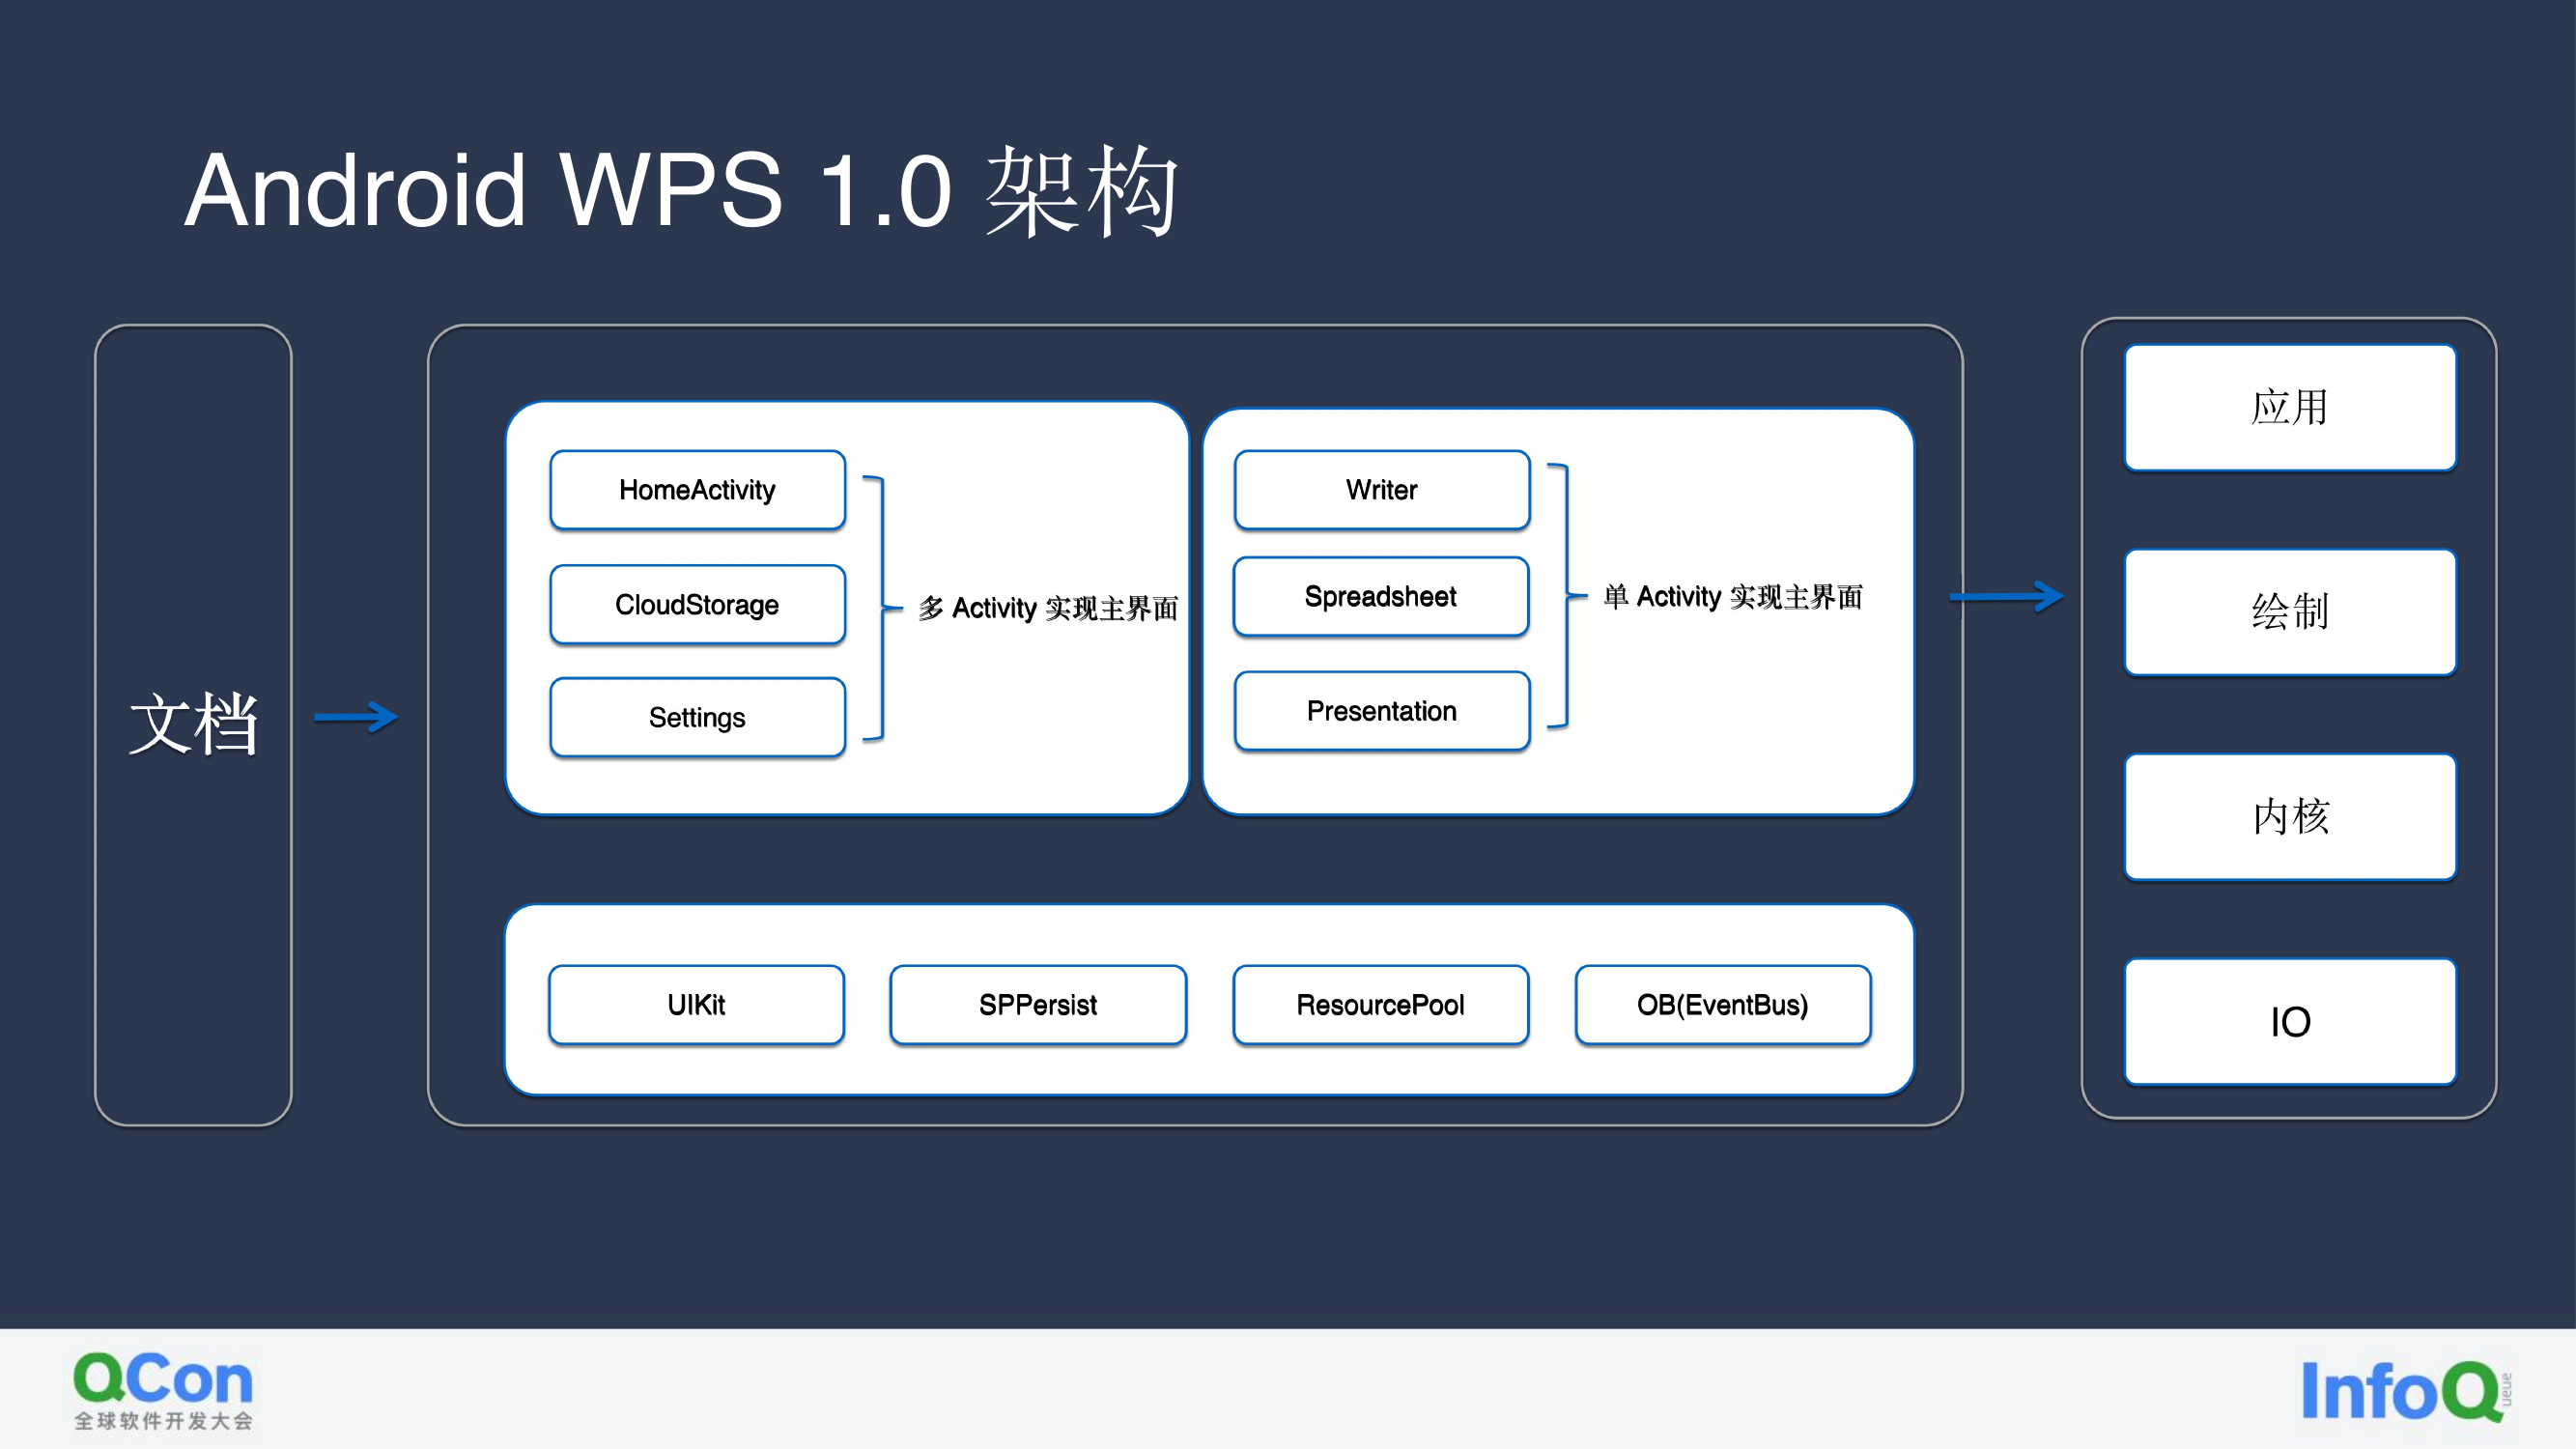
WPS 1.0 架构:多 Activity 实现主界面(HomeActivity/CloudStorage/Settings)vs 单 Activity 实现主界面(Writer/Spreadsheet/Presentation);底层 UIKit/SPPersist/ResourcePool/OB (EventBus)。
-
首屏优化:IO 策略(读写分离、分段读写、分层绘制:Sheet 信息 / 首屏单元格 / 当前 Sheet / 其他 Sheet);绘制帧率(双缓冲复用:帧 2 = 帧 1 复用区 + 帧 2 增量区,增量绘制)。
-
1.0 遗留问题:无法支持多任务(默认 Android Back Stack 栈式管理)。
2.0 多进程多任务
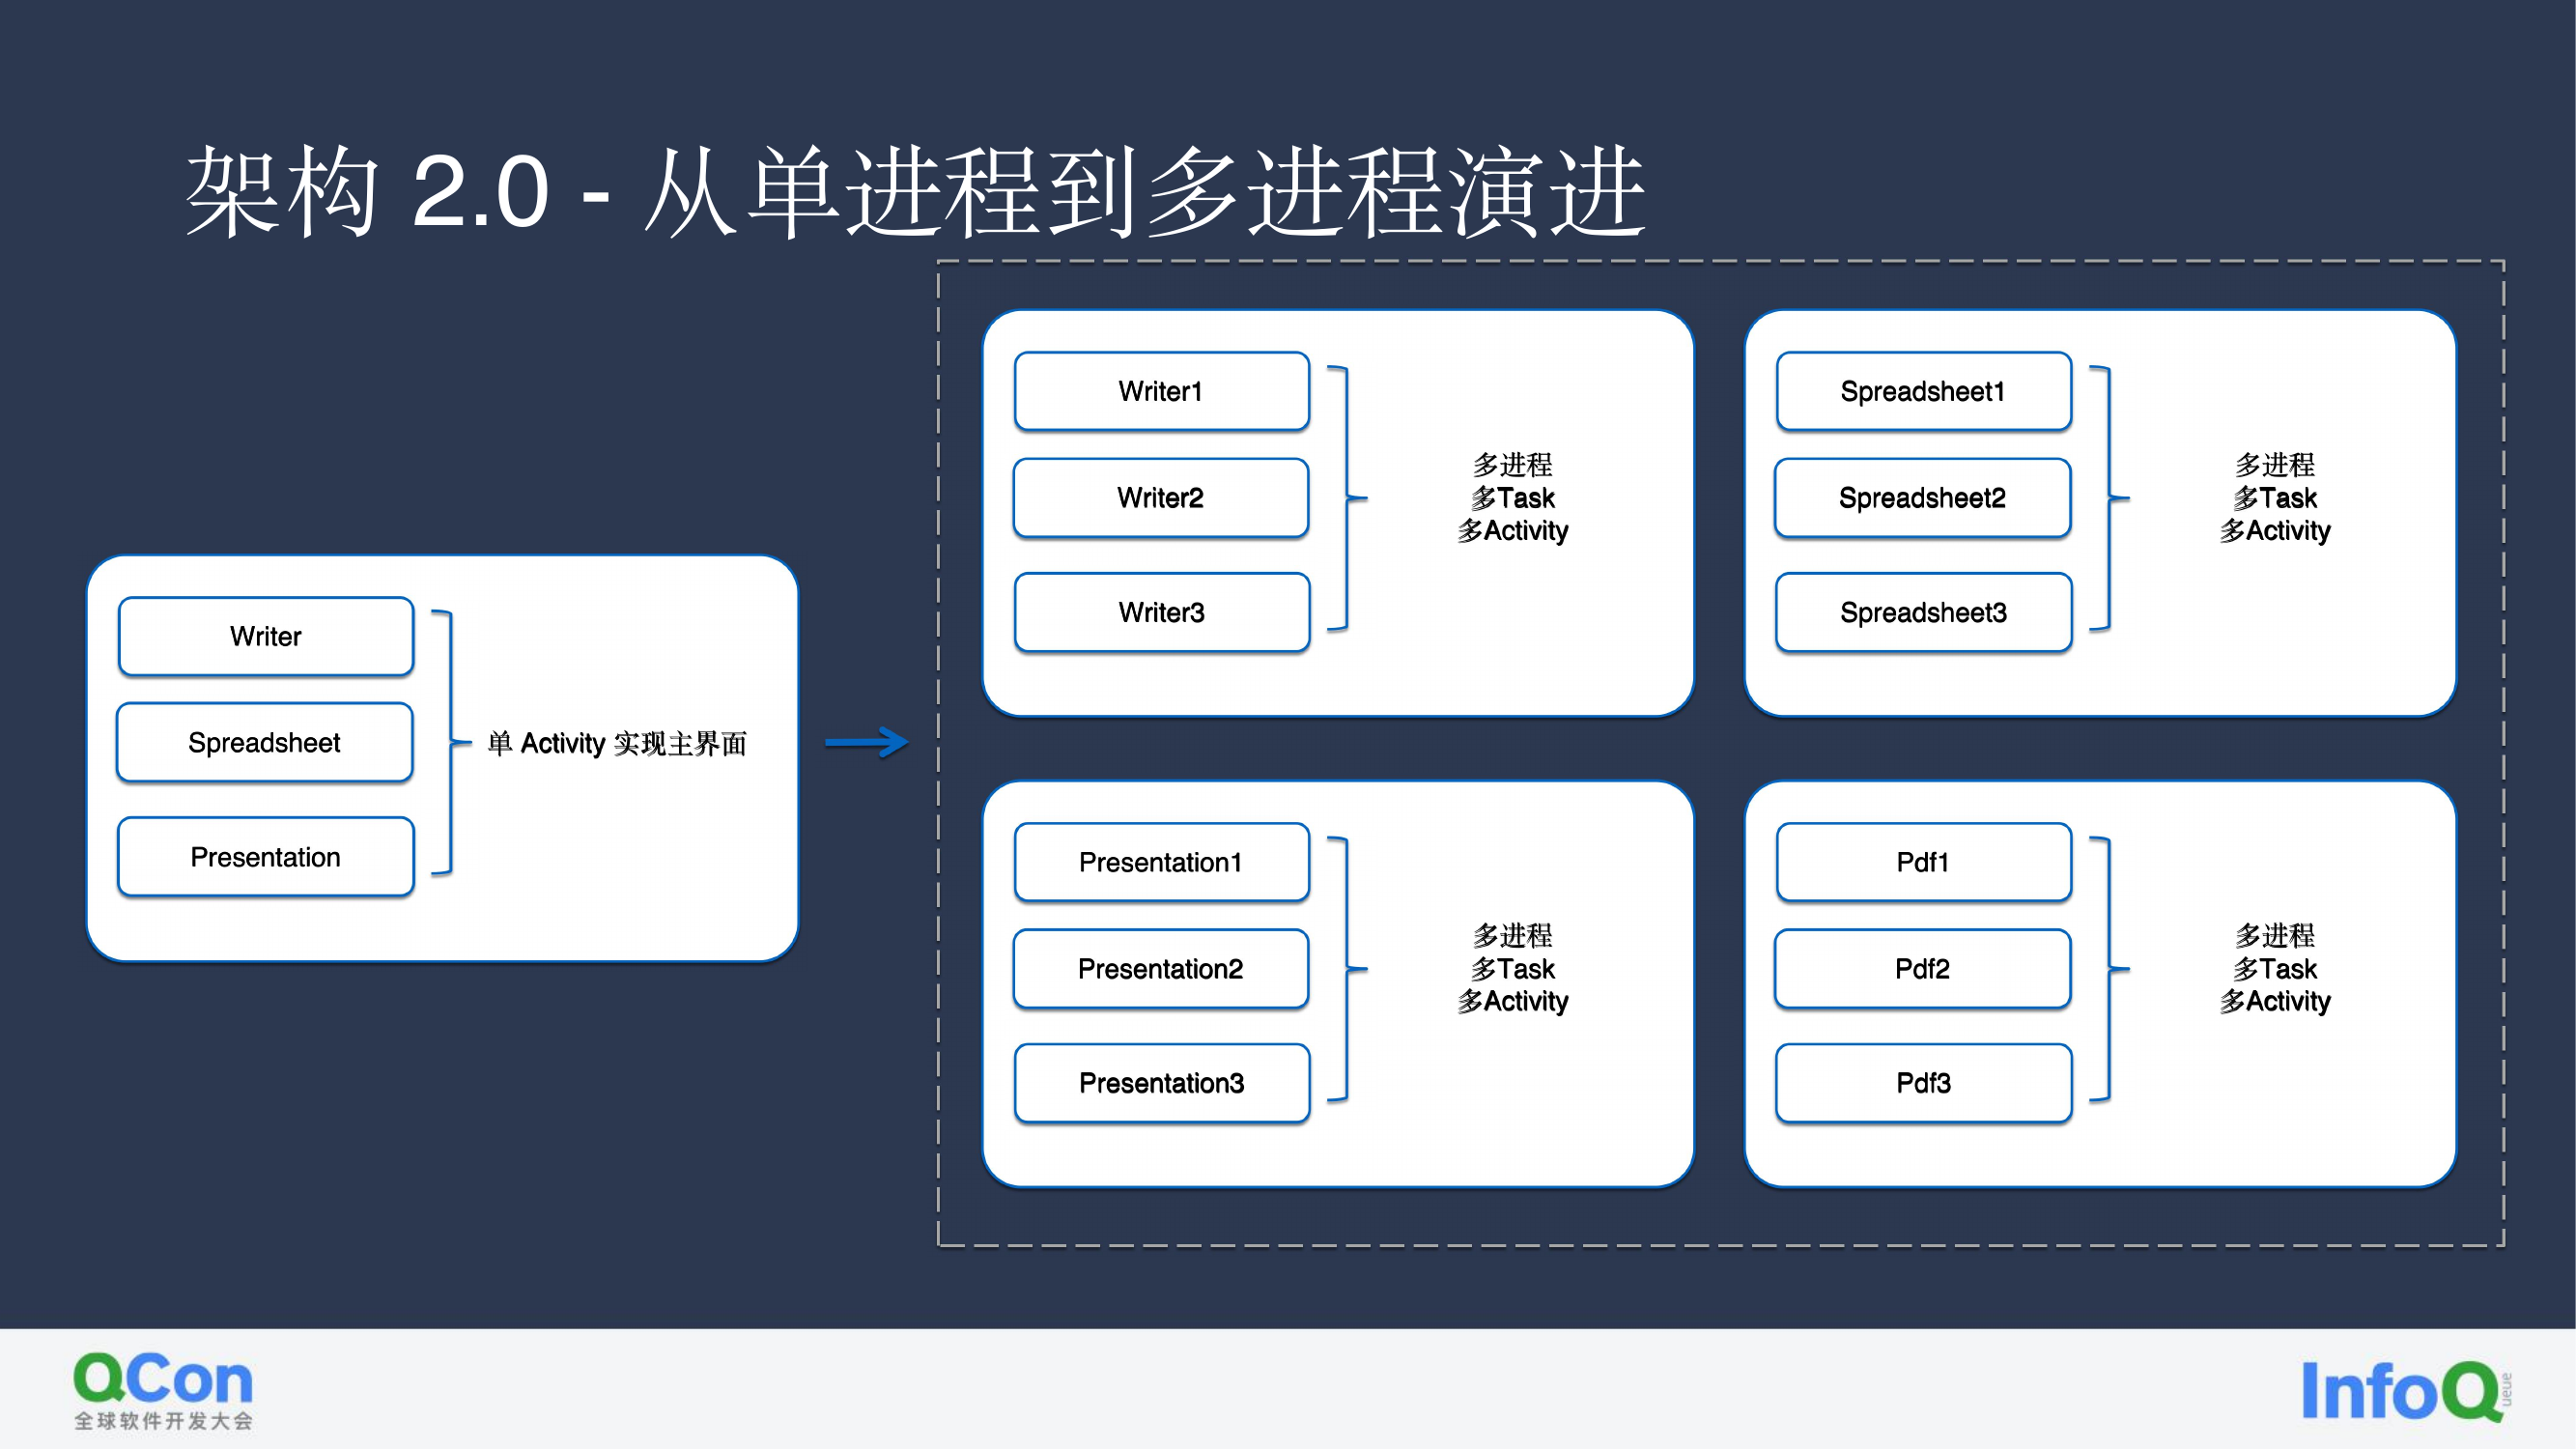
- 每个文档独立进程 + singleTask + taskAffinity(如 cn.wps.moffice.spreadsheet1),Writer/Spreadsheet/Presentation/Pdf 各自多进程多 Task 多 Activity,文档独立进程。
-
新挑战:跨进程通讯与数据一致性(中心化 IPC broadcast + 去中心化内存映射 MemoryFile);65K 方法数问题;启动性能与代码量线性相关。
-
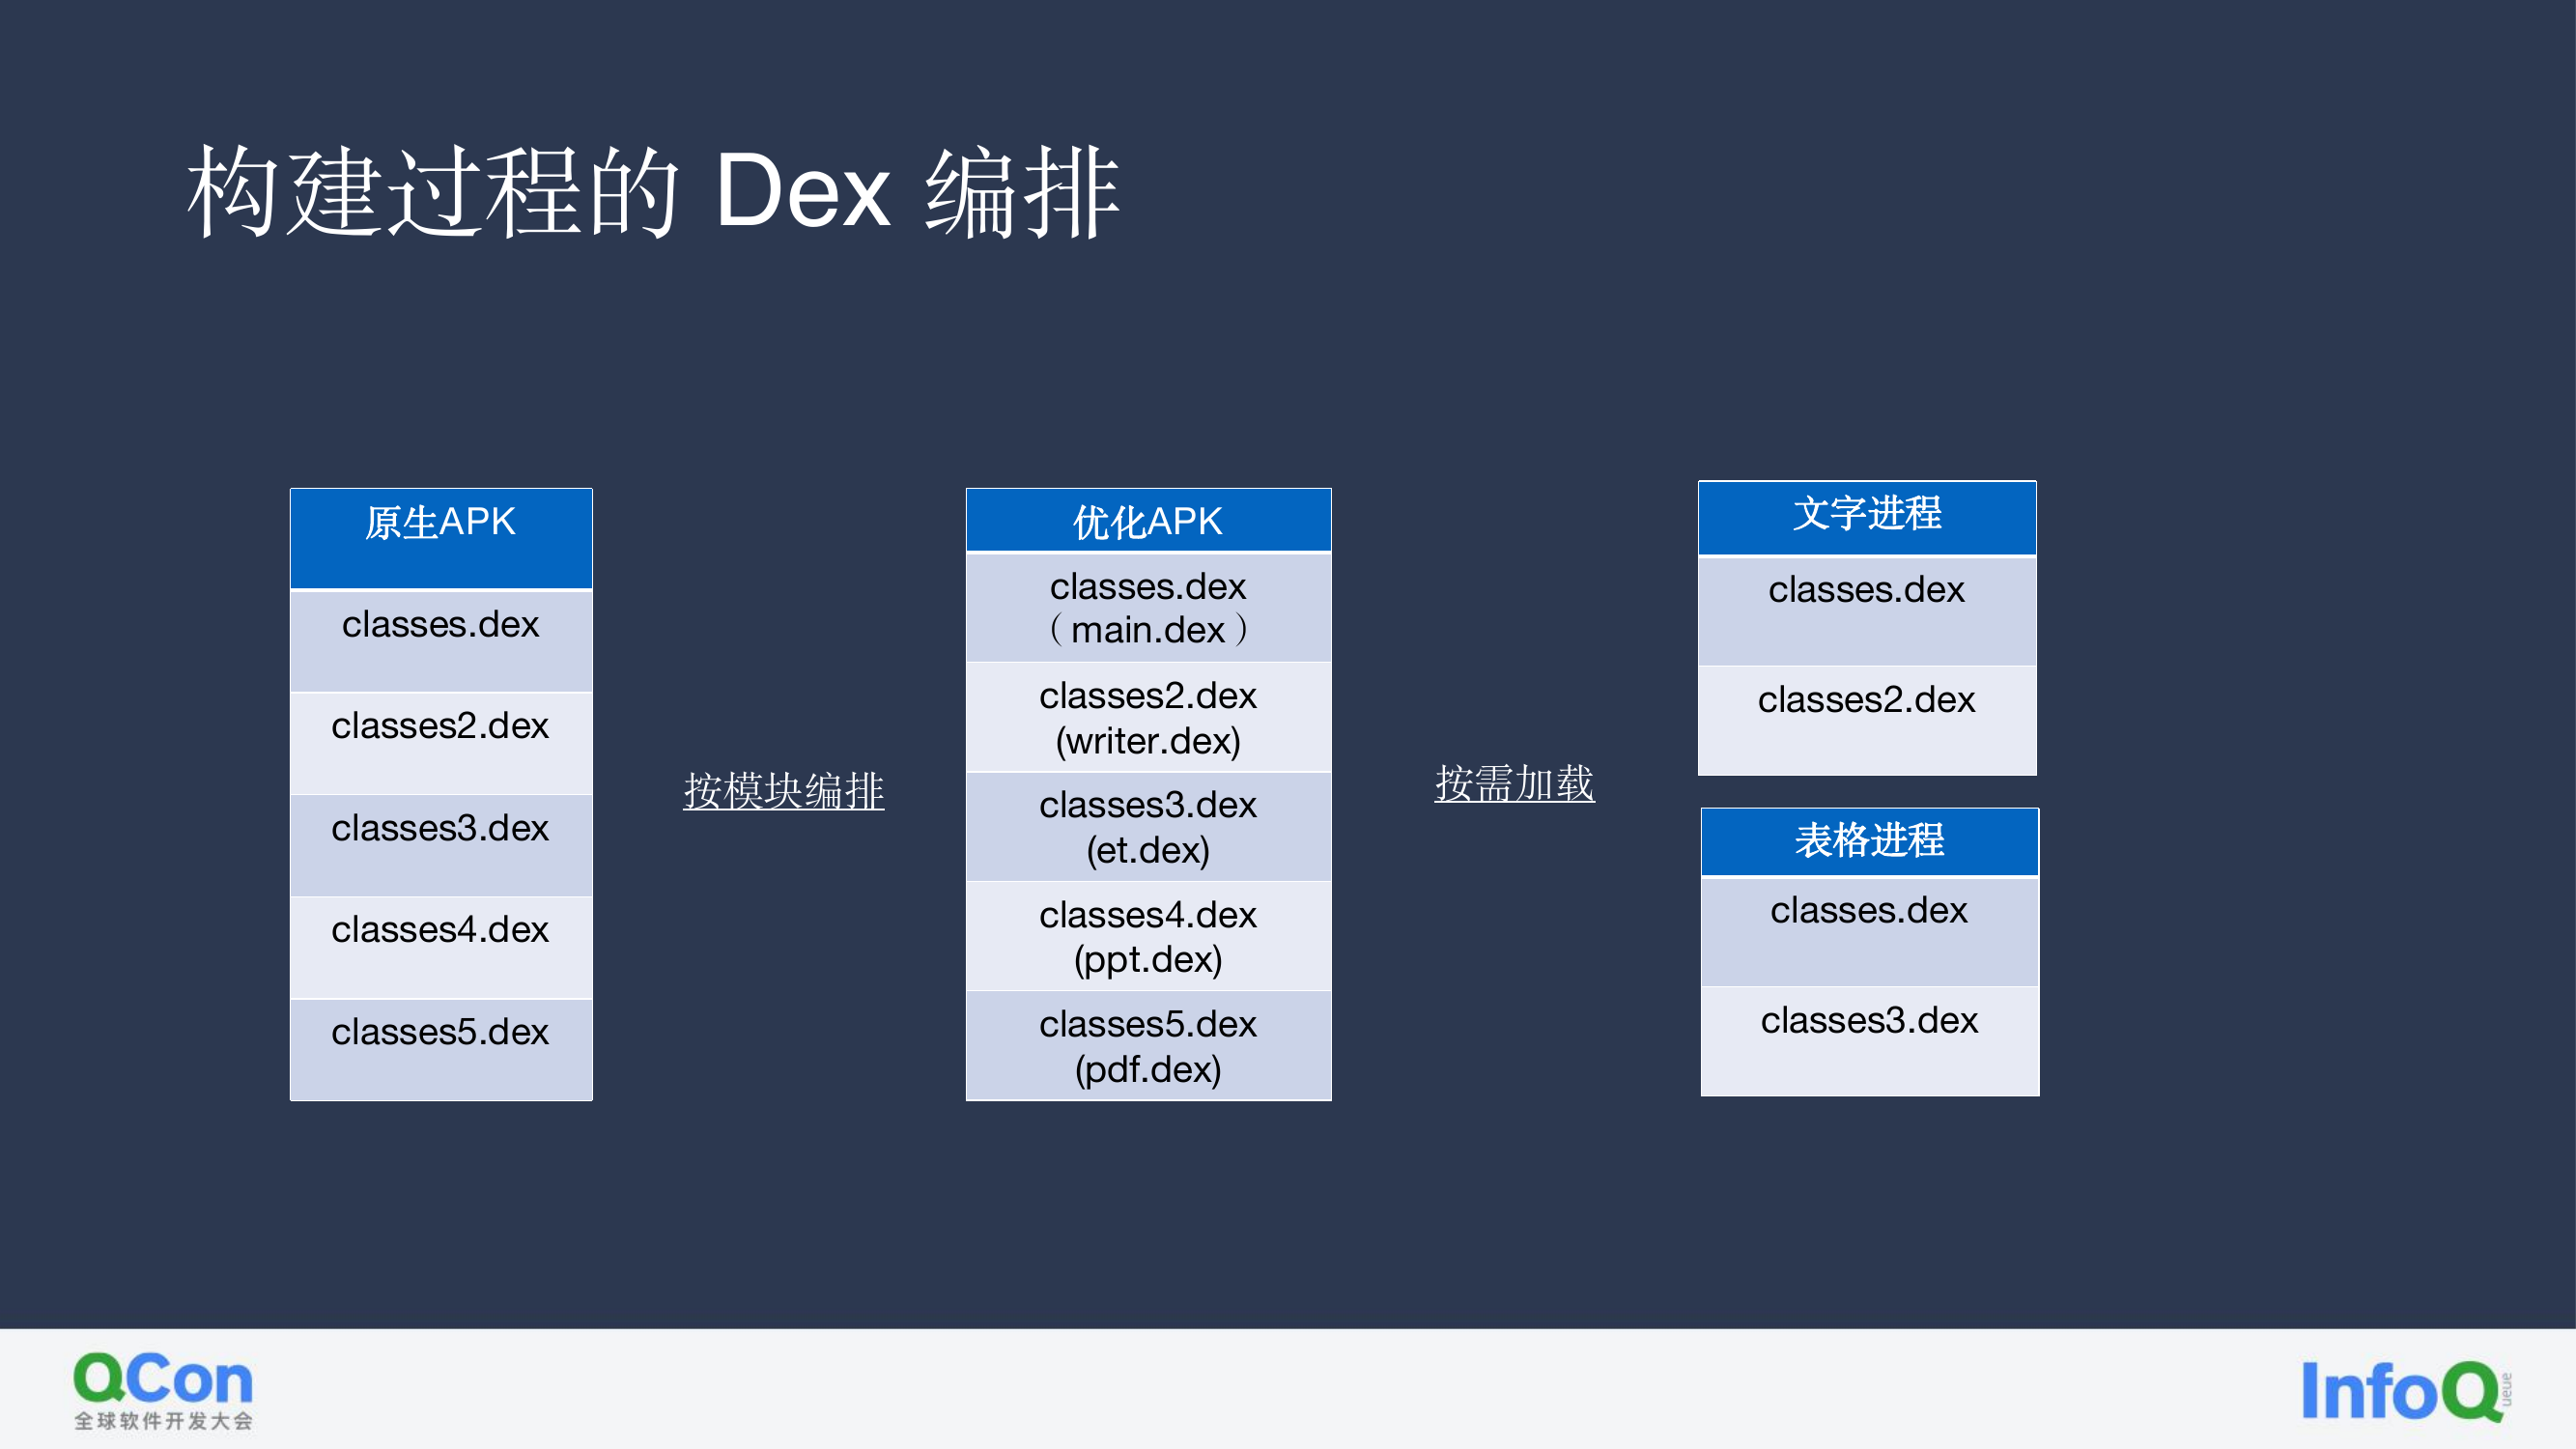
65K 问题与 Dex 编排:旧 Dex 机制报错 method ID not in [0,0xffff]:65536;官方 MultiDex 增加构建 / 启动时间且无法按需加载 → 按模块编排(main.dex/writer.dex/et.dex/ppt.dex/pdf.dex)+ 按需加载(文字进程 / 表格进程)。
3.0 大型项目工程化
-
新问题:团队迅速扩大代码质量下降、业务线增多代码大量耦合、技术栈落后交付延期;新挑战:亿级用户规模、Android 碎片化、用户反馈定位困难、线上问题无法重现。
-
改造前:基础 / 云 / 增值 / 稻壳 / 组件业务大量重复(文档列表、账号登录、本地搜索各自实现)。
-
目标架构:Dev(IDE 代码检查、入库检查、单元测试、自动化)→ 国内版 / 海外版 / 企业版 → 业务层 → 容器(Native/Web/Flutter 容器)→ 基础组件(网络库 / 远程配置 / APM / 组件化 SDK / 日志库)→ Ops(动态配置 / 动态发布 / APM 服务 / 统一网关 / Push)。
-
方法路径:组件化(公共服务共享、基础设施下沉、模块间解耦)+ 标准化(统一开发流程 / 基础服务 / 应用框架 / 用户体验)+ 动态化(动态配置 / 动态分发)。
-
基础组件下沉:网络库(多端统一接口、多维度网络监控、实时网络控制);远程配置(多维度灰度、配置回滚、变更感知);日志库(格式统一、上报策略);诊断工具(网络诊断、白屏诊断)。
-
组件化 = 依赖反转、独立运行、独立发布(UriRouter/ServiceLoader/Interfaces/EventBus,schema/call/provide interface/implementation)。
-
启动依赖治理:基于注解、线程控制、依赖回调、依赖管理。
-
标准化 - 开发流程全链路:研发(IDE 代码检查、Lint 入库门禁、commit msg 门禁、知识库)→ 测试 → 灰度(渠道 / 机型 / 用户组)→ 发布(包体积 / 性能 / 安全扫描、版本 / 插件化 / 小程序发布)→ 监控(异常日志 / OOM / 崩溃兼容)。
-
APM 质量监控体系:实时性、大数据、多维度、全平台、数据安全。
-
启动崩溃全链路容灾案例:客户端容灾(连续崩溃检查、配置回退、独立进程拉取)+ 服务端容灾(监控告警、变更回退、推送变更、配置分发 / 重制)→ 分析回退 → 恢复。
-
演进阶段:初创期(快速堆功能)→ 发展期(局部优化、组件化)→ 成熟期(拆分子系统、服务化)→ 平台期(平台化)。
-
未来思考:戒除焦虑回归本源、跳出边界系统思考。
3.13 刘一凡《快手全链路大数据安全平台建设》
📄 来源飞书文档:刘一凡《快手全链路大数据安全平台建设》(https://my.feishu.cn/wiki/Q6f7w6dw7isNmIkGOb2cB8J4njf)
背景与平台定位
-
快手数据平台:万级集群规模 / EB 级总数据量 / PB 级日净增 / 十万级日作业量。
-
安全平台定位 = 为数据全链路(数据上报 → 采集 → 同步 → 加工 → 分发 → 服务)保驾护航。
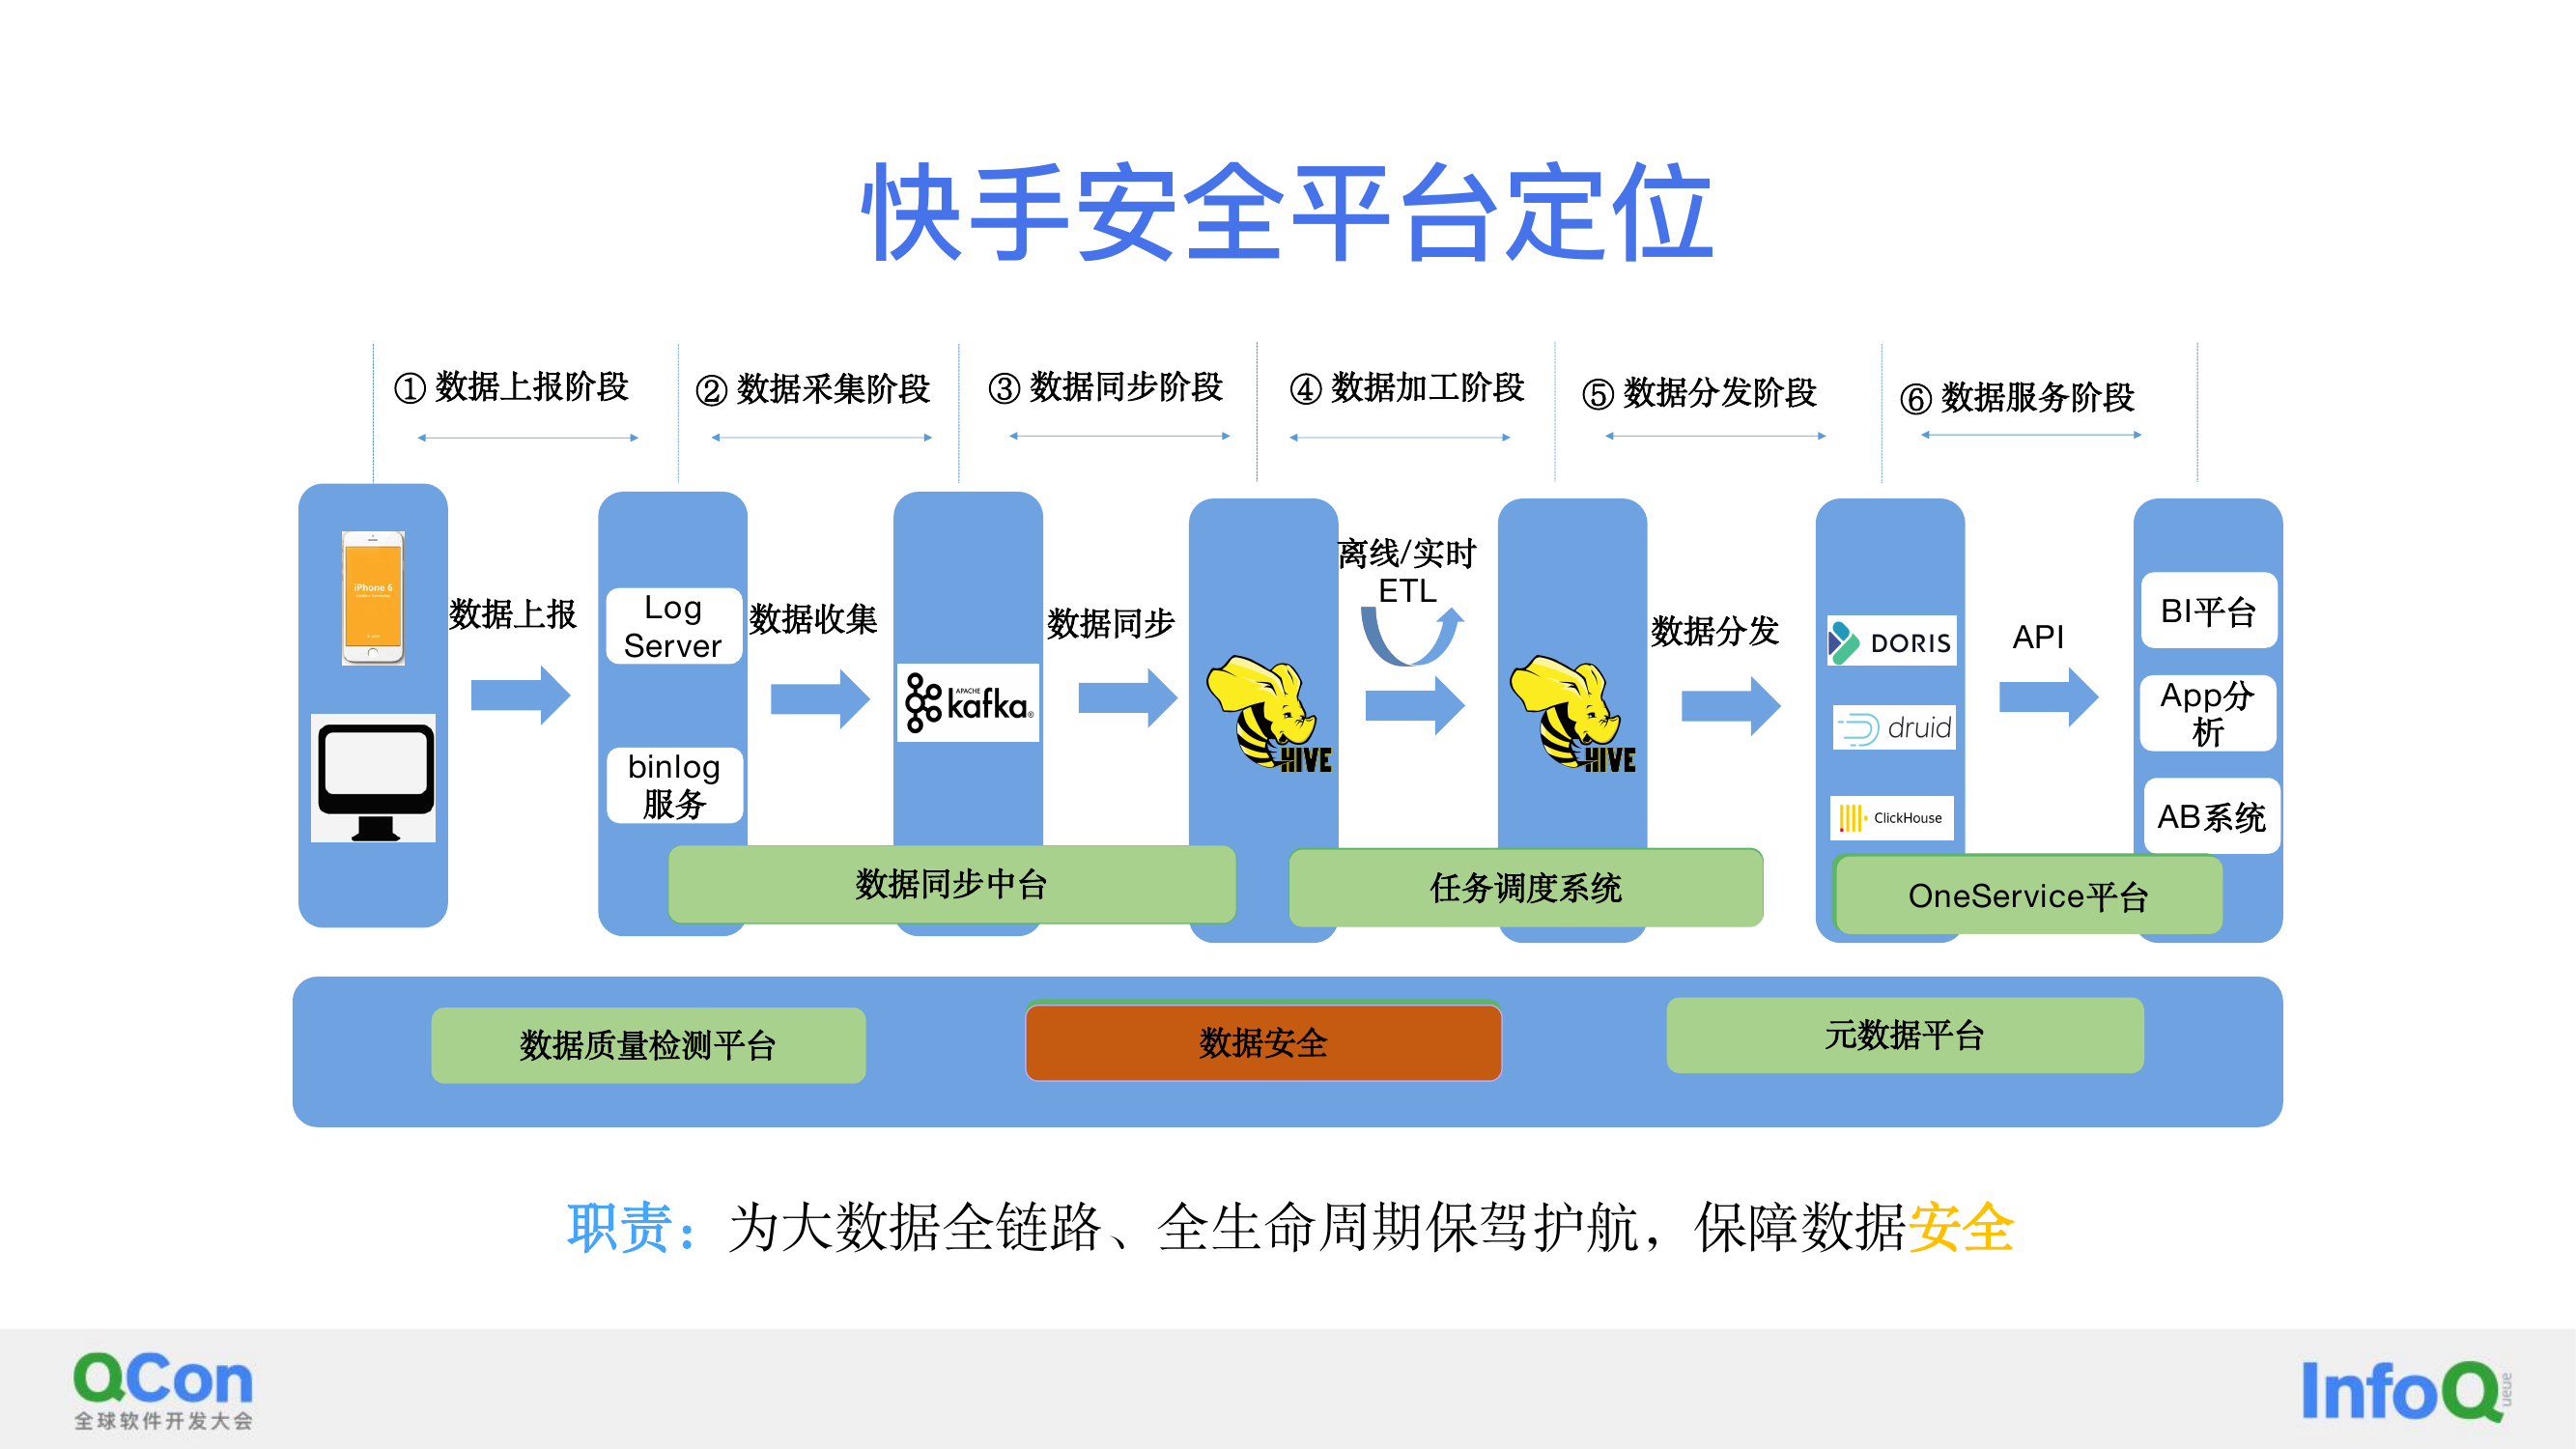
面临的问题:系统覆盖度广(底层引擎 / 开发工具平台 / 分析平台);数据精细化管控(报表 / 数据集 / 指标 / 维度 / 库 / 表 / 行 / 列 / 文件,多租户隔离);性能要求高(千级用户、百万级资源、亿级权限关系、几十毫秒鉴权延时、OLAP 每天亿级查询、HDFS 百万级 QPS);业务灵活多变。
建设思路与原则:组织 / 规范 / 工具 / 治理;保证安全兼顾效率、职责明确、最小权限、权限不转移、数据授权、分类分级、合规。
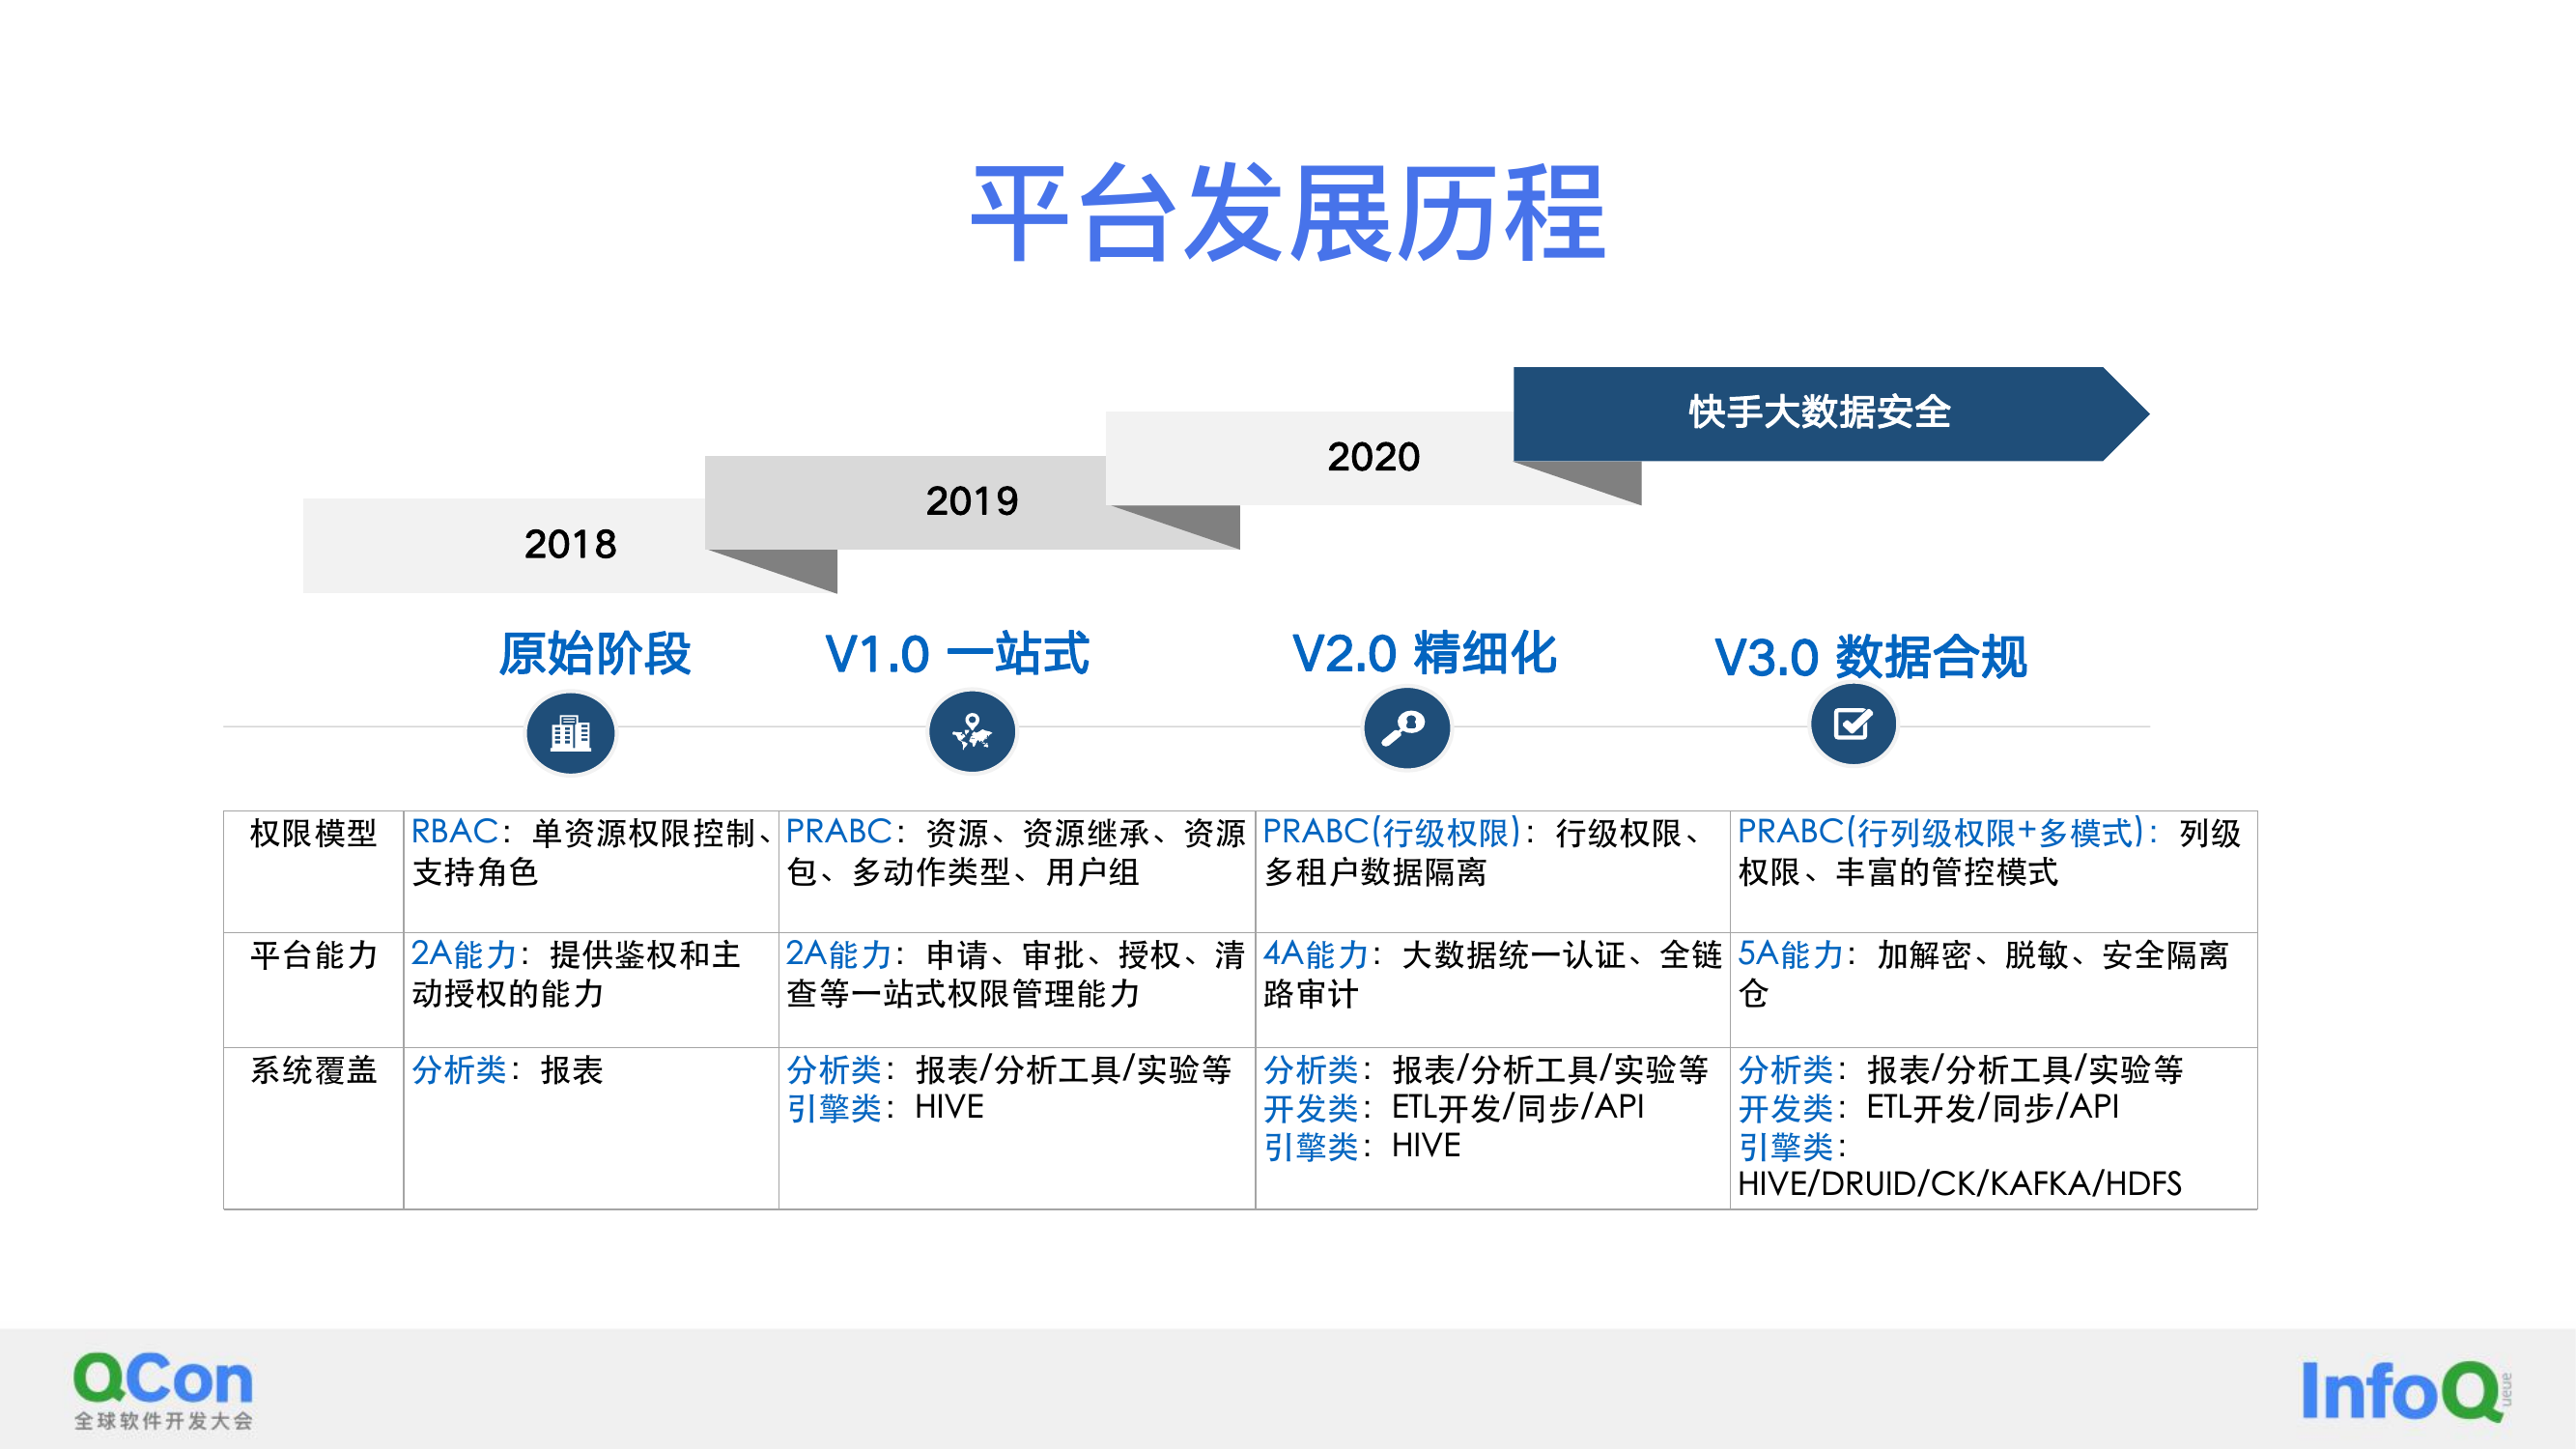
平台发展历程(能力演进)
-
2018 原始阶段:RBAC(单资源权限控制、支持角色)+ 2A(鉴权、主动授权)。
-
V1.0 一站式:PRABC(资源 / 资源继承 / 资源包 / 多动作类型 / 用户组)+ 2A(申请 / 审批 / 授权 / 查询)+ HIVE。
-
V2.0 精细化:PRABC 行级权限 + 多租户数据隔离 + 4A(统一认证 / 全链路审计)+ 开发类 ETL / 同步 / API。
-
V3.0 数据合规:PRABC 行列级权限 + 多模式 + 5A(加解密 / 脱敏 / 安全隔离仓)+ HIVE/DRUID/CK/KAFKA/HDFS。
平台 3.0 解决方案:全域(分析类系统 / 生产类系统 / 大数据计算存储引擎)+ 全能力(5A 安全能力)+ 全周期(事前:数据识别 / 加密脱敏 / 权限管理 / 合规检查;事中:风险发现 / 实时告警 / 事件响应 / 权限回收;事后:访问审计 / 下载审计 / 安全态势 / 风险报告)。
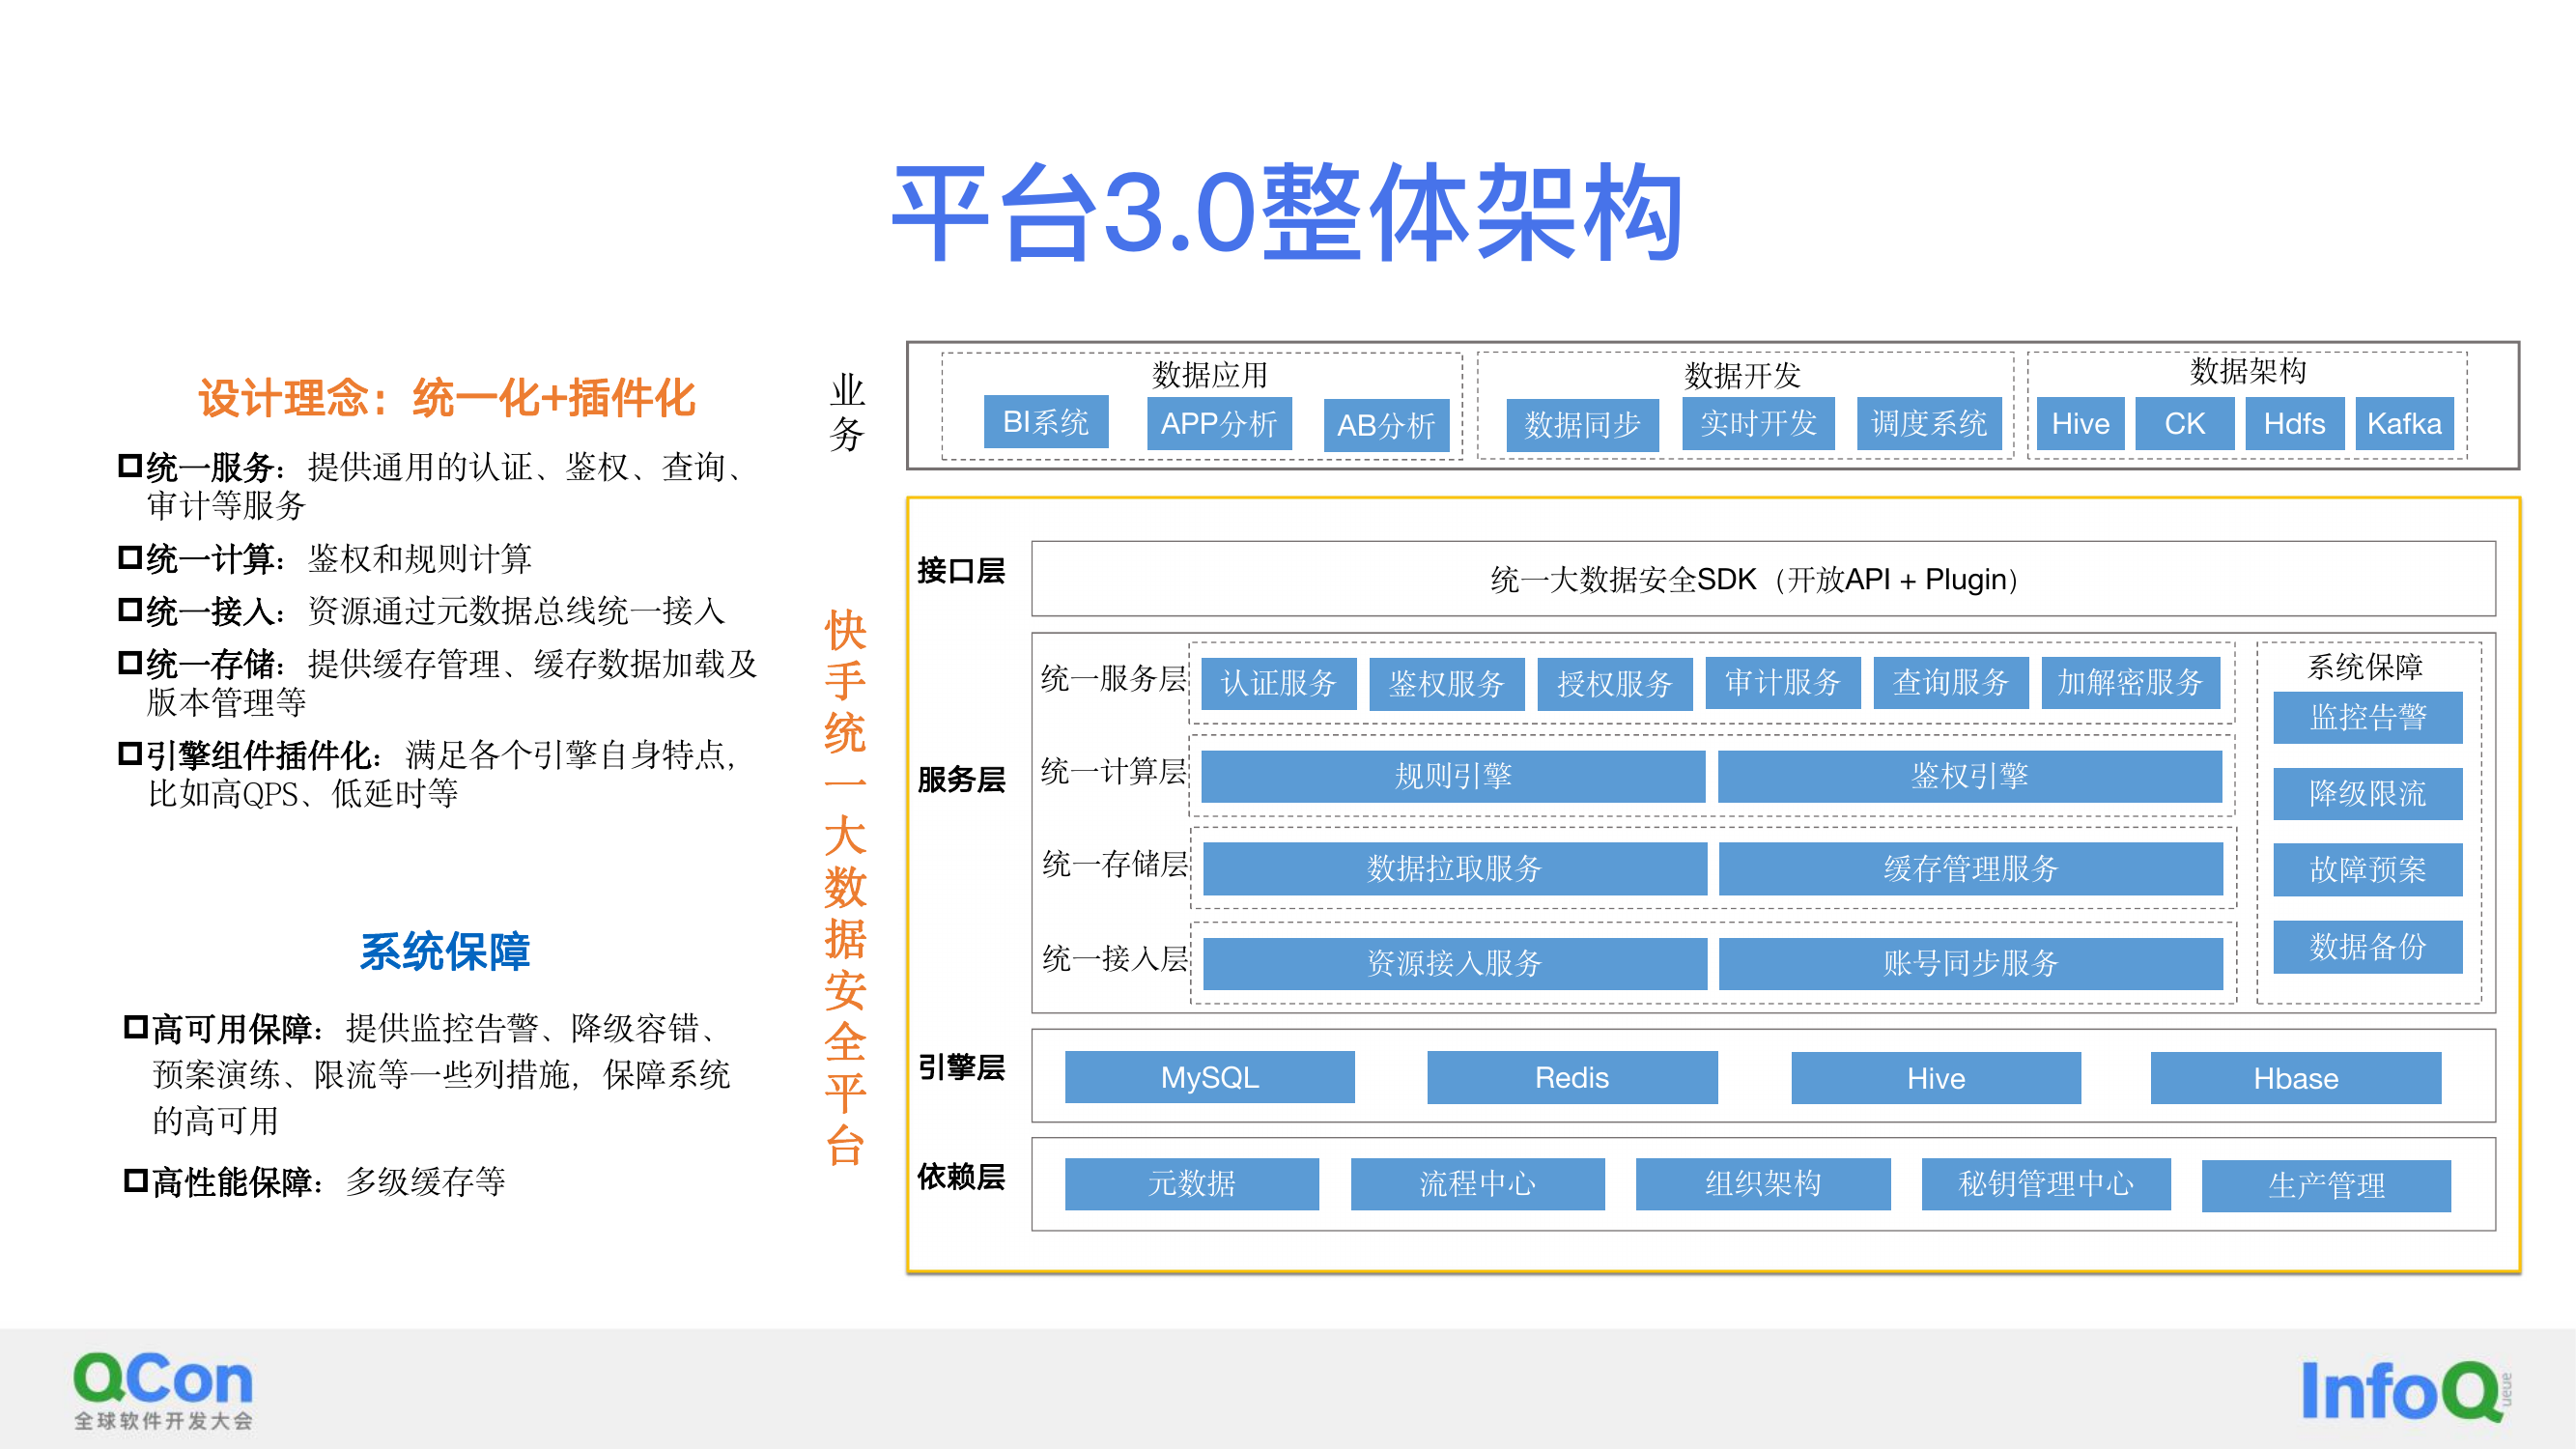
整体架构设计理念:统一化 + 插件化(统一服务 / 统一计算 / 统一接入 / 统一存储 / 引擎组件插件化);接口层(统一大数据安全 SDK:开放 API+Plugin)→ 统一服务层(认证 / 鉴权 / 授权 / 审计 / 查询 / 加解密)→ 统一计算层(规则引擎 / 鉴权引擎)→ 统一存储层 → 统一接入层 → 引擎层(MySQL/Redis/Hive/Hbase);系统保障(监控告警 / 降级限流 / 故障预案 / 数据备份)。
关键技术
-
认证体系:轻量级(入侵最小、性能稳定、可解释)/ 本地化(结合生产组织管理)/ 易衍化;账号类型 = 个人 / 项目组 / 代理账号(principal_name/type@realm);令牌 = AccessToken/DelegateToken/DegradeToken;类似 Kerberos 的 DSC KDC(AS/TGS、AS_REQ/AS_REP/TGS_REQ/TGS_REP/VERIFY TOKEN/ACCESS)。
-
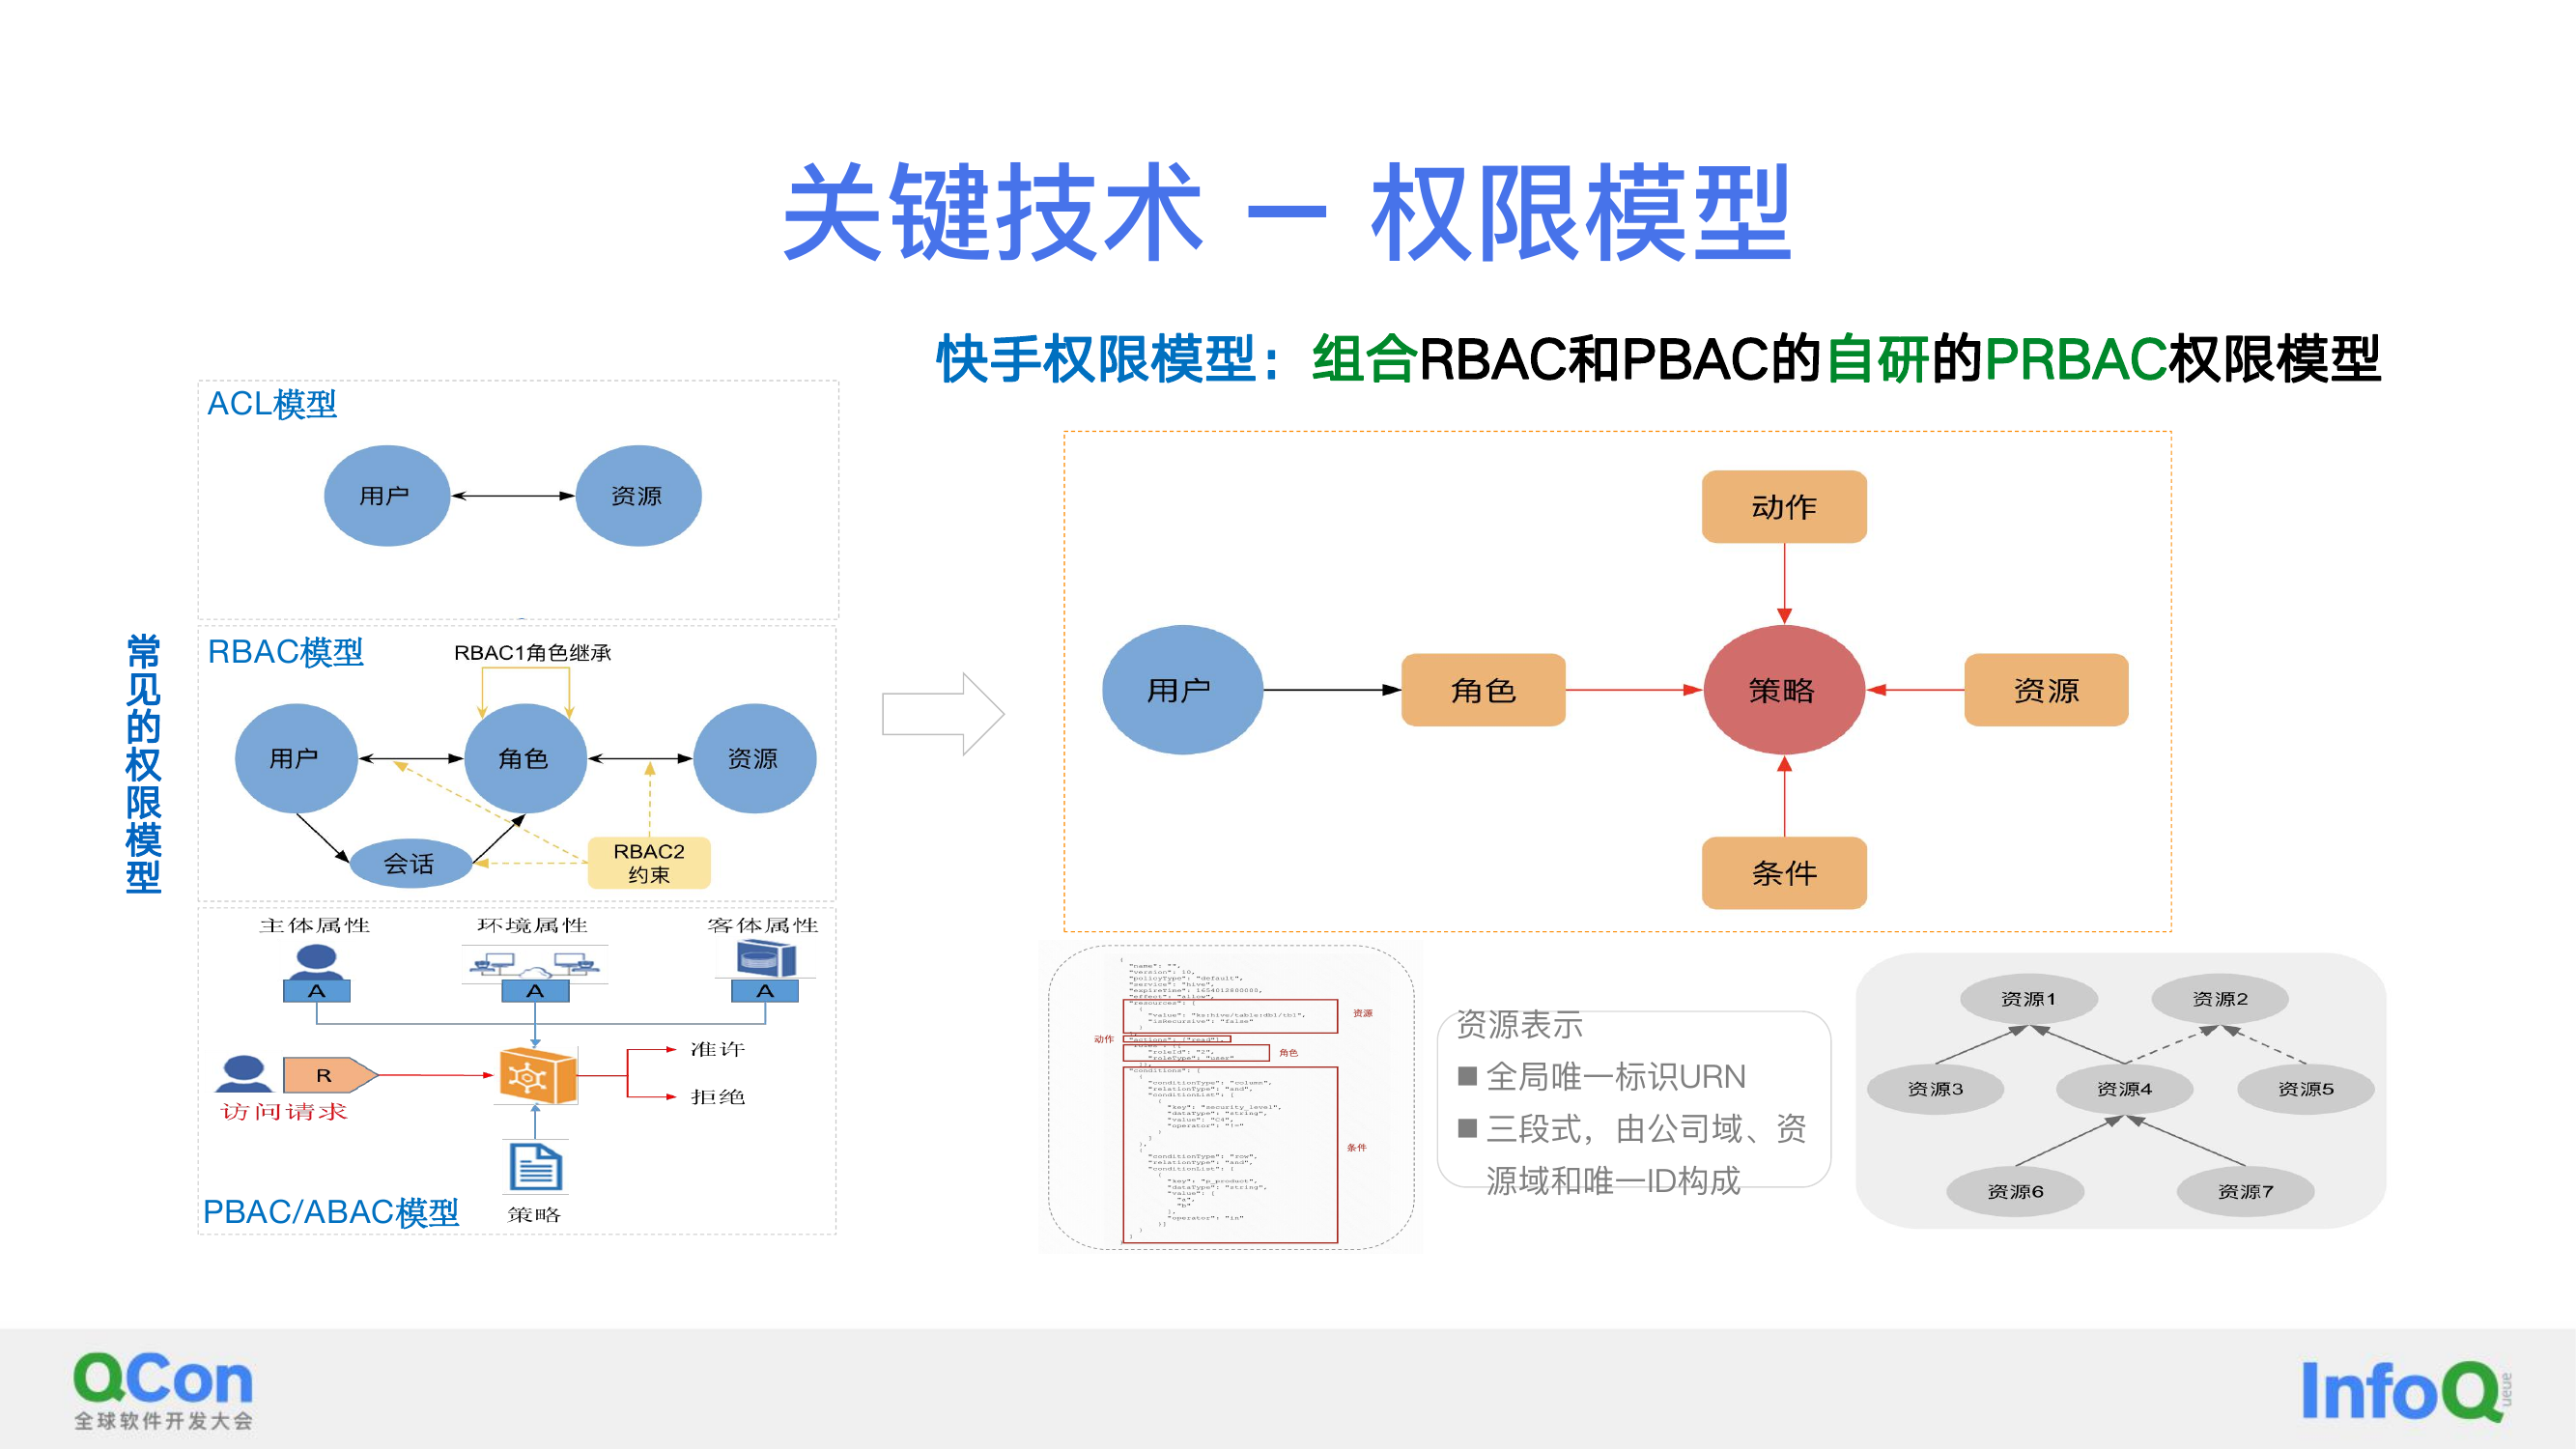
权限模型:自研 PRBAC(组合 RBAC + PBAC);常见模型 = ACL / RBAC / PBAC (ABAC);资源表示 = 全局唯一 URN(公司域 / 资源域 / 唯一 ID 三段式)。
-
统一鉴权:本地鉴权(DSC Server poll policy + DSC Plugin authorize)vs 远程鉴权;Auth Engine(鉴权模型 + 策略规则计算)、Policy Refresher(增量 / 全量拉取)、Cache Manager(本地缓存 + 定时持久化)、Data Loader(路由从库隔离)。
-
全链路审计:数据源(Hive/Olap/Kafka/Hdfs)→ 采集(资产操作 / 访问 / 下载日志)→ 应用(策略管理:审计策略配置 / 计算;风险管理:异常行为告警 / 溯源);统一审计标准(融合血缘信息、风险识别告警)。
最佳实战
-
数据分类分级:分类(通用数据 C1-C4、隐私数据 P1-P4、公共 / 非公共传播数据)+ 分级(公开 / 内部 / 机密 / 绝密);原则 = 数据升级 / 降级 / 衍生。
-
自动数据识别:元数据采集(统一上报 + 图数据库存储)+ 血缘链路传播(表 / 字段继承)+ 检测算法(改进 BERT、k-means、Luhn 校验)+ 规则模板(内置 50+ 个人敏感信息识别模板);资产大盘(个人 / 组织 / 部门三视角)。
-
数据引擎安全:账号体系(个人 / 生产 / 代理)+ 管理角色(安全接口人 / 租户管理员 / 项目组管理员 / 权限负责人)+ 权限隔离(租户隔离、归属和申请两种获权)+ 分层独立鉴权 + 血缘安全元信息联动 + 通用鉴权 Plugin;治理 = 头部平台重点沟通、长尾运营、灰度封禁。
-
敏感数据保护 - 隔离仓:国内外高敏感信息梳理 + 脱敏规范;数据识别(分类分级、文件 / 字段级加密脱敏);数据保护(字段级权限、严格审批、安全隔离仓、精细管控);数据检测(代码检测 / 内容扫描 / 下载监控);数据响应(应急预案 / 全链路异常监控告警溯源);普通仓 vs 安全隔离仓(ODS/DWD/DWS/APP 分层、加密列 / 脱敏列 / 非敏感列)。
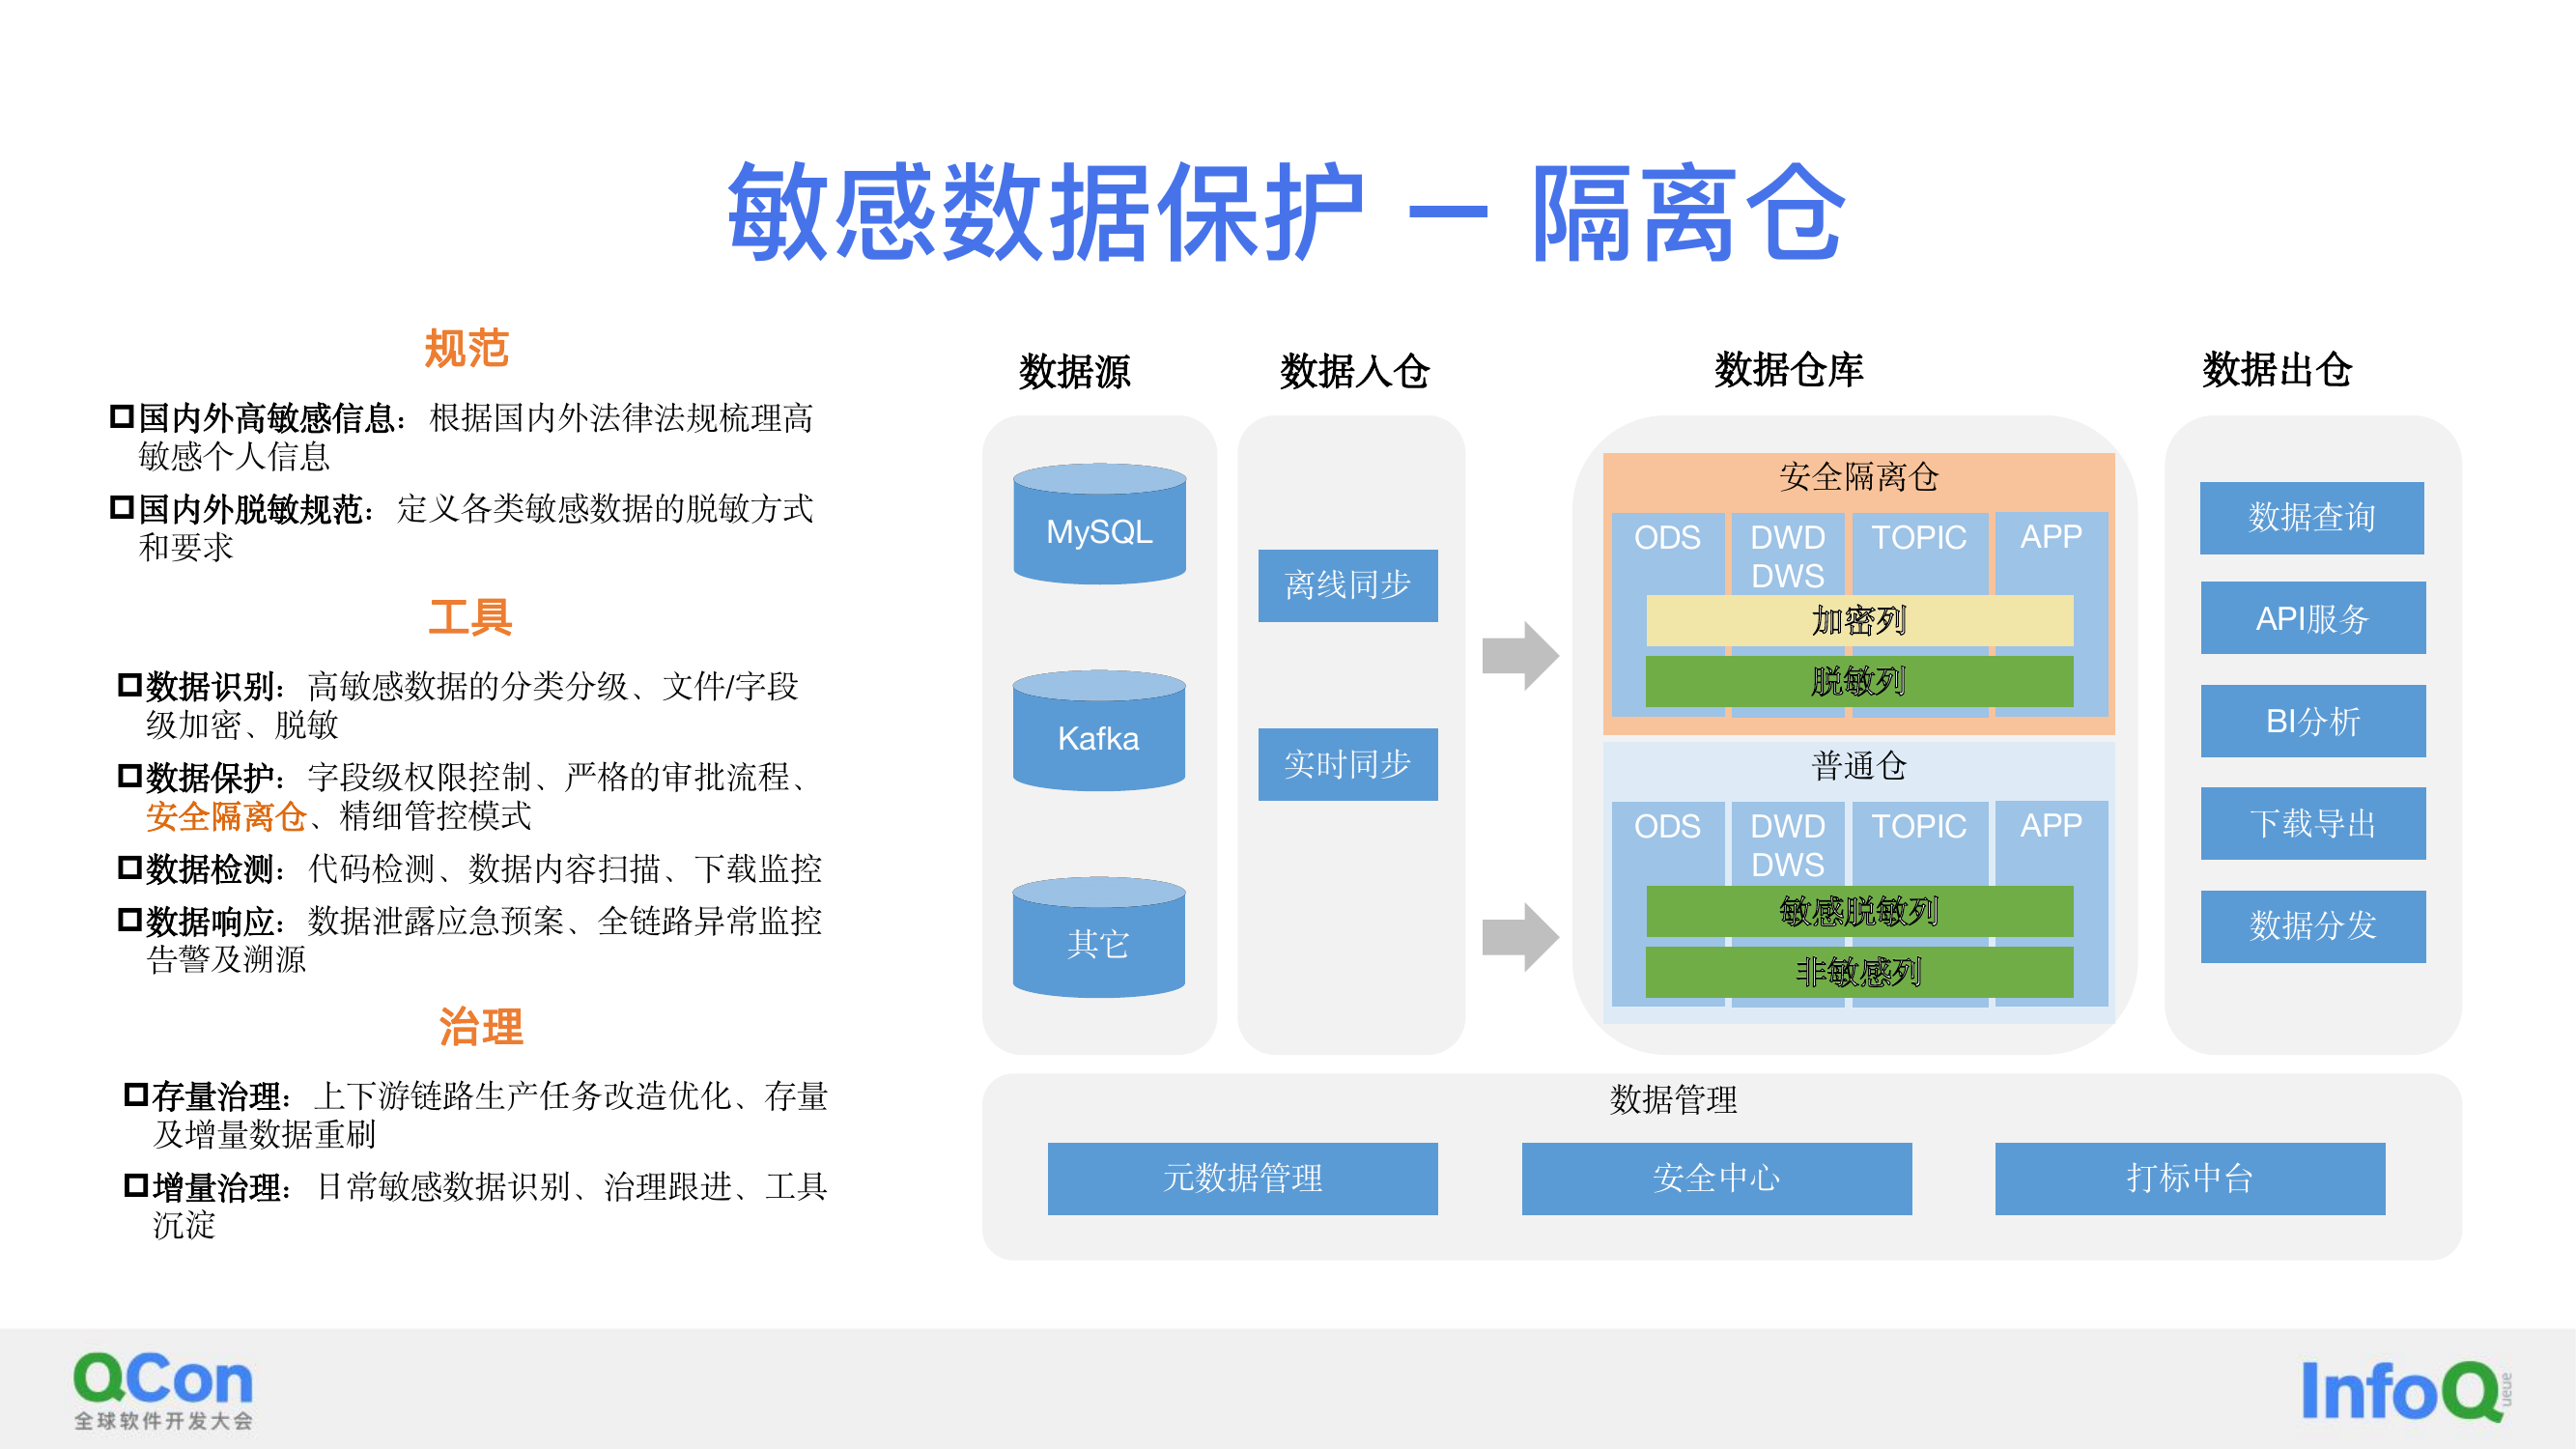
总结与未来:30+ 接入系统、千万级资源、百万级授权、千级日均申请量;未来 = 100% 接入认证鉴权、态势感知、联邦学习 / 安全多方计算(数据的可用不可见)、机器学习智能分类分级。
3.14 刘裕惺《快手有状态服务规模上云实践》
📄 来源飞书文档:刘裕惺《快手有状态服务规模上云实践》(https://my.feishu.cn/wiki/WyKcwx8dbilGetkhZfrcInKxnEh#page_number=16&bbox=%5B0%2C0%2C1%2C1%5D)
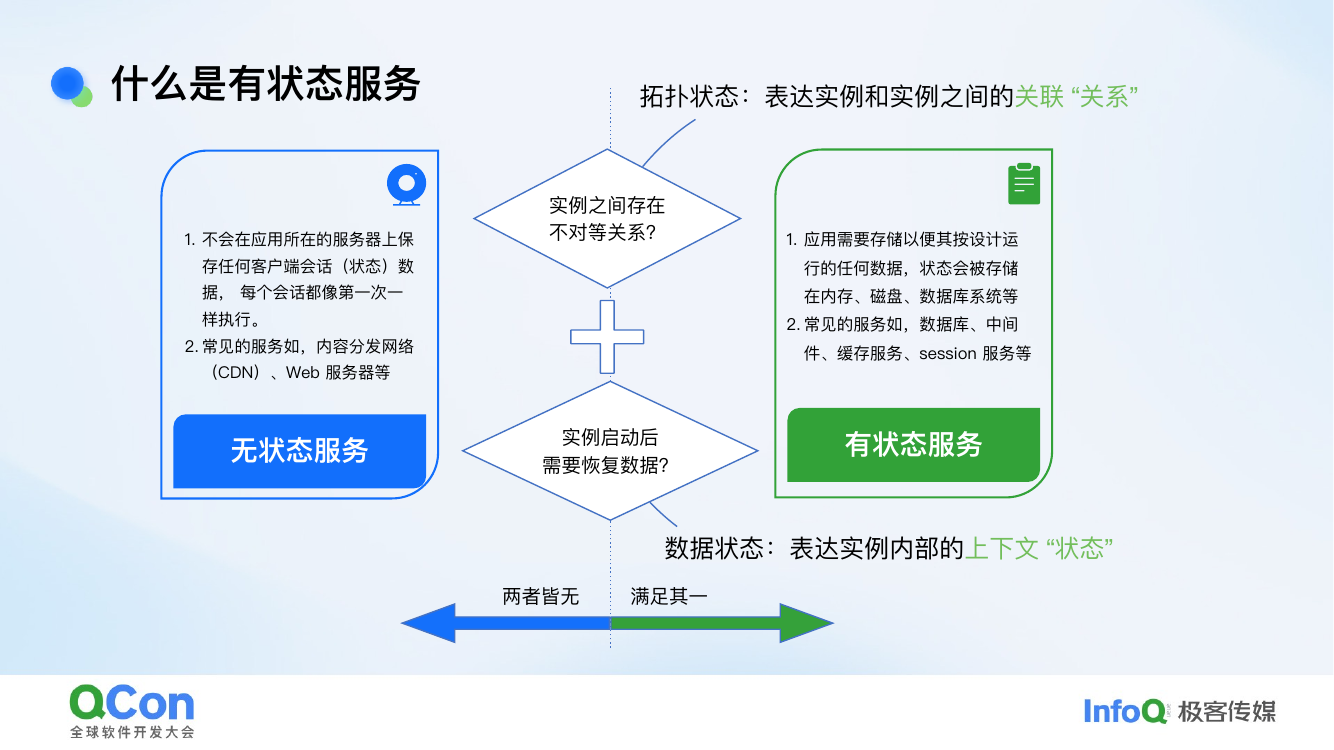
什么是有状态服务
-
无状态服务:不保存任何客户端会话数据,每个会话像第一次执行(如 CDN、Web 服务器)。
-
有状态服务:应用需要存储以便按设计运行的任何数据(内存 / 磁盘 / 数据库),如数据库、中间件、缓存、session 服务。
-
判定标准:实例之间存在不对等关系?(拓扑状态)+ 实例启动后需要恢复数据?(数据状态)—— 两者皆满足其一即是有状态服务。
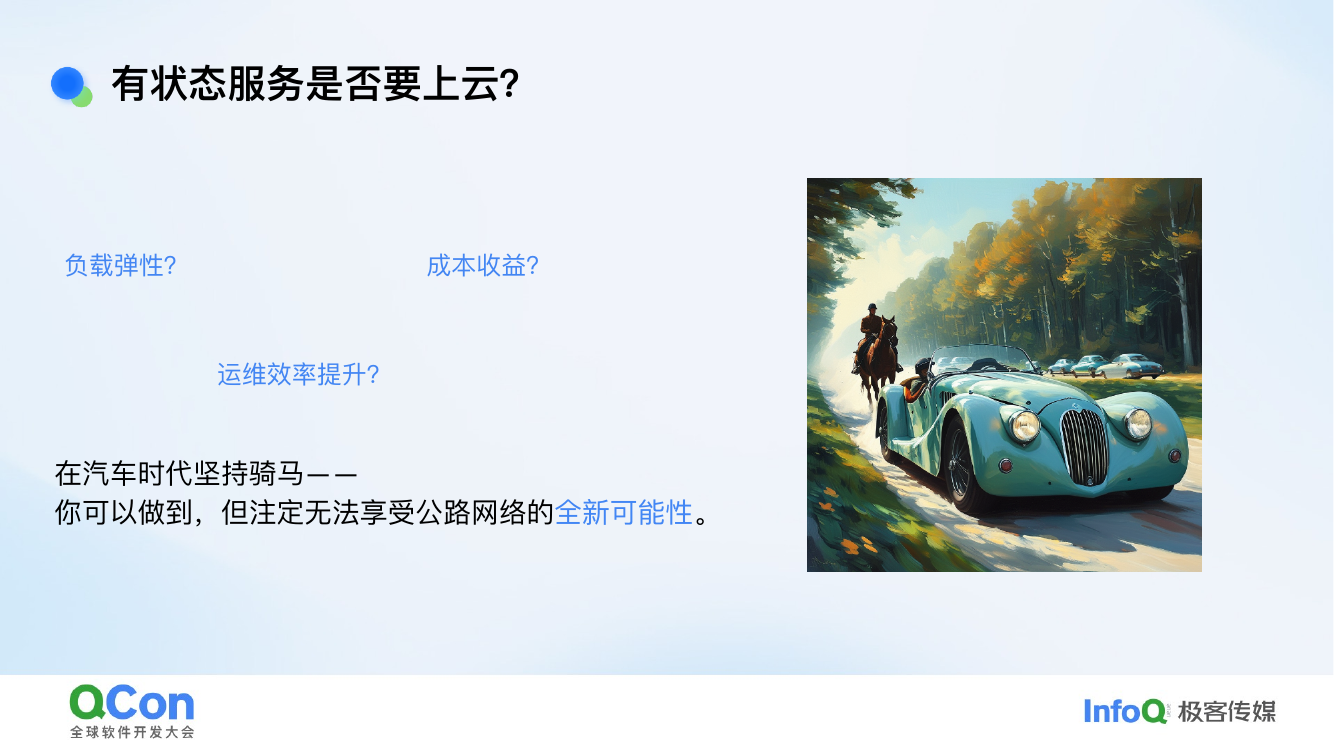
是否要上云:负载弹性?成本收益?运维效率提升?——"在汽车时代坚持骑马:你可以做到,但注定无法享受公路网络的全新可能性"。
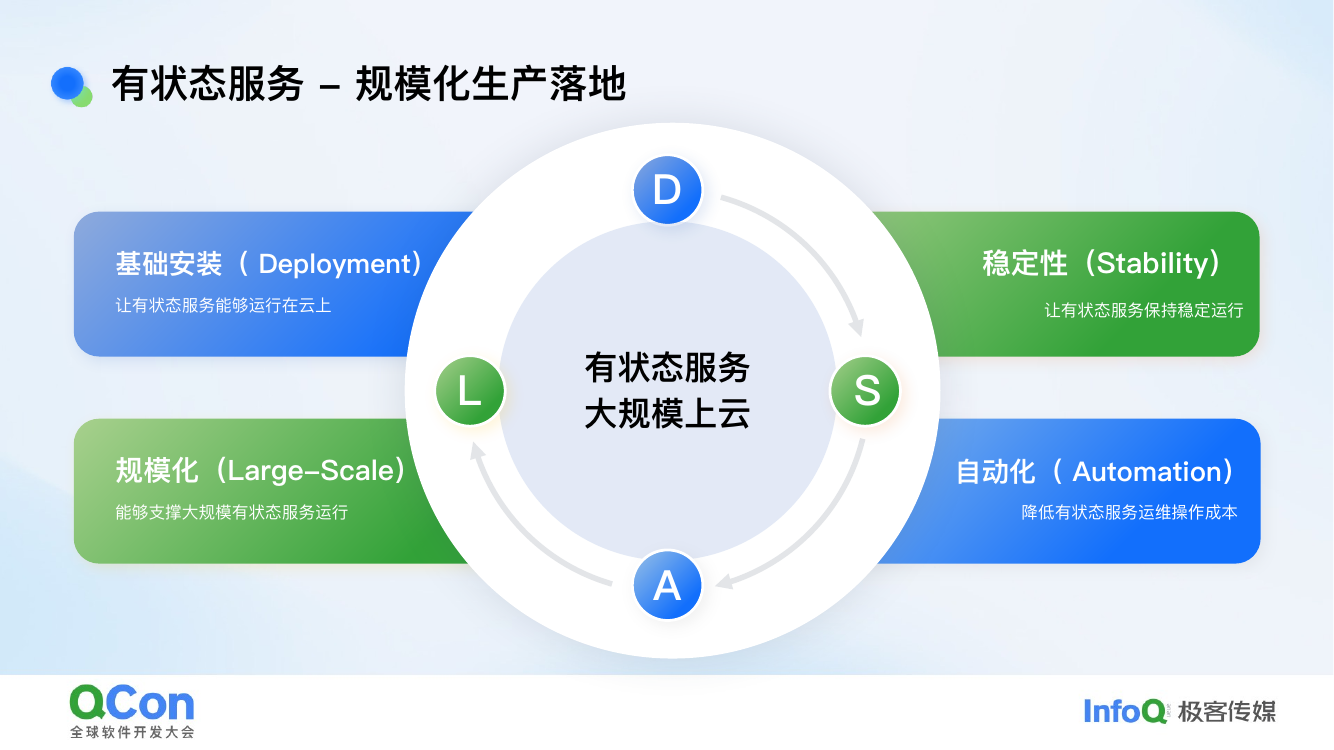
规模化生产落地(DLSA 四维)
-
Deployment 基础安装:让有状态服务能够运行在云上。
-
Large-Scale 规模化:能够支撑大规模有状态服务运行。
-
Automation 自动化:降低有状态服务运维操作成本。
-
Stability 稳定性:让有状态服务保持稳定运行。
未来探讨:云原生数据库(更适合云上的数据库产品);AI-Driven 弹性能力(进一步享受成本优化红利);有状态生命周期管理(Rollout 框架、监控基础设施);有状态应用编排(开箱即用的标准化 API,如 apecloud/kubeblocks)。