001:工具链与行业观察(Skill / MCP / AI 行业观察)
AI API 协议 · Skill 与 MCP 工具链 · WorkBuddy 实践 · AI 行业观察与生产力思考(2026-09-11 从原 001 拆分,
体系定位:AI API 协议 · Skill 与 MCP 工具链 · WorkBuddy 实践 · AI 行业观察与生产力思考(2026-09-11 从原 001 拆分,评测内容已并入 008 大模型原理与评测 / 010 Agent 原理与评测)
📑 目录
- 1 第三部分:AI API 协议与海外 Skill 市场(豆包会话《海外 Skill 市场介绍》)
- 1.1 推理结束标识:finish_reason vs status + output
- 1.2 BOS/EOS 与异步轮询机制
- 1.3 知识蒸馏 vs 输出蒸馏辨析 + AI 安全机制
- 1.4 AGI 通用人工智能:定义、特征与演进阶段
- 2 Skill 与 MCP 工具链
- 2.1 Playwright 自然语言驱动:LLM + 浏览器自动化【2026-09-09 补充】
- 3 Workbuddy 必装的 5 大 Skill 技能,效率翻倍!用了半年
- 3.1 视频信息
- 3.2 全文摘要
- 3.3 原文结构化整理
- 3.4 完整逐字稿
- 3.5 关键截图
- 4 Agent Skill 过多?4 招提升命中
- 4.1 视频信息
- 4.2 全文摘要
- 4.3 原文结构化整理
- 4.4 完整逐字稿
- 4.5 关键截图
- 5 手把手教你创建 Skills—— 全流程,小白一看就懂!
- 5.1 视频信息
- 5.2 全文摘要
- 5.3 原文结构化整理
- 5.4 完整逐字稿
- 5.5 关键截图
- 6 Superdesign Tutorial - Create First Design
- 6.1 视频信息
- 6.2 全文摘要
- 6.3 原文结构化整理
- 6.4 完整逐字稿
- 6.5 关键截图
- 7 AI 必装的 10 个插件
- 7.1 视频信息
- 7.2 全文摘要
- 7.3 原文结构化整理
- 7.4 完整逐字稿
- 7.5 关键截图
- 8 NA - Superdesign CLI Skill Tutorial
- 8.1 视频信息
- 8.2 全文摘要
- 8.3 原文结构化整理
- 8.4 完整逐字稿
- 8.5 关键截图
- 9 装上这 8 个 Skill 之后,WorkBuddy 直接变全能助手
- 9.1 视频信息
- 9.2 全文摘要
- 9.3 原文结构化整理
- 9.4 完整逐字稿
- 9.5 关键截图
- 10 为何有了 Skill 还需要 MCP?10 分钟给大家讲清楚!
- 10.1 视频信息
- 10.2 全文摘要
- 10.3 原文结构化整理
- 10.4 完整逐字稿
- 10.5 关键截图
- 11 MCP vs CLI:大模型工具的未来属于谁?16 分钟讲清楚!
- 11.1 视频信息
- 11.2 全文摘要
- 11.3 原文结构化整理
- 11.4 完整逐字稿
- 11.5 关键截图
- 11.6 Chat Completions API vs Responses API(OpenAI 两大协议)
- 11.7 Skill 市场与社区盘点(国内外)
- 11.8 Coze / Skill / Agent 三者关系与 Coze 并入豆包
- 12 AI 行业观察与生产力思考
- 13 AI 时代的生产力革命与长期思考
- 13.1 第一章 工业革命放大了体力,AI 放大了智力
- 13.2 第二章 曾鸣访谈全录结构化提取:《2026,像极了 1995》
- 13.3 第三章 资本大佬的资金回笼逻辑:李嘉诚、巴菲特 2026 年都在做什么
- 13.4 附录:信息来源
- 14 Codex 一人做完短视频:Codex 干完自媒体全流程,配音剪片发布全自动
- 14.1 视频信息
- 14.2 全文摘要
- 14.3 原文结构化整理
- 14.4 完整逐字稿
- 14.5 关键截图
- 15 AI 时代内容创作和产品营销的 5 个趋势
- 15.1 视频信息
- 15.2 全文摘要
- 15.3 原文结构化整理
- 15.4 完整逐字稿
- 15.5 关键截图
- 16 DeepSeek 一天消耗八万亿,这是对于硅谷 AI 的斩杀线
- 16.1 视频信息
- 16.2 全文摘要
- 16.3 原文结构化整理
- 16.4 完整逐字稿
- 16.5 关键截图
- 17 马斯克突然宣布解散!这次他真的认输了?
- 17.1 视频信息
- 17.2 全文摘要
- 17.3 原文结构化整理
- 17.4 完整逐字稿
- 17.5 关键截图
- 18 AI 行业动态与前沿解析(大模型命名 / 行业收购 / WeatherNext3 / 新闻诉讼 / ChatGPT Ads / DSH / AI Builder)
- 18.1 大模型命名套路(Fable / Sol 为例)
- 18.2 AI 行业收购事件盘点(英伟达 / OpenAI / Anthropic / SpaceX)
- 18.3 WeatherNext3(谷歌 DeepMind AI 气象模型)
- 18.4 AI 行业新闻与诉讼拆解(2026 近期)
- 18.5 ChatGPT Ads 广告机制(如何丝滑嵌入对话)
- 18.6 DSH:DeepSeek-R1 时刻还是新坑?
- 18.7 什么是 AI Builder?AI 时代的开发者定位
- 19 如何用 AI 做出超级好看的矢量图(可编辑)
- 19.1 视频信息
- 19.2 全文摘要
- 19.3 原文结构化整理
- 19.4 完整逐字稿
- 19.5 关键截图
- 20 LLM 调试工具链:LLM Space / Claude-Tap / Langfuse / DeerFlow
- 20.1 LLM Space(桌面级 Agent IDE)
- 20.2 Claude-Tap(本地代理抓包回放)
- 20.3 Langfuse(LLM 工程全链路追踪)
- 20.4 DeerFlow(LLM Space 姊妹项目)
- 21 AI 办公软件 / Agent 梯队定级与归因分析(2026-09 调研)
- 21.1 梯队总表
- 21.2 第一梯队归因分析:"它们到底做得好在哪里?"
- 21.2.1 国内第一梯队
- 21.2.1.1 豆包(字节跳动)—— 流量 × 迭代速度的碾压者
- 21.2.1.2 通义千问 + 钉钉 AI(阿里巴巴)—— 企业基建型的"全栈平推"
- 21.2.1.3 WPS AI(金山办公)—— 存量办公入口的"AI 化收割者"
- 21.2.1.4 腾讯系(元宝 + WorkBuddy + ima)—— 微信生态 × 桌面 Agent 的"慢热拼图"
- 21.2.2 国外第一梯队
- 21.2.2.1 ChatGPT(OpenAI)—— 模型 + 生态的全球默认选项
- 21.2.2.2 Microsoft 365 Copilot(微软)—— 套件分发的"顺水推舟者"
- 21.2.2.3 Claude(Anthropic)—— 企业安全与写作质量的"高信任派"
- 21.2.2.4 Gemini for Workspace(Google)—— 捆绑分发 × 多模态的"性价比挑战者"
- 21.2.3 第一梯队横向对比表
- 21.3 选型建议
- 21.4 关键趋势判断(2026 下半年)
- 21.5 盈利与成本分析(2026-09 补充调研)
1 第三部分:AI API 协议与海外 Skill 市场(豆包会话《海外 Skill 市场介绍》)
来源 :豆包会话《海外 Skill 市场介绍》(2026-09-04,链接
xe2lqJqR8u5qJuATF) 覆盖范围 :Chat Completions vs Responses API、Skill 市场盘点、Coze 并入豆包、Agent 开发工具对比、推理结束标识、BOS/EOS、异步轮询、大模型命名、AI 行业收购、WeatherNext3、AI 新闻诉讼、知识蒸馏辨析、ChatGPT Ads
📄 来源:001_模型评测指标知识点汇总.md (## 三十七、推理结束标识:finish_reason vs status + output)
1.1 推理结束标识:finish_reason vs status + output
1.1.1 核心结论
-
Chat Completions 看
choices[0].finish_reason:"stop"= 结束(正常出答案),"tool_calls"= 这轮输出结束但任务没结束(要接着调工具),"length"= 被截断 -
Responses API 看两层:先看顶层
status(completed /in_progress/incomplete/failed),再看 output 数组里 item 的类型 —— 是 message 才算真的结束,是 function_call 就还要继续工具循环 -
最大的坑:Responses 里工具调用时 status 也是 "completed",不能只看 status 就以为任务完了,必须看 output 类型
1.1.2 Chat Completions:用 finish_reason 一个字段判断
-
✅ 推理结束(最终回答)→
finish_reason: "stop"(模型自然生成完成,content 是最终答案) -
🔄 未结束(要调工具)→
finish_reason: "tool_calls"(模型这轮输出结束,但整个任务没结束;要执行工具、用 role:"tool" 回传、再发下一轮) -
⏳ 流式模式未结束 →
finish_reason: null(每个分片都是 null,只有最后一个分片才出现真实值) -
⚠️ 被截断 →
finish_reason: "length"(达到 max_completion_tokens 上限,输出被截断)
1.1.3 Responses API:用 status + output 类型两层判断
-
✅ 推理结束(最终回答)→
status: "completed"+ output 是 message(答案在 output_text) -
🔄 未结束(要调工具)→ status 依然是 "completed",但 output 是 function_call(最易搞混!判定标准是 output 类型,不是 status)
-
⏳ 异步处理中 →
status: "in_progress"(Chat Completions 没有这个状态;需轮询 GET /v1/responses/{id}) -
⚠️ 截断 →
status: "incomplete"+ incomplete_details.reason(如 max_output_tokens) -
❌ 失败 →
status: "failed"+ error 对象
1.1.4 差异对照表
| 维度 | Chat Completions | Responses API |
|---|---|---|
| 判定入口 | choices [0].finish_reason(单次输出级) | 顶层 status + output [] item 类型(任务级) |
| "结束" 标识 | finish_reason: "stop" | status: "completed" 且 output 是 message |
| "未结束・要调工具" | finish_reason: "tool_calls" | output 是 function_call(status 也是 completed) |
| "正在处理中" | 无此状态(同步返回);流式分片 finish_reason: null | status: "in_progress",需轮询 |
| 截断标识 | finish_reason: "length" | status: "incomplete" + incomplete_details.reason |
| 失败标识 | HTTP 错误码 | status: "failed" + error 对象 |
1.1.5 最容易踩的坑
-
Responses 里别只判断 status:工具调用返回时 status 同样是 "completed",
output[0].type === "function_call"才是 "要继续" 的信号 -
Chat Completions 流式:一定要等到 finish_reason 出现非 null 值再停止接收,否则答案不完整
-
语义层级不同:Chat Completions 的 "stop" 只代表 "这次模型输出结束",整个多轮 Agent 任务是否结束要自己在业务层判断;Responses 的 completed + message 更接近 "这条响应链路走完了"
一句话:Chat Completions 用 finish_reason 一个字段告诉你 "这轮输出停在哪";Responses 用 status + output 类型告诉你 "这个 Agent 任务到哪个环节了"—— 这是 "单次对话" 思维和 "Agent 任务" 思维的差别。
📄 来源:001_模型评测指标知识点汇总.md (## 三十八、BOS/EOS 与异步轮询机制)
1.2 BOS/EOS 与异步轮询机制
1.2.1 BOS / EOS 全称与含义
| Token | 全称 | 含义 | 常见符号 |
|---|---|---|---|
| BOS | Beginning Of Sequence(也有说 Beginning Of Sentence) | 序列 / 句子的开始标记,告诉模型 "输入从这里开始" | <s>、<bos>、`< |
| EOS | End Of Sequence(也有说 End Of Sentence) | 序列 / 句子的结束标记,模型生成到它就会停止 | </s>、<eos>、`< |
关键联系:finish_reason: "stop" 的本质就是模型生成了 EOS 标记(或命中停止序列),解码过程自然终止。EOS 是 "模型自己决定停" 的底层信号。
补充:特殊 token 家族还有 PAD(Padding 填充)、UNK(Unknown 未知词)、SEP(Separator 分隔)、CLS(Classification 分类头),BOS/EOS 是其中最核心的两个。
1.2.2 两个 API 的官方名称
| 接口 | 官方名称 | 路径 | 本质 |
|---|---|---|---|
| 老的 | Completions API(文本补全,已弃用) | /v1/completions | 纯文本续写 |
| 现行 | Chat Completions API(对话补全) | /v1/chat/completions | 对话式,事实标准 |
| 新版 | Responses API(响应 API) | /v1/responses | 面向 Agent 的新一代接口 |
两者都是 OpenAI 定义的 REST API 接口规范,不是像 HTTP 那样的底层协议标准。Chat Completions 因生态最大成为行业 "事实标准"(几乎所有厂商都做兼容层);OpenAI 想通过 Open Responses(2026-01 发布)把 Responses 格式推向开放规范。
1.2.3 Chat Completions 能异步吗?"后台执行完通知用户" 怎么做?
协议层:Chat Completions 是纯同步的 —— 一个 HTTP 请求一直等到模型生成完才返回,没有原生的 "提交任务→拿任务 ID→后台跑→查状态" 模式。
应用层实现(3 种主流做法):
-
方案 A:任务队列 + Worker(最通用):用户提交任务 → 业务服务丢进队列(Celery/Redis/SQS)→ 后台 Worker 拉出调 Chat Completions(同步)→ 完成后通过 Webhook / 站内信 / IM 推送通知用户。多 Agent 协同 / 大任务场景标准实现:编排层把任务拆成多个子 Agent,每个子任务走队列异步执行,全部完成后再聚合通知
-
方案 B:流式(SSE):stream: true 打开,服务端边生成边推 chunk,客户端 SSE 实时收进度。是长连接流式,不是真正的后台任务
-
方案 C:把 Chat Completions 包成异步服务:自己写一层 "任务表 + 状态字段(pending/running/done)",用户拿 task_id 轮询自己的接口。注意:轮询的是自建服务,不是模型 API
对比:Responses API 把这些做到协议层 ——background=True 提交后台任务、返回 response_id、直接轮询模型 API 本身。
1.2.4 Responses API 的轮询:是 while true 吗?
本质是一个循环轮询,但不是 "无脑 while true",正确姿势是:带间隔 + 带超时上限 + 退避策略 + 只查终态。
from openai import OpenAI

import time

client = OpenAI()

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\# 1. 提交后台任务,立即返回,不阻塞

resp = client.responses.create(

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    model="gpt-5.x",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    input="写一篇很长的论文...",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    background=True,          # ← 关键:进入后台模式

)

print(f"任务已提交: {resp.id}, 状态: {resp.status}")  # 通常是 "queued" / "in\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_progress"

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\# 2. 轮询直到终态

while resp.status in {"queued", "in\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_progress"}:    # 非终态集合

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    time.sleep(2)                                  # 每次间隔 2 秒

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    resp = client.responses.retrieve(resp.id)      # 按 response\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_id 查状态

print(resp.output\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_text)
状态机:queued(排队中)→ in_progress(执行中)→ 终态 completed(成功)/failed(失败)/cancelled(取消)/incomplete(截断)
生产环境不要裸写 while True,要做 4 个优化:
-
加超时上限:长任务可能跑很久甚至挂死,max_seconds 上限,超时抛异常或降级
-
指数退避间隔:固定 2s 轮询上千并发会打爆限流(如 GPT-4 约 1 万次 / 分钟),1s→2s→4s→8s 递增封顶 5s
-
尊重服务端建议:服务端返回 openai-poll-after-ms 头告知 "多久后再来查"
-
别阻塞主线程:用 async/await、后台任务、或 SDK 封装好的 poll ()
SDK 已封装:
\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\# openai-python 提供的 poll 辅助方法(内部就是"循环+间隔+超时")

resp = client.responses.create(model="gpt-5.x", input="...", background=True)

final = client.responses.poll(resp.id)   # 自动轮询到终态再返回
还有统一的 *_and_poll 系列方法(如 threads.runs.create_and_poll),可传 poll_interval_ms 控制频率。
📄 来源:001_模型评测指标知识点汇总.md (## 四十三、知识蒸馏 vs 输出蒸馏辨析 + AI 安全机制)
1.3 知识蒸馏 vs 输出蒸馏辨析 + AI 安全机制
1.3.1 "拿 OpenAI 输出训练 Grok" 算不算蒸馏?
答案是:广义上算 "蒸馏",但严格学术意义上的知识蒸馏不是一回事。
| 维度 | 严格知识蒸馏(Hinton 2015) | 用 OpenAI 输出训练(xAI 被指控的做法) |
|---|---|---|
| 学习目标 | 教师模型的概率分布 /logits(软标签) | 教师模型最终生成的文本(硬标签) |
| 信息含量 | 保留 "暗知识"(对每个候选词的置信度分布) | 只拿到最终输出文字,丢失概率信息 |
| 需要的权限 | 通常要教师模型配合(或 API 提供 logprobs) | 只要 API 的返回文本即可 |
| 准确称呼 | Knowledge Distillation(知识蒸馏) | 输出蒸馏 / 合成数据训练 /imitation |
| 典型用途 | 大模型压缩成小模型(7B→1B) | 用强模型生成数据喂给自家模型 |
人话版:严格知识蒸馏像 "学生抄老师的答题思路(每一步的把握程度)";用输出训练像 "学生抄老师的标准答案"—— 前者学到的是 "为什么会这么想",后者只学到 "答案长什么样"。
xAI 被指控的是 "标准答案" 型(output distillation)。OpenAI 服务条款明确禁止用其 API 输出训练 "竞争模型"(competitive model)—— 这也是 OpenAI 对 Cursor/SpaceX 不信任的历史根源之一。
1.3.2 ChatGPT 遇到高危对话会不会通知警察?
你的直觉方向对 —— 确实应该有应急响应机制,但现状不是 "通知警察"。真实设计是 "分层响应" 模型:
- 有应急响应机制,但以 "预防 + 转介" 为主,不是 "监视 + 报警"
-
自伤场景 → 给危机资源(业界通行)
-
暴力 / 犯罪指导 → 拒绝 + 警示
-
CSAM(儿童性虐待内容)→ 目前唯一普遍强制上报执法的场景(美国法律要求,上报给 NCMEC)
-
为什么 "通知警察" 没有成为常态机制:误报率 + 隐私 + 法律授权三个硬约束。模型对 "是否真的要犯罪" 的置信度远不足以支撑大规模执法举报,一旦误报代价极高
-
与枪击案诉讼的微妙关联:OpenAI 抗辩逻辑是 "模型只是生成文本,没有主观意图"。假如 OpenAI 建立 "识别犯罪意图并上报" 机制,反而等于承认 "模型能识别意图",会削弱自己的抗辩立场 —— 所以产品上更强调 "护栏",而不是 "监控"
-
但议题正被诉讼推动变化:Tumbler Ridge 案及 AI 责任边界讨论,可能推动未来 "高置信度极端场景 + 人工复核 + 有限上报" 机制探索 —— 但目前无论技术还是法律都远未成熟
一句话:你要的 "应急机制" 存在,但形态是 "挡住有害输出 + 给求助资源 + 法定场景(CSAM)上报",而不是普遍报警;后者在隐私、误报、法律三个层面都过不了关。
📄 来源:001_模型评测指标知识点汇总.md (## 四十五、AGI 通用人工智能:定义、特征与演进阶段)
1.4 AGI 通用人工智能:定义、特征与演进阶段
1.4.1 什么是 AGI(通用人工智能)
AGI = Artificial General Intelligence(通用人工智能),指 "具备与人类同等(或超越人类)水平、能在任何智力任务上表现的人工智能",核心是通用性—— 不是只擅长下棋、翻译、画画等某一种任务,而是像人一样能跨领域理解、学习、推理、规划并解决新问题。
与之相对的概念:
| 概念 | 全称 | 特点 |
|---|---|---|
| ANI / Narrow AI | Artificial Narrow Intelligence(狭义人工智能) | 只擅长单一或特定领域任务(如人脸识别、语音识别、AlphaGo 下棋),当前绝大多数 AI 都是 ANI |
| AGI | Artificial General Intelligence(通用人工智能) | 具备通用学习和推理能力,能像人一样跨领域处理任意智力任务 |
| ASI | Artificial Superintelligence(超级人工智能) | 智力全面超越人类的人工智能,属于 AGI 之后的想象阶段 |
关键辨析:现在的 ChatGPT / Claude / 豆包 等大模型,能力已经远超传统 ANI,但本质上仍是 **"强 ANI"**—— 它们有很强的语言 / 代码 / 推理能力,但仍是 "被训练在某类任务上" 的模型,不具备真正的跨领域自主通用性(例如不能像人一样随时学会任意新技能、有持久自我意识与目标)。大模型的出现让 AGI 从 "遥不可及" 变成了 "看到曙光",但业界对 "是否已接近 AGI" 争议很大。
1.4.2 AGI 的六个能力维度(业界常用评估框架)
参考 OpenAI / DeepMind 等主流评估思路,衡量一个系统是否接近 AGI,通常看这六个维度:
-
学习能力:能否从少量样本 / 新领域快速学会新任务(few-shot /zero-shot/ 持续学习)
-
推理能力:逻辑推理、数学、因果推断、常识理解(区别于 "死记硬背")
-
规划能力:把复杂目标拆解成子目标并有序执行(Agent 的核心能力)
-
知识泛化:能否把已有知识迁移到从未见过的新任务、新场景
-
感知与交互:多模态理解(文字 / 图像 / 声音 / 视频)+ 与世界真实交互(工具、环境)
-
自主性与持续性:长期目标保持、自我纠错、自我改进(而非每轮对话都 "重新开始")
面试观点话术:AGI 不是 "某个模型变聪明" 这么简单,而是学习、推理、规划、泛化、感知、自主六个能力的综合达标。当前大模型在 1/2/3 上有惊艳表现,但 4(泛化)、6(自主性)仍有明显缺口。
1.4.3 AGI 的演进阶段(业界常见分层)
业界对 "从当前 AI 到 AGI 要走几个阶段" 有多个版本划分,最常被引用的是 OpenAI 的 5 级路线(2023 年提出):
| 等级 | 名称 | 代表能力 | 当前状态(2026 判断) |
|---|---|---|---|
| L1 | 聊天机器人(Chatbots) | 能自然对话,有语言能力 | ✅ 已实现(2022 年 GPT-3.5 / ChatGPT 引爆) |
| L2 | 推理者(Reasoners) | 能像人类专家一样解决复杂问题、深度推理 | 🔄 已接近 / 部分实现(o 系列、DeepSeek-R1、Claude 等推理模型) |
| L3 | 智能体(Agents) | 能自主执行多步操作、使用工具完成任务 | 🚧 正在突破(Agent 是当前最热方向,但可靠性 / 长程任务仍不足) |
| L4 | 创新者(Innovators) | 能自主发明创造,产出原创性新知识 / 技术 | 🔭 尚未实现(前沿探索阶段) |
| L5 | 组织者(Organizations) | 能像组织一样自主运转,完成组织级工作 | 🌌 愿景阶段(最远) |
另一个常被引用的框架:按 "与人类能力对比" 分为 ——弱 AI(ANI)→ 强 AI(AGI)→ 超 AI(ASI) 三阶段;也有按技术里程碑分:感知智能(能听会说看)→ 认知智能(能理解会思考)→ 通用智能(全领域自主)。
DeepMind 也有类似分级(绩效 vs 通用性两轴),把 "通用能力" 划分为:初级(Amateur)→ 专家(Expert)→ 大师(Virtuoso)→ 超人(Superhuman)四个绩效等级 × 通用性范围(窄 / 宽 / 全)。
1.4.4 当前我们处于哪个阶段?(2026 主流判断)
主流共识:当前(2026 年)整体处于 L1 已达成、L2 正在突破、L3 方兴未艾 的过渡带 ——
-
已实现:L1 对话能力(所有主流大模型)
-
接近 / 局部实现:L2 深度推理(o 系列 / R1 系推理模型在数学、代码、科学问题上有专家级表现,但仍有幻觉和可靠性问题)
-
正在攻坚:L3 智能体(Agent 能调用工具、多轮执行任务,但长程稳定性、自我纠错、真实世界操作仍不可靠)
-
未实现:L4/L5(自主创新、组织级自主运作)
争议点(面试加分项):有人认为 "大模型 + 足够算力 + 足够数据 ≈ 通向 AGI 的路径已清晰",有人认为当前路线只是 "统计学习的高峰"、距离真正的通用智能(具身、自主意识、因果理解)仍有本质鸿沟。是否把 "当前大模型" 称为 AGI 的前身,业界没有统一答案—— 但共识是:L2 推理和 L3 Agent 是当前离我们最近、也最能落地的 AGI 前兆。
1.4.5 面试关联:AGI 和当前热点的关系
-
和 Agent 的关系:Agent(智能体)被普遍视为 "通往 AGI 的 L3 阶段" 的落地形态 —— 自主规划 + 工具调用 + 多轮执行。面试聊 Agent 时,可以顺势引出 AGI 分级,展示体系化认知
-
和推理模型的关系:o 系列 / DeepSeek-R1 等 "推理模型" 就是 L2(Reasoners)的具象化 —— 通过思维链(CoT)让模型 "先想后答"
-
和 AI 味的关系:当前大模型的 "AI 味" 本质是其统计生成机制(详见第二十章),这也解释了为什么它还不是真正 "通用智能"—— 它在模仿人类表达,而非真正理解世界
-
和评测的关系:AGI 的评测比普通模型评测更复杂 —— 除了正确率,还要看泛化、迁移、鲁棒性、对齐等(呼应本文档第一部分的评测指标体系)
1.4.6 一句话面试速记
"AGI 是具备像人一样跨领域通用学习与推理能力的人工智能,与只擅长单一任务的 ANI 相对。业界常用 OpenAI 五级划分:L1 聊天机器人(已实现)→ L2 推理者(当前推理模型正突破)→ L3 智能体(Agent 正是这一阶段的落地形态,正在攻坚)→ L4 创新者 → L5 组织者。当前大模型能力虽强,本质仍是 ' 强 ANI',距离真正 AGI 在泛化与自主性上还有明显差距。" 本文档为面试知识点整理合集 ,覆盖三个豆包会话的全部知识点。如需补充或修订,请告知。
📄 来源:002_大厂 AI 面试视频知识点汇总.md (文档头部)
2 Skill 与 MCP 工具链
体系定位:Skill / MCP 与工具链(Skill 创建 / 命中 / MCP/WorkBuddy/ 插件) 来源文件数:12(内容原封不动按来源保留)
2.1 Playwright 自然语言驱动:LLM + 浏览器自动化【2026-09-09 补充】
直接结论:Playwright 本身是代码 API 库(Python/JS/Java/.NET),只能执行写死的指令(page.click/page.fill),听不懂自然语言;但 "自然语言驱动" 完全可行且是当前主流 ——在 Playwright 前面加一个 LLM 翻译层:LLM 把自然语言意图转成 Playwright 能执行的代码 / 工具调用,执行后把页面状态(可访问性树 / 截图 / DOM)反馈给 LLM,循环直到任务完成。
三种主流实现方式:
| 方式 | 代表 | 机制 | 适合场景 |
|---|---|---|---|
| A. LLM 生成 Playwright 代码 | GPT/Copilot 写测试 | 自然语言 → LLM → 生成完整 .spec.ts 代码 → 离线执行 | 测试用例生成、批量脚本,半自动 |
| B. Playwright MCP(官方) | @playwright/mcp(微软 Playwright 团队) | LLM 通过 MCP 工具实时调用浏览器(browser_navigate/click/type…),页面以结构化 Accessibility Tree 返回,无需视觉模型 | Agent 实时操作浏览器、对话式爬虫,最标准 |
| C. 浏览器自动化 SDK | Stagehand、Browser Use | 在 Playwright 上封装 act ()(自然语言→动作)、extract ()(结构化抽取)、observe ()(发现可用动作)、agent ()(自主工作流) | 代码控制流 + AI 动作的混合,元素定位自愈 |
核心闭环机制:自然语言指令 → LLM(意图解析 → 动作序列 / 工具选择)→ Playwright API(navigate/click/fill/extract/assert)→ 真实浏览器执行 → 观察反馈(Accessibility Tree / 截图 / DOM)→ 决定下一步 → 循环直到任务完成。
三个关键设计(面试加分):
-
用可访问性树(Accessibility Tree),不塞整页 DOM:整页 DOM 给 LLM 做上下文 token 贵且噪音大;裁剪成语义节点(按钮 / 输入框 / 标题),省 token 又够定位。Playwright MCP 官方即用此方案 —— 通过结构化可访问性快照交互,不需要视觉模型。
-
动作翻译 + 观察反馈:LLM 选定元素和动作 → 翻译成 Playwright API 执行 → 把新页面状态喂回去 → 自闭环;页面改版导致定位失效时能继续 / 自愈(Stagehand 等会检测变化自动修复选择器)。
-
可混合代码与 AI:Stagehand 模式 —— 开发者写控制流(先导航到哪、边界条件),AI 只负责具体动作(点哪个按钮),稳定与灵活折中,回归可控。
局限(诚实说明):非确定性 —— 同一自然语言指令两次可能产生不同动作,回归测试里不能当唯一断言;动态页面 / 跨域 iframe/Shadow DOM 定位仍有挑战;每步都调 LLM 有 token 成本和延迟;让 Agent 操作真实站点要权限控制和安全沙箱(对应 "Agent 输入输出过滤" 知识点)。
官方例证:Playwright MCP 文档示例 —— 用户说 "Navigate to https://demo.playwright.dev/todomvc and add 'Buy groceries'",LLM 自动翻译成 browser_navigate {url} + 添加待办,全程通过结构化可访问性快照与页面交互。来源:playwright.dev/mcp/introduction、github.com/microsoft/playwright-mcp。
工程选型建议(面试视角):探索式测试 / 用例生成 / 爬虫 → 自然语言驱动;CI 回归测试 → 确定性代码;最佳实践 = 代码控制流 + AI 动作(Stagehand 模式)。
📄 来源:014_Workbuddy 必装的 5 大 Skill 技能,效率翻倍! 用了半年.md
3 Workbuddy 必装的 5 大 Skill 技能,效率翻倍!用了半年
3.1 视频信息
| 项目 | 内容 |
|---|---|
| 视频名称 | Workbuddy 必装的 5 大 Skill 技能,效率翻倍!用了半年 |
| 时长 | 1 分 21 秒 |
| 来源平台 | 抖音 |
| 原始链接 | https://www.douyin.com/video/7660837015446298021 |
| 飞书妙记 | https://www.feishu.cn/minutes/obcniu2eay1g41634ybvk1j4 |
| 关键词 | WorkBuddy、Skill、Agent Browser、Local Whisper、Skill Scanner、Find Skills |
3.2 全文摘要
本视频盘点了 2026 年最值得装的 5 个 WorkBuddy 黑科技 Skill。核心观点是:不会装 Skill,AI 助手就只是个聊天工具;会装 Skill,它才能替你真正干活。 视频详细介绍了五大 Skill:Agent Browser(让 AI 自己上网,点链接、截图、翻页、挖隐藏内容)、办公文档四件套(PDF/Word/PPT/Excel 一把梭)、Local Whisper(本地语音转文字,数据不出电脑)、Skill Scanner(装 Skill 前的安全门卫,防恶意代码和泄露)、Find Skills(从 2 万多个技能里帮你挑最合适的)。强调 WorkBuddy 的灵魂不是对话,而是会干活。
3.3 原文结构化整理
3.3.1 核心理念:Skill 才是 AI 助手的灵魂
-
只用基础对话 = AI 助手只是聊天工具
-
会装 Skill = AI 才能替你真正干活
-
WorkBuddy 的灵魂不是对话,而是会干活
3.3.2 五大黑科技 Skill 详解
| 序号 | Skill 名称 | 核心能力 | 适用人群 |
|---|---|---|---|
| 1 | Agent Browser | 让 AI 自己上网,点链接、截图、翻页,连隐藏内容都能挖出来 | 数据党、研究员 |
| 2 | 办公文档四件套 | PDF、Word、PPT、Excel 一把梭,改合同、洗数据、做 PPT 模板 | 打工人 |
| 3 | Local Whisper | 本地语音转文字,数据不出电脑,开会采访录音秒变文字 | 隐私党、记者 |
| 4 | Skill Scanner | 装第三方技能前先扫一遍,防止恶意代码和数据泄露 | 所有用户(安全第一) |
| 5 | Find Skills | 从 2 万多个技能里帮你挑最合适的,说清需求就匹配,还能对比差异 | 小白用户 |
重点推荐:
-
Agent Browser:再也不用自己爬数据,AI 就能把网页翻个底朝天
-
Local Whisper:全程不上传数据,手都不用敲键盘
-
Skill Scanner:冷门但保命,安全永远是第一位
-
Find Skills:不知道装什么就用它,小白也不踩坑
3.4 完整逐字稿
以下为飞书妙记转写的完整逐字稿,带时间戳。
Speaker 1 00:00:01.570
你用了 Work Buddy 这么久,如果你还只会基础对话,那这 5 个 Skill 才是真正拉开差距的地方。这条视频给你盘点 2026 年最值得装的 5 大黑科技 Skill,装完效率直接翻倍。不会装 Skill,你的 AI 助手就只是个聊天工具,会装 Skill,它才能替你真正干活。
Speaker 1 00:00:17.410
最后一个,很多人根本没注意到,但它才是避免你踩坑的隐藏王炸。 2026 最值得装的 5 个 Skill,从上网、文档、语音到安全和发现,下面一个一个给你讲清楚。第一个, Agent Browser,让 AI 自己会上网,再也不用自己爬数据, AI 帮你点链接、截图、翻页,连隐藏内容都能挖出来,数据党狂喜。
Speaker 1 00:00:36.170
第二个办公文档四件套,PDF、Word、PPT、Excel,一把梭。扔给 AI 一句话搞定,改合同、洗数据、做 PPT 模板,打工人摸鱼神器实锤。第三个, Local Whisper,本地语音转文字,数据不出电脑,开会采访录音秒变文字,全程不上传数据,隐私党放心用,手都不用敲键盘。
Speaker 1 00:00:54.690
第四个, Skill Scanner,装 Skill 前的安全门卫,冷门但保密,装第三方技能前先扫一遍,防止恶意代码和泄露,安全第一。第五个, Find Skills,不知道装什么就用它,找 2 万多个技能里,帮你挑最合适的,说清需求就匹配,还能对比差异,小白也不踩坑。 Workbody 的灵魂不是对话,而是会干活。这 5 个 Skill 装完,你的 AI 才真的开始替你打工。我是何公子,关注我,学习更多 AI 知识。
3.5 关键截图
3.5.1 五大 Skill 总览
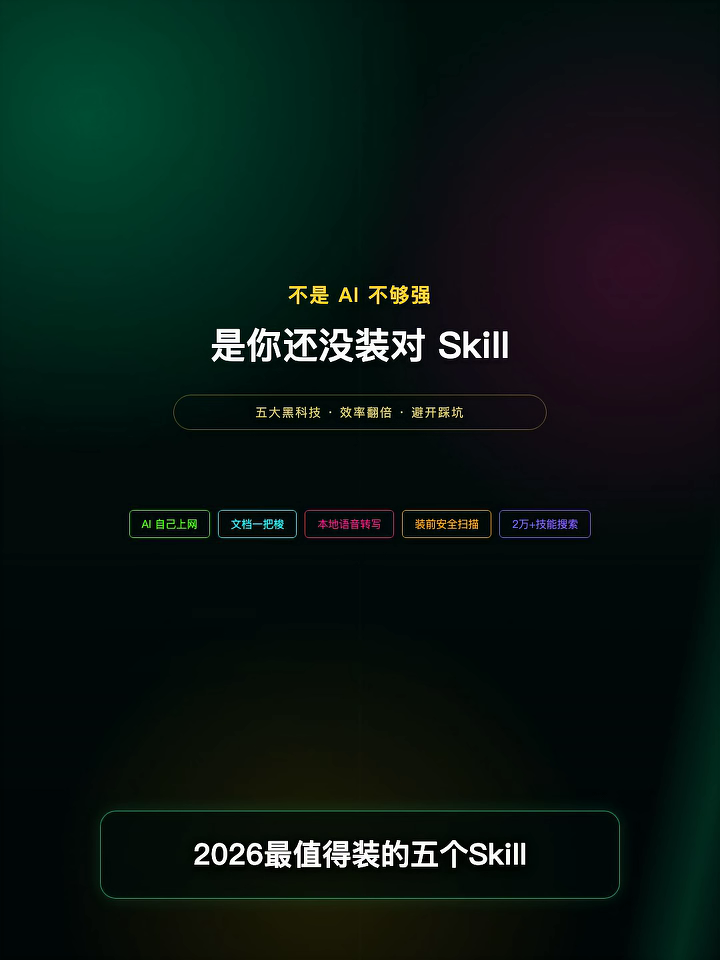
2026 最值得装的五个 Skill 总览:AI 自己上网、文档一把梭、本地语音转写、装前安全扫描、2 万 + 技能搜索。
3.5.2 Agent Browser:让 AI 自己上网
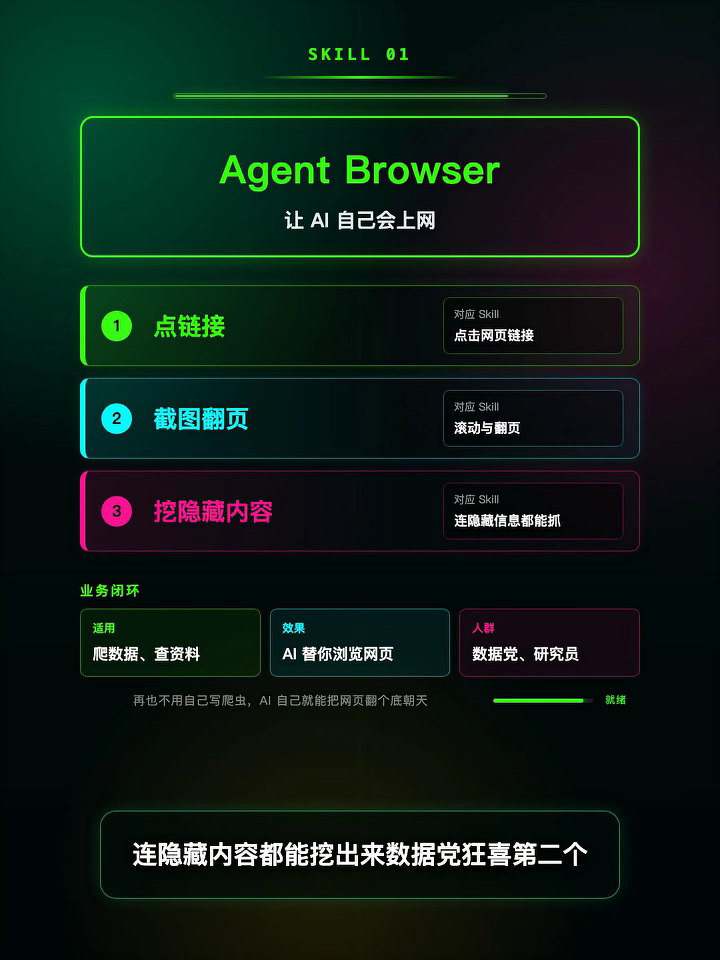
Agent Browser 三大核心能力:点链接、截图翻页、挖隐藏内容。适用爬数据、查资料场景,AI 替你浏览网页。
3.5.3 Skill Scanner:装前安全扫描
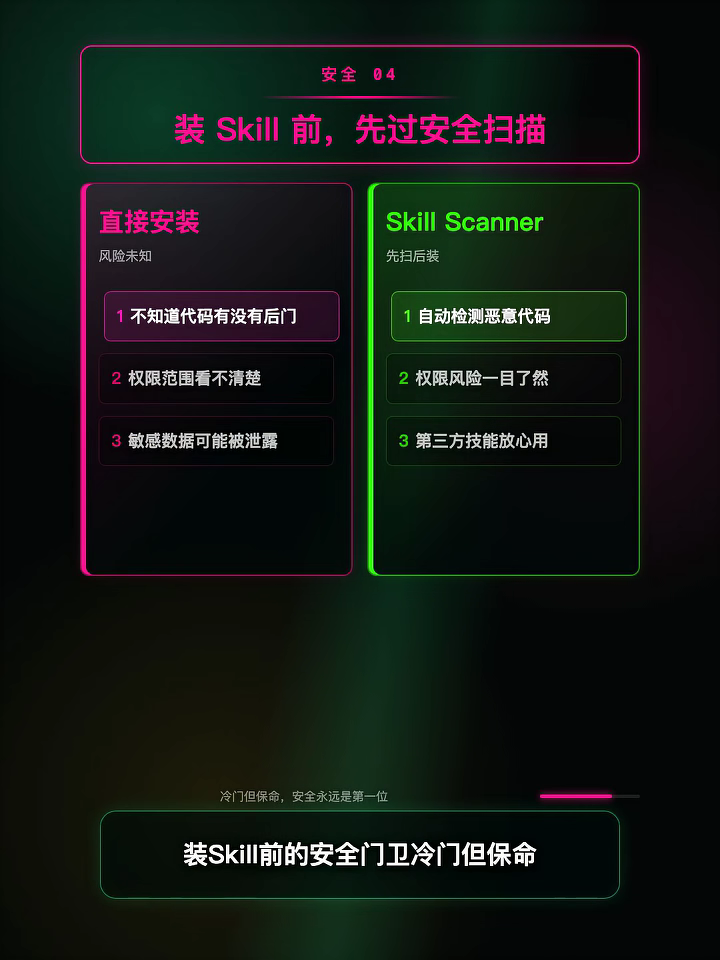
直接安装 vs Skill Scanner 先扫后装的对比:自动检测恶意代码、权限风险一目了然、第三方技能放心用。
📄 来源:018_Agent Skill 过多?4 招提升命中.md
4 Agent Skill 过多?4 招提升命中
4.1 视频信息
| 项目 | 内容 |
|---|---|
| 视频名称 | Agent Skill 过多?4 招提升命中 |
| 时长 | 2 分 37 秒 |
| 来源平台 | 抖音 |
| 原始链接 | https://www.douyin.com/video/7660837015446298021 |
| 飞书妙记 | https://www.feishu.cn/minutes/obcniu91e6g1tce54393op32 |
| 关键词 | Skill 路由、Progressive Disclosure、渐进加载、Skill 描述、Skill Tree、负样本描述、召回加重排、Embedding |
4.2 全文摘要
本视频讲解了当 Agent 的 Skill 数量从十几个涨到几十个、上百个后,如何保证 Skill 命中率的问题。核心观点是:Skill 太多以后,Skill 路由本身就变成了一个检索问题,这不是模型变笨了,而是搜索空间太大了。 视频介绍了 Anthropic 在 Agent Skills 里的核心思想 Progressive Disclosure(渐进加载)—— 先读取每个 Skill 的名称和描述,再决定要不要加载完整内容。详细讲解了四招提升命中率:第一,提高 Skill 描述的区分度(不要写 "是什么",要写 "什么时候用它",description 里要包含触发场景);第二,Skill 分层(建立 Skill Tree,先分大类再分子类,缩小搜索空间);第三,增加负样本描述(除了告诉模型什么时候用,还要告诉什么时候不要用,显著减少误触发);第四,做召回加重排(先用 Embedding 或关键词检索召回 Top10,再交给大模型做最终判断,和 RAG 思路完全一样)。
4.3 原文结构化整理
4.3.1 问题本质:Skill 路由本身就是检索问题
现象:
-
刚开始做 Agent,只有十几个 Skill,命中率挺高
-
Skill 数量涨到几十个、上百个后,模型开始抽风
-
明明有对应 Skill,却死活不用;或者用了一个看起来相关、其实完全不对的 Skill
本质:不是模型变笨了,而是 Skill 太多以后,Skill 路由本身变成了一个检索问题。
4.3.2 核心思想:Progressive Disclosure 渐进加载
Anthropic 在 Agent Skills 里的核心思想:
-
不会把所有 Skill 全部塞进上下文
-
先读取每个 Skill 的名称和描述
-
再决定要不要加载完整内容
常见优化错误:天天优化 Skill 内部 prompt,却不优化 Skill 的描述信息。
关键洞察:Skill 的 name 和 description 本质上就是向量检索里的标题和摘要。
4.3.3 四招提升命中率详解
4.3.3.1 第一招:提高 Skill 描述的区分度
错误写法:数据分析助手、通用办公工具、代码处理专家(模糊,几十个 Skill 放在一起模型根本分不清)
正确写法:不要写这个 Skill 是什么,而要写什么时候用它
-
错误:负责生成 PPT
-
正确:当用户要求制作汇报材料、融资路演、季度总结或演示文稿时使用
Anthropic 官方强调:description 里面应该包含触发场景,而不仅仅是功能介绍。因为模型路由时本质是在做语义匹配,场景描述越清晰,命中率越高。
4.3.3.2 第二招:Skill 分层
错误做法:把 100 多个 Skill 全部平铺,模型每次都要在 100 多个选项里做判断
正确做法:建立 Skill Tree
-
第一层:先分大类(研发、运营、市场、财务)
-
第二层:再分子类(代码生成、代码评审、测试生成)
-
模型先找到大类,再找到具体 Skill,搜索空间一下就缩小了
很多大型 Agent 系统都在做这种分层路由,而不是一次性全量匹配。
4.3.3.3 第三招:增加负样本描述
很多人忽略的一点:除了告诉模型什么时候用,还要告诉模型什么时候不要用。
示例:
-
仅用于生成 SQL,不适用于数据库设计和性能优化
-
仅用于前端代码生成,不负责后端接口开发
社区里很多高质量 Skill 都开始增加 when not to use 这一部分,因为它能显著减少误触发。
4.3.3.4 第四招:做召回加重排
不要让大模型直接从几百个 Skill 里选:
-
先用 Embedding 或关键词检索 召回 Top10
-
再交给大模型做最终判断
这和 RAG 的思路完全一样。实际上,当 Skill 数量达到几百上千以后,Skill Router 本身就已经变成了一个检索系统。很多研究工作甚至专门训练 Skill Router 来解决这个问题。
4.4 完整逐字稿
以下为飞书妙记转写的完整逐字稿,带时间戳。
Speaker 1 00:00:00.340
面试官问你, skill 过多如何保证 agent 的命中率?你会怎么回答?刚开始做 agent 的时候,只有十几个 skill,命中率还挺高。但当 skill 数量涨到几十个、上百个以后,模型开始抽风了,明明有对应 skill,却死活不用,或者用了一个看起来相关,其实完全不对的 skill。这其实不是模型变笨了,而是 skill 太多以后, skill 路由本身变成了一个检索问题。
Speaker 1 00:00:21.500
我是小哲,点赞收藏加关注,我们马上开始,更多内容可以查看橱窗。先说 Anthropic 在 agent skills 里的一个核心思想,叫 progressive disclosure,也就是渐进加载。 Claude 不会把所有 skill 全部塞进上下文,而是先读取每个 skill 的名称和描述,再决定要不要加载完整内容。所以很多人优化错了方向,他们天天优化 skill 内部 prompt,却不优化 skill 的描述信息。
Speaker 1 00:00:44.630
实际上, skill 的 name 和 description 本质上就是向量检索里的标题和摘要。如果这里写的模糊,比如数据分析助手、通用办公工具、代码处理专家,那几十个 skill 放在一起,模型根本分不清谁是谁。第一个提高命中率的方法就是提高 skill 描述的区分度,不要写这个 skill 是什么,而要写什么时候用它。比如不要写负责生成 PPT,而应该写当用户要求制作汇报材料、融资路演、季度总结或演示文稿时使用。 Anthropic 官方也特别强调, description 里面应该包含触发场景,而不仅仅是功能介绍。因为模型路由的时候,本质是在做语义匹配,场景描述越清晰,命中率越高。
Speaker 1 00:01:25.250
第二个方法是 skill 分层,很多团队会把 100 多个 skill 全部平铺,结果模型每次都要在 100 多个选项里做判断。更好的做法是建立 skill tree,第一层先分大类,研发、运营、市场、财务。第二层再分子类,代码生成、代码评审、测试生成。这样模型先找到大类,再找到具体 skill,搜索空间一下就缩小了。很多大型 agent 系统其实都在做这种分层路由,而不是一次性全量匹配。
Speaker 1 00:01:52.560
第三个方法是增加负样本描述,这是很多人忽略的一点,除了告诉模型什么时候用。还要告诉模型什么时候不要用。例如,仅用于生成 SQL,不适用于数据库设计和性能优化,仅用于前端代码生成,不负责后端接口开发。社区里很多高质量 SQL 都开始增加 when not to use 这一部分,因为它能显著减少误触发。
Speaker 1 00:02:14.010
第四个方法是做召回加重排,不要让大模型直接从几百个 skill 里选,先用 embedding 或关键词检索召回 top10,再交给大模型做最终判断。这和 RAG 的思路完全一样。实际上,当 skill 数量达到几百上千以后, skill router 本身就已经变成了一个检索系统。很多研究工作甚至专门训练 skill router 来解决这个问题。本期视频我们就讲到这里,下期再见,拜了个拜。
4.5 关键截图
4.5.1 优化方向对比:Name & Description 才是核心关键
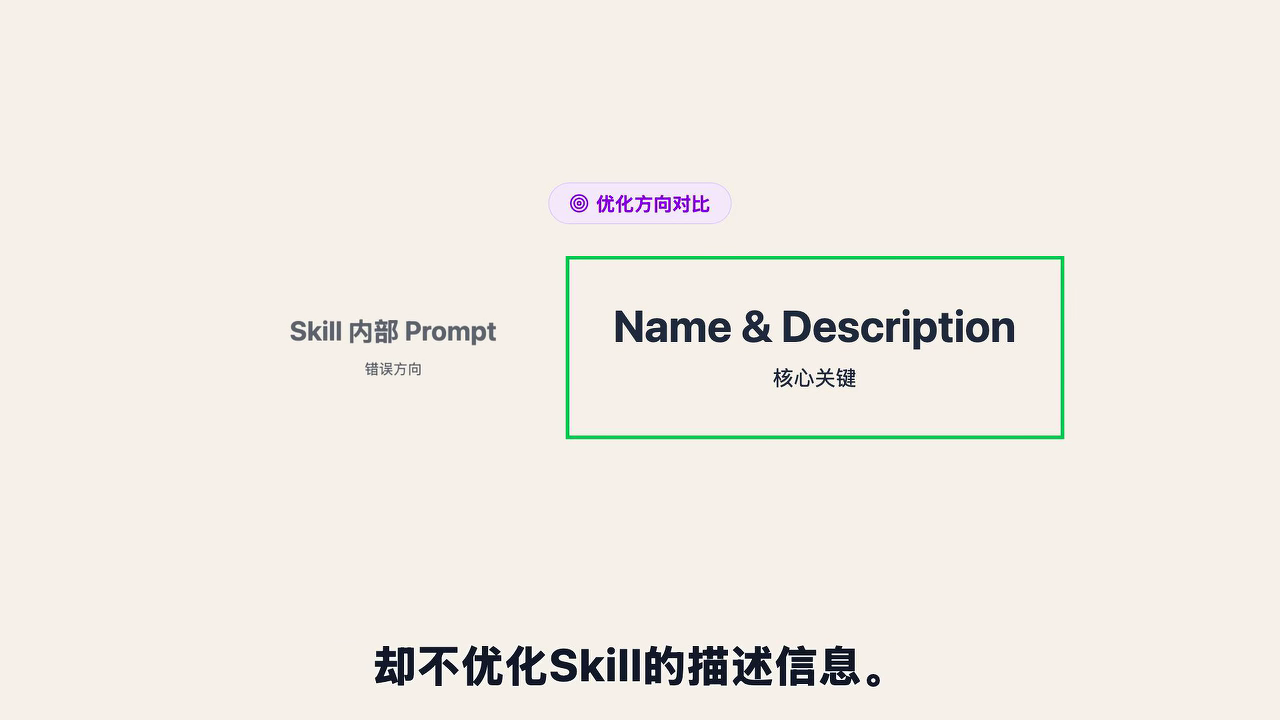
很多人优化错了方向:天天优化 Skill 内部 Prompt(错误方向),而真正的核心关键是优化 Name & Description—— 它本质上就是向量检索里的标题和摘要。
4.5.2 100+ Skills 全部平铺导致 LLM 决策困难
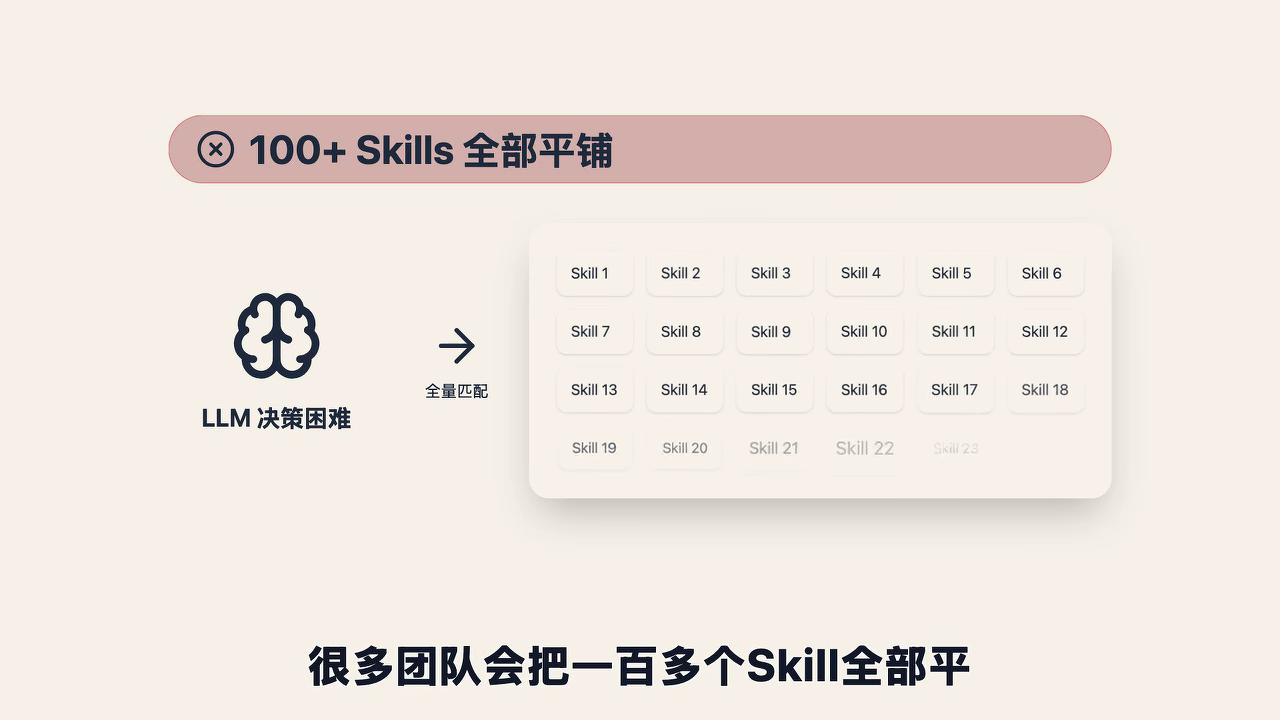
常见错误做法:把 100 多个 Skill 全部平铺,LLM 需要全量匹配,决策困难。正确做法是建立 Skill Tree 分层路由,缩小搜索空间。
4.5.3 分层路由核心优势
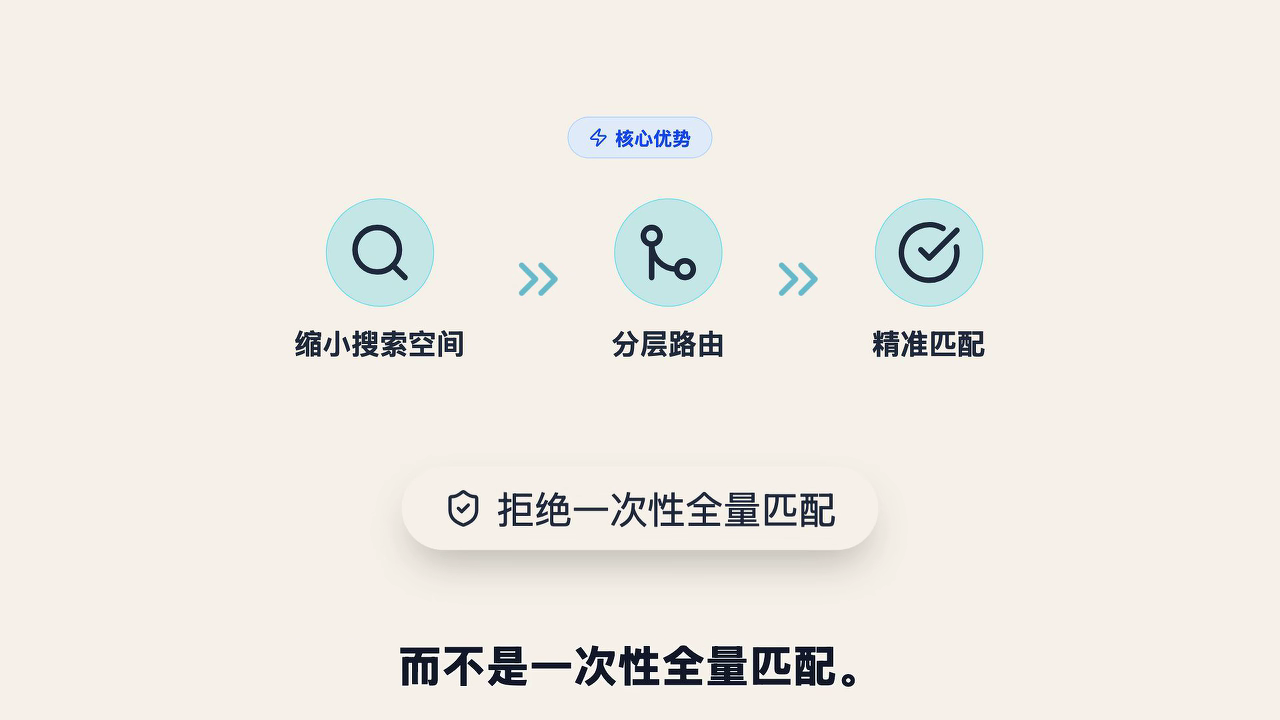
分层路由的核心优势:缩小搜索空间 → 分层路由 → 精准匹配,拒绝一次性全量匹配。
📄 来源:031_手把手教你创建 Skills-- 全流程,小白一看就懂!.md
5 手把手教你创建 Skills—— 全流程,小白一看就懂!
5.1 视频信息
| 项目 | 内容 |
|---|---|
| 视频名称 | 手把手教你创建 Skills—— 全流程,小白一看就懂! |
| 时长 | 2 分 11 秒 |
| 来源平台 | 抖音 |
| 原始链接 | https://www.douyin.com/video/7670865178824576291 |
| 飞书妙记 | https://www.feishu.cn/minutes/obcnh5p881t1pqgjqr8x4lq6 |
| 关键词 | Skills、创建流程、目录结构、SKILL.md、需求分析 |
5.2 全文摘要
本视频讲解了 Skills 创建的完整流程,分为两大核心阶段:前期规划和落地创建。前期规划包括目标定义(功能描述、适用场景、预期输出、限制条件四个关键点)和需求分析(用户需求、技术需求、性能需求、兼容性需求四个维度)。落地创建包括搭建标准目录结构(mkdir+cd+tree 命令)和核心文件编写(SKILL.md 为核心,可选 scripts、references、assets 文件夹,附 License 文件)。
5.3 原文结构化整理
5.3.1 两大核心阶段
Skills 创建流程主要分为两大核心阶段:
-
第一阶段:前期规划
-
第二阶段:落地创建
5.3.2 第一阶段:前期规划
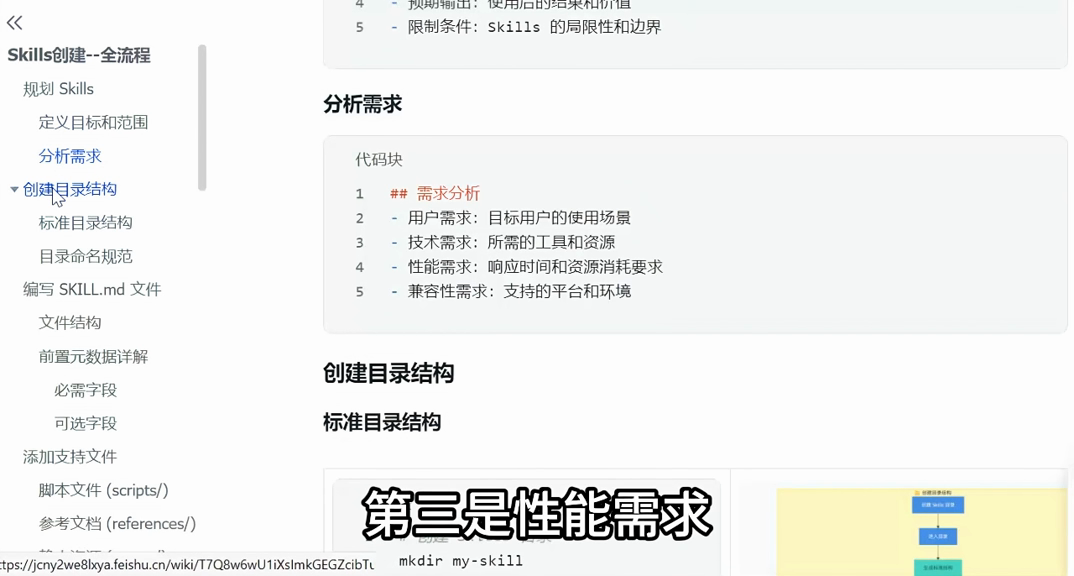
正式动手做 Skills 之前,一定要先做好规划,核心就是两件事:定义目标和范围、全面分析需求。
5.3.2.1 目标定义(四个关键点不能漏)
| 关键点 | 说明 |
|---|---|
| 功能描述 | 说清楚这个 Skills 具体要解决什么问题 |
| 适用场景 | 明确在什么情况下使用它 |
| 预期输出 | 敲定使用之后能拿到什么结果,创造什么价值 |
| 限制条件 | 梳理出这个 Skills 存在哪些局限和使用边界,提前规避问题 |
5.3.2.2 需求分析(四个维度)
| 维度 | 说明 |
|---|---|
| 用户需求 | 梳理目标用户的真实使用场景 |
| 技术需求 | 提前准备好制作需要用到的工具和各类资源 |
| 性能需求 | 明确响应时长、资源消耗这类硬性标准 |
| 兼容性需求 | 确定这个 Skills 能够支持的平台和运行环境 |
5.3.3 第二阶段:落地创建
5.3.3.1 第一步:搭建标准目录结构
实操命令:
mkdir my-skill    # 创建专属的Skills文件夹

cd my-skill       # 进入这个目录

tree -a           # 查看完整的标准目录结构
建好目录后,一定要核对命名规范,保证格式统一。
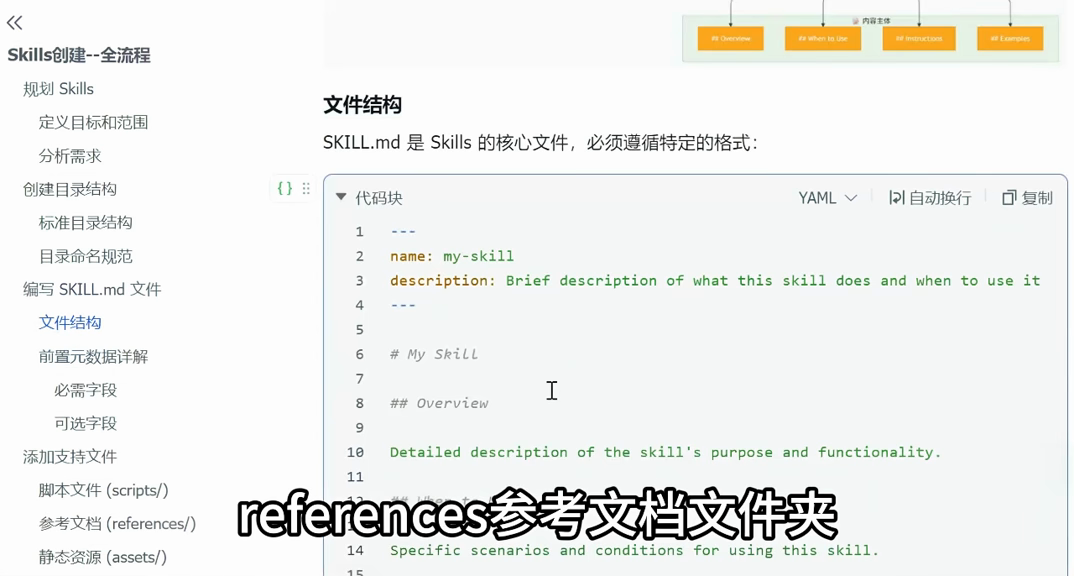
5.3.3.2 第二步:核心文件编写
一个完整合规的 Skills 目录必须包含:
| 文件 / 文件夹 | 说明 | 必要性 |
|---|---|---|
| SKILL.md | 整个 Skills 的核心文件,至关重要 | 必需 |
| scripts/ | 脚本文件夹 | 可选 |
| references/ | 参考文档文件夹 | 可选 |
| assets/ | 静态资源文件夹 | 可选 |
| LICENSE | 许可证文件 | 建议 |
5.4 完整逐字稿
以下为飞书妙记转写的完整逐字稿,带时间戳。
Speaker 1 00:00:00
哈喽,大家好!今天带大家完整走一遍 Skills 创建全流程,内容清晰,步骤标准,零基础也能跟着上手。整个创建流程主要分为两大核心阶段,第一阶段是前期规划,第二阶段是落地创建。我们先从规划环节说起,在正式动手做 Skills 之前,一定要先做好规划,核心就是两件事,定义目标和范围,全面分析需求。首先来看目标定义,这里有四个关键点不能漏掉。第一是功能描述,说清楚这个 Skills 具体要解决什么问题。第二是适用场景,明确我们在什么情况下使用它。第三是预期输出。敲定使用之后能拿到什么结果,创造什么价值。最后是限制条件,梳理出这个 Skills 存在哪些局限和使用边界,提前规避问题。
Speaker 1 00:00:46
定好目标后,接下来开展需求分析,一共分为四个维度。第一是用户需求,梳理目标用户的真实使用场景。第二是技术需求,提前准备好制作需要用到的工具和各类资源。第三是性能需求,明确响应时长、资源消耗这类硬性标准。第四是兼容新需求,确定这个 Skills 能够支持的平台和运行环境。把这些需求全部梳理完毕,前期规划就完成了。
Speaker 1 00:01:12
规划结束,我们就进入第二阶段,正式创建 Skills。第一步就是搭建标准的目录结构,操作非常简单,我给大家讲一下实操命令。首先打开终端,输入 MKDIR my Skill,创建专属的 Skills 文件夹。接着用 CD my Skill 命令进入这个目录,最后执行 Tree - a,就能查看完整的标准目录结构。建好目录之后,大家一定要核对命名规范,保证格式统一。一个完整合规的 Skills 目录必须包含这些核心内。
Speaker 1 00:01:41
内容,首先是 skill MD,这是整个 Skills 的核心文件,至关重要。其次是可选的 Scripts 脚本文件夹、References 参考文档文件夹、Assets 静态资源文件夹。最后还要附上 License 许可证文件。以上就是从前期规划、需求分析到目录搭建、规范核验的全套 Skills 创建流程。按照这个步骤一步步操作,就能规范高效的完成 Skills 创建了。
5.5 关键截图
5.5.1 前期规划:目标定义
5.5.2 创建目录结构
5.5.3 核心文件与规范
📄 来源:045_NA - Superdesign tutorial - Create first design.md
6 Superdesign Tutorial - Create First Design
6.1 视频信息
| 项目 | 内容 |
|---|---|
| 视频名称 | NA - Superdesign tutorial - Create first design |
| 时长 | 1 分 48 秒 |
| 来源平台 | 抖音 |
| 原始链接 | https://www.douyin.com/video/7657890123456789012 |
| 飞书妙记 | https://www.feishu.cn/minutes/obcnh5d34o4hwt14n43pl8b3 |
| 关键词 | Superdesign、AI 设计、Web 应用设计、Prompt 设计、Plan 模式、品牌资产 |
6.2 全文摘要
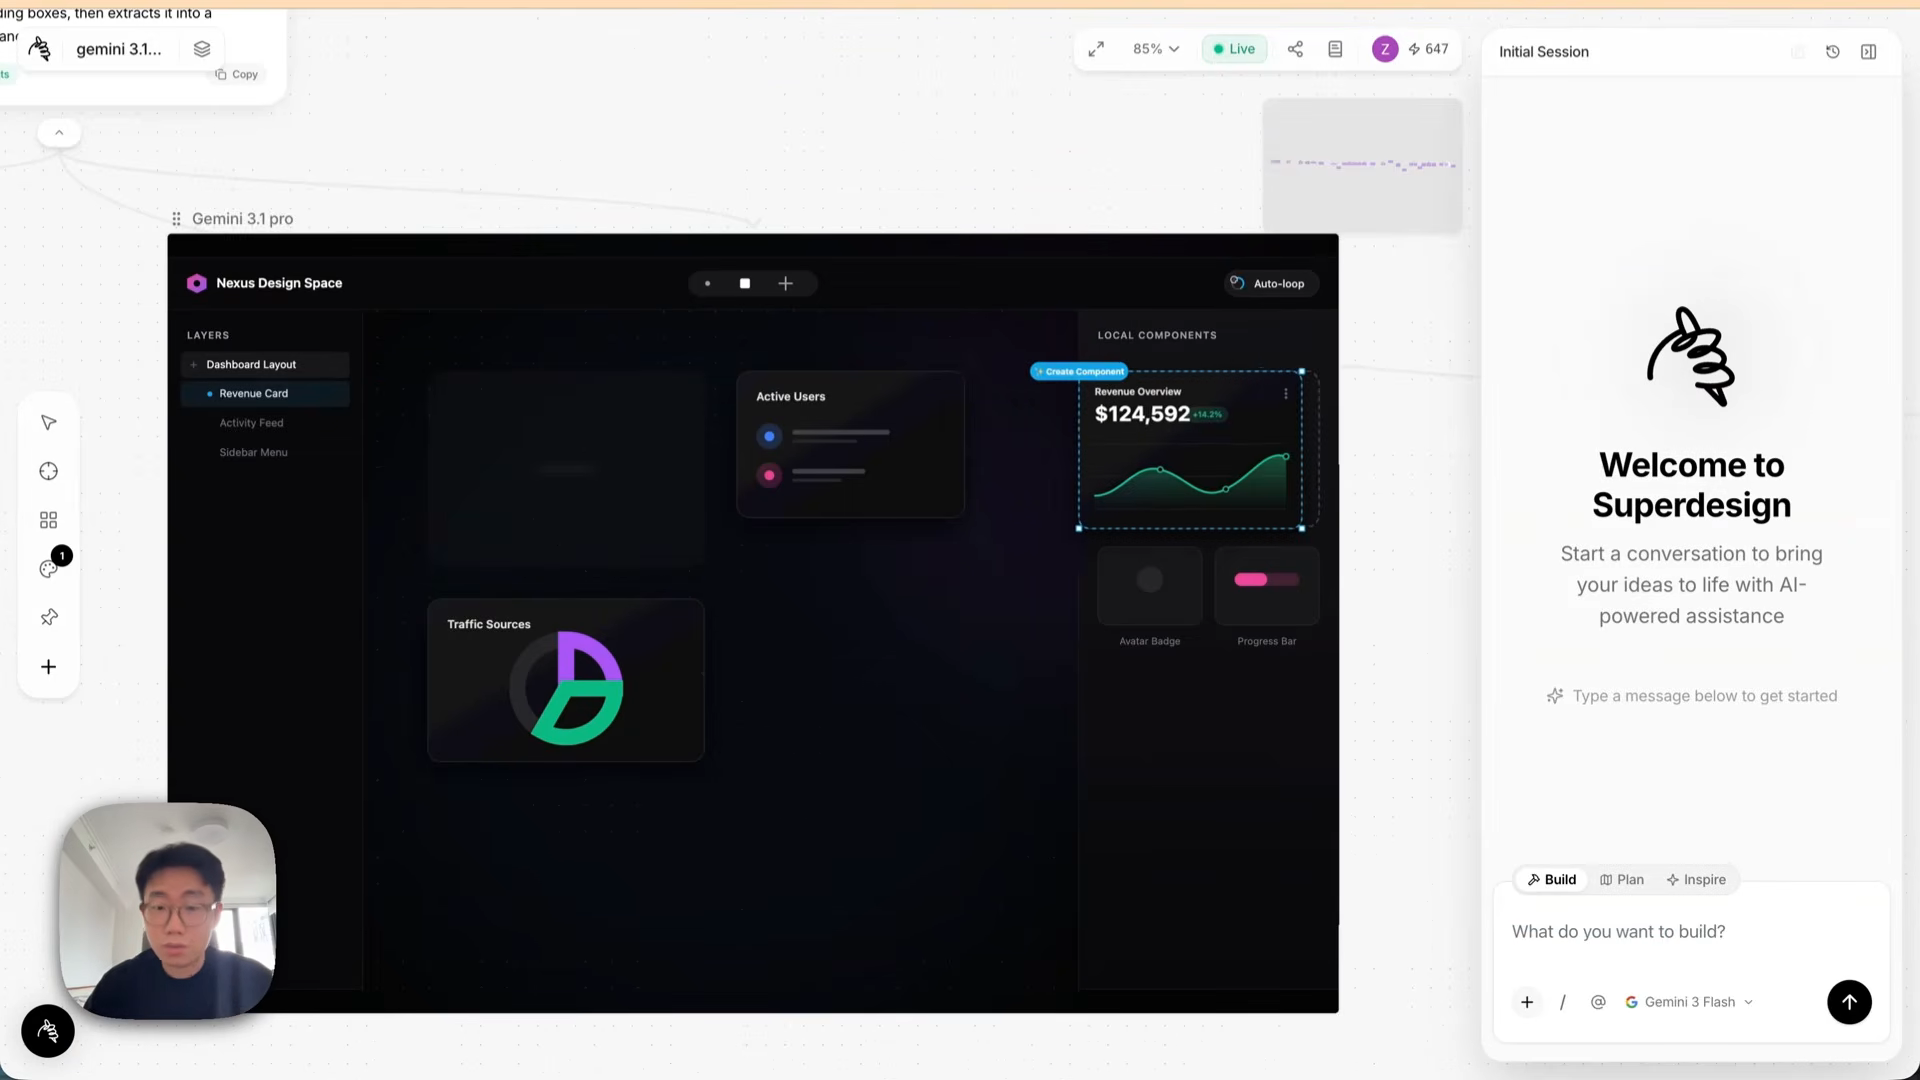
本视频是 Superdesign(AI 设计工具)的入门教程,演示如何创建第一个设计。Superdesign 可以设计移动或 Web 应用、落地页、电商网站甚至动画。创建设计有三种方式:Web 平台直接创建、安装 Claude Code/Cursor Skill 在现有 UI 上生成、浏览器扩展抓取现有网站或产品 UI。Web 平台输入 Prompt(如 "help me design a travel app")即可创建项目,Prompt 模糊时会自动提问澄清,还会联网搜索设计灵感(集成 Moban 和 Dribbble)。支持上传品牌资产(Logo、字体),有 Prompt Library 库可浏览他人设计,还有 Plan 模式帮助思考设计权衡并形成设计计划。
6.3 原文结构化整理
6.3.1 Superdesign 能做什么
-
设计移动或 Web 应用
-
设计精美的落地页(landing pages)
-
电商网站
-
甚至可以包含动画,用于网站或演示
6.3.2 三种创建设计的方式
| 方式 | 说明 |
|---|---|
| 1. Web 平台 | 直接在 Superdesign 网站上创建设计 |
| 2. Claude Code / Cursor Skill | 安装 Skill,让 Claude Code 或 Cursor 在现有 UI 基础上生成精美设计 |
| 3. 浏览器扩展 | 抓取现有网站或产品 UI 到 Superdesign,让 Agent 基于真实 UI 开始迭代 |
6.3.3 Web 平台创建设计流程
-
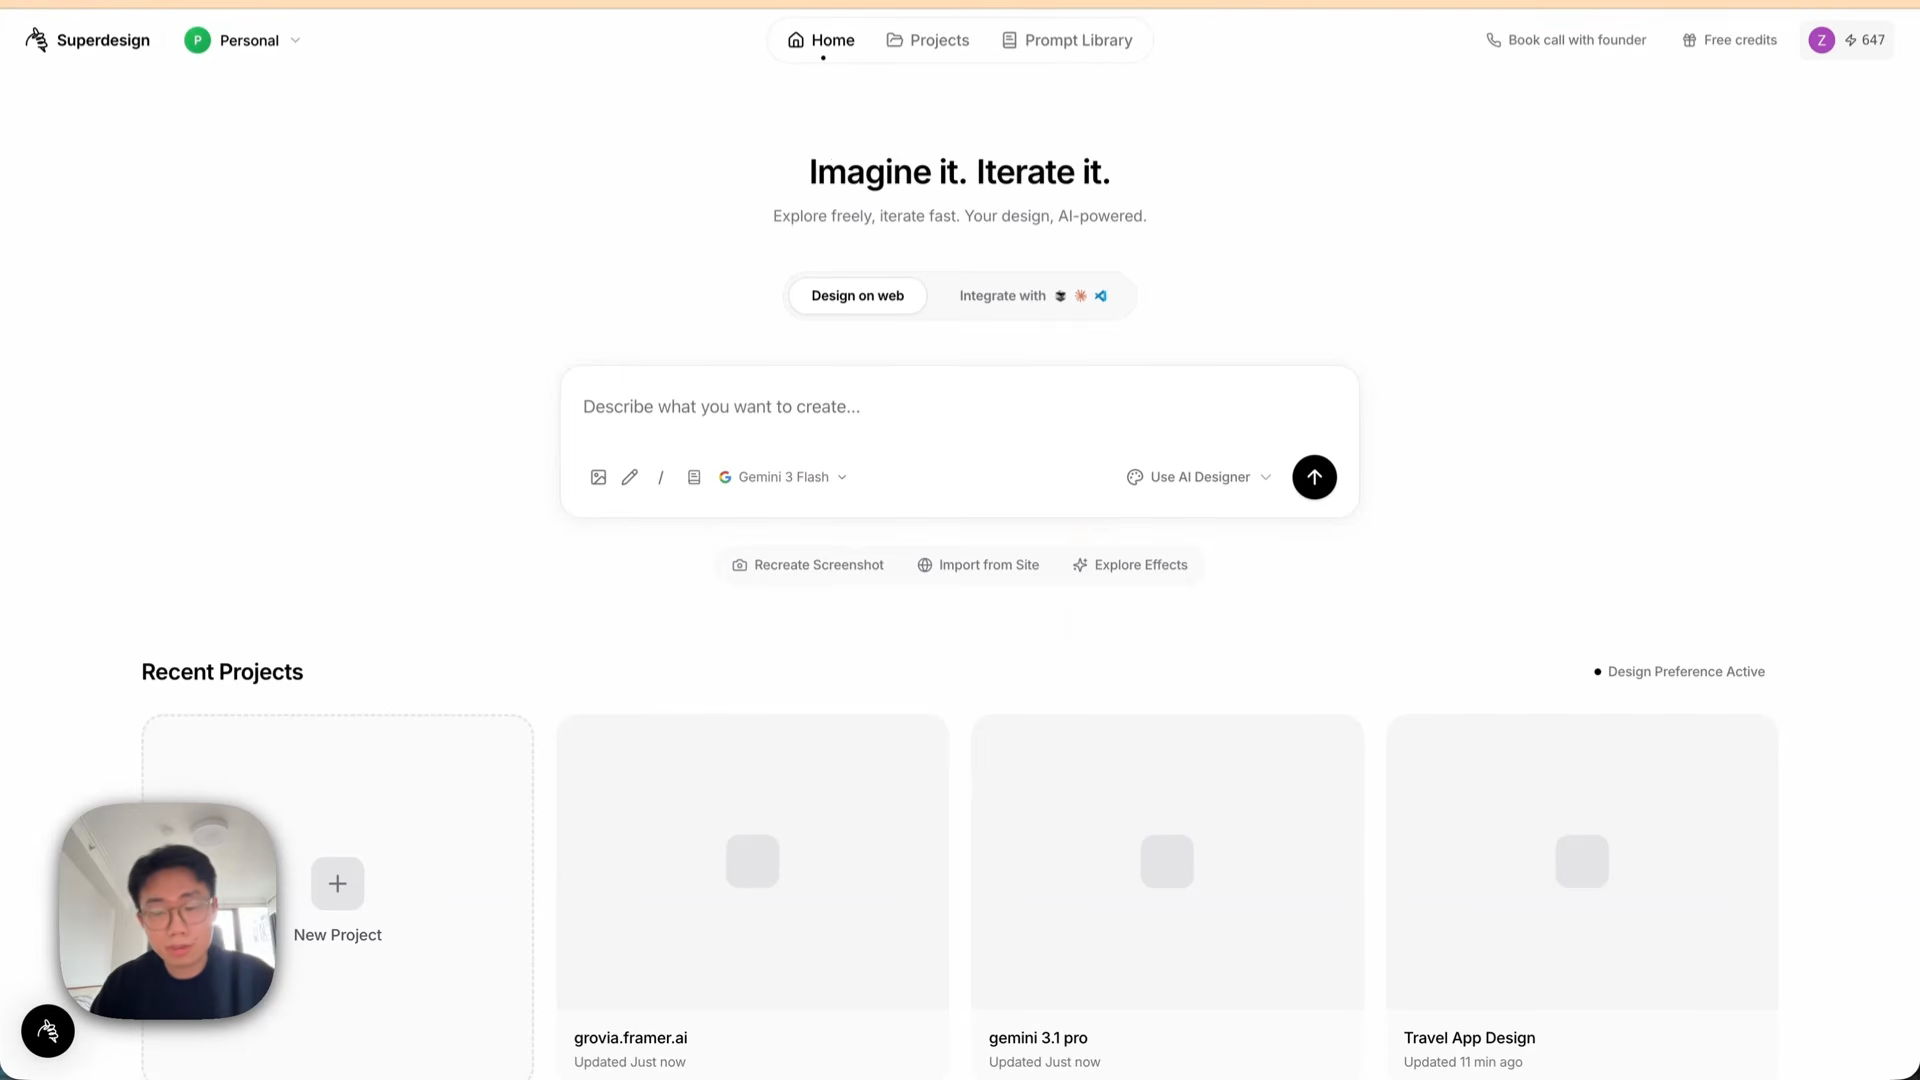
输入 Prompt:如 "help me design a travel app",点击回车创建新项目
-
自动澄清:如果 Prompt 模糊,会自动提问澄清问题,简单回答提交即可
-
联网搜索灵感:有时会自动联网搜索相关设计灵感
-
集成设计平台:直接集成 Moban 和 Dribbble,可以选择更符合需求的设计参考
-
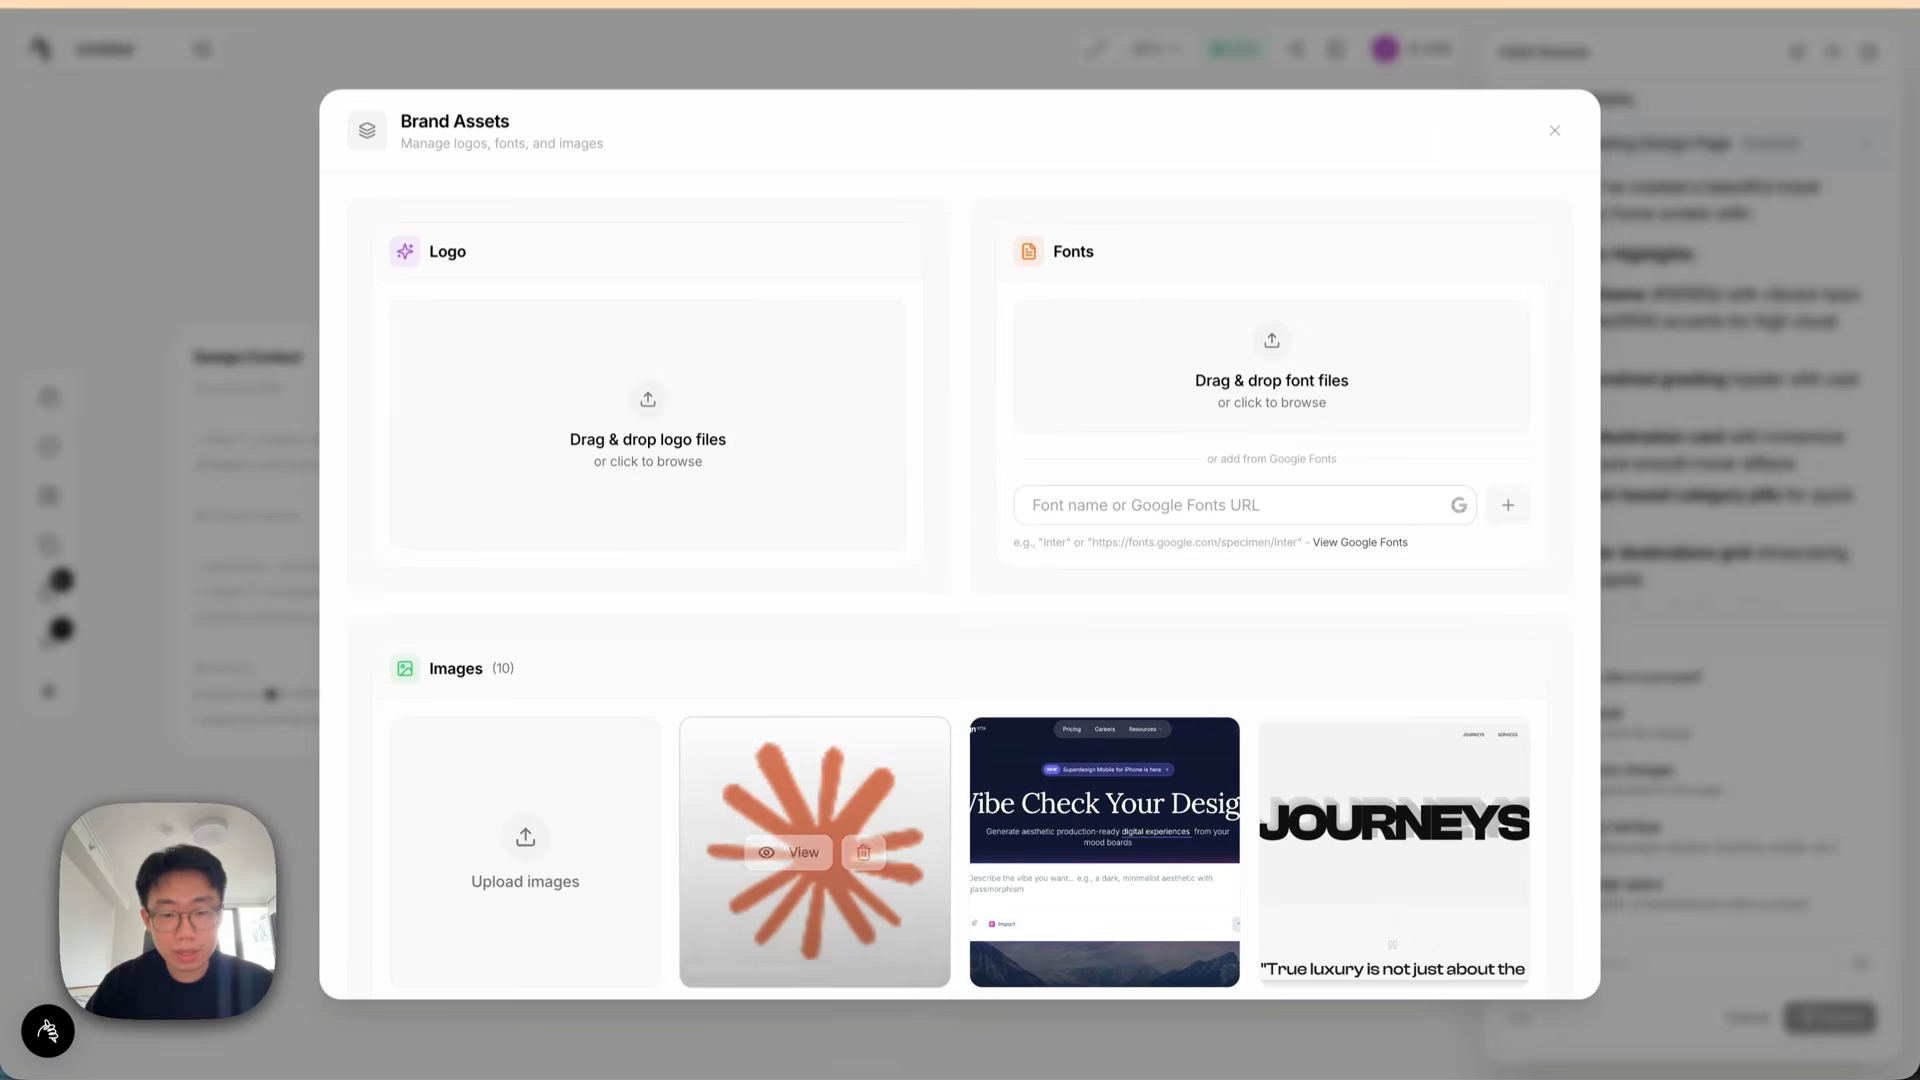
品牌资产优先:Agent 会优先使用用户上传的品牌资产(图片、Logo、字体)
6.3.4 Prompt Library 与灵感
-
Prompt Library 标签页可以浏览其他人的设计
-
涵盖不同风格、动画、UI 组件
-
每个设计可以点击 "Use Prompt" 按钮复制完整 Prompt,或只复制风格 / 布局
6.3.5 Plan 模式
-
可以看作是 "头脑风暴模式"(brainstorm mode)
-
帮助来回思考所有设计权衡和选项
-
最终形成一份正式的设计计划(design plan)
-
设计定稿后,可以分支创建不同版本,或深入生成页面其余部分
6.4 完整逐字稿
以下为飞书妙记转写的完整逐字稿,带时间戳。(英文原文)
Speaker 1 00:00:00
Welcome to Super Design. You can use Super Design to design mobile or web applications, stunning landing pages, e commerce sites, or even animations they can include in your websites or demos.
Speaker 1 00:00:10
And let's firstly create design. There's three ways you can create design. 1, you can just start creating design on our web platform, or you can watch this tutorial to install the cloud code or cursor skills. They allow cloud code or cursor to generate stunning design on top of your existing UI. And third, we also have this. Prom extension that allow you to grab existing website or product UI into super design. So you can get agent to start iterating on the real UI. But to get it started, let's try with web. I can give a prompt like, help me design a travel app and click enter. This will create a new project. And if your prompt is vague, it will start asking you some clarification questions. You can just simply answer and submit your answers. And sometimes it will also search across internet to find relevant design inspirations. And we have direct integration with MOBAN and dribbles. So you can choose the one that more align with what you want and submit here you can see that it is using some images and those images are brand assets that I uploaded here. So agent will prioritize using those brand assets I specific upload and you can upload your logo and fonts as well if you want to get some inspirations, there are also a prompt library tabs where you can click to browse through design from others. Across different styles, animations, and UI components. And for each one you want, you can just click on this use prompt button to copy the full prompt, or you can copy just the style or the layout. You can also use this plan mode, which we can consider as bring style mode that can back and forth help you think through all the design trade offs and options and in the end, formalize a design plan. And what's really interesting next is we have this capability for you to branch out different versions or go deep to generate the rest of page once you have finalized design, which I will talk about next.
6.5 关键截图
6.5.1 Superdesign 首页
6.5.2 创建设计:输入 Prompt
6.5.3 Plan 模式与设计权衡
📄 来源:066_AI 必装的 10 个插件.md
7 AI 必装的 10 个插件
7.1 视频信息
| 项目 | 内容 |
|---|---|
| 视频名称 | AI 必装的 10 个插件 |
| 时长 | 5 分 25 秒 |
| 来源平台 | 抖音 |
| 原始链接 | https://www.douyin.com/video/7678901234567890123 |
| 飞书妙记 | https://www.feishu.cn/minutes/obcnh6fx8s4w94u775t2z6b2 |
| 关键词 | AI 插件、Gorm、GitHub、ComputeUse、UserWebApps、Figma、Documents、Presentations、AI for Sheets、Hyperframes、Remotion |
7.2 全文摘要
本视频介绍了 AI 必装的 10 个插件,覆盖从开发到设计到办公到数据分析的全流程。包括:Gorm(让 AI 直接操作浏览器,做 SEO 分析、竞价投放监控、网页调试、数据抓取)、GitHub(代码仓库管理协作,PR 管理、代码审查、问题跟踪,从需求到部署全流程协同)、ComputeUse(让 AI 直接控制电脑,自动点击输入打开应用,7×24 小时工作,适合自动化办公和批量任务)、UserWebApps(一句话生成完整网页应用,前后端数据库一次性搞定,快速搭 MVP、电商网站、内部工具)、Figma(设计稿直接变代码,读取 Figma 设计稿生成组件页面和前端代码,缩短设计到开发交付流程)、Documents(AI 帮写编辑美化文档,PRD、方案书、周报月报、项目文档)、Presentations(AI 生成高质量 PPT,自动排版设计美化、数据可视化、一键导出)、AI for Excel/Sheets(AI 数据分析师,自动分析数据生成图表报表,把复杂数据变成可执行结论)、Hyperframes(网页直接转视频,把 HTML 通过智能渲染导出 MP4,生成产品演示教程宣传片)、Remotion(通过代码生成视频,自动制作动态图表数据视频,适合规模化视频生产和 AI 内容工厂)。
7.3 原文结构化整理
7.3.1 Gorm—— 让 AI 拥有浏览器能力
-
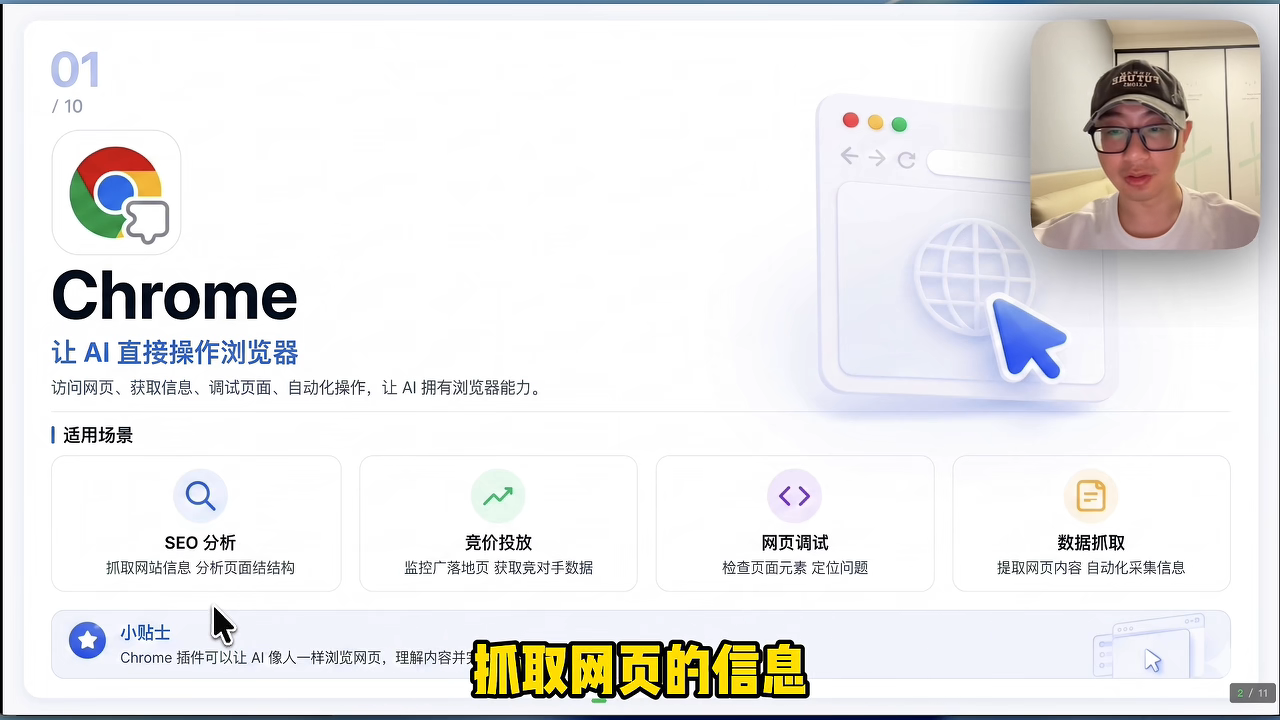
功能:让 AI 直接操作浏览器,访问网页,获取信息,调取页面自动化操作
-
适用场景:
-
SEO 分析:关键词分析、抓取网页信息、分析页面结构
-
竞价投放:监控广告落地页、获取竞争对手数据
-
网页调试:设计验收、检查页面元素定位问题
-
数据抓取:提取网页内容、自动化采集信息
-
特点:让 AI 像人一样浏览网页,理解内容并完成各种操作
7.3.2 GitHub—— 代码仓库管理与协作
-
功能:让 AI 连接 GitHub,帮助管理代码仓库,创建 PR,运行代码审查与问题跟踪
-
包含:
-
PR 管理:自动创建、更新、合并 pull request
-
代码审查、问题跟踪
-
团队协作
-
价值:AI 可以从需求分析→代码实现→测试→部署上线全流程协同,加速整个开发周期
7.3.3 ComputeUse—— 让 AI 拥有双手操作电脑
-
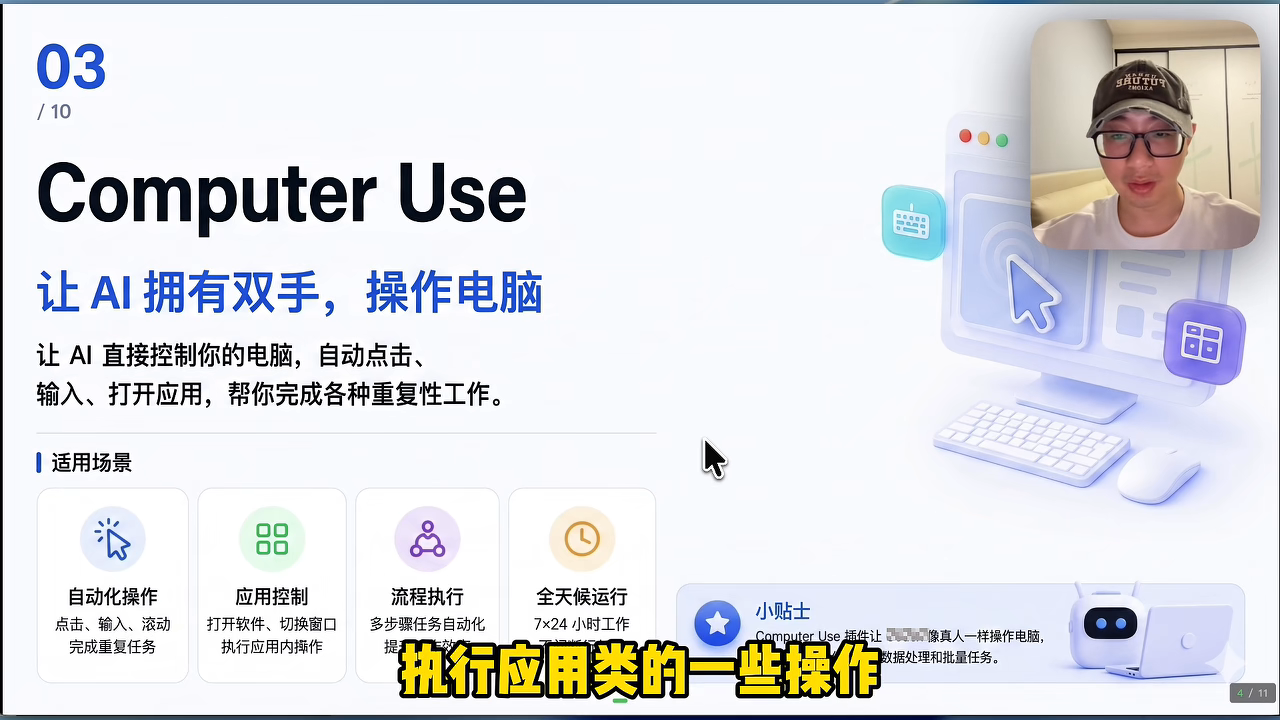
功能:让 AI 直接控制计算机,自动点击、输入、打开应用,完成各种重复性工作
-
适用场景:
-
自动化操作:点击、输入、滚动,完成各种重复性任务
-
应用控制:打开软件、切换窗口、执行应用内操作
-
自动化提升工作效率
-
全天候运行:7×24 小时工作
-
特点:让 AI 像真人一样操作电脑,特别适合自动化办公、数据处理和批量任务
7.3.4 UserWebApps—— 一句话生成完整网页应用
-
功能:一句话生成可以运行的网页应用,前端、后端、数据库一次性搞定
-
适用场景:
-
SaaS 应用:快速搭建 MVP,验证产品想法
-
电商网站:MVP 版本,包含商品展示、购物车、支付流程一键生成
-
内部工具:公司内部管理系统、数据看板、工作流应用快速落地
-
全栈应用:前后端包括数据库完整项目结构
-
特点:描述需求,AI 自动选择合适技术栈,生成可运行可部署的完整应用,支持本地运行和一键部署
7.3.5 Figma—— 设计稿直接变代码
-
功能:让 AI 直接读取 Figma 设计稿,生成组件、页面以及前端代码
-
适用场景:UI 设计、产品原型、design system、前端开发
-
价值:产品设计已在 Figma 中完成完整设计稿,减少设计与开发之间的沟通成本,缩短设计到开发的交付流程
7.3.6 Documents——AI 文档撰写编辑美化
-
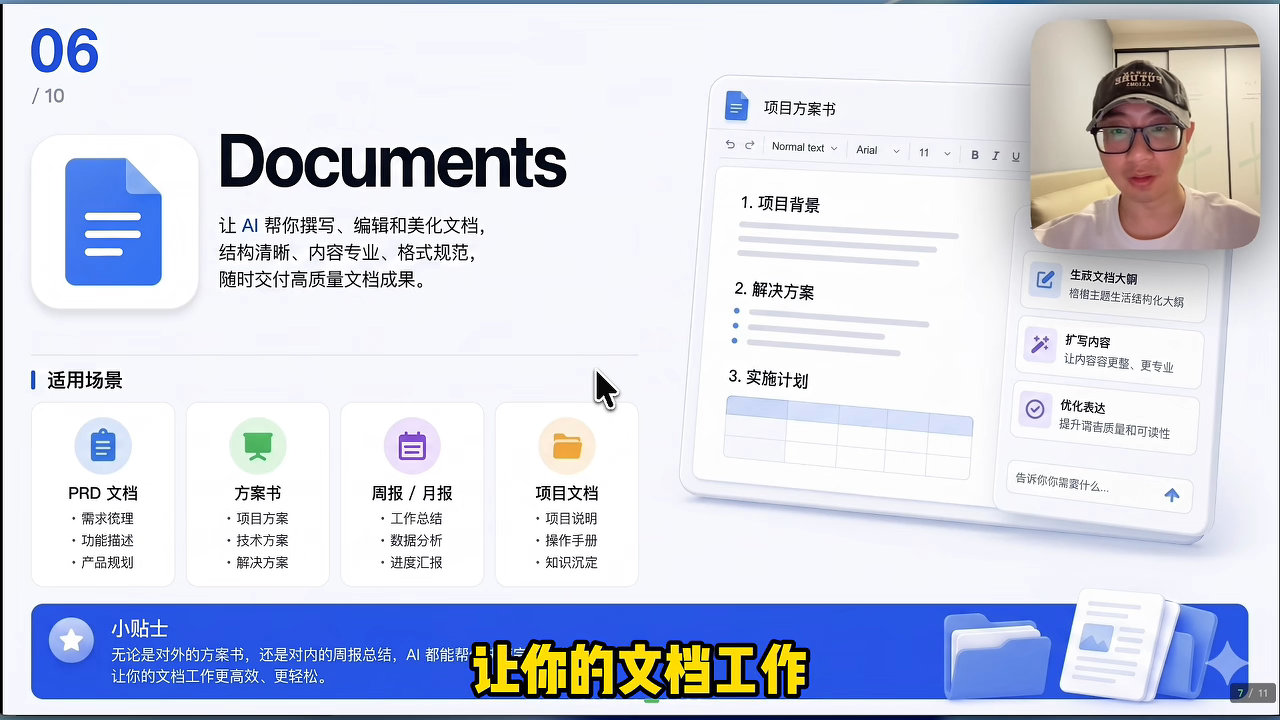
功能:让 AI 帮你撰写、编辑、美化文档,结构清晰、内容专业、格式规范
-
适用场景:
-
PRD 撰写、方案书撰写
-
周报月报撰写
-
项目文档说明、操作手册知识沉淀
-
特点:无论对外方案书还是对内周报总结,AI 都能快速完成专业文档排版撰写
7.3.7 Presentations——AI 生成高质量 PPT
-
功能:AI 直接帮你生成演示文稿,自动排版、设计美化
-
适用场景:
-
快速生成 PPT
-
智能排版设计
-
数据可视化:生成好看的图表
-
一键导出分享
-
特点:越详细的主题描述,生成的 PPT 质量越高;可以指定不同风格、目标用户、生成页数
7.3.8 AI for Excel/Sheets——AI 数据分析师
-
功能:让 AI 自动分析数据,生成图表报表,把复杂数据变成可执行的结论
-
包含:数据分析、图表生成、报表输出、AI 洞察、生成结果
-
特点:不只是 Excel,更像一个强大的 AI 数据分析师
7.3.9 Hyperframes—— 网页直接转视频
-
功能:把网页的 HTML 通过内部智能渲染直接导出成 MP4 视频
-
适用场景:
-
产品展示
-
教程制作
-
营销宣传素材
-
社区内容宣发
-
特点:让任何网页转成高质量视频,轻松生成产品演示、教程以及宣传片
7.3.10 Remotion——AI 程序化视频生成
-
功能:通过代码直接生成视频,自动制作动态图表、数据视频或批量内容生产
-
执行流程:编写代码 → 渲染预览 → 导出视频
-
适用场景:
-
数据视频
-
批量生成 AI 内容生产
-
自动化工作流导出
-
特点:每天需要生成大量相似内容视频时,比传统剪辑软件好用很多;适合自动化生产,特别适合数据视频和 AI 内容工厂;AI 生成脚本分镜后可实现一键式全流程自动渲染
把这 10 个插件全部跑通,整个工作将会实现一个质的飞跃。
7.4 完整逐字稿
以下为飞书妙记转写的完整逐字稿,带时间戳。
Speaker 1 00:00:00
大家好,我是阿伦,这一期给大家讲一下 AI 必装的 10 个插件,它覆盖到从开发到设计到办公到数据分析等等各方面的工作的一个全流程的合作伙伴。
Speaker 1 00:00:20
第一个插件是 Gorm 插件,就是它可以让 AI 直接操作浏览器,访问网页,获取信息,调取页面自动化的一些操作,让 AI 拥有浏览器一样的能力。适用于 SEO 分析、竞价投放监控、网页调试、数据抓取。这个插件可以让 AI 像人一样浏览网页,理解内容并完成各种操作。
Speaker 1 00:00:51
第二个插件就是 GitHub,是代码仓库的管理与协作,让 AI 连接 GitHub,帮助管理代码仓库,创建 PR 运行代码审查与问题跟踪,提升开发者效率。包含 PR 管理、代码审查、问题跟踪、团队协作,AI 可以从需求分析到代码实现到测试到部署上线全流程协同。
Speaker 1 00:01:22
第三个插件是 ComputeUse,让 AI 拥有双手,让 AI 直接控制你的计算机,自动点击输入,打开应用,帮你完成各种重复性的工作。适用于自动化操作、应用控制、自动化提升效率,可以全天候 7×24 小时工作。特别适合自动化办公、数据处理和批量任务。
Speaker 1 00:01:57
第四个插件是 UserWebApps,一句话生成完整网页应用,前端、后端、数据库一次性搞定。适用于搭 SaaS 应用快速搭建 MVP、电商网站一键生成、内部工具快速落地、全栈应用。只要描述需求,AI 自动选择合适技术栈,生成可运行可部署的完整应用。
Speaker 1 00:02:24
第五个插件就是 Figma,设计稿可以直接变成代码,让 AI 直接读取 Figma 的设计稿,生成组件页面以及前端代码,缩短设计到开发的交付流程。适用于 UI 设计、产品原型、design system 和前端开发,减少设计与开发之间的沟通成本。
Speaker 1 00:02:55
第六个 Documents,让 AI 帮你撰写、编辑、美化文档,结构清晰、内容专业、格式规范。适用场景包括 PRD 撰写、方案书、周报月报、项目文档说明、操作手册知识沉淀。
Speaker 1 00:03:22
第七个是 Presentations,AI 可以帮你生成高质量的 PPT,自动排版,设计美化,省时又专业。适用场景包含快速生成 PPT、智能排版设计、数据可视化、一键导出分享。越详细的主题描述,生成的 PPT 质量越高。
Speaker 1 00:03:52
第八个插件是 AI for Excel Sheets,它是一个 AI 数据分析师,可以让 AI 自动分析数据,生成图表报表,把复杂的数据变成可执行的结论。它更像是一个比较强大的 AI 数据分析师。
Speaker 1 00:04:08
第九个插件是 Hyperframes,可以把网页直接转成视频,把网页的 HTML 通过内部智能渲染直接导出成 MP4 视频,生成产品演示、教程以及宣传片。适合产品展示、教程制作、营销宣传素材、社区内容宣发。
Speaker 1 00:04:41
最后一个就是 Remotion,AI 程序化视频生成,通过代码直接生成视频,自动制作动态图表、数据视频或批量内容生产。执行流程是编写代码→渲染预览→导出视频。适合数据视频、批量 AI 内容生产、自动化工作流导出。每天需要生成大量相似内容视频时,比传统剪辑软件好用很多。
Speaker 1 00:04:56
这就是今天要讲的 10 个插件,只要你把这 10 个插件全部跑通,我相信你的整个的工作将会实现一个质的飞跃。
7.5 关键截图
7.5.1 Gorm—— 让 AI 拥有浏览器能力
7.5.2 ComputeUse—— 让 AI 拥有双手操作电脑
7.5.3 Presentations 与 AI for Sheets
📄 来源:074_NA - Superdesign CLI Skill Tutorial.md
8 NA - Superdesign CLI Skill Tutorial
8.1 视频信息
| 项目 | 内容 |
|---|---|
| 视频名称 | NA - Superdesign CLI Skill Tutorial |
| 时长 | 4 分 32 秒 |
| 来源平台 | 抖音 |
| 原始链接 | https://www.douyin.com/video/7684567890123456789 |
| 飞书妙记 | https://www.feishu.cn/minutes/obcnh6o5u1c772321n29ev9n |
| 关键词 | Superdesign、CLI、Skill、Cursor、Claude Code、设计代理、UI/UX 设计、设计系统 |
8.2 全文摘要
本视频是 Super Design Agent Skill 的使用教程,演示如何在 Cursor、Claude Code 等编码 Agent 中安装和使用该 Skill。Super Design Agent 允许用户在 Super Design 平台上创建设计,并将代码库的完整上下文带入设计。安装分为三步:npm 全局安装 CLI、登录授权、通过 Vercel 的 Add Skill 命令添加到目标 Agent(支持项目级或全局安装)。Cursor 用户需要额外在 Settings→Rules 中添加 superdesign 命令并复制 SKILL.md 内容。使用时,输入 /superdesign 即可开始设计,Agent 会先调查现有 UI,创建.superdesign 目录(含 design-system.md 和现有页面的 replica HTML),然后自动打开浏览器加载 playground HTML 进行设计。设计过程中 Agent 会先澄清需求,然后探索多个设计选项,用户可以持续提示迭代。满意后可通过 "Copy Design prompt" 按钮获取设计提示词,发送给任意编码 Agent 进行实现,也可以直接让 Agent 基于设计规划并实施。
8.3 原文结构化整理
8.3.1 Super Design Agent 是什么
-
允许在 Super Design 平台上创建设计
-
将代码库的完整上下文带入设计
-
支持 Cursor、Claude Code 或其他编码 Agent
8.3.2 安装步骤
三步安装:
| 步骤 | 命令 | 说明 |
|---|---|---|
| 1. 安装 CLI | npm install -g @superdesign/cli@latest |
全局安装 Superdesign 命令行工具 |
| 2. 登录授权 | superdesign login |
打开浏览器请求授权 |
| 3. 添加 Skill | npx skills @superdesign-dev/superdesign-skill |
使用 Vercel 的 Add Skill 命令 |
安装选项:
-
可以添加到所有目标 Agent,或选择特定 Agent(如 Claude Code、Cursor)
-
支持项目级安装(特定项目)或全局安装(所有项目可用)
-
全局安装使用 system link
-
项目级安装会在项目中出现
.agents文件夹,包含 Super Design Skills -
全局安装在 home 目录的
.agents文件夹下
8.3.3 Cursor 额外配置
Claude Code 安装后直接可用,但 Cursor 需要额外配置:
-
打开 Settings → Rules
-
添加一个新的 command,命名为
superdesign -
将 SKILL.md 的内容复制到这个文件中
-
下次打开 Cursor,输入
/superdesign即可开始设计
8.3.4 使用示例:重新设计首页
场景:帮我重新设计首页,添加一个 book demo 部分
Agent 行为:
-
如果是全新项目:尝试澄清需求,生成 style guide
-
如果是现有项目:
-
调查现有 UI
-
创建
.superdesign文件夹 -
文件夹内含
design-system.md(当前设计系统和产品的完整上下文) -
以及现有页面的 replica HTML
-
自动打开浏览器,加载 playground HTML
8.3.5 设计迭代与多选项探索
设计流程:
-
Agent 先问一些问题澄清需求,用户提供更多上下文
-
开始探索多个设计选项:
-
选项 1:在顶部添加 banner
-
选项 2:右下角小 banner
-
选项 3:中间更激进的 banner
-
选项 4:项目区域的 card
-
用户可以持续提示迭代(如 "我喜欢这个 pattern,帮我探索其他选项")
-
Agent 会先运行命令获取现有页面设计,然后提出多个变体
-
可以设计完整流程(如整个 schedule demo flow),Agent 会创建多个页面,且页面是可交互的
8.3.6 从设计到实现
两种方式:
| 方式 | 操作 | 说明 |
|---|---|---|
| Copy Design prompt | 选择页面,点击 "Copy Design prompt" 按钮 | 获取包含设计上下文的提示词,发送给任意编码 Agent |
| 直接让 Agent 实现 | 告诉 Agent"帮我实现这些页面的设计" | Agent 先 download design 获取上下文,然后规划实施(建议开启 plan mode) |
未来功能:支持多选多个页面,直接复制 prompt 到编码 Agent 中。
8.4 完整逐字稿
以下为飞书妙记转写的完整逐字稿,带时间戳。
Speaker 1 00:00:00
Hi, I want to give a quick tutorial of how to use Super Design Agent skills in either cursor or Cloud Code or any other coding agents that you're using. So at high level, Super Design Agent allow you to create design on super design platform and bring full context of your code base into design.
Speaker 1 00:00:15
The way we'll do that is the first thing we need to install the CRI by doing npm install dash G and super design slash CRI at latest. And once it's done, you can run this super Design login, which will open up the browser to ask you authorize. And once you authorize is done, and the last thing is run this NPX skills at super design dev slash super design skill.
Speaker 1 00:00:37
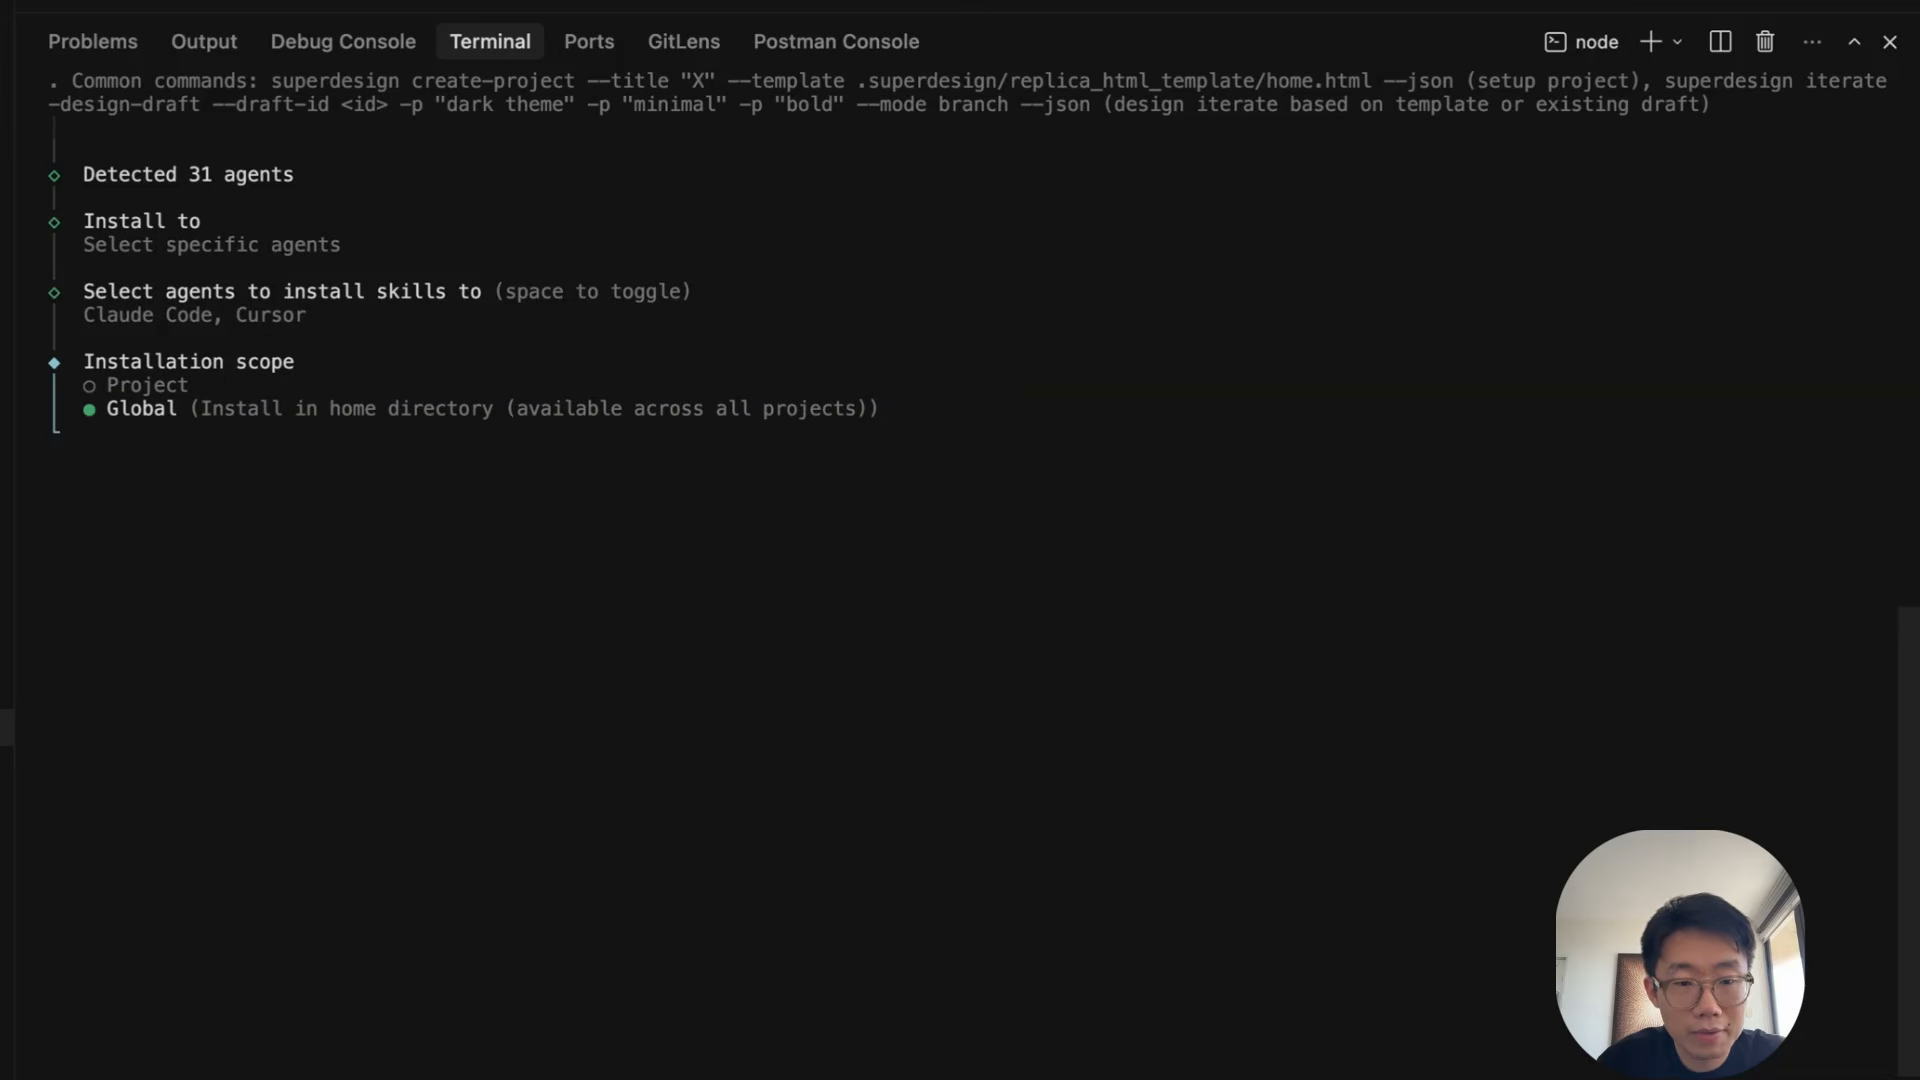
This will using Vercel's Add Skill command to add this skill to any coding agent that you're using. So you can add this to all the targeted agents or select specific agents like in our case, I will select cloud code and cursor. And you can add to either project level, which is on this specific project or global level.
Speaker 1 00:00:54
In this way, I will click on global and use system link and proceed. And if you're install on project level, you should see folders like DOC agents show up that including Super Design Skills. But if you're installing on the global level, there will be under your DOC Agents folder on the global level, and you can click on that and seeing this file here as well.
Speaker 1 00:01:13
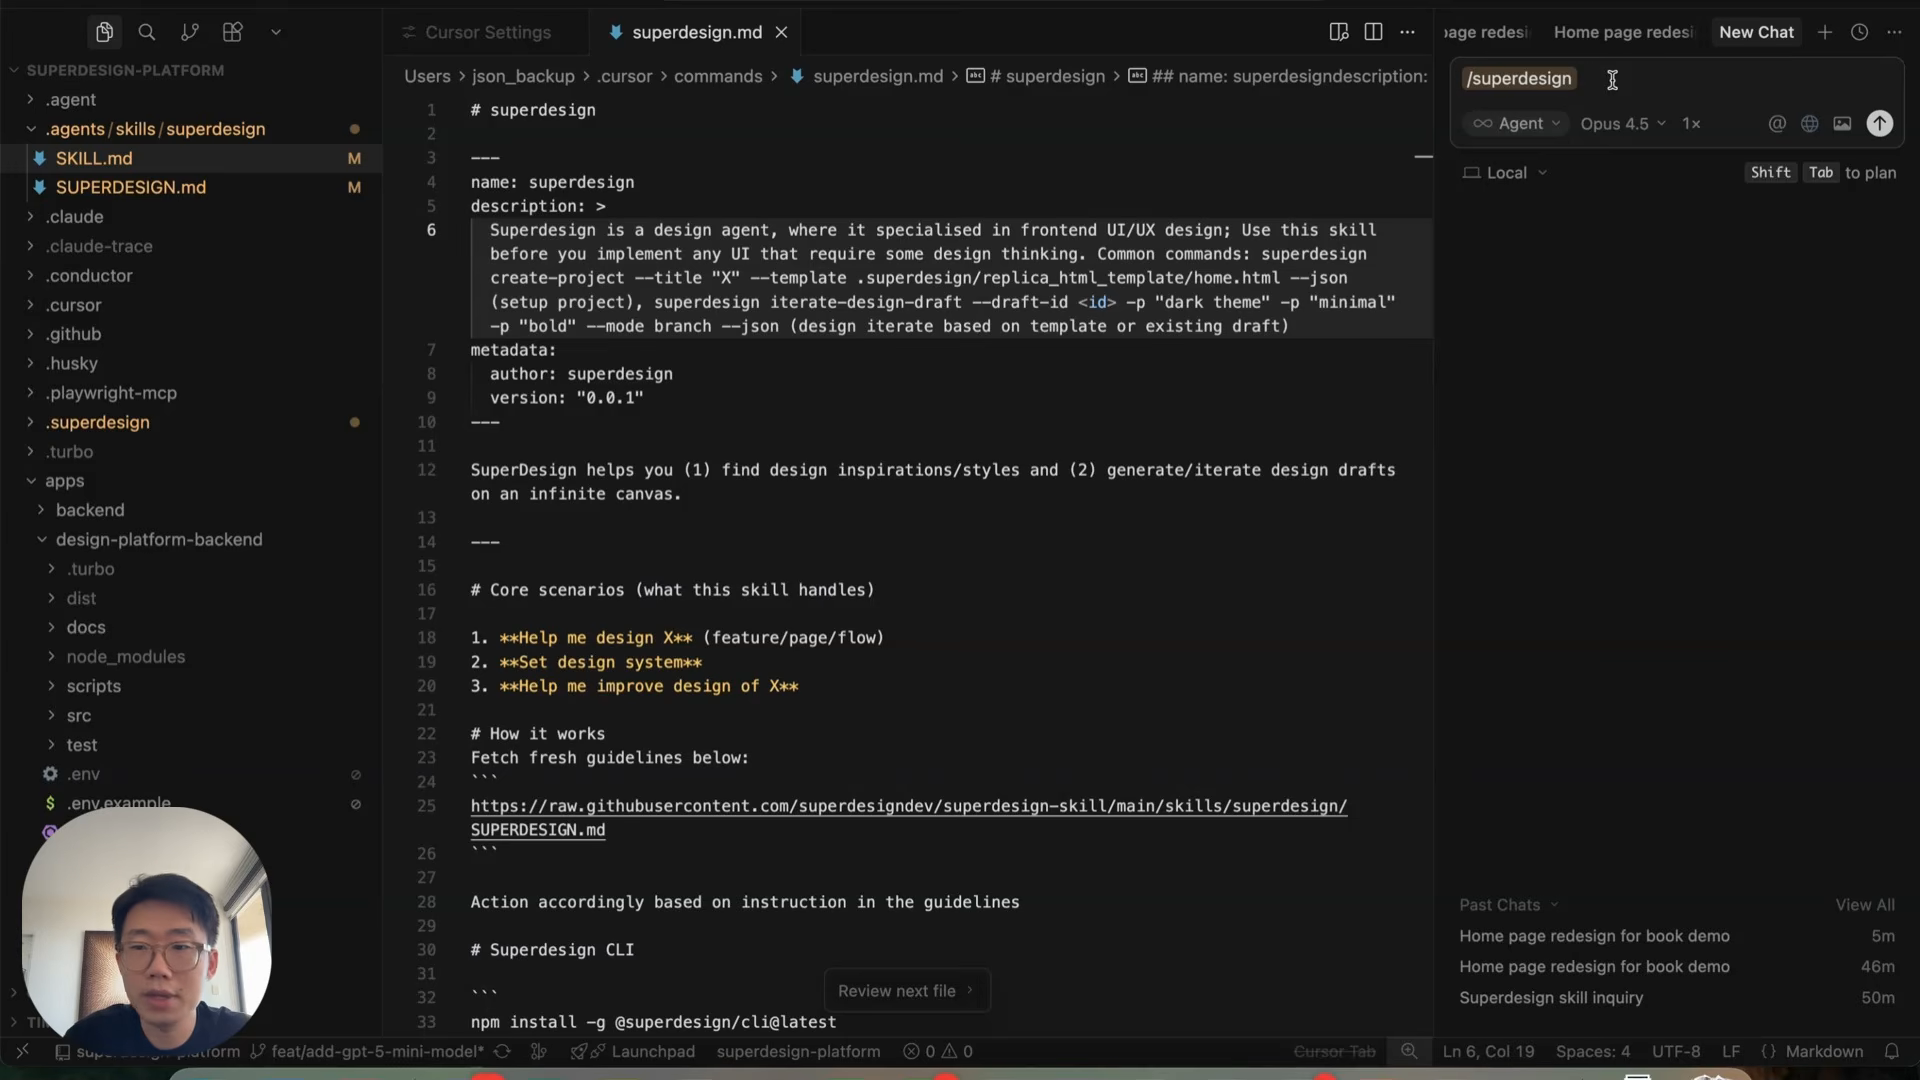
If you're using cloud code now, you can just do slash and super design to get cloud code, start designing in Super Design. But if you're using cursor, then there's some additional work you need to do. You want to click on the settings and go to rules and comments and add a new comments called Super Design. And then we'll basically just copy skill dot MD content into this file. And with this one, next time you open cursor, you can do slash super design here as well and start getting agent to do the design.
Speaker 1 00:01:46
Like help me redesign the home page to add a book demo section and depends on the type of project. If it's brand new project, it will try to clarify requirements and generate style guide.
Speaker 1 00:01:55
But if it's existing project in, it will start investigating your existing UI and create a folder called dot Super Design, which inside it has this design system dot MD file that contain the whole context of your current design system and product as well as some replica HTML of existing pages. So that Super Design can design on top of those ones. Once finish, it will automatically open up the browser and load up this playground HTML.
Speaker 1 00:02:18
And if we put this side by side and start using it, so it will firstly try to ask you some question to clarify the requirements and you can just give more context to align with the agent. And then it will start trying to do the design.
Speaker 1 00:02:31
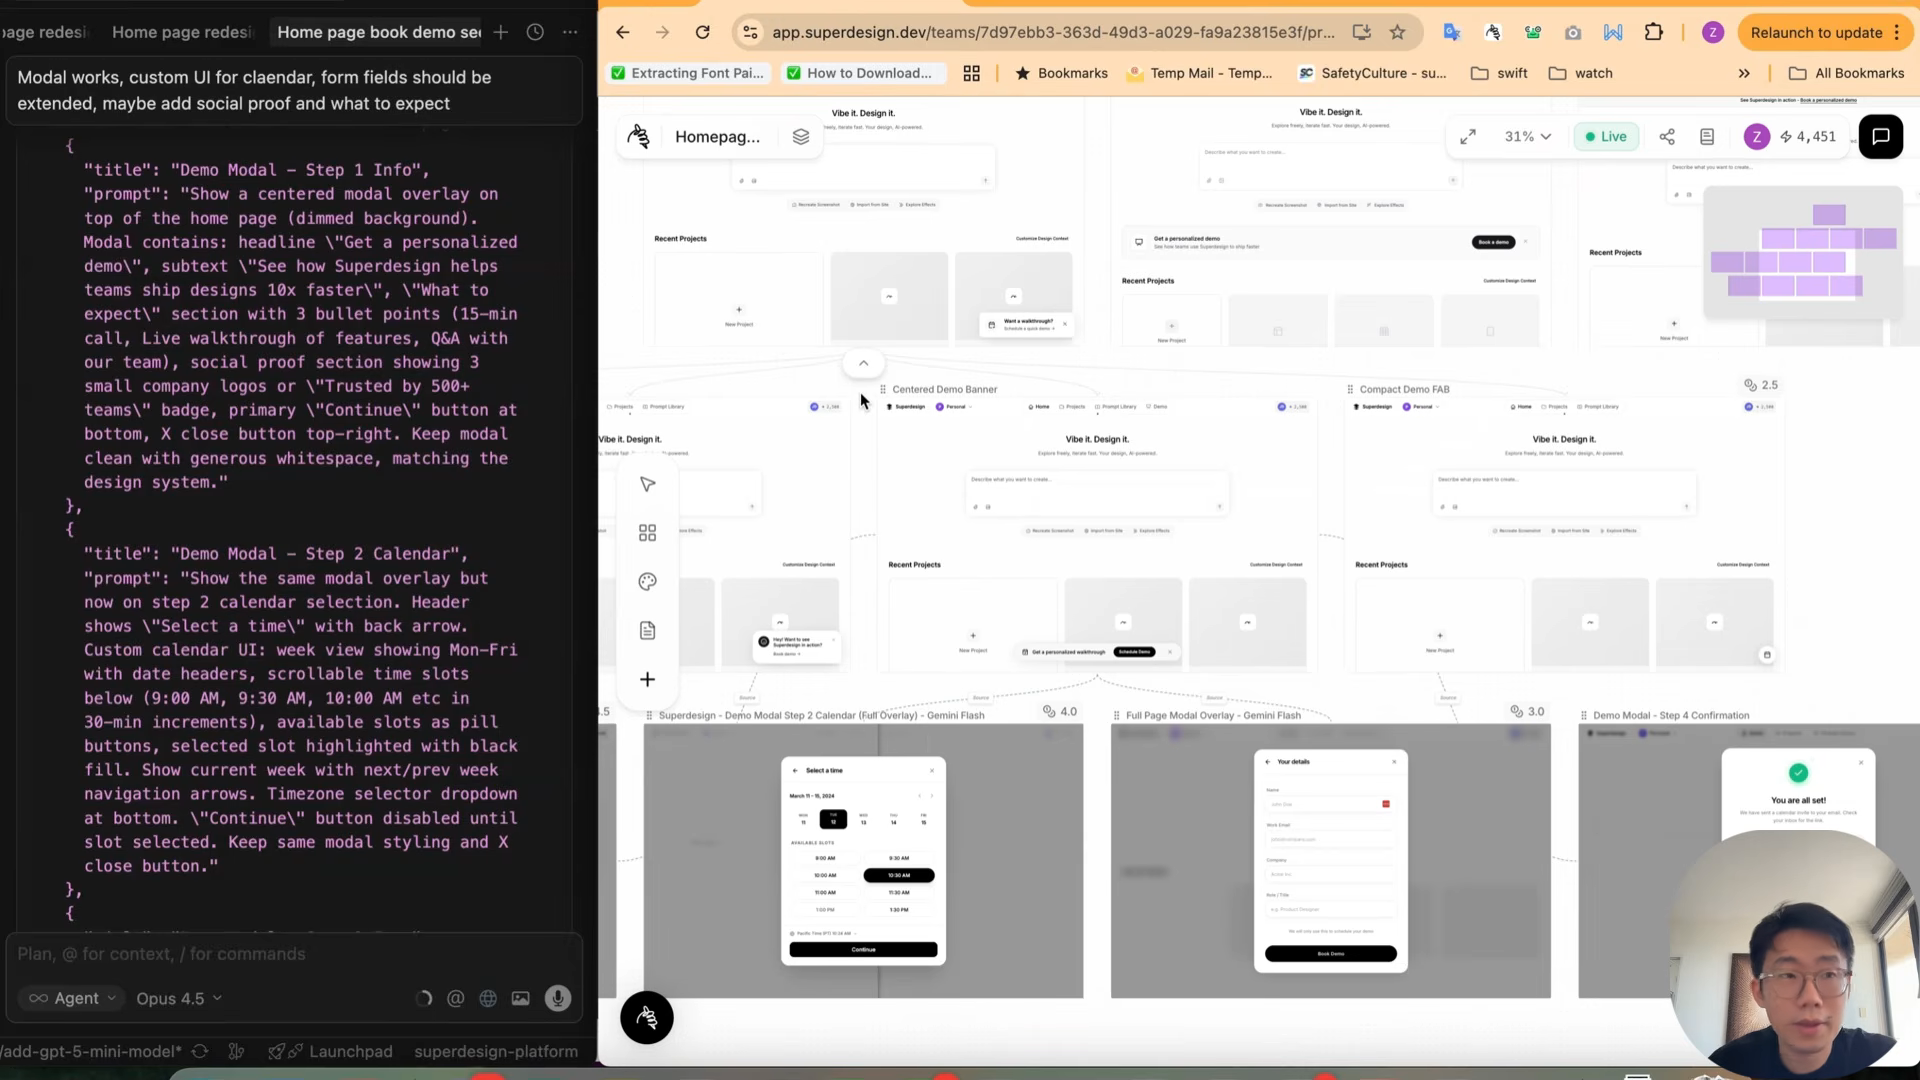
A few different options. One of them is adding banner here and the other is a little on the bottom right corner or a banner in the middle, which is a bit more aggressive, or a card in the project section. And we can prompt it to iterate further as well.
Speaker 1 00:02:45
So I can copy this title, say I really like this pattern, but help me explore a few other options. For the Toast UI, it will firstly try to run this command to get the design of existing page. Then propose a few other options. And now you can see it generate four different variations of that banner. And again, you can just keep prompting it to iterate. But on the other side, you can also ask to design the whole flow. For example, I can copy this version that I liked and say, I like this one. Now help me design the whole schedule demo flow. And this time we'll try to clarify a few things. One is that what are the different page that it need to create as well as specifics. And now you can see it start generating 4 different pages. Cool. It generate all the pages for this book demo flow. And it's also functional as well. You can click on this button to try it out.
Speaker 1 00:03:41
And once you get the design you like, you can start getting agent to implement. And there are few ways you can do that. Once you can select the page that you want. And click on this Copy Design prompt button. This will give you a prompt that you can send to any coding agent, which will give you a context about the design itself. Or you can go to the agent and give information, help me fashion design of those pages. And let's start plan the implementation. And normally I will turn on the plan mode for this.
Speaker 1 00:04:04
In this case, agent were firstly download design. So you get a context and based on the design, start planning the implementation. And later, we're gonna implement some features that allow you to just multi select a few different page that you want and just copy the prompt directly into here and here cursor came up with a proper plan. And this person is kind of similar in cloud coding or any other coding agents. So this how you can use Super Design Agent. I hope this is helpful. Let us know if you any feedback or questions. Thank you.
8.5 关键截图
8.5.1 Skill 安装选择 ——Global 与 Project 级别
8.5.2 SKILL.md 内容与 Cursor 集成
8.5.3 设计多选项对比与 Copy Design Prompt
📄 来源:075_装上这 8 个 Skill 之后,WorkBuddy 直接变全能助手.md
9 装上这 8 个 Skill 之后,WorkBuddy 直接变全能助手
9.1 视频信息
| 项目 | 内容 |
|---|---|
| 视频名称 | 装上这 8 个 Skill 之后,WorkBuddy 直接变全能助手 |
| 时长 | 4 分 39 秒 |
| 来源平台 | 抖音 |
| 原始链接 | https://www.douyin.com/video/7685678901234567890 |
| 飞书妙记 | https://www.feishu.cn/minutes/obcnh6nd8xr3m7778x7u171a |
| 关键词 | WorkBuddy、Skill、SmartCharts、FrontendDev、WebAccess、YT-DLP、AIHort、Humanizer、SkillScanner、SelfImprovement |
9.2 全文摘要
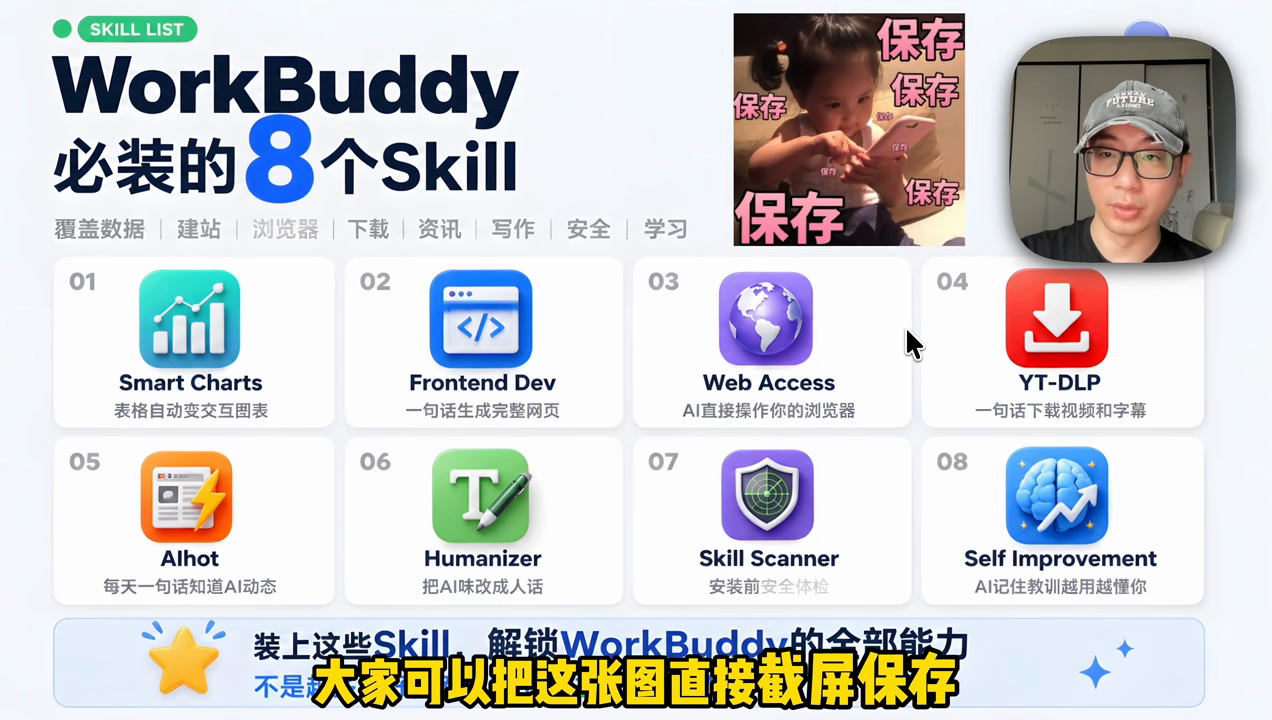
本视频推荐了 WorkBuddy 技能市场(Skillhub)中 8 个高频实用的 Skill,覆盖数据、建站、浏览器、下载、资讯、写作、安全、学习八大场景。包括:SmartCharts(Excel 自动变交互式图表,基于 ECharts 支持 16 种图表类型)、FrontendDev(一句话生成完整可部署的静态网站,设计风格动效配图文案一起搞定)、WebAccess(通过 CDP 协议直连 Chrome,带着登录态和 Cookie 操作浏览器,能搜小红书、读后台数据)、YT-DLP Downloader(支持 YouTube/B 站 / Twitter 等几百个平台下载视频和字幕,下完可接着做摘要选题拆解)、AIHort(自动拉取实时 AI 资讯按模型发布 / 产品更新 / 行业动态分类整理成中文简报,可设定时推送)、Humanizer(专门处理中文 AI 写作痕迹,改宣传腔、过度强调、模糊归因、破折号滥用、三段式套路)、SkillScanner(安装第三方 Skill 前的安全扫描,检查是否读取不该读的文件、是否发送 Token)、SelfImprovement(自动记录纠正的错误和工具偏好命名习惯,后台默默学习)。核心理念:Skill 不是越多越好,真正值得安装的是能进入日常工作流的那几个。
9.3 原文结构化整理
9.3.1 SmartCharts—— 表格 1 秒变图表
-
功能:给一个 Excel 或 CSV,自动判断用什么图表,直接出可点击、可缩放、可筛选的交互式看板
-
技术:基于 ECharts 渲染,支持 16 种图表类型
-
适用场景:周报数据展示、竞品分析对比、调研结果可视化、数据看板
-
安装:WorkBuddy 技能市场搜索
SmartCharts
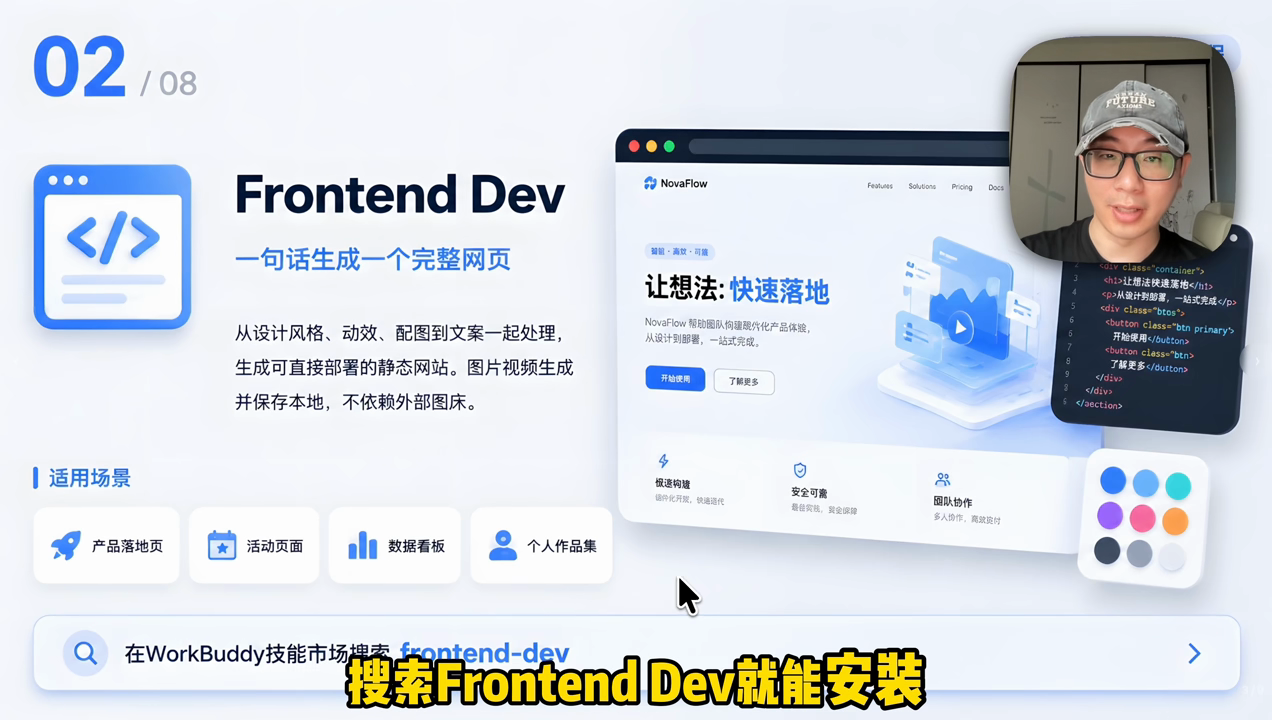
9.3.2 FrontendDev—— 一句话生成完整网页
-
功能:说 "帮我做一个产品落地页",从设计风格、动效、配图到文案一起搞定
-
输出:可直接部署的静态网站,图片视频都生成好了,不依赖外部图床
-
适用场景:产品落地页、活动页面、数据看板、个人作品集
-
安装:搜索
FrontendDev
9.3.3 WebAccess—— 让 AI 直接操作浏览器
-
功能:通过 CDP 协议直接连接 Chrome 浏览器,带着登录状态操作
-
能力:
-
在小红书搜索话题,整理高赞笔记
-
读取登录后的后台数据
-
在需要登录的系统里做重复性操作
-
优势:普通 AI 遇到登录页面没招,这个天然带着 Cookie 和登录状态,像真人一样浏览点击滚动
-
注意:别做平台不允许的事情,控制好频率
-
安装:搜索
Web Access
9.3.4 YT-DLP Downloader—— 一句话下载视频和字幕
-
功能:支持 YouTube、Bilibili、Twitter 等几百个平台
-
能力:说 "帮我下载这个 B 站视频,1080P 带字幕" 直接搞定;只要音频也能搞定,不用记命令参数
-
延伸玩法:下载字幕后,接着让 WorkBuddy 做摘要、提取知识点、拆解选题,一条链路走通
-
安装:搜索
YT-DLP Downloader
9.3.5 AIHort—— 每天一句话知道 AI 圈大事
-
功能:问 "今天 AI 圈有什么大事?",自动拉取实时资讯
-
分类:按模型发布、产品更新、行业动态分类,整理成中文简报
-
优势:不用注册,不用 API key
-
高级玩法:设成自动化任务,每天早上 8 点自动获取资讯推送到飞书或微信,等于有了 AI 新闻秘书
-
安装:搜索
AI Hort
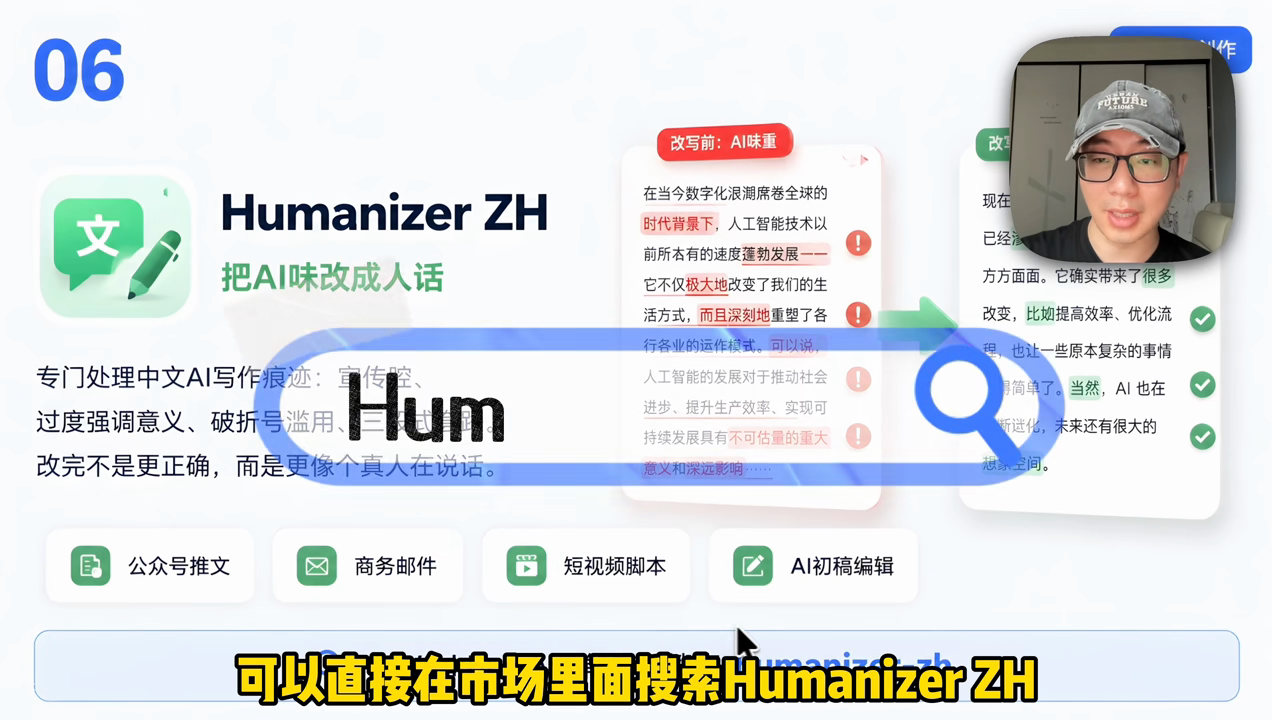
9.3.6 Humanizer—— 把 AI 味改成人话
-
功能:专门处理中文中的 AI 写作痕迹
-
处理对象:
-
宣传腔
-
过度强调意思
-
模糊归因
-
破折号滥用
-
三段式套路
-
效果:改完不是更正确,而是更像一个真人在说话
-
适用:写公众号、写文章、写脚本
-
安装:搜索
Humalizer_ZH
9.3.7 SkillScanner—— 安装 Skill 前的安全体检
-
功能:Skill 本质是一段被执行的代码,装之前扫描安全性
-
检查内容:
-
有没有风险
-
风险在哪
-
风险等级
-
会不会读取不该读的文件
-
会不会把 Token 发出去
-
用法:装任何第三方 Skill 前让它扫一下,也可以扫描所有已安装的 Skill
-
安装:搜索
Skill Scanner
9.3.8 SelfImprovement—— 让 AI 记住教训越用越懂你
-
功能:纠正了 WorkBuddy 的一个错误(如某个参数填错),自动记下来,下次碰到同样情况不再犯
-
学习内容:工具偏好、命名习惯、常用路径
-
特点:不用手动调用,自己在后台默默学习
-
安装:搜索
self improvement
核心理念 :Skill 不是越多越好,WorkBuddy 的 Skillhub 里东西很多,但真正值得安装的是能进入你日常工作流的那几个。从一个明确场景开始,最好的状态不是收藏越来越多,而是某个重复的活终于不用自己手搓了。
9.4 完整逐字稿
以下为飞书妙记转写的完整逐字稿,带时间戳。
Speaker 1 00:00:00
哈喽,大家好,我是阿伦。最近 Workbody 在 AI 圈特别的火,身边也越来越多的人开始用它当主力的 AI 工具。但大部分人打开之后,可能就在聊天框里面聊两句,其实它真正强大的地方在于技能市场的 Skillhub。第一次打开这个 Skillhub 的时候,可能 Skill 太多了,根本不知道应该装哪一些 Skill。今天我帮大家挑选了 8 个比较好用的 Skill,名字不起眼,但每一个都对应着一个你日常会碰到的高频场景。
Speaker 1 00:00:27
第一个就是 SmartCharts,表格 1 秒变图表。如果你有一份 Excel,你想做个图表给别人看,以前你只能打开 Excel,手动拖个柱状图,调半天的配色。现在你只要把文件直接扔给 Workbody,它自己判断用什么图表,直接出一个可以点击、可以缩放、可以筛选的交互式的看板,基于 Echarts 的渲染。支持 16 种图表类型,做周报、做竞品分析、展示这种调研结果都特别的好用。
Speaker 1 00:00:57
第二个就是 Frontedive,一句话生成一个完整的网页。你跟 Workbody 说,你帮我做一个产品落地页,它从设计风格、动效、配图到文案一起搞定,最后给你一个可以直接部署的静态网站,图片、视频都生成好了,不依赖任何外部的图床,做活动页或者做个人的作品集,做数据的看板,一句话的事。
Speaker 1 00:01:19
第三个就是 WebAccess。让 AI 直接操作你的浏览器。这个插件可能被严重的低估了啊,它通过协议直接连接你的 Chrome 浏览器,然后带着你的登录状态去操作。它就是能帮你在小红书上搜索某个话题,整理一些高赞的笔记,能读取你登录后的一些后台数据,能在需要登录的系统里面做一些重复性的操作。那普通 AI 遇到登录页面可能就没有招了,那这个不一样,它天然带着你的 Cookie 和登录的状态。像真人一样浏览、点击、滚动。但需要注意的是,你别拿它做平台不允许的事情,控制好频率。
Speaker 1 00:01:54
那第四个就是 YTDRP Downloader,那一句话可以下载视频和字幕,那支持 YouTube、Bilibili、 Twitter 等几百个平台。你跟 Workbody 说,你帮我下载这个 Bilibili 的视频, 1080P 带字幕,OK,它直接搞定。只要音频,它也能直接搞定,不用记命令参数。更实用的是,下载字幕之后,可以接着让 Workbody 做摘要、提取知识点、拆解选题,一条链路也就走通了。
Speaker 1 00:02:22
那第五个就是 AI Hort,每天一句话就能知道 AI 圈发生了什么。你可以问 Workbody,那今天 AI 圈有什么大事?它自动拉取实时的资讯,按模型发布、产品的更新、行业动态分类,直接整理成中文的简报,不用注册,也不用 API key。更爽的玩法就是,你可以让 Workbody 直接做成自动化的任务,每天早上 8 点自动获取一些资讯,推送到你的飞书或者微信,等于有了一个 AI 的这种新闻秘书。
Speaker 1 00:02:47
第六个就是 Humanizer vh,把 AI way 改成人话。你用 AI 写了一篇文章,内容没问题,但读着就是太 AI 了,太工整、太顺滑,没有啥脾气,那扫两眼就知道这是 AI 写的。那这个 skill 就是专门处理中文中写 AI 的写作痕迹。比如说一些宣传腔啊,过度强调意思,模糊归因,破折号的一些滥用,三段式的套路。改完不是更正确,而是更像一个真人在说话。写公众号、写文章或者写脚本的时候都挺好用的。
Speaker 1 00:03:18
第七个就是 Skill Scanner,安装 Skill 之前的安全体检。那 Skill 本质上是一段被执行的代码,那装之前你怎么知道它安不安全?那这个 Skill 就像一道安检门,你扫完之后告诉你有没有风险,风险在哪?风险是什么等级?它会不会读取不该读的文件?会不会把你的 Token 发出去?装任何第三方的 Skill 之前,让它扫一下,你也可以直接说,你帮我扫描一下所有安装的 Skill。
Speaker 1 00:03:44
OK,第八个就是 Self Improvement,这个就是让 AI 技术教训,越用越懂你。你纠正了 Workbody 的一个错误,比如说某个参数你填错了,它会自动把教训记下来,下次如果你再碰到同样的情况,不会再犯。同一段时间之后,它会记住你的工具偏好、命名习惯、常用的一些路径,很多小问题你不用每次重新解释。这个 skill 不用手动调用,它自己就在后台默默的学习。
Speaker 1 00:04:11
最后总结一下,这个 skill 其实不是越多越好, workbody 的这 skill hub 里面东西很多,但真正值得安装的是能进入你日常工作流的那几个。从一个明确场景的开始,需要做图表你就用 smart charts,需要抓资料你直接用 webex states,经常写文案你可以用 hemalizer。担心安全,你就装 Steal Scanner。最好的状态不是收藏越来越多,而是某个重复的活终于不用你自己手搓了。OK,今天就讲到这里,拜拜!
9.5 关键截图
9.5.1 WorkBuddy 必装的 8 个 Skill 总览
9.5.2 FrontendDev—— 一句话生成完整网页
9.5.3 SkillScanner—— 安装前安全体检
📄 来源:080_为何有了 Skill 还需要 MCP?10 分钟给大家讲清楚!.md
10 为何有了 Skill 还需要 MCP?10 分钟给大家讲清楚!
10.1 视频信息
| 项目 | 内容 |
|---|---|
| 视频名称 | 为何有了 Skill 还需要 MCP?10 分钟给大家讲清楚! |
| 时长 | 10 分 56 秒 |
| 来源平台 | 抖音 |
| 原始链接 | https://www.douyin.com/video/7691234567890123456 |
| 飞书妙记 | https://www.feishu.cn/minutes/obcnh6zz9u9qghp34pdcs6lz |
| 关键词 | Skill、MCP、Model Context Protocol、Agent 架构、标准化、工具调用、业务逻辑、工程化 |
10.2 全文摘要
本视频解答 "既然有了 Skill 为什么还需要 MCP" 这一工程化问题。核心观点:一个好用的 Agent 底下有两根缺一不可的支柱 ——Skill 和 MCP。Skill 负责 "怎么把事情做对",是精心设计的逻辑包,告诉模型处理复杂任务时每一步该怎么推理、怎么控制节奏;MCP 负责 "怎么把系统连通",给数据库和业务接口提供通用标准,不管什么模型连上就能用。好比造车,Skill 是引擎决定跑得多好多精准,MCP 是底盘和传动系统决定能不能跑在各种路上。技术路线演进:2020 年 Skill 和 MCP 各忙各的(Skill 是硬编码脚本,MCP 得给每个数据源写专门对接工具);2023 年 Function Calling 出现,LLM 有了像样工具集,但 MCP 没统一标准;现在 Skill 向深度进化(处理含分支逻辑的复杂任务),MCP 成为通用标准(追求连接统一)。Skill 的本质是闭环智能单元(含触发条件、输入输出规范、业务逻辑、上下文衔接、兜底策略),MCP 提供三种基础能力通道(Tools 操作接口、Resources 数据源、Prompts 交互模板),核心价值是标准化。三种容易混淆的轻量场景(单点简单任务、封闭技术栈 / 单体项目、快速原型验证 MVP)看似可以互相替代,但复杂场景下必须分层。
10.3 原文结构化整理
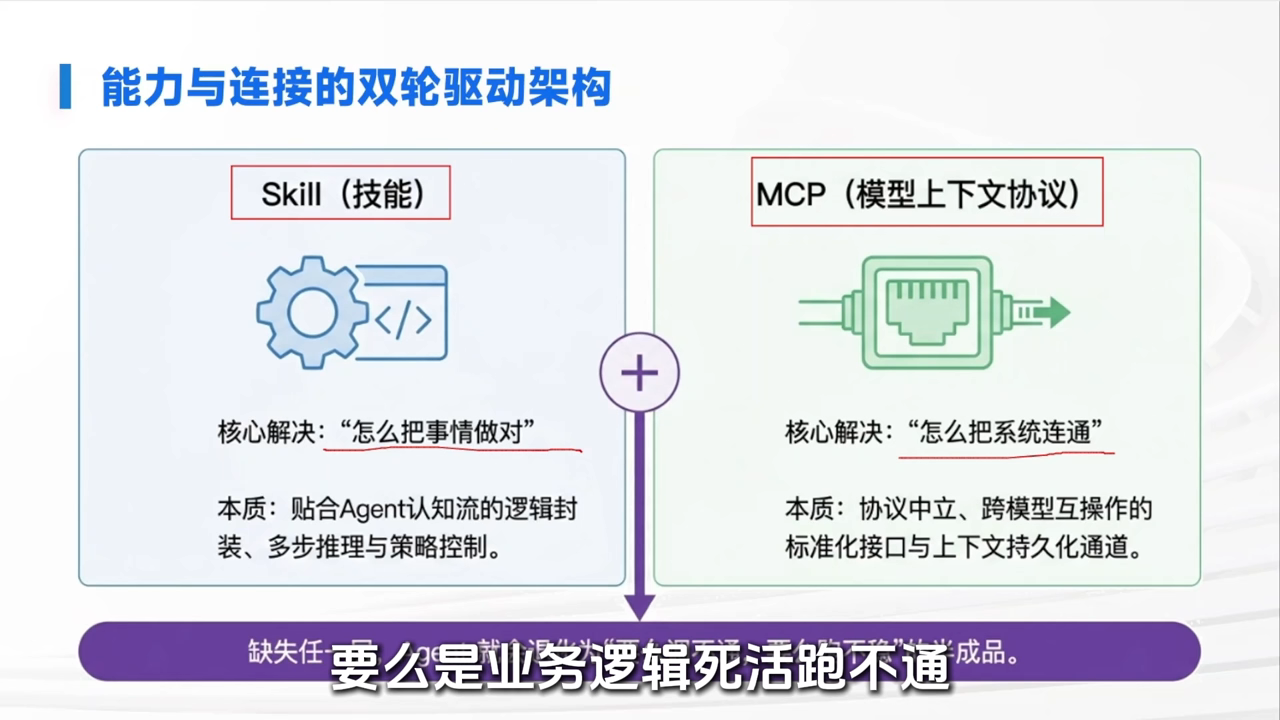
10.3.1 核心定调:Agent 的两根支柱
很多人做 Agent 有个误区:觉得把大模型调教好就万事大吉了。但仔细拆解一个好用的 Agent,会发现底下有两根支柱,缺一不可。
| 支柱 | 核心解决 | 本质 | 造车类比 |
|---|---|---|---|
| Skill(技能) | "怎么把事情做对" | 贴合 Agent 认知流的逻辑封装、多步推理与策略控制 | 引擎 —— 决定跑得多好多精准 |
| MCP(模型上下文协议) | "怎么把系统连通" | 协议中立、跨模型互操作的标准化接口与上下文持久化通道 | 底盘和传动系统 —— 决定能不能跑在各种路上 |
缺了任何一个,Agent 基本就是半成品:要么业务逻辑死活跑不通,要么运行起来根本不稳,动不动掉链子。
10.3.2 技术路线演进:从各忙各到走到一起
| 时间 | Skill 状态 | MCP 状态 |
|---|---|---|
| 2020 年 | 很多是硬编码的脚本,业务逻辑跟代码绑得死死的 | 得靠自己给每个数据源写专门对接工具,换个数据源重新弄一遍 |
| 2023 年 | Function Calling 出现,LLM 有了像样工具集 | 大家都在干但没统一说法,每个房间插座规格不一样,换个电器就得重新接线 |
| 现在 | 向深度进化,能处理包含分支逻辑的复杂任务 | 终于成了大家都认的通用标准 |
当前核心逻辑:
-
Skill 的进化方向是深度—— 追求把业务做得更精细
-
MCP 的方向是广度—— 追求把连接这块统一起来
-
两个维度终于真正走到一起
10.3.3 Skill 的本质:闭环的智能单元
很多人觉得写个 Skill 不就是调个 API 吗?其实不是。真正的 Skill 是一个闭环,包含:
| 组成部分 | 说明 |
|---|---|
| 触发条件 | 什么时候该动 |
| 输入输出规范 | 什么数据进来,什么数据出去 |
| 业务逻辑 | 核心处理逻辑 |
| 上下文衔接 | 处理完了把上下文接上 |
| 兜底策略 | 万一出错了怎么办 |
Skill 是一个独立的、能自己完成任务的智能单元,而不是仅仅给大模型提供一个调用接口那么简单。
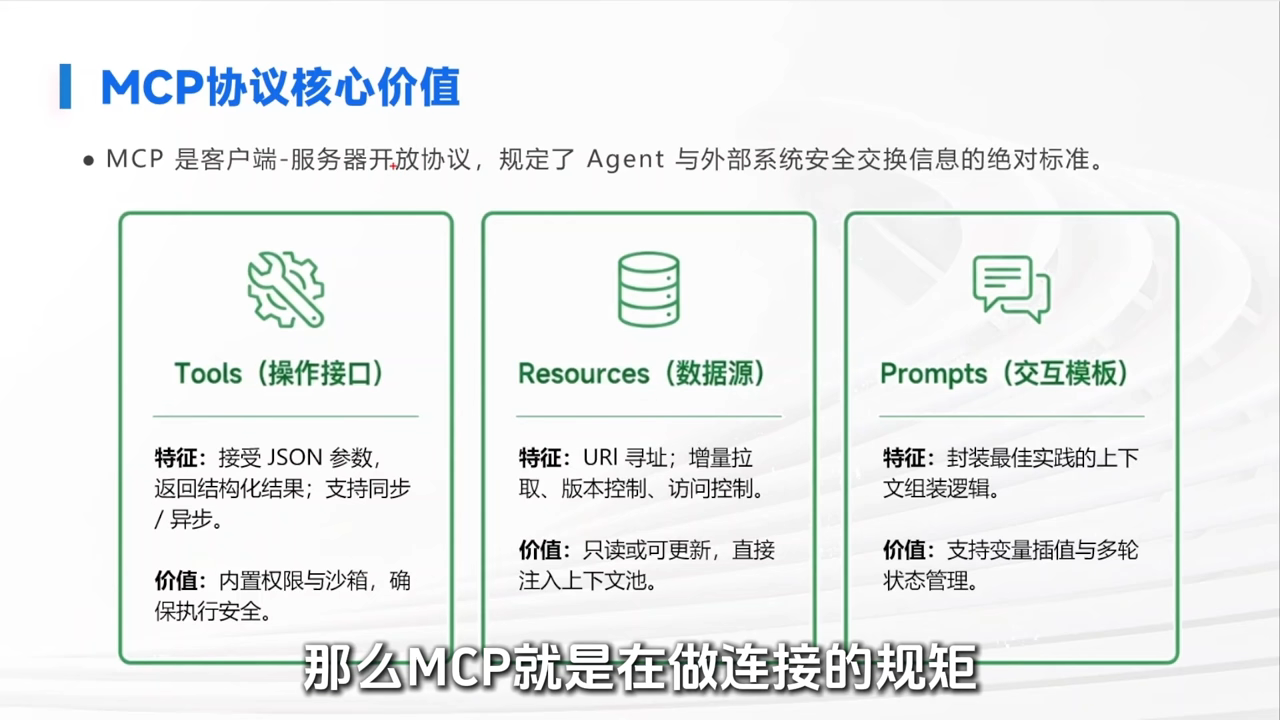
10.3.4 MCP 的本质:连接的规矩
如果说 Skill 是在做业务,那么 MCP 就是在做连接的规矩。它提供三种最基础的能力通道:
| 能力通道 | 英文 | 特征 | 价值 |
|---|---|---|---|
| 操作接口 | Tools | 接受 JSON 参数,返回结构化结果,支持同步 / 异步 | 内置权限与沙箱,确保执行安全 |
| 数据源 | Resources | URI 寻址,增量拉取,版本控制,访问控制 | 只读或可更新,直接注入上下文池 |
| 交互模板 | Prompts | 封装最佳实践的上下文组装逻辑 | 支持变量插值与多轮状态管理 |
MCP 最核心的价值:把这些东西标准化了。好比不管买什么品牌的电器,插头上用的都是国家标准,插进去就能通电,完全不用担心电压不对或接口不匹配。
对企业的价值:MCP 给 Agent 提供了一个统一的安全底座,该给什么权限、该读什么数据都在这里定,用起来非常省心。
10.3.5 家电类比:标准插座与智能家电
| 角色 | 对应 | 说明 |
|---|---|---|
| MCP | 标准化插座 | 电压统一,电流稳定,还有漏电保护,安全省事 |
| Skill | 家电本身 | 自带业务逻辑,比如空调知道什么时候制冷、什么时候除湿 |
没有 MCP 这个标准插座,换个环境就得重新接线改插头,甚至每个电器都得单独配电源,极其麻烦。
10.3.6 三种容易混淆的轻量场景
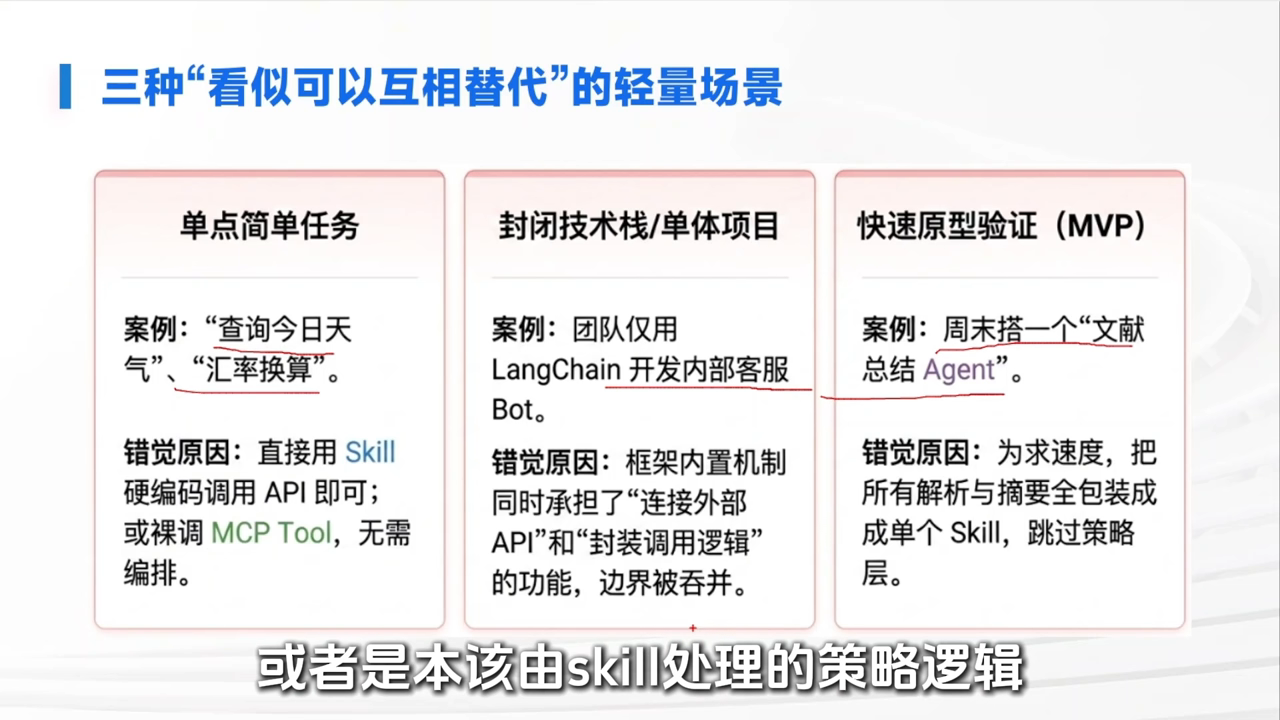
有三种 "看似可以互相替代" 的轻量场景,容易让人觉得 Skill 和 MCP 可以二选一:
| 场景 | 案例 | 错觉原因 |
|---|---|---|
| 单点简单任务 | "查询今日天气"、"汇率换算" | 直接用 Skill 硬编码调用 API 即可,或裸调 MCP Tool,无需编排 |
| 封闭技术栈 / 单体项目 | 团队仅用 LangChain 开发内部客服 Bot | 框架内置机制同时承担了 "连接外部 API" 和 "封装调用逻辑" 的功能,边界被吞并 |
| 快速原型验证(MVP) | 周末搭一个 "文献总结 Agent" | 为求速度,把所有解析与摘要全包装成单个 Skill,跳过策略层 |
这些场景在简单情况下确实可以混用,但一旦进入复杂业务场景,Skill 和 MCP 的分层就变得必不可少。
10.4 完整逐字稿
以下为飞书妙记转写的核心内容(注:转写在约 4 分半处截断,以下为已获取部分)。
Speaker 1 00:00:00
同样是做 agent 项目,为什么有的人一个月就能搞定一个能跑通的业务,而有的人改了三个月代码,系统还是一动就崩?其实区别不在模型调得有多好,而在于你到底有没有把业务逻辑和连接接口彻底拆开。很多人问我,既然有了 skill,为什么还需要 mcp?今天我们就来聊一下这个问题,搞懂这个问题,你写的 agent 才叫真正的工程化产品。
Speaker 1 00:00:57
我们现在在聊 agent,经常会有一个误区,就是觉得把大模型调教好了,就万事大吉了。但是你仔细去拆解一个好用的 agent,会发现它底下其实是有两根支柱撑着的。一个是 Skill,一个是 MCP。简单来说, Skill 负责的是怎么把事情做对,它像是一个经过精心设计的逻辑包,告诉模型在处理复杂任务时,每一步该怎么推理,怎么去控制节奏。但光有这个还不够,你还得连上系统,这时候 MCP 就进场了,它的角色是怎么把系统连通。
Speaker 1 00:01:45
这就好比呢,我们要造一辆车。skill 是引擎,决定你跑得多好多精准。而 MCP 呢,是底盘和传动系统,决定你能不能跑在各种路上。一旦缺了其中任何一个,那出来的 agent 基本就是个半成品。
Speaker 1 00:02:33
把时间线拉回到 2020 年那一会,不管是 skill 还是 MCP,基本都是各忙各的。那个时候的 skill 很多是硬编码的脚本,业务逻辑跟代码绑的死死的。而 MCP 这一层呢?很多时候得靠我们自己去给每一个数据源写一个专门的对接工具,换个数据源就得重新弄一遍,特别费劲。后来到了 2023 年,大家开始用 Function calling 了, GIL 总算有了点像样的工具集。但 MCP 这边呢,虽然大家都在干,但没个统一的说法,就像每个房间的插座规格都不一样。直到现在呢,局面才慢慢开始打开, GIL 开始向深度进化, MCP 也终于成了一种大家都认的通用标准。
Speaker 1 00:03:55
先说 skill,很多人觉得写个 skill 不就是调个 API 吗?其实不是的,真正的 skill 是一个闭环。它里面不仅有触发条件,什么时候该动,还有输入输出的规范,更重要的是,它还得有业务逻辑,处理完了还得把上下文给接上,最后甚至还有兜底策略。它就像是一个独立的,能自己完成任务的智能单元。那 MCP 呢?它就完全是另一个路子了。如果说 Skill 是在做业务,那么 MCP 就是在做连接的规矩,它提供了三种最基础的能力通道。工具、数据源还有交互模板, MCP 最核心的价值在于它把这些东西标准化了。
Speaker 1 00:04:33
我们反复说了,你可以把 MCP 想象成标准化的插座,反正电压统一,电流稳定,还有漏电保护。而 Skill 呢,就是那些家电本身,它们自带业务逻辑,比如空调知道什么时候该制冷,什么时候该除湿。
10.5 关键截图
10.5.1 能力与连接的双轮驱动架构
10.5.2 MCP 协议核心价值:三通道
10.5.3 三种 "看似可以互相替代" 的轻量场景
📄 来源:092_MCP vs CLI 大模型工具的未来属于谁?16 分钟讲清楚!.md
11 MCP vs CLI:大模型工具的未来属于谁?16 分钟讲清楚!
11.1 视频信息
| 项目 | 内容 |
|---|---|
| 视频名称 | MCP vs CLI:大模型工具的未来属于谁?16 分钟讲清楚! |
| 时长 | 16 分 53 秒 |
| 来源平台 | 抖音 |
| 原始链接 | https://www.douyin.com/video/7703456789012345678 |
| 飞书妙记 | https://www.feishu.cn/minutes/obcnh7i3gk75at5c54nz8x5q |
| 关键词 | MCP、CLI、命令行、工具调用、Token 成本、执行效率、企业级、开发者、工具元信息 |
11.2 全文摘要
本视频深度对比 MCP(模型上下文协议)与 CLI(命令行)两种大模型工具调用方式,探讨大模型工具的未来归属。背景:去年被吹上天的 MCP 突然被顶级开发者冷落 ——Perplexity CTO 公开表示内部全面转向 API 和传统 CLI 准备放弃 MCP,YC CEO 也公开说更倾向用 CLI 而非 MCP,爆火开源项目 OpenClaw 里基本全是命令行在跑找不到 MCP 影子。CLI 的两大核心优势:①Token 消耗特别小 ——MCP 模式下 GitHub 服务打包 44 个工具,元信息共 1683 行 6 万多字符,一次性吃掉约 14268 个 Token,光是让大模型认识工具每次对话就要花好几块钱;CLI 模式只给一个 Bash 工具(说明仅十几行),大模型现场生成命令替代几千行工具元数据,每次提问连一分钱都花不到,完全是降维打击。②执行效率高。大模型不需要挑工具,直接根据问题生成命令。MCP 的不可替代性在于更可控(Controllability)和更安全 —— 灵活性是一把双刃剑,CLI 的万能 Shell 在企业级场景存在安全风险。未来工具部署矩阵:追求效率的个人开发者用 CLI+Skills,追求稳定安全的企业级云端落地方案用 MCP+Skills。
11.3 原文结构化整理
11.3.1 背景:MCP 突然被顶级开发者冷落
信号:
-
2026 年 3 月,Perplexity CTO 在大会上公开表示内部全面转向 API 和传统 CLI 工具,准备放弃 MCP
-
YC CEO 公开说自己现在更倾向于用 CLI 而不是 MCP
-
爆火开源项目 OpenClaw 实际干活过程中基本全是各种命令行在跑,基本找不到 MCP 的影子
核心问题:MCP 明明是专门为大模型量身定制的标准接口,怎么现在反而被几十年前的命令行工具抢了风头?这些古老的命令行到底有什么秘密武器?
11.3.2 CLI 的两大优势:Token 消耗小 + 执行效率高
| 优势 | 说明 |
|---|---|
| Token 消耗特别小 | 不需要给大模型塞大量工具说明书 |
| 执行效率很高 | 大模型直接生成命令,不需要挑工具 |
11.3.3 MCP 费 Token 的实战拆解
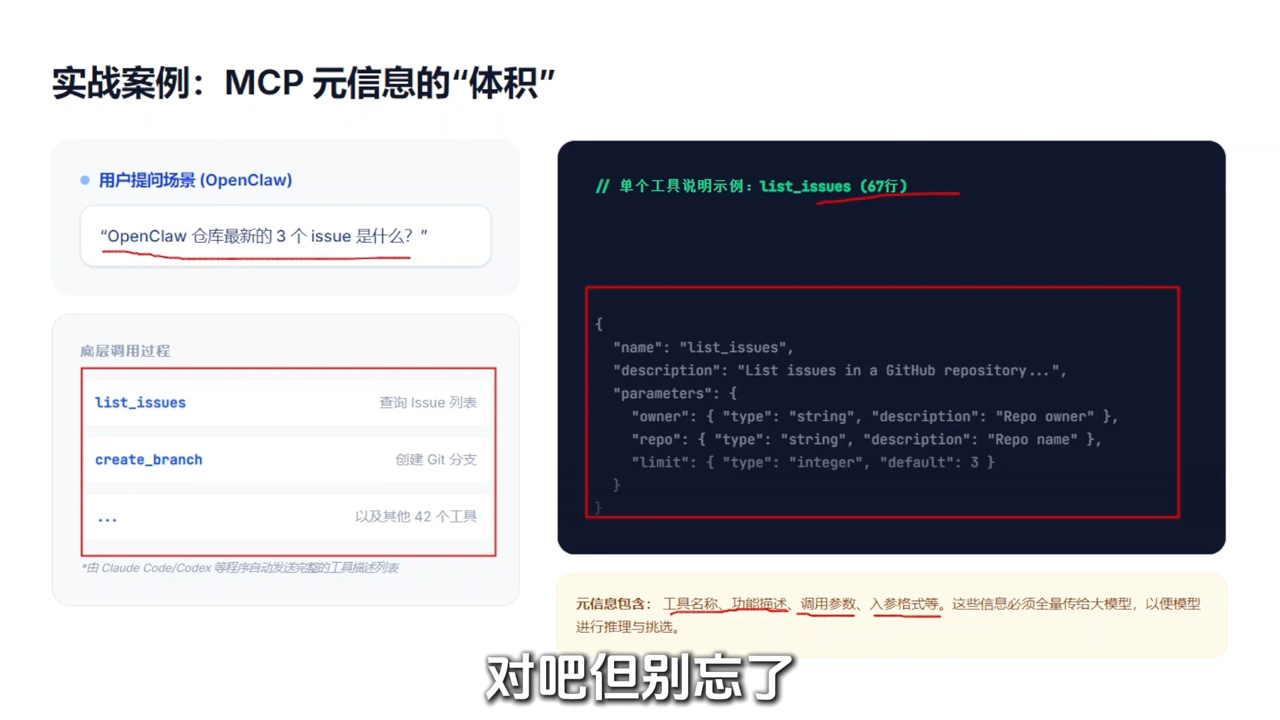
场景:用 OpenClaw 辅助写代码,想看看仓库最新的三个 issue 是什么。
MCP 模式的问题:
-
大模型要知道自己有哪些工具可用,开发端必须把可用工具列表一起塞给大模型
-
发的不是简单的工具名字,而是工具的详细元信息(工具叫什么、能干什么、传什么参数、参数格式)
-
单个
list_issues工具的说明文档就有67 行 -
GitHub 的 MCP 服务打包了44 个工具
-
44 个工具的所有元信息加起来:1683 行代码,6 万多个字符
-
换算成 Token:一次性吃掉约14268 个 Token
-
按 Claude 3.5 Sonnet 价格算:光是把工具列表发给模型,一发一收三毛钱就没了
-
实际开发中可能同时挂好几个 MCP 服务,每次对话光让大模型认识工具就要花好几块钱
CLI 模式的对比:
-
不需要给大模型塞 44 个工具说明书
-
只需要提供一个工具:Bash 命令行工具
-
Bash 工具的说明仅十几行代码,核心意思就一句话:"这是一个用来跑命令的接口,把命令传给我就行"
-
大模型不需要挑工具,直接根据问题现场生成命令
-
一行简单的命令完美替代几千行工具元数据
-
Token 消耗几乎可以忽略不计,每次提问可能连一分钱都花不到
-
完全是一场降维打击
大模型怎么知道 CLI 命令怎么写?
-
像 Git、Grep 这些常用命令行程序,大模型在训练时早就读过成千上万遍官方文档和开源代码
-
这些知识早已在模型参数里,不需要额外提供
11.3.4 MCP 的不可替代性
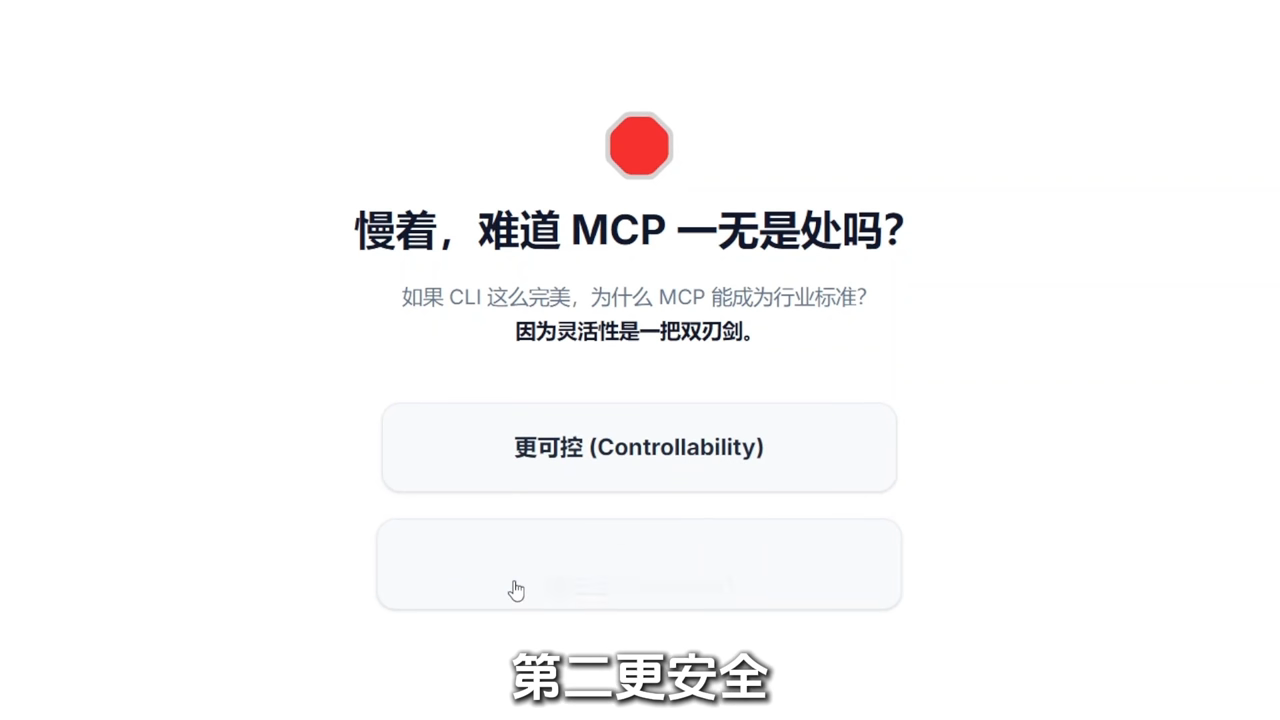
慢着,难道 MCP 一无是处吗?如果 CLI 这么完美,为什么 MCP 能成为行业标准?
答案:因为灵活性是一把双刃剑。
MCP 的两大核心价值:
| 价值 | 说明 |
|---|---|
| 更可控(Controllability) | 每个工具的输入输出都有严格的 Schema 定义,大模型只能调用预定义的工具,行为可预测 |
| 更安全 | 企业级场景下,CLI 的万能 Shell 意味着大模型可能执行任意命令,存在巨大安全风险;MCP 的工具是白名单制,权限可控 |
11.3.5 未来工具部署矩阵
| 场景 | 推荐方案 | 原因 |
|---|---|---|
| 个人开发者 / 本地开发 | CLI + Skills | 极致高效、极致灵活、零额外开销 |
| 企业级云端 SaaS | MCP + Skills | 强安全隔离、标准化远程接入、跨平台互通 |
| 跨平台手机 APP | MCP + Skills | 没有本地文件系统敲命令行,需要标准化协议 |
结论:不是谁取代谁,而是分工不同。MCP 是云端 Agent 唯一标准化接入层,CLI 是本地开发的效率之王。
11.4 完整逐字稿
以下为飞书妙记转写的核心内容(注:转写在约 4 分 37 秒处截断,以下为已获取部分,已覆盖 CLI 优势和 MCP 费 Token 的完整拆解)。
Speaker 1 00:00:00
大模型工具的未来到底属于定制的 MCP,还是原始的 CLI 命令行?为什么本该成为万能接口的 MCP 干起活来总要在中间来回折腾,反复确认?而几行看似简陋的 CLI 命令却能帮我们 1 秒搞定所有复杂的流程。本期视频我们会分为三个部分,带你们把这里面的门道给彻底拆开。首先我们来看 CLI 的两大优势,看它怎么帮我们把 token 成本压到最低,把执行效率呢拉到最满。那既然命令行那么好用,为什么大厂还要死守着 MCP 不放?那第二部分我们来转过头来聊一聊 MCP 的不可替代性。
Speaker 1 00:00:37
最后我们一起来梳理一下,未来的工具部署矩阵,看看对于追求效率的个人开发者和追求稳定安全的企业级云端落地方案,未来到底该怎么选?怎么部署?好,话不多说,我们直接开始。不知道大家最近有没有注意到,去年被吹上天的 MCP,也就是模型上下文协议,好像突然呢,被一些顶级的开发者给冷落了。你看,就在今年的 3 月份, Aplaxy 的 CTO 在一次大会上直接公开表示,他们内部现在已经全面转向了 API 和传统的 CLI 工具,准备放弃 MCP 了。那不仅是他们, YC 的 CEO 也公开说自己现在更倾向于用 CLI,而不是 MCP。
Speaker 1 00:01:18
还有前段时间爆火的开源项目 OpenClaw,如果你去看一下它实际干活的过程,就会发现它里边啊,基本全都是各种命令行在跑,基本找不到 MCP 的影子。这就让我们不得不去琢磨一个问题了, MCP 明明是专门为了大模型量身定制的一个标准接口,怎么现在反而被几十年前的命令行工具抢了风头呢?这些古老的命令行到底有什么秘密武器,能让大模型用的这么顺手?其实啊,仔细拆解下来,命令行工具的核心优势主要是两点。第一个是它的 token 消耗特别小,第二个是执行效率很高。那我们就先来把这第一个问题 token 的开销给它彻底算个明白。
Speaker 1 00:01:58
为什么说 MCP 费 token 呢?我们来举一个具体的一个实战例子。假设我们现在在用 OpenClaw 辅助写代码,想看看这个仓库最新的三个 issue 是什么,顺便帮他们查一下 bug。在这个时候,我们把问题发过去,大模型是没有办法自己直接去上网的,它必须要调用工具。那大模型要知道自己有哪些工具可用的话,就需要开发端把一份可用的工具列表一起塞给大模型。比如说这里面有用来查 issue 的 list issues 工具,有创建 git 分支的 create branch 工具等等。
Speaker 1 00:02:31
但问题就出在这了,我们发给模型的可不是一个简单的工具名字,而是这个工具的详细信息。你看这里面就包括了这个工具叫什么、能干什么、要用的时候要传什么参数、参数得是什么格式,这一堆东西我们在技术上管它叫元信息。光是这一个用来查 issue 的 list issues 工具,它的说明文档就有 67 行,你可能觉得。 67 行也还好吧,对吧?但别忘了,这只是几十个工具里的其中一个。在实际写代码的时候,我们往往会挂载一整个服务,比如 Github 的 MCP 服务,这个服务里可不只有这一个工具啊,它打包了 44 个工具。你想想,如果把这 44 个工具的所有信息加在一起会有多少?我们算了一下,整整有 1683 行代码,有 6 万多个字符。这 6 万多个字符如果换算成大模型的 Token,一次性就要吃掉差不多 14268 个 Token。
Speaker 1 00:03:30
我拿 Claude 3.5 sonnet 价格算了一笔账,光是把这个工具列表发给模型,大模型它还什么都没干呢,这一发一收,三毛钱就没了。而且这还只是一个 GitHub 服务,在实际的开发中,我们可能同时挂着好几个 MCP 服务,光是让大模型认识这些工具,每次对话都要花掉好几块钱,这账怎么算都不划算,对吧?那如果我们换成 CLI 命令行模式,会什么样呢?其实流程也是完全一样的,大模型也需要找工具来查 issue,但是我们不需要给它塞 44 个乱七八糟的工具说明了,我们只需要给它提供一个工具,那就是 Bash 命令行工具。
Speaker 1 00:04:07
这个 bash 工具的说明很简单,就十几行代码,核心意思就一句话,这是一个用来跑命令的接口,你只要把命令传给我就行了。这个时候大模型它不需要挑工具了,它会直接根据你的问题现场生成这样一行命令。你看,这行简单的命令就完美替代了刚才那几千行的工具元数据。跟 MCP 相比,这种模式下的 token 消耗几乎可以忽略不计,每一次提问可能连一分钱都花不到,这完全是一场降维打击。
Speaker 1 00:04:37
不过呢,说到这里,大家可能又有一个疑问了。我们不给大模型发说明书,它怎么知道这个 GH 命令要怎么写呢?它怎么知道要加哪些参数?其实这个道理也特别简单,像 Git、 Grep 这些我们平时经常用的命令行程序,大模型在训练的时候,早就读过成千上万遍它们的官方文档和开源代码了,这些知识早已在它...
11.5 关键截图
11.5.1 实战案例:MCP 元信息的 "体积"(44 工具全量打包)
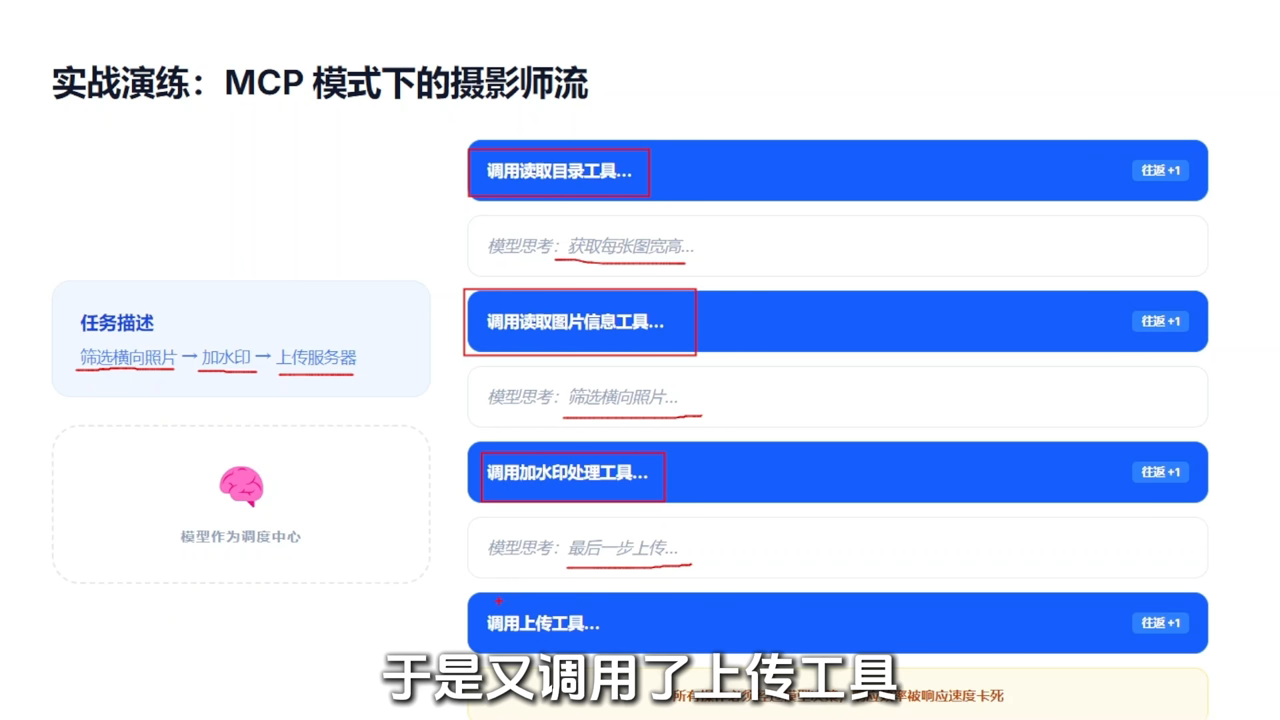
11.5.2 实战演练:MCP 模式下的摄影师流(多次工具调用)
11.5.3 MCP 的价值:更可控、更安全(灵活性是双刃剑)
📄 来源:001_模型评测指标知识点汇总.md (## 三十三、Chat Completions API vs Responses API(OpenAI 两大协议))
11.6 Chat Completions API vs Responses API(OpenAI 两大协议)
11.6.1 定位与用途
Chat Completions API(传统):
-
面向普通聊天对话,无状态,每次请求必须手动把全部对话历史放到 messages 数组传给模型
-
工具调用只能自定义函数,没有内置搜索、代码解释器;联网、文件检索都要自己开发实现
-
适合:简单问答、普通聊天、已有老项目、简单函数调用场景
Responses API(新版 Agent 接口):
-
面向智能体 Agent 应用,原生支持多轮循环工具调用,内置 web 搜索、代码解释器、文件检索等工具,只需简单配置即可启用
-
支持
previous_response_id,不用每次拼接全部历史,传上一轮返回 ID 即可维护会话上下文,减少请求报文大小 -
适合:做 Agent、复杂工具调用、联网检索、多轮复杂任务、文件问答
11.6.2 发布历史时间线
-
2025-03-11(GA 发布):OpenAI 官宣推出
/v1/responses,定位为 Chat Completions + Assistants API 的继任者;核心特性:previous_response_id服务端会话状态、output 多 item 结构、首批内置工具 -
2025-05-21:新增 code_interpreter、MCP 远程工具支持,o 系列推理模型深度适配
-
2025-07:Azure OpenAI 上线 Responses API(预览)
-
2026-01-15:发布 Open Responses 开源协议规范,希望做成跨厂商通用标准
-
2026-08-26:老 Assistants API 正式下线,官方全部迁移导向 Responses API
补充:
-
Chat Completions 2023-03 发布,现已进入维护模式,新 Agent 能力只在 Responses 迭代,但不会下线
-
Responses 目前还不是行业通用标准,只有 OpenAI / Azure OpenAI 原生支持;第三方代理网关兼容度参差不齐
11.6.3 请求 & 返回结构差异对照
| 项目 | Chat Completions API | Responses API |
|---|---|---|
| 接口路径 | POST /v1/chat/completions | POST /v1/responses |
| 输入字段 | messages: [...] | input:字符串 /item 数组 |
| 系统指令 | role: system | role: developer 或顶层 instructions |
| 多轮上下文 | 业务方手动拼接完整 messages 数组 | ① input 拼全历史;② 传 previous_response_id 复用上一轮 response |
| 最大输出 token | max_completion_tokens | max_output_tokens |
| 工具 | tools,只能自定义 function | tools 支持自定义函数 + 内置 web_search/file_search/code_interpreter |
| 参数 n(多候选返回) | 支持 n>1 | 直接移除,不支持 n |
| 返回结构 | choices [0].message,单次返回一条消息 | output 数组,可含多条不同类型 item |
| 工具调用 | tool_calls 嵌套在 message 里 | 工具调用是 output 里独立 item 类型 |
11.6.4 角色 role 的关键变化(重点)
Chat Completions(老接口):messages 数组,角色:
-
role: system:系统提示词,设定身份、规则 -
role: user:用户说的话 -
role: assistant:模型上一轮输出 -
role: tool:工具返回结果
Responses API(新接口):请求参数叫 input,不再叫 messages:
-
⚠️ 没有 system 角色了!替换成 developer
-
role: developer:等价原来的 system,优先级最高,写系统指令、人设规则 -
role: user:用户输入,和老接口一样 -
role: assistant:模型历史回复,和老接口一样
两种写法:
-
极简写法:input 直接传字符串,等价 user 消息
-
数组写法(多轮 + 系统指令):
[{"role":"developer",...},{"role":"user",...}] -
额外:顶层参数
instructions直接写系统提示,等价把 developer 消息放到 input 最前面,二选一即可
11.6.5 迁移小结
| 迁移映射 | 说明 |
|---|---|
| system → developer | 系统指令角色名变化 |
| messages → input | 请求字段名变化 |
| choices[0].message.content → output_text | 返回文本取法变化 |
| 多轮上下文 | 用 previous_response_id 减少报文大小 |
| 工具调用回传 | Chat:role:"tool" + tool_call_id(整段重发历史);Responses:type:"function_call_output" item(可免重发历史) |
| 工具定义 | Chat:tools [].function.{name,description,parameters}(多一层 function 嵌套);Responses:tools [].{name,description,parameters} |
怎么选:
-
普通聊天、简单问答、老系统迁移 → Chat Completions API(生态成熟,SDK 深度支持)
-
Agent、联网搜索、代码运行、复杂多轮工具任务 → Responses API(注意部分旧 SDK / 第三方兼容网关支持度不足)
11.6.6 完整工具调用 Demo(同一需求:查北京明天天气)
场景:系统指令 "你是天气助手,用户问天气必须调用 get_weather 工具";用户输入 "北京明天天气怎么样?";工具 get_weather (city, date)
Chat Completions 第一轮请求:
POST /v1/chat/completions

{

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "model": "gpt-4o",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "messages": \\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\[

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    {"role": "system", "content": "你是一个天气助手,当用户询问天气时必须调用 get\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_weather 工具获取数据后再回答。"},

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    {"role": "user", "content": "北京明天天气怎么样?"}

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  ],

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "tools": \\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\[{

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    "type": "function",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    "function": {

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\      "name": "get\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_weather",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\      "description": "查询指定城市、指定日期的天气情况",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\      "parameters": {

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\        "type": "object",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\        "properties": {

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\          "city": {"type": "string", "description": "城市名,如北京"},

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\          "date": {"type": "string", "description": "日期,格式 YYYY-MM-DD"}

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\        },

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\        "required": \\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\["city", "date"]

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\      }

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    }

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  }],

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "tool\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_choice": "auto"

}
Chat Completions 第一轮返回(模型请求调用工具):
{

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "id": "chatcmpl-9xYzAbC123",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "choices": \\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\[{

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    "index": 0,

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    "message": {

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\      "role": "assistant",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\      "content": null,

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\      "tool\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_calls": \\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\[{

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\        "id": "call\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_abc123",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\        "type": "function",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\        "function": {

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\          "name": "get\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_weather",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\          "arguments": "{\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\"city\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\":\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\"北京\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\",\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\"date\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\":\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\"2026-09-05\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\"}"

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\        }

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\      }]

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    },

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    "finish\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_reason": "tool\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_calls"

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  }]

}
Chat Completions 第二轮请求(把工具结果以 role:tool 回传,必须整段重发历史):
POST /v1/chat/completions

{

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "model": "gpt-4o",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "messages": \\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\[

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    {"role": "system", "content": "你是一个天气助手,当用户询问天气时必须调用 get\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_weather 工具获取数据后再回答。"},

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    {"role": "user", "content": "北京明天天气怎么样?"},

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    {"role": "assistant", "content": null, "tool\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_calls": \\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\[{"id": "call\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_abc123", "type": "function", "function": {"name": "get\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_weather", "arguments": "{\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\"city\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\":\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\"北京\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\",\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\"date\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\":\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\"2026-09-05\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\"}"}}]},

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    {"role": "tool", "tool\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_call\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_id": "call\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_abc123", "content": "{\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\"city\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\":\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\"北京\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\",\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\"date\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\":\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\"2026-09-05\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\",\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\"weather\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\":\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\"晴\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\",\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\"temp\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_high\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\":30,\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\"temp\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_low\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\":21}"}

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  ]

}
Chat Completions 第二轮返回(最终回答):
{

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "id": "chatcmpl-9xYzDeF456",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "choices": \\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\[{

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    "index": 0,

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    "message": {"role": "assistant", "content": "北京明天(9月5日)天气晴朗,气温 21\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\~30℃,适合出行。"},

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    "finish\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_reason": "stop"

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  }]

}
Responses API 第一轮请求(instructions 放系统指令,input 直接传字符串):
POST /v1/responses

{

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "model": "gpt-4o",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "instructions": "你是一个天气助手,当用户询问天气时必须调用 get\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_weather 工具获取数据后再回答。",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "input": "北京明天天气怎么样?",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "tools": \\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\[{

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    "type": "function",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    "name": "get\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_weather",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    "description": "查询指定城市、指定日期的天气情况",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    "parameters": {

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\      "type": "object",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\      "properties": {

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\        "city": {"type": "string", "description": "城市名,如北京"},

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\        "date": {"type": "string", "description": "日期,格式 YYYY-MM-DD"}

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\      },

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\      "required": \\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\["city", "date"]

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    }

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  }]

}
Responses API 第一轮返回(工具调用是 output 里的独立 item):
{

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "id": "resp\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_67aBcD123456",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "object": "response",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "status": "completed",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "output": \\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\[{

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    "type": "function\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_call",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    "id": "fc\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_xyz789",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    "call\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_id": "call\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_abc123",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    "name": "get\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_weather",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    "arguments": "{\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\"city\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\":\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\"北京\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\",\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\"date\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\":\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\"2026-09-05\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\"}"

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  }]

}
Responses API 第二轮请求(用 previous_response_id 复用上下文 + 追加工具结果,不用重发历史):
POST /v1/responses

{

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "model": "gpt-4o",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "previous\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_response\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_id": "resp\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_67aBcD123456",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "input": \\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\[{

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    "type": "function\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_call\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_output",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    "call\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_id": "call\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_abc123",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    "output": "{\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\"city\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\":\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\"北京\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\",\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\"date\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\":\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\"2026-09-05\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\",\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\"weather\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\":\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\"晴\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\",\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\"temp\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_high\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\":30,\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\"temp\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_low\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\":21}"

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  }]

}
Responses API 第二轮返回(最终回答):
{

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "id": "resp\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_67eFgH789012",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "object": "response",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "status": "completed",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "output": \\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\[{

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    "type": "message",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    "role": "assistant",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    "content": \\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\[{"type": "output\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_text", "text": "北京明天(9月5日)天气晴朗,气温 21\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\~30℃,适合出行。"}]

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  }],

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "output\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_text": "北京明天(9月5日)天气晴朗,气温 21\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\~30℃,适合出行。"

}
11.6.7 真实 Response V1 返回样例(腾讯混元 hy4-preview,含推理过程)
真实抓包样例:用
curl -X POST /v1/responses调腾讯混元hy4-preview,input: "你好",非流式返回。 核心看点 :①output数组里同时有type: "reasoning"(推理过程)和type: "message"(最终回答)两类 item;②usage里output_tokens_details.reasoning_tokens单独统计推理 token。
{

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "id": "26967b34-be15-4ff8-b8bc-0babdbe050f1",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "object": "response",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "created\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_at": 1788506041,

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "completed\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_at": 1788506049,

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "model": "hy4-preview",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "status": "completed",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "output": \\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\[

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    {

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\      "type": "reasoning",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\      "id": "rs\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_20260904151409bb9xvji6",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\      "status": "completed",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\      "summary": \\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\[

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\        {

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\          "type": "summary\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_text",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\          "text": "用户发来“你好”,这是一个简单的打招呼。我是混元,由腾讯开发的大模型。我需要以友好、礼貌的方式回应,并简要介绍自己。……"

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\        }

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\      ]

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    },

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    {

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\      "type": "message",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\      "id": "msg\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_20260904151409hpnb9xvj",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\      "status": "completed",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\      "role": "assistant",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\      "content": \\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\[

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\        {

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\          "type": "output\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_text",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\          "text": "你好!我是混元,是由腾讯开发的大模型。很高兴与你聊天,有什么问题或者想聊的话题都可以告诉我呀。"

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\        }

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\      ]

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    }

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  ],

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "output\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_text": "你好!我是混元,是由腾讯开发的大模型。很高兴与你聊天,有什么问题或者想聊的话题都可以告诉我呀。",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "usage": {

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    "input\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_tokens": 28,

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    "output\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_tokens": 84,

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    "total\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_tokens": 112,

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    "output\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_tokens\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_details": {

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\      "reasoning\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_tokens": 56

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\    }

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  },

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "error": null,

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "metadata": null,

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "instructions": "You are a helpful assistant.",

\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\  "parallel\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_tool\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_calls": null

}
从这份真实样例提炼的面试知识点:
-
output数组 = 完整处理链路的 "流水账":一个 Response 里可以同时出现多个 item,每类 item 用type区分。这里type: "reasoning"(模型内部思考的摘要)+type: "message"(最终回答)。判断 "任务是否完成" 要遍历 output 找到 message item,而不是只看第一个元素。 -
reasoningitem 的summary字段:推理模型的思考过程不会把完整思维链(CoT)暴露给客户端,只返回summary(摘要),type: "summary_text"。这是产品安全 / 隐私设计 —— 避免泄露完整推理链,也控制传输体积。 -
usage.output_tokens_details.reasoning_tokens(重点):output_tokens(84)= 推理 token(56)+ 最终回答的 token(28)。推理过程消耗的 token 也计入 output_tokens,是要计费的—— 不是只有最终回答文本才收费。这也解释了为什么同一段回答,推理模型(如 o 系列 /hy4-preview /deepseek-r1)比非推理模型更贵。 -
output_text是快捷字段:顶层output_text直接给出拼接后的完整回答文本,业务侧不用自己遍历 output 数组拼 content,取文本的常规姿势是读它。 -
completed_at/created_at:Unix 时间戳(秒),可用来算端到端耗时(本例约 8 秒),排障时可对比 "API 耗时 vs 推理 token 量"。 -
parallel_tool_calls/metadata/error:并行工具调用开关、自定义元数据、错误对象。error: null表示正常。
面试话术速记:
"Responses API 返回的 output 是一个 item 数组,推理模型的链路会包含 type: reasoning 和 type: message 两类 item;顶层 output_text 直接拿最终回答。usage.output_tokens_details.reasoning_tokens 单独统计推理 token,并且它算在 output_tokens 里一起计费,所以推理模型比普通模型贵,本质是 ' 思考也要付钱 '。"
📄 来源:001_模型评测指标知识点汇总.md (## 三十四、Skill 市场与社区盘点(国内外))
11.7 Skill 市场与社区盘点(国内外)
11.7.1 核心概念澄清:SkillHub vs ClawHub
-
skillhub.cn 是腾讯云 Lighthouse 团队官方维护的 AI-Skill 社区平台,是 OpenClaw 生态的国内本土化镜像平台
-
不是 OpenClaw 官方原生社区;会同步海外 ClawHub 的技能资源,做国内加速、中文检索、安全扫描、合规过滤;支持国内开发者上传发布原创 Skill,明确标注原始来源 ClawHub
-
海外原版叫 ClawHub(OpenClaw 项目官方原生 Skill 注册表),腾讯 SkillHub 是国内镜像增强版,二者不是同一个站点
11.7.2 海外主流 Skill 市场
| 平台 | 运营方 | 定位 | 特点 |
|---|---|---|---|
| ClawHub(clawhub.ai) | OpenClaw 官方团队 | OpenClaw 生态原生官方商店,CLI 默认源 | 上万社区 Skill 首发地;支持版本管理、安全扫描、语义搜索、直接发布;openclaw skill install 一键安装;国内访问慢,是腾讯 SkillHub 的上游源 |
| Skills.sh | Vercel Labs | 跨 Agent 通用技能市场,NPM 风格 | npx skills add 一键安装;展示安装量趋势、热度排行榜;对接 GitHub 源,自动安全风险检测;兼容 Claude Code、OpenClaw 等 |
| SkillsMP(skillsmp.com) | 独立社区项目 | 全球最大聚合搜索引擎 | 自动抓取 GitHub 上所有 SKILL.md,数量极大;⚠️无审核,使用前务必审查源码,有安全风险 |
| LobeHub Skills | LobeHub | 兼顾 Skill + UI 插件 | 支持 SKILL.md 标准,适配 Cursor、Claude Code、OpenClaw;收录 20 万 + 技能包;提供聊天界面渲染组件、侧边面板类 UI 技能 |
| Smithery(smithery.ai) | — | MCP Server 最大公共注册表 | 偏向 MCP 协议工具,大量 MCP 服务可直接部署调用;和 SKILL.md 体系不完全一致 |
| AgentSkills Hub | 第三方 | 聚合多源 Skill | 跨平台统一检索、排行 |
| ClaudeSkills Hub | 社区 | 面向 Claude Code 生态 | 社区人工筛选,偏向 Anthropic 体系 |
| NanoSkill | 独立 | 垂直精品市场 | 营销、SEO 方向,全部人工审核上架,质量高但数量少 |
补充:OpenAI GPT Store 是 GPTs 生态,和 SKILL.md/ OpenClaw 体系不完全兼容。
11.7.3 国内主流 Skill 平台
| 平台 | 说明 |
|---|---|
| 腾讯 SkillHub(skillhub.cn) | 腾讯官方,OpenClaw 生态国内镜像;中文界面、国内高速下载、安全审核;支持个人 / 企业发布,支持 SkillPay 创作者激励 |
| 扣子 Coze 技能商店(字节) | 扣子平台内置技能市场,主要服务扣子 Agent,支持上架售卖技能,生态闭环 |
| 虾技市场(skillcast.cn) | 精品向 Skill 社区,偏向质量,带用户评测反馈,小而美 |
| 智谱 AgentMore Skills 广场 | 整合 SkillHub、开源社区、官方严选,一键安装,适配智谱 Agent 运行环境 |
| GitHub 开源仓库(Awesome-OpenClaw-Skills、Anthropic-skills 等) | 原始源码仓库,无网页商店 UI |
11.7.4 社区活跃度 / 使用量 / 安全性总览
重要前提:没有任何平台能做到 100% 绝对安全。Skill 具备文件读写、命令执行能力,即便标记审核过的技能,企业生产环境依然建议人工复核源码、沙箱测试。
安全分级:
-
✅ 优选:自动化扫描 + 人工精选 / 认证标签,高危恶意技能拦截能力强
-
⚠️ 谨慎:活跃度高,全部开放提交,以社区举报 + 自动扫描为主
-
❌ 不推荐:纯爬虫聚合站,无审核,仅适合找素材
| 平台 | 活跃度 | 安全等级 | 关键安全说明 | 最佳使用建议 |
|---|---|---|---|---|
| ClawHub(海外官方) | ⭐⭐⭐⭐⭐ | ⚠️ 谨慎 | Verified 标记 = 人工审计,其余仅自动扫描;2026-02 发生 ClawHavoc 恶意 Skill 事件 | 只装 Verified、高下载量,必看源码 |
| Skills.sh(Vercel) | ⭐⭐⭐⭐ | ⚠️ 谨慎 | 自动风险扫描,无强制人工审核 | 用作热度参考,规避高风险标记 |
| LobeHub Skills | ⭐⭐⭐⭐ | ✅ 优选(精选区) | 精选人工复核;社区投稿仅自动扫描 | 优先选【精选】分区 |
| Smithery.ai(MCP) | ⭐⭐⭐⭐⭐ | ⚠️ 谨慎 | MCP 工具注册表,认证标记相对可靠 | 用于 MCP 工具 |
| 腾讯 SkillHub(国内) | ⭐⭐⭐⭐ | ✅ 优选(精选) | 精选人工审计(朱雀实验室扫描);普通投稿仅自动扫描;同步 ClawHub 恶意包黑名单 | 优先带【精选】标签技能 |
| 扣子技能商店 | ⭐⭐⭐⭐ | ✅ 优选 | 全量平台审核 | 仅限扣子平台内使用 |
| 虾技市场 | ⭐⭐⭐ | ✅ 优选 | AI + 人工复核,总量偏少 | 中文精品小场景 |
通用安全建议:
-
海外优先选 ClawHub Verified、LobeHub 精选;国内优先腾讯 SkillHub 精选、虾技市场
-
低下载量、新发布、无源码的 Skill 不要直接上生产
-
企业使用前人工阅读 SKILL.md,检查越权读取文件、未知外网请求、prompt 注入风险
-
优先在沙箱 / 容器内测试,不要直接在本机带密钥环境运行陌生 Skill
📄 来源:001_模型评测指标知识点汇总.md (## 三十五、Coze / Skill / Agent 三者关系与 Coze 并入豆包)
11.8 Coze / Skill / Agent 三者关系与 Coze 并入豆包
11.8.1 三者关系
| 概念 | 本质 | 类比 |
|---|---|---|
| Skill(技能) | 一段可复用的能力模块(SKILL.md/ 插件 / 连接器),如查天气、搜网页、读写文件 | 员工的 "岗位技能证书" |
| Agent(智能体) | 有角色设定、能自主决策调哪些技能、按步骤完成任务的主体 | "能干活、会自己安排步骤的员工" |
| Coze(扣子) | 低代码搭建 Agent 的平台:把模型 + 技能 + 知识库 + 工作流拖拽组装成一个 Agent,再一键部署 | "招人、培训、上岗一条龙的 HR + 工厂流水线" |
大白话:Skill 是 "零件",Agent 是 "机器人",Coze 是 "造机器人的工厂"。豆包 / ChatGPT 是造好的通用大脑,Coze 是让你自己 "造专属 AI" 的地方。
11.8.2 Coze 的优势和特点
-
零代码 / 低代码:不懂编程也能拖拽搭建 AI 应用
-
五大核心能力一体:模型调用 + 智能体创建 + 工作流编排 + 知识库 + 插件扩展,全链路可视化
-
一键部署分发:搭好的 Agent 可发布到微信、飞书、Web 等渠道
-
3.0 升级到 "AI 团队协作":一个人调度多个 Agent,甚至把 Claude Code、Codex 等外部 Agent 纳入同一项目空间统一调度
-
开源生态:开源了 Coze Studio、Coze Loop(Agent 全生命周期管理平台),有一定自托管能力
11.8.3 并入豆包的事实(已核实)
-
2026-08-24,36 氪《智能涌现》独家报道:TRAE、扣子(Coze)团队整体并入豆包体系,向豆包产品负责人赵祺汇报
-
分工:TRAE Work、扣子的办公能力与豆包工作场景整合;TRAE IDE 及 CLI 作为豆包品牌下的编程产品线继续发展
-
字节计划推出统一 AI 办公品牌「豆包工作」(媒体口径 "最快本周",官方未确认具体时间)
-
官方回应:为更好协同产品和技术资源,现有用户权益不受影响
-
战略背景:梁汝波在 8 月 6 日年中全员会提出 "高度优先、粗主干、优化长期",希望豆包成为类似抖音的 "主干业务";飞书产品团队 7 月 30 日也已并入豆包
11.8.4 未来定位:弱化还是以豆包为主?
| 层面 | 结局判断 |
|---|---|
| 品牌 / 入口 | ⚠️ 逐步弱化。独立入口淡化,流量和分发规则向「豆包工作」集中,靠扣子接单变现的人受影响最大 |
| 能力层 | ✅ 不会消失。豆包一周上架 200+ 技能 / 连接器,相当一部分就是扣子生态攒下的底子,被吸收复用 |
| 开发者侧 | ✅ 独立延续。原扣子开发平台升级为「扣子编程」,从低代码转向基于 AI 编程的全代码应用开发 |
| 开源侧 | ✅ 保留。Coze Studio、Coze Loop 持续更新,开发者仍可自托管 |
| 生态侧 | 🔄 从 "独立平台" 变成 "豆包工作这个办公入口背后的能力模块" |
本质判断:字节在执行 "赛马结束后收兵" 的路线 —— 市场方向确认后,把分散的团队资源集中到豆包主航道上。扣子积累的智能体生态和连接器体系恰是「豆包工作」最需要的基础设施,是 "能力被扶正",不是 "资产被清零"。
行动建议:
-
轻度用户:不用急着迁,官方承诺权益不受影响
-
付费 / 攒积分用户:先导出备份工作流配置,政策明确前别大额续费
-
靠扣子接单变现的:盯 "流量去哪里",别急着和客户签长约
-
想要数据自主权的开发者:Coze Studio 自托管、Dify、n8n 是备选,但迁移成本高
12 AI 行业观察与生产力思考
体系定位:AI 行业观察与生产力思考(曾鸣访谈 / 资本逻辑 / 行业趋势) 来源文件数:12(内容原封不动按来源保留)
📄 来源:110_AI 时代的生产力革命与长期思考.md
13 AI 时代的生产力革命与长期思考
主题定位 :不偏技术细节,聚焦 AI 对人类文明、生产力结构、组织形态与个人价值的长期影响。 内容来源 :① 曾鸣 × 张小珺《2026,像极了 1995》访谈全录结构化提取(张小珺商业访谈录第 153 期,约 2.5 小时,发布于 2026-09);② 工业革命 vs AI 智力放大的对比分析;③ 李嘉诚 / 巴菲特 2026 年资金回笼逻辑(财经事实 + 逻辑拆解)。 使用场景 :面试中的 "AI 宏观认知 / 长期趋势" 类问题;个人对 AI 时代的战略思考。
13.1 第一章 工业革命放大了体力,AI 放大了智力
13.1.1 三次 "能力外包" 革命
| 革命 | 放大的能力 | 替代 / 外包的对象 | 本质 |
|---|---|---|---|
| 工业革命(18-19 世纪) | 体力 | 肌肉 | 蒸汽机 / 内燃机 / 电动机把 "力气" 外包给机器,生产力不再受身体限制 |
| 信息革命(20 世纪中后) | 算力 | 重复计算 | 计算机把 "计算" 外包,软件处理人类知识(德鲁克 "知识革命") |
| 人工智能革命(21 世纪) | 智力 | 认知劳动 | 把 "推理、规划、语言、判断、创造" 外包 |
核心差异:
-
工业革命放大的体力是边际递减、可标准化的:机器再多,产出按机器数增长
-
AI 放大的智力具有可复制、可规模化、边际成本趋零的特性:一个模型的智力可以同时服务十亿人,这是人类智力永远做不到的
-
所以 AI 不是 "又一个工具",而是第一次把人之所以为人的核心能力(认知)变成了可外购的商品
必须说清的边界:AI 放大的是 "可形式化的认知劳动",不包括身体感知、情感体验、真实世界的因果理解。更准确的说法是:AI 放大了人的 "抽象推理" 智力,而不是 "完整的人"。人类不可替代的部分,恰恰在 AI 覆盖不到的角落 —— 情感、创造、意义感。
13.1.2 德鲁克框架 + 曾鸣的延伸:创造力时代
| 时代 | 时间 | 核心变革 |
|---|---|---|
| 生产力革命 | 工业革命初期 | 流水线取代手工作坊 |
| 管理革命 | 约 100 年前 | 泰勒科学管理,商学院成为新物种 |
| 知识革命 | 1970 年代起 | 软件的核心是处理人类的知识 |
| 创造力时代(曾鸣延伸) | AI 时代 | 所有可以被结构化处理的知识型工作,都会被 AI 接管;人被解放出来去开发新的潜能 —— 创造力 |
曾鸣对创造力的重新定义:
-
创造力 ≠ 简单写首歌、画幅画
-
创造力 = 更原创的 **"定义复杂问题" 的能力 **—— 一种元创造力,无中生有的能力
-
就像电发明、流水线出现后,才诞生了 "产业工人、技术工人、白领" 这些 19 世纪人无法想象的概念;AI 时代也会诞生全新的、今天无法想象的角色
AI 时代人的价值公式:
当智能可以外购(agent 化、token 化),

人剩下的核心价值 = 创造力 + 情感 + 判断力

其中:创造力 = 定义复杂问题的能力(元创造力)
13.2 第二章 曾鸣访谈全录结构化提取:《2026,像极了 1995》
嘉宾 :曾鸣(阿里巴巴前总参谋长、湖畔大学教育长) 访谈 :张小珺商业访谈录・第 153 期(2026-09,约 2.5 小时) 核心判断 :2026 年 ≈ 互联网的 1994-1995 年(浏览器前夜)——AI 第一阶段(模型 / Token)刚刚成熟,第二阶段(Agent)刚刚开场
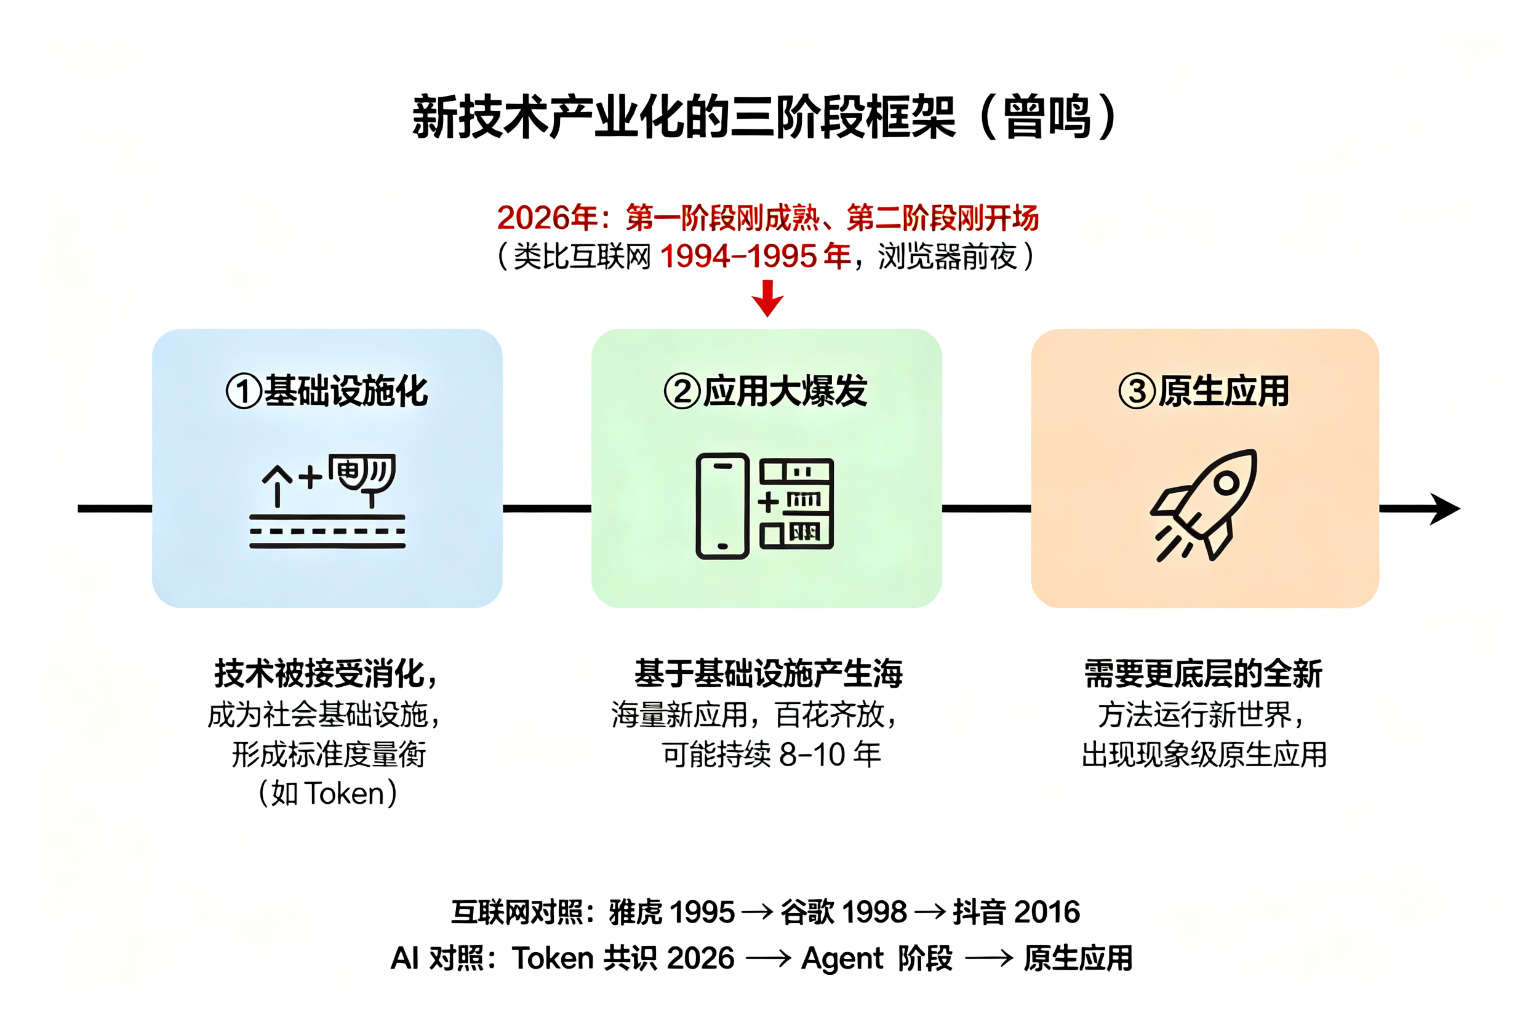
13.2.1 核心框架:新技术产业化的三阶段
| 阶段 | 名称 | 内容 | 对应 AI |
|---|---|---|---|
| 第一阶段 | 基础设施化 | 技术被社会接受消化,成为全社会基础设施,形成标准度量衡 | Token 共识(2026 年初形成) |
| 第二阶段 | 应用大爆发 | 基于基础设施产生海量新应用,百花齐放 | 智能体(Agent)阶段 |
| 第三阶段 | 原生应用 | 海量应用出现后,需要更底层的全新方法运行新世界 | 现象级原生应用 |
关键推论:
-
为什么原生应用不能诞生于第二阶段:应用爆发给了技术下一阶段的发展方向。以移动互联网为例 —— 黑莓 2010 年还占美国智能手机市场 40% 以上,iPhone 4 之后才被反超;有了 App Store 才出现新一代原生应用。真正解决核心需求的主流应用才是原生应用
-
字节案例:文字成熟 → 今日头条;今日头条探索出推荐算法(技术模式 + 商业模式)→ 加带宽算力 → 短视频;短视频 + 推荐算法 → 抖音(现象级原生应用)
-
第二阶段本身非常精彩:"还有可能 8 年、10 年都属于第二阶段 —— 但没有第二阶段的积累,跨不到第三阶段"(曾鸣)
13.2.2 我们具体在哪个时间点?
2026 年是第一阶段基本完成的标志性节点:
-
Token 成为标准度量衡:2026 年初形成广泛共识 —— 黄仁勋说英伟达的未来就是 Token 工厂;奥特曼表达 OpenAI 核心就是卖 Token。"当一个技术有了标准的度量衡,它就能被规模化、标准化地使用 —— 就像一度电、一吨水、一个 GB 流量"
-
第二阶段开场:春节前后 OpenClaw("龙虾")让大家看到能独立完成任务的 Agent 的潜力。AI 进入的第二个阶段就是智能体阶段,智能体就是 AI 时代的新应用
类比互联网:今天是哪一年?
-
曾鸣三年前演讲题目是 "让我们拥抱雅虎吧,雅虎马上来了"
-
今年判断更前移:我们还在等一个 "浏览器" 出来
-
与 Agent 同时出现的词是 Skill(技能),Agent 的本质就是分享能力——1992 年最狂热的是建网站分享信息,今天大家建 Agent 分享能力
-
AGI 这轮创新,让我们从信息时代进入能力时代
13.2.3 判断②:模型公司是未来的 AI 云公司,不是终局赢家
大模型到底是什么?
-
数据是新时代的石油,大模型就是一个炼油厂
-
从基础设施角度看,它像已消失的美国在线 AOL——AOL 让所有人接上互联网,今天大模型让所有人轻易接入智能
-
OpenAI、Anthropic、Kimi、DeepSeek 最后都会变成:AI 云公司
"万亿美元市值" 是一个幻觉(历史对照):
| 公司 | 成立 / 起步 | 市值高点 |
|---|---|---|
| 雅虎 | 1995 年成立 | 2000 年达 1200 亿美元(当年千亿 ≈ 今天 1 万亿) |
| AOL | 1988 年开始服务 | 2000 年估值高点 2200 亿美元 |
| 谷歌 | 1998 年成立 | 2005 年市值 1000 亿美元 |
"当一个技术有这么大冲击力的时候,第一波成功跑出来的公司就有这么大的价值"—— 所以 Anthropic 不到 10 年接近万亿美元市值并不罕见,"这一次不一样" 的叙事是幻觉。
第一阶段的企业很难活到第二阶段:
-
陆奇:OpenAI 未来一定比 Google 大,只是大 5 倍还是 10 倍的问题
-
曾鸣:未来一定会有 10 万亿美元的公司,但未必是现在领跑的 OpenAI 和 Anthropic
-
原因:两个阶段能力要求完全不同 —— 第一阶段靠原创技术创新("可不可用");第二阶段技术放缓、变成大家都能调用的能力,要的是产品力、与普通用户的同理心、上下文管理等应用技术
公共基础设施的宿命:
"公共基础设施的行业,只有一种商业模式成立,叫寡头垄断 + 政府强监管。它很可能往后活得不错,但大概率不是原生应用阶段的大玩家、大赢家。" "只要有同质化的供给,你就不可能获取高额利润,你就是一家不怎么值钱的公司。"
石油比喻:炼油厂和化工厂是两类企业;汽车离开石油肯定不转,但石油公司很难做汽车。
现阶段的优劣之分:
-
2026 年 Anthropic 先领跑、OpenAI 再跟上、谷歌阶段性被甩下 —— 是组织能力和技术能力的差距
-
Anthropic 领跑与 "智能复利" 有关:他们开始用大模型训练大模型,把 AI 工具用到自己的主业上
-
中美是两个不同生态,中国模型公司会持续追赶;今年年底谁跑不到 3T 参数模型,估计就出局了
13.2.4 判断③:Agent 是第二阶段的主体,复杂任务才值得做
简单任务没有长期价值:
-
去年 AI 应用不怎么样,是因为做的都是特别简单的任务(10 个 demo 三五个是做广告的)
-
"做复杂任务,你才有可能建立自己的智能闭环。当智能能力不够的时候,你做应用很大程度上是在做脚手架 —— 等着模型自然溢出,把你脚手架就淹没了"
-
今天做应用的切入点:假定智能完全够用,看它到底能干啥活。越简单的活越容易被复杂的活吞掉
通用 vs 垂直:
-
Manus 抓住 coding 溢出的机会窗,定位通用 Agent、触达 prosumers,切入点是对的
-
今天一个 Agent 要立住,至少要找 10 倍以上切入点才有发展空间
-
垂类:教育、健康是典型大垂类,认真深耕就够了
智能飞轮与黑洞效应:
-
网络效应在 AI 时代继续存在,但已是标配
-
数据本质:越多元化、越差异化的数据越能产生新洞察;同类型数据到一定规模,价值边际递减
-
黑洞效应(网络效应的升级版):应用场景越多、连接越复杂,越能拓宽智能;对应《智能商业》DNA 双螺旋升级:数据智能 → 智能复利;网络协同 → 黑洞的内部网络结构(看能快速吞噬多少场景)
-
新时代会出现双边市场:海量 Agent 开发商 × 海量用户如何匹配;用一个 Agent 可能造成很大负面影响 → 大概率把判断力让渡给信任的独立第三方
应用创业者的反共识阶段:
-
现在是反共识阶段 —— 没有好的应用让大家看到潜力和做法,都在摸索(视频生成已相对成熟,终极目标都是 AI 时代的 TikTok,但都知道离得很远)
-
青黄不接:模型能力已溢出到很多简单任务(它自己就能干了),但还没找到足够大的场景让 AI 做足够复杂、足够有价值的事,还能形成独特技术积累
-
"大部分人低估了 agent 的难度"
-
真实标志:今年普遍感受是 "智能真的能干活了、可以信赖了",开始有人认真想 "我能不能严肃地拿它干点重要的活"—— 这才是应用阶段开始的真实标志
13.2.5 判断④:公司会被淘汰,但组织永远会存在
科层制管理的公司制度会衰亡:
-
"公司早晚会被淘汰 —— 它是跟工业时代一起出现的。工业时代之前没有公司,只有手工作坊。如果工业时代的基本经济规律被挑战,公司这种组织形态肯定也会被挑战"
-
2026 年出现很多 New Lab(新型 AI 研究机构),原因:① 有人看到现有范式天花板(杨立昆从原理上认为有偏差);② 有人认为 scaling law 有边际递减趋势;③ 大模型基础能力到了一定程度,可以做不同路径但很底层的创新(AI for Science)
-
New Lab 不是过渡现象,是新组织形态的早期雏形;真正的第一个 New Lab 是 OpenAI/Anthropic,这一批应该叫 New New Lab
岗位消失,任务登场:
"AI 时代组织的基本单元是任务,不是岗位。大家围绕任务流转,这个组织就完全不一样了。以后找工作找什么?去认领任务。"
-
"AI 嵌入工作流" 只是阶段性产品 —— 因为那个工作流是为人设计的
-
AI 原生组织会从第一天就定义任务、拆解任务、分配任务,硅基员工和碳基员工围绕任务流协同
-
层级会消失:层级存在是因为不知道谁说了算;未来是谁的能力强,谁被调用。传统意义上的中层肯定要消亡
-
传统公司怎么办?转型升级,不换脑袋就换人
未来企业更像合伙人企业:
-
未来战略的生成方式与原有组织不匹配 —— 决策频率越来越高、质量要求越来越高,只有新组织形态才能生成新战略
-
走得足够远的创业者,基本都是自己重写了公司内部运行体系(李志飞把自己关在家里三天写出框架);AI 最大的帮助是快速把原型实现
-
未来 AI 原生组织的第一批 CEO,大概是亲手重写组织运行方式的人 —— 那就是未来组织的神经网络(原来的 ERP 是固化道路,不可能是实时反应的网络)
-
未来组织人更少是肯定的;能适应新组织的是少部分人:非常积极主动、学习能力非常强的人
-
联合创始人会变多:如果一个人不是必不可少,那就不如用 agent 了
-
参照系:律师事务所、咨询公司、投行 —— 很多都是合伙人企业
组织评判标准之一:能不能让人更快乐:
-
年轻人反感 "老登",本质上和 AI 时代的组织变化有关:以前尊老是因为老的经验有价值;现在能转化成知识的经验不再有价值 —— 它都被大模型吸收了
-
年轻聪明人用好 AI 杠杆,瞬间就能成为任何一个领域的专家。你过去 20 年的经验还有啥价值呢?
-
上一个时代的公司让人不快乐,是因为大部分知识工作简单、枯燥、重复、繁琐、没有成长性,而公司用控制性手段把人盯得很死
-
以后一个组织是否优秀的评判标准之一:能不能让人更快乐(从 Google 开始就是这样 —— 尊重人的差异化,释放人的创造力)
13.2.6 判断⑤:从战略规划到战略生成,关键在 "想 3 年"
那个最扎心的第一问:
"10 年以后,你会对怎样的自己满意?"
- 这个问题最能反映这段旅程是什么驱动的。最好的回答是使命 —— 像马云的 "让天下没有难做的生意",像马斯克的去火星
看 10 年、想 3 年、干 1 年:
-
工业时代大部分人记住的是 "看 10 年、干 1 年":成熟世界每年 5%、8% 增长,做今年规划就是线性外推
-
今天:看一年远远不够,你没法线性外推 —— 线性外推不可能得出 Anthropic 今年 80 倍的同比增长;但未来如此不确定,看 10 年也帮不了太多
-
真正的创造力在看 3 年:大概要看两三步 —— 我第一个里程碑是什么?我今年做的第一件重要的事,是为了满足哪一个里程碑?
-
"在一个三维空间思考最优解,跟在二维平面找最优解,完全不是一回事情"
ARR 幻觉实例:有 Agent 创业公司 ARR 涨得很快,曾鸣问 "你继续长两年以后,又怎么样呢?" 对方回去算了发现天花板不高,赶紧去做新事情。"ARR 是很虚幻的事情 —— 拿当下外推 12 个月,很容易让人产生增长的幻觉。"
从战略规划到战略生成:
-
"伟大不能被计划"—— 真正要做的是一套体系、一个环境,让战略洞察涌现出来,成为一个战略不断生成的系统
-
最后的战略是自然而然的决定:合适的时间、合适的人,做了一个合适的决定
-
未来的组织是一个神经网络、一个任务流导向的系统,人跟 AI 都接到系统里,核心是涌现 ——就像大模型一样,实际上是人和 AI 一起在训练一个 "组织的小模型"
-
文化层面:context not control(用透明的信息替代层级指令与审批)重新火了起来。给够、甚至全员共享完整的上下文(Long context),事情就会自然涌现。人和 AI 都要共享 —— 人没有 AI 处理海量信息的能力,但人有瞬间的创造力、和看见不存在的连接的能力
-
文化的核心是创造,像球队:每个人不可缺少,但有明星,有前锋后卫的分工 —— 开放、透明、共享、共创
在巨浪面前,没有人是安全的:
"在巨浪面前没有人是安全的,谁觉得安全,谁就是最不安全的。"
- "AI first、all in AI" 够吗?是必要条件。够不够,要看技术演化路径有多颠覆、新公司获取资源的能力有多大
老物种的退出不可悲:
-
上一个时代的企业能过渡到下一个时代并保持领先吗?不是多不多的问题,是有没有的问题。IBM 做到过一次,微软算是做到过一次
-
微软错过移动互联网,但保住搜索火苗、有云计算积累和 PC OS 垄断,让它在 AI 时代又起了一次机会 —— 但目前模型这块已经出局
-
Google 也许能成为很好的 AI 云公司,但能不能成为消费者级大应用不确定
-
"人有生老病死,公司也有生老病死,没有比这更正常的了。Google 不一定是下个时代的 Google,字节不一定是下个时代的字节"
-
"这一点都不让人绝望:老物种的退出,才给了新物种生长的土壤,年轻人才有梦想"
13.2.7 判断⑥:当智能可以外购,人只剩下创造力
-
德鲁克三阶段(生产力革命→管理革命→知识革命)之后,AI 时代可定义为创造力时代:所有可以被结构化处理的知识型工作,都会被 AI 接管
-
人一方面被逼着开发新的潜能;但也可以认为,人终于被解放出来,可以去开发自己的潜能 —— 这个方向就是创造力
-
创造力 = 更原创的 "定义复杂问题" 的能力(元创造力,无中生有的能力)
-
这种创造可能包括各种各样的情感陪伴、关于人的各种以前没有被满足的需求 ——"它们也许不会让世界有巨大进步,但可能对人类的成长和幸福有很大帮助"
13.2.8 金句总集(原话摘录)
-
"第一阶段的企业,很难活到第二阶段;第二阶段的企业,很难活到第三阶段。"
-
"对比互联网时代,我们现在刚刚走到浏览器阶段,甚至比 Yahoo 还要早。"
-
"直白一点说,模型公司就是未来的 AI 云公司。"
-
"公共基础设施的行业,只有一种商业模式是成立的,叫寡头垄断加政府强监管 —— 我知道这个现实对很多现在创业的人很残酷。"
-
"Anthropic、OpenAI,大概率不是原生应用阶段的大玩家、大赢家。"
-
"只要有同质化的供给,你就不可能获取高额利润,你就是一家不怎么值钱的公司。"
-
"下个阶段就是看谁是 Netscape、谁是 Yahoo,谁把 Agent 的标准建立起来,谁抢住 Agent 的用户入口。未来三年是有可能开始出现 Agent 入口的。"
-
"新的平台大概率不诞生自旧的平台 —— 旧平台做的是简单信息匹配,新平台要做的是能力跟需求的匹配,复杂度高了很多。"
-
"AGI 这轮创新,就是让我们从信息时代进入了能力时代。"
-
"科层制管理的公司制度会衰亡 ——' 公司 ' 会消亡。这没有什么可以遗憾的。"
-
"在巨浪面前没有人是安全的。谁觉得自己安全,谁就是最不安全的。"
-
"CEO 不能有老板心态。谁还认你啊?—— 现在年轻人说 ' 我连老登都不陪玩了 ',我还陪你老板玩?"
-
"上一个时代的企业过渡到下一个时代的企业 —— 基本没有。这一点都不让人绝望:人有生老病死,公司也有生老病死,新公司才有机会,年轻人才有梦想。"
-
"岗位可能不存在了。AI 时代组织的基本单元是任务 —— 以后找工作找什么?去认领任务。"
-
"未来整个企业会越来越像合伙人企业。"
-
"伟大不能被计划。真正要做的是一套让战略洞察不断涌现、生成的体系。"
-
"以后一个组织是否优秀的评判标准之一,是能不能让人更快乐。"
13.2.9 趋势与判断速查表
| 主题 | 判断 | 内容 | 性质 |
|---|---|---|---|
| 阶段定位 | 当前坐标 | 2026 年 = 互联网的 "浏览器前夜"(约 1994-1995 年),第一阶段完成、第二阶段开场 | 当前坐标 |
| 第二阶段长度 | 趋势 | 可能还有 8-10 年属于第二阶段(智能体阶段) | 趋势 |
| Token 共识 | 已发生 | 2026 年初 Token 成为标准度量衡,标志第一阶段成熟 | 已发生 |
| Agent 入口 | 趋势 | 三年内有可能开始出现 Agent 入口;谁建立 Agent 标准,谁就是 Netscape/Yahoo | 趋势 |
| 模型公司终局 | 判断 | 模型公司 = 未来 AI 云公司(寡头垄断 + 政府强监管);大概率不是原生应用阶段的赢家 | 非共识 |
| 智能复利 | 已发生 | Anthropic 用大模型训练大模型,把 AI 工具用到主业,实现领跑 | 已发生 |
| 3T 参数门槛 | 判断 | 今年年底谁跑不到 3T 参数模型,估计就出局了 | 判断 |
| 组织变革 | 判断 | 科层制公司制度衰亡;组织基本单元从岗位变为任务;企业像合伙人企业 | 非共识 |
| 人的价值 | 判断 | 结构化知识工作被 AI 接管;人剩下创造力(元创造力) | 判断 |
13.3 第三章 资本大佬的资金回笼逻辑:李嘉诚、巴菲特 2026 年都在做什么
13.3.1 已确认事实(2026 年)
李嘉诚(一年海外套现超 1700 亿港元,长和 + 长实现金储备超 2100 亿港元,历史之最):
-
2026 年 1 月:出售英国铁路车辆租赁公司 UK Rails 全部权益
-
2026 年 2 月 26 日:长实集团、长江基建、电能实业联合公告,以 1107.5 亿港元清仓英国电网公司 UK Power Networks 100% 股权(法国 Engie 接盘)—— 近年来全球公用事业领域规模最大的交易
-
2026 年 5 月:抛售英国电信业务,套现约 455 亿港元
-
2026 年 8 月:出售澳洲能源企业(客户含力拓、嘉能可,年纯利十几亿港元)约 166 亿港元
巴菲特(伯克希尔):
-
2026 年 Q1:现金储备 3973.8 亿美元,创 61 年最高纪录;其中 3393 亿美元买短期美债(一年利息约 150 亿美元);期内净卖出约 81.5 亿美元股票(连续多季度净卖出)
-
2026 年 Q2:现金储备降至 3655.1 亿美元,股票净买入近 200 亿美元(开始反手重仓科技巨头)
13.3.2 为什么资金回笼?(四层逻辑)
① 资产估值处于历史高位 ——"不赚最后一个铜板"
-
美股在 AI 浪潮下屡创新高;李嘉诚卖的是现金流稳定的 "类债券资产"(公用事业 / 基建)
-
利率上行周期里,类债券资产的估值逻辑被破坏:贴现率上升 → 估值下降。现在卖在高位,将来可以在更低位置买回
-
李嘉诚名言:"不赚最后一个铜板"—— 从不在最高点恋战,在大家还很兴奋时悄悄离场
② 保持流动性 = 抄底期权
-
经济下行 → 企业破产 → 资产价格暴跌 → 手握现金者低价收购(收割破产资产)
-
历史验证过的打法:巴菲特 2008 金融危机后买入高盛、通用电气优先股(年息 10%);李嘉诚 1965 香港银行危机、1997 亚洲金融危机后抄底地产
-
"别人恐惧我贪婪" 的前提就是手里有现金
③ 现金本身有收益
-
高利率环境下短期美债收益率可观(巴菲特 3393 亿美债年利息约 150 亿美元)
-
持有现金的 "机会成本" 很低甚至为正 —— 不用急着把钱投出去
④ 地缘政治风险
- "哪安全我去哪儿"—— 英国的基建属于 "搬不走的资产",一旦地缘风险升级无法变现,所以提前换成流动性更强的现金
13.3.3 什么情况下资产被定义为 "劣质资产"?
关键认知:劣质不是资产的固有属性,而是 "价格 vs 价值" 的相对判断。 同样一个资产,价格低时是优质,价格高时就是 "劣质"。
| 判定信号 | 说明 |
|---|---|
| 价格远超内在价值 | 估值泡沫化:市盈率、市净率显著高于历史中枢 |
| 利率环境变化 | 利率上升 → 债券型资产(公用事业、地产、高股息股)估值承压 |
| 现金流预期恶化 | 增长停滞、政策打压、行业长期衰退 |
| 风险收益比恶化 | 收益率跑不赢无风险利率(美债)+ 风险溢价 |
| 地缘 / 政策风险 | 资产 "搬不走",一旦出问题无法退出 |
结论:李嘉诚卖英国电网不是因为它不赚钱,而是 "在这个价格、这个利率、这个地缘环境下,持有它的风险收益比不如拿现金"。大佬定义" 劣质 " 的标准是风险调整后的预期回报,而不是资产本身的质地。
13.4 附录:信息来源
-
曾鸣 × 张小珺《2026,像极了 1995》访谈全录提炼笔记(张小珺商业访谈录第 153 期,2026-09)
-
新浪财经:《李嘉诚巴菲特同步大换仓!抛弃稳资产,释放重要财富信号》(2026-09-07)
-
新浪财经:《三位顶级大佬同时撤退,什么信号?》(2026-08-22)
-
新浪财经:《李嘉诚巴菲特同步套现,手握现金等待抄底》(2026-08-12)
-
格隆汇:《李嘉诚套现 1100 亿,巴菲特囤了 27000 亿!他们嗅到了什么?》(2026-08-10)
-
雪球:《巴菲特与李嘉诚同步清仓》(2026-04-08)
-
网易:《卖完英国卖澳洲,李嘉诚囤积 2100 亿港元现金!他嗅到了什么危机?》(2026-08-15)
注:访谈内容为公开访谈提炼笔记的结构化整理;财经事实以 2026 年公开报道为准,投资逻辑为基于事实的分析框架,不构成投资建议。
📄 来源:038_Codex 一人做完短视频 Codex 干完自媒体全流程,配音剪片发布全自动.md
14 Codex 一人做完短视频:Codex 干完自媒体全流程,配音剪片发布全自动
14.1 视频信息
| 项目 | 内容 |
|---|---|
| 视频名称 | Codex 一人做完短视频 Codex 干完自媒体全流程,配音剪片发布全自动 |
| 时长 | 2 分 14 秒 |
| 来源平台 | 抖音 |
| 原始链接 | https://www.douyin.com/video/7658765432109876543 |
| 飞书妙记 | https://www.feishu.cn/minutes/obcnh526ufe8s7w91z53fn4h |
| 关键词 | Codex、自媒体、短视频、开源工具、Hyperframes、Voicebox、Vidius、OpenMontage、AI-Tour |
14.2 全文摘要
本视频介绍了 5 个开源工具,配合 Codex 可以一个人干完自媒体全流程(写稿、配音、剪辑、发布)。五个工具分别是:Hyperframes(39.4K star,用 HTML 渲染视频,改文案改配色全是改代码)、Voicebox(48.9K star,本地 AI 语音工作室,几秒克隆声音,7 个 TTS 引擎 23 种语言,接 MCP 让 Codex 自动配音)、Vidius(18.9K star,自动剪片,转文字稿、剪口水词、调色、烧字幕、质检)、OpenMontage(45K star,12 条制作流水线 + 100 多个工具 + 700 多个技能文件,从调研到成片全自动)、AI-Tour(24.6K star,一次上传多平台同时排期发布,评论自动回复)。五个加起来 17 万 star,全部开源免费,Codex/Claude Code/Cursor 通通兼容。
14.3 原文结构化整理
14.3.1 五个开源神器总览
| 工具 | Star 数 | 核心功能 | 解决的痛点 |
|---|---|---|---|
| Hyperframes | 39.4K | HTML 渲染视频 | 不用打开剪辑软件对轨道 |
| Voicebox | 48.9K | 本地 AI 语音工作室 | 不用露脸出声,零云服务费 |
| Vidius | 18.9K | 自动剪片 | 素材攒了一堆懒得剪 |
| OpenMontage | 45K | 全流程自动化 | 想从零一句话出片 |
| AI-Tour | 24.6K | 多平台自动发布 | 片子做完没时间发 |
五个加起来 17 万 star ,全部开源免费,安装基本都是一条命令,Codex/Claude Code/Cursor 通通兼容。
14.3.2 Hyperframes:HTML 渲染视频
-
39.4K star,HeyGen 开源的
-
做视频最烦的就是打开剪辑软件对轨道,它直接把这一步跳过去
-
把想要什么讲清楚,Codex 写一段 HTML,它就渲染成视频
-
改文案、改配色、改时长,全是改代码,一句话重出一版,不用再一帧一帧拖时间轴
14.3.3 Voicebox:本地 AI 语音工作室
-
48.9K star,一整套跑在自己电脑上的 AI 语音工作室
-
录几秒你的声音就能克隆出来,之后打字就等于你在念
-
里面装了 7 个主流 TTS 引擎,23 种语言随便切
-
还能接 MCP,让 Codex 直接调用,稿子写完自动配好音
-
云服务费一分不花
14.3.4 Vidius:自动剪片
-
18.9K star,让 Codex 直接动手剪片
-
工作流程:
-
先把素材转成带时间戳的文字稿
-
自动剪掉口水词和长静音
-
自动调色、识别并烧上字幕
-
自己质检有没有跳帧、有没有爆音,不合格就自动重来一遍
14.3.5 OpenMontage:一句话出片
-
45K star,把 AI 编程工具直接变成一整间视频制作公司
-
内置 12 条制作流水线、100 多个工具、700 多个技能文件
-
说一句想要什么片子,它自己调研、写脚本、生成画面、配音、剪辑,一路做到成片,中间不用你插手
14.3.6 AI-Tour:多平台自动发布
-
24.6K star,压轴工具
-
片子做好了,总不能一个平台一个平台手动传,它把最后这一步也接走了
-
一次上传,多个自媒体平台同时排期发布
-
评论还能自动回复
-
做内容最耗时间的重复劳动到这里清零,一个人也能稳定更新
14.3.7 安装建议
不用五个全装,缺哪补哪:
-
不想开剪辑软件 → 装第一个(Hyperframes)
-
不想露脸出声 → 装第二个(Voicebox)
-
素材攒了一堆懒得剪 → 装第三个(Vidius)
-
想从零一句话出片 → 装第四个(OpenMontage)
-
片子做完没时间发 → 直接上压轴那个(AI-Tour)
14.4 完整逐字稿
以下为飞书妙记转写的完整逐字稿,带时间戳。
Speaker 1 00:00:00
Codex 装上这 5 个开源神器,一个人就能干完自媒体全流程。写稿、配音、剪辑、发布,最耗时间的 4 件事全交给它,一句话就出片,几秒克隆你自己的声音,口水词自动剪掉,字幕自动烧上去,成片还能自动发到多个平台。5 个加起来 17 万 star,全部开源免费,一个人真能顶一个团队。
Speaker 1 00:00:19
第一个 Hyperframes,39.4K star,heygen,开源的。做视频最烦的就是打开剪辑软件对轨道,它直接把这一步跳过去,你把想要什么讲清楚,Codex 写一段 HTML,它就渲染成视频。改文案、改配色、改时长,全是改代码,一句话重出一版,不用再一帧一帧拖时间轴。
Speaker 1 00:00:37
第二个,Voicebox,48.9K star,它是一整套跑在你自己电脑上的 AI 语音工作室。录几秒你的声音就能克隆出来,之后打字就等于你在念。里面装了 7 个主流 TTS 引擎,23 种语言随便切,还能接 MCP,让 Codex 直接调用稿子,写完自动配好音,云服务费一分不花。
Speaker 1 00:00:56
第三个,Vidius,18.9K star,它让 Codex 直接动手剪片,先把素材转成带时间戳的文字稿,再自动剪掉,这类口水词和长静音。接着自动调色、识别并烧上字幕,最后它自己质检有没有跳帧、有没有爆音,不合格就自动重来一遍。第四个,OpenMontage,45K star,这个更狠,它把 AI 编程工具直接变成一整间视频制作公司,内置 12 条制作流水线、100 多个工具、700 多个技能文件。你说一句想要什么片子,它自己调研、写脚本、生成画面、配音、剪辑,一路做到成片,中间不用你插手。
Speaker 1 00:01:31
压轴的 AI Tour,24.6K star,片子做好了,总不能一个平台一个平台手动传,它把最后这一步也接走了,一次上传。多个自媒体平台同时排期发布,评论还能自动回复。做内容最耗时间的重复劳动到这里清零,一个人也能稳定更新。这五个神器全部开源免费,Github 加起来 17 万 star,安装基本都是一条命令,Codex、Claudecode、Cursor 通通兼容。不用五个全装,缺哪补哪。不想开剪辑软件,装第一个。不想露脸出声,装第二个。素材攒了一堆,懒得剪,装第三个。想从零一句话出片,装第四个。片子做完没时间发,直接上压轴那个。五个神器的详细安装教程我都整理好了,感兴趣的话可以直接分享给大家。
14.5 关键截图
14.5.1 五个开源神器总览
14.5.2 Hyperframes 和 Voicebox
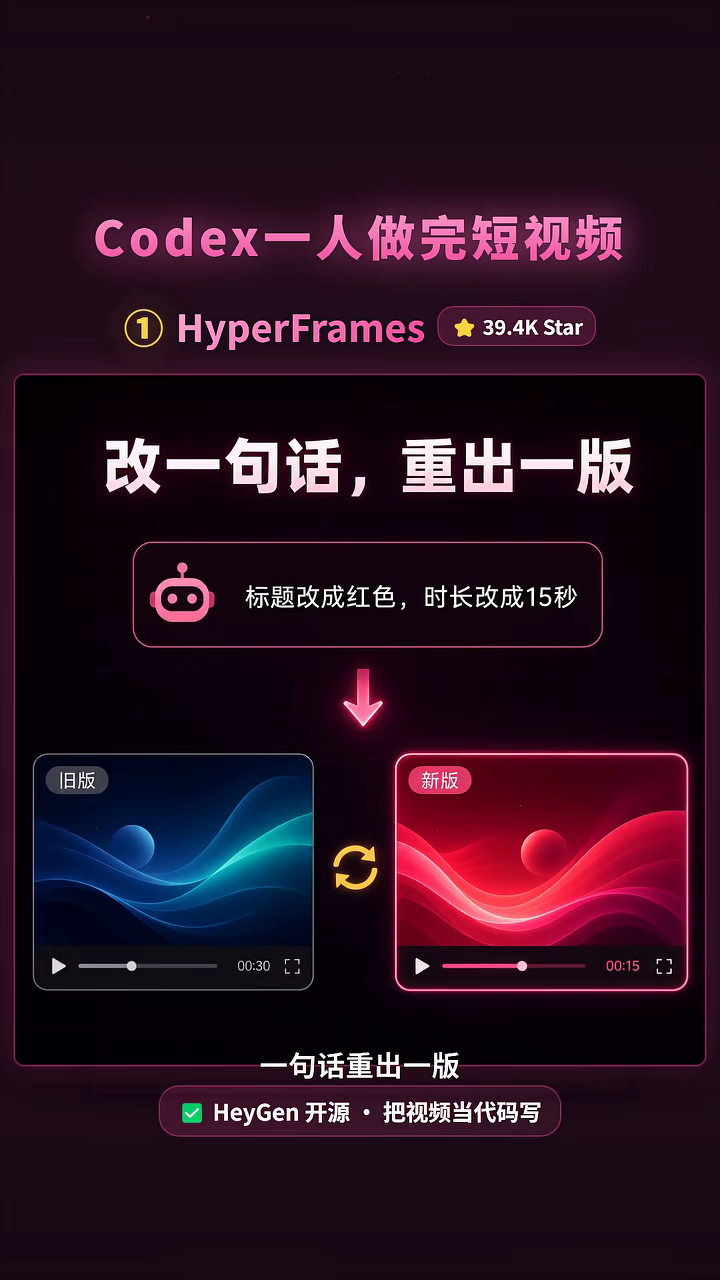
14.5.3 Vidius:自动剪片(剪口水词)
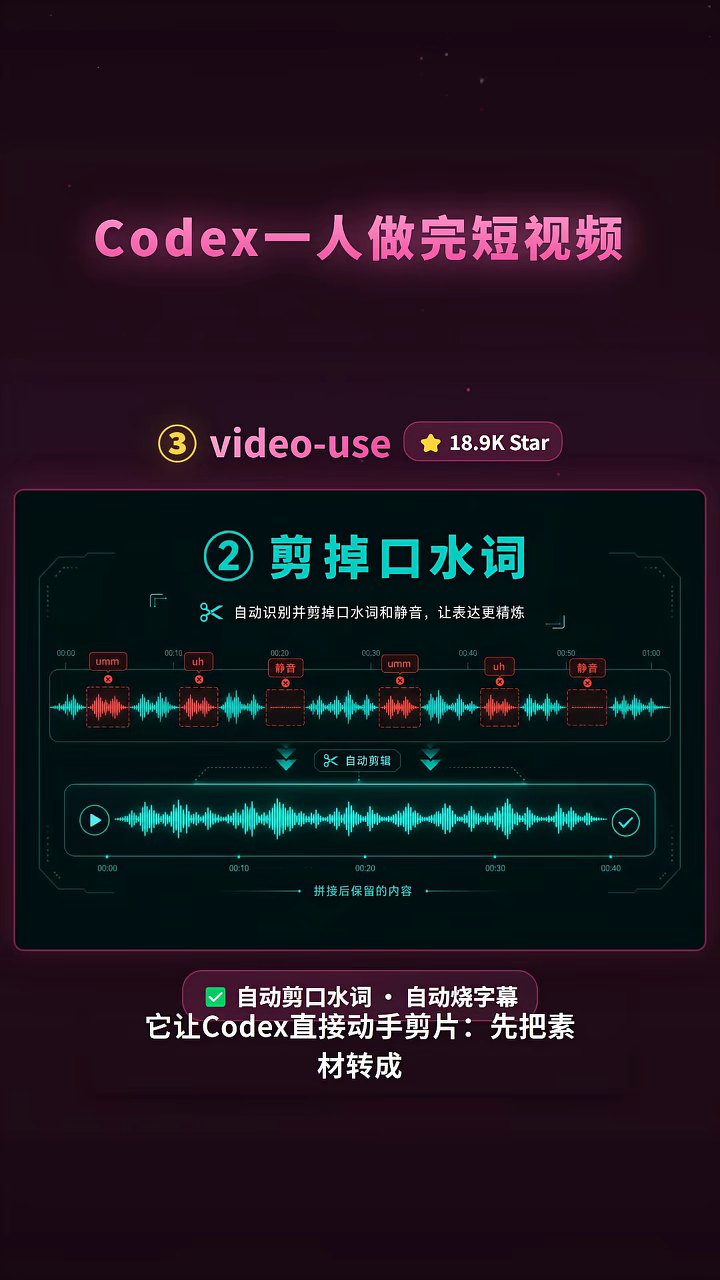
14.5.4 OpenMontage 和 AI-Tour
📄 来源:064_AI 时代 内容创作和产品营销的 5 个趋势.md
15 AI 时代内容创作和产品营销的 5 个趋势
15.1 视频信息
| 项目 | 内容 |
|---|---|
| 视频名称 | AI 时代 内容创作和产品营销的 5 个趋势 |
| 时长 | 3 分 27 秒 |
| 来源平台 | 抖音 |
| 原始链接 | https://www.douyin.com/video/7676789012345678901 |
| 飞书妙记 | https://www.feishu.cn/minutes/obcnh5c87g6y3sl9noxap2wd |
| 关键词 | AI 内容创作、产品营销、go to market、活人感、builder、influencer、AI slop、opinionated product |
15.2 全文摘要
本视频分享了 AI 时代内容创作和产品营销的 5 个趋势:第一,代码变便宜了,注意力变贵了 —— 以前 "talk is cheap, show me the code",现在是 "code is cheap, show me the talk",做产品太容易(Agent 十分钟搞定),最难的是 go to market,获取注意力越来越难;第二,AI 生成内容越多,活人感就越重要 —— 用 AI 提效同时确保内容有灵魂、有活人感,真实感大于精致感,出镜讲解是最高效也最有门槛的方式;第三,Builder 和 Influencer 两个概念越来越重叠 —— 做产品的要为自己产品代言(自己就是 CMO),做内容的要把能力产品化,产品品牌和个人品牌越来越重合,Influencer 做 Builder 自带分发和流量优势;第四,AI Slop 的根源不是表达问题而是没有灵魂 ——AI 无法脱离人生体验和真实感想表达,讲出来一定是平均值的平均值,各种 "让内容不像 AI" 的 skill 只解决表象;第五,代码正在成为自我表达的媒介 —— 每个 skill、每个产品都是一个观点,要做 opinionated product(有观点的产品),用户用产品是因为认可背后的观点,啥都能干的 general 产品不如去用 Codex。
15.3 原文结构化整理
15.3.1 趋势一:代码变便宜了,注意力变贵了
-
以前:talk is cheap, show me the code(空谈无用,拿出代码来)
-
现在:code is cheap, show me the talk(代码太便宜,拿出你的表达 / 观点来)
-
做一个产品太容易了 —— 以前可能要一个月做出来,现在 Agent 十分钟搞定
-
最难的是go to market(市场推广)
-
跟很多创业者和 OPC 交流,现在大家最大的卡点就是营销和推广
-
获取人的注意力变得越来越难,产品太多(每天至少五个人让试用产品)
-
怎么正确抓住注意力、让人对产品产生好奇,是非常难的事情
15.3.2 趋势二:AI 生成内容越多,活人感就越重要
-
打开各种社交媒体,很多内容一看就是 AI 写的
-
用 AI 做内容本身没有问题,但要在用 AI 提效同时,确保内容是有灵魂的、有活人感的
-
为什么一直出镜来讲?
-
最高效:出镜录是门槛最低也最快的方式,没有时间用 AI
-
让大家感受到内容背后是一个活人,非常重要
-
看到一看就是 AI 的内容,就没有兴趣往下看了
-
真实感大于精致感—— 不会花特别多时间把内容做得很精美,但活人感很重要
15.3.3 趋势三:Builder 和 Influencer 越来越重叠
-
以前觉得要不就是做产品的(builder),要不就是做内容的(influencer)
-
现在这两件事是一件事,最厉害的人一定是两个一起做
| 身份 | 应该做什么 |
|---|---|
| Builder(创业者) | 要为自己的产品代言,自己就是自己的 CMO |
| Influencer(内容创作者) | 应该把自己的能力产品化 |
-
产品品牌和个人品牌会越来越重合
-
Influencer 做 Builder 很有优势 —— 自带分发和流量优势,而现在创业者全都卡在推广这一块
15.3.4 趋势四:AI Slop 的根源是没有灵魂
-
社交媒体上充斥着大量 AI slop(AI 生成的低质内容)
-
市面上有很多 skill,比如帮你去破折号、帮你改写,让内容看起来不那么像 AI
-
但这些 skill 只解决了表象问题,没有解决 AI slop 的根源
-
AI slop 的根源是没有灵魂的问题:
-
AI 没有办法脱离你的人生体验和真实的感想去表达
-
它讲出来一定是平均值的平均值
-
核心问题:在用 AI 做内容同时,怎么让它有灵魂?
15.3.5 趋势五:代码正在成为自我表达的媒介
-
在 GitHub 上做了很多 skill,每一个 skill 都是一个观点
-
slides 不是 PowerPoint 是 HTML—— 观点是 "HTML 就应该取代 PPT"
-
follow builders—— 首选了二十几个值得关注的 builder,观点是 "follow builders not influencers"
-
好的产品本身就是一个大家愿意分享的观点
-
要做opinionated product(有观点的产品)
-
大家用这个产品是因为认可背后的观点
-
如果只做一个非常 general 的产品,啥都能干、谁都是目标受众,那还不如去用 Codex
-
既然要做自己的产品,必须有非常鲜明的观点和个性在后面,这个故事才能讲出去
15.4 完整逐字稿
以下为飞书妙记转写的完整逐字稿,带时间戳。
Speaker 1 00:00:00
这是我认为 AI 时代内容创作的五个趋势。第一个趋势是代码变便宜了,注意力变贵了。Code is cheap, attention is expensive. 之前大家会说 talk is cheap, show me the code. 但我认为现在是 code is cheap, show me the talk. 做一个产品太容易了,你以前可能要一个月做出来的,现在 agent 十分钟给你搞定。那么最难的最难的就是 go to market,就是因为我跟很多创业者和 OPC 交流,现在大家最大的卡点就是营销和推广,获取人的注意力变得越来越难,而且现在的产品太多太多了,真的是每天都有至少五个人让我试用他们的产品。那你怎么能正确的抓住我的注意力,让我对你的产品产生好奇,是一件非常非常难的事情。
Speaker 1 00:00:41
第二个趋势是我觉得 AI 生成内容越多,活人感就越重要。因为现在你打开各种社交媒体,很多内容一看就是 AI 写的。我觉得用 AI 做内容本身没有问题,但是你要在用 AI 提效同时,还确保内容是有灵魂的,是有活人感的。因为我自己的视频,为什么我一直是出镜来讲的?是因为我觉得首先这对我来是最高效的,我觉得我出镜录是一个,其实是门槛最低也最快的。我没有时间用 AI,对,另外我觉得让大家感受到这个内容背后是一个活人,非常非常的重要。反正我自己看到那种一看就是 AI 的,我就没有兴趣往下看了。对,所以我觉得真实感大于精致感,我不会花特别多时间去把它做得很精美,但是我觉得活人感很重要。
Speaker 1 00:01:28
第三个趋势是我觉得 builder 和 influencer 这两个概念正在越来越重叠。以前大家会觉得你要不就是做产品的,你要不就是做内容的,但是我觉得这两件事是一件事,最厉害的人一定是两个一起做。如果你是一个 builder,你是创业,你要做产品,你要为自己的产品代言,你自己就是自己的 CMO。如果你是一个 influencer,你做内容,那你也应该把自己的能力产品化。所以产品品牌和个人品牌会越来越重合,这也是为什么我觉得其实 influencer 做 builder 是很有优势的,因为自带分发和流量的优势,因为现在创业者全都卡在推广这一块。
Speaker 1 00:02:04
下一个是关于 AI slop 相关的,就是刚才讲到社交媒体上充斥着大量的 AI slop,市面上有很多 skill,比如说帮你去破折号,然后帮你改写,让它看起来不那么像 AI。但是我觉得这些 skill 只解决了表象的问题,它没有解决 AI slop 的根源。我觉得 AI slop 的根源是没有灵魂的问题,就是 AI 没有办法脱离你的人生体验和你的真实的感想去表达,它讲出来一定是平均值的平均值。所以我们还是要想说,在用 AI 做内容同时,怎么让它有灵魂?
Speaker 1 00:02:35
第五个是我觉得代码正在成为一种自我表达的媒介。比如说我在 GitHub 上做了很多 skill,我觉得每一个 skill 都是我的一个观点。比如说这个 slides 不是一个 PowerPoint,是一个 HTML,这就是我的一种观点,我认为 HTML 就应该取代 PPT。比如说我的 follow builders,就是我首选了二十几个 builder,我认为值得关注的,那这个背后的观点就是 follow builders not influencers。所以我觉得好的产品本身就是一个大家愿意分享的观点。我们要做一个 opinionated product,有观点的产品。大家用这个产品是因为他认可背后的观点。如果你只做一个非常 general 的产品,这个产品啥都能干,谁都是你的目标受众,那我还不如去用 Codex。你既然要做一个你的产品,你必须得有一个非常鲜明的观点和个性在后面,这个故事才能讲出去。
15.5 关键截图
15.5.1 AI 时代内容创作 5 个趋势总览
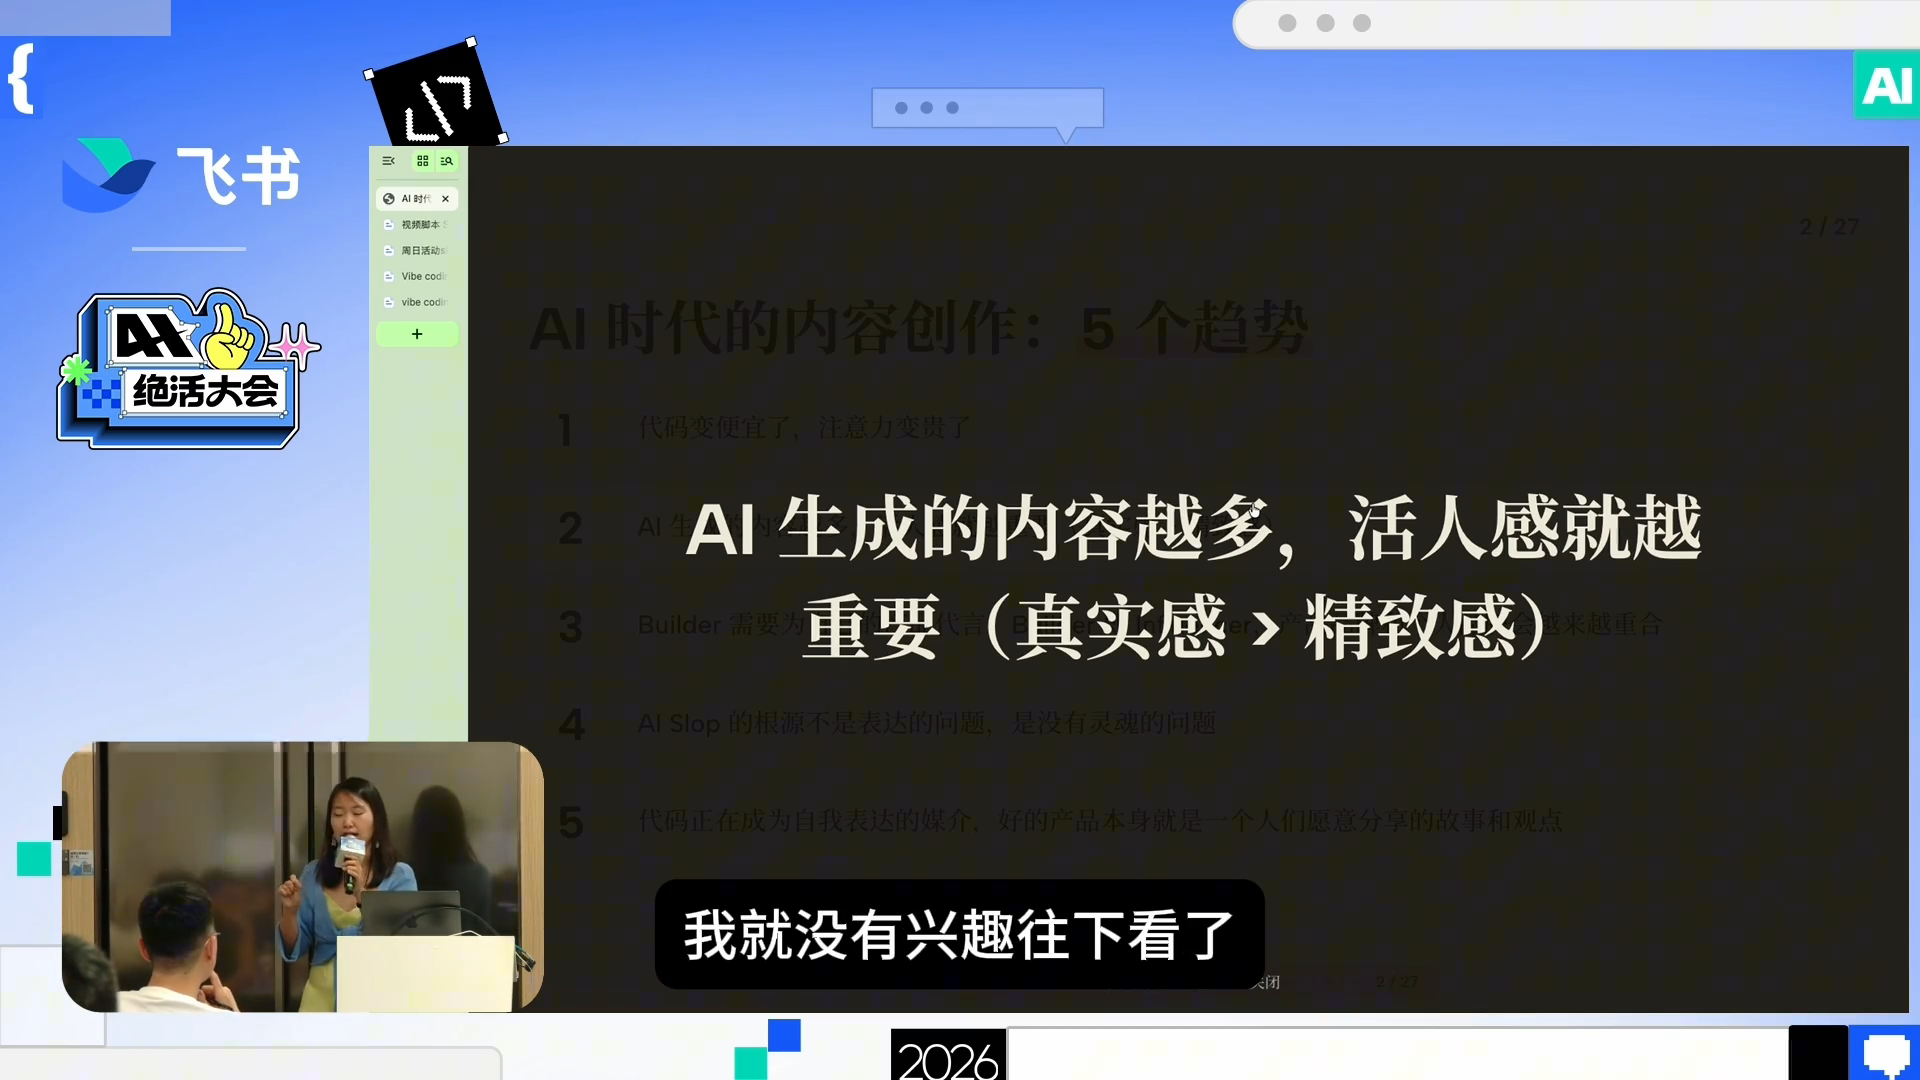
15.5.2 Builder 与 Influencer 重叠趋势
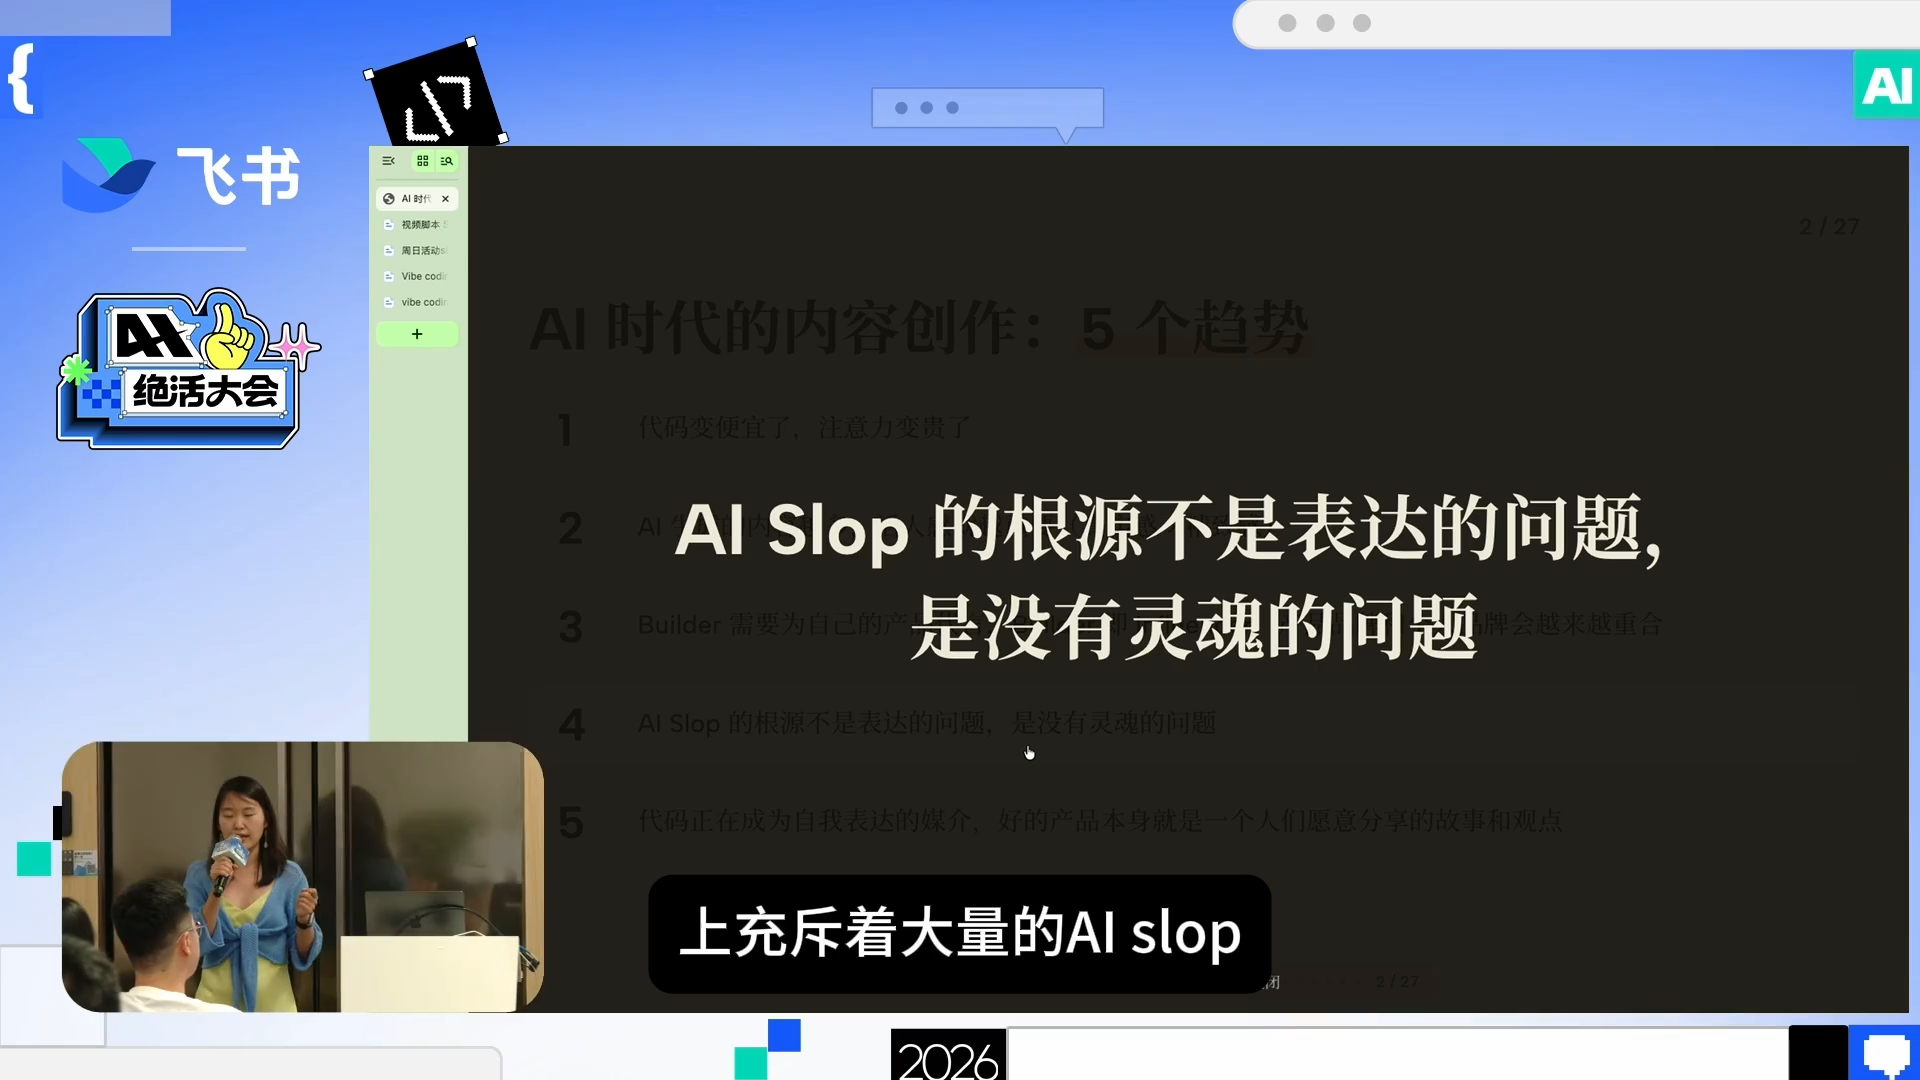
📄 来源:091_DeepSeek 一天消耗八万亿。这是对于硅谷 Ai 的斩杀线.md
16 DeepSeek 一天消耗八万亿,这是对于硅谷 AI 的斩杀线
16.1 视频信息
| 项目 | 内容 |
|---|---|
| 视频名称 | DeepSeek 一天消耗八万亿,这是对于硅谷 AI 的斩杀线 |
| 时长 | 4 分 51 秒 |
| 来源平台 | 抖音 |
| 原始链接 | https://www.douyin.com/video/7702345678901234567 |
| 飞书妙记 | https://www.feishu.cn/minutes/obcnh7ax7n4v3i4nf62u9i7e |
| 关键词 | DeepSeek、八万亿 Token、硅谷、定价权、降维打击、OpenAI、Claude、GPT-5.6、性价比、AI 初创公司 |
16.2 全文摘要
本视频分析 DeepSeek 日消耗八万亿 Token 对硅谷 AI 行业的冲击。8 万亿 Token 的意义:它是 OpenAI、Google 及其他 AI 巨头加起来总额度的总和(他们每天总额度也就 6.6 万亿),DeepSeek 一家的调用量把全世界所有 AI 巨头加在一起还甩在后面。目前全世界能达到每日万亿级 Token 消费的只有 4 家,包括 DeepSeek。"斩杀线" 最有意思的地方在于它没有杀最弱的也没有杀最强的,杀的是那些比 DeepSeek、Windsurf、Flash 稍微强一点点的厂家 —— 他们性能上和 DeepSeek 没什么差异,但 DeepSeek 攒的是整个 AI 行业的暴利和硅谷单方面的定价霸权。成本对比:旧金山评测机构跑完所有大模型,DeepSeek V4 Flash 单次测试成本只有 3 美分,而 Claude 是 3.15 美元,差了 105 倍(两个数量级)。AI 创业公司每月推理成本 10 万美元,换成 DeepSeek 1000 美元搞定,省下来的钱够多招 10 个工程师 —— 这不叫性价比高,叫降维打击。OpenAI 慌到 7 月 30 号没有任何预告,GPT-5.6 Luna 全线降价 80%,输出价格从每百万 Token 6 美元砍到 1.2 美元,但还是比 DeepSeek 贵 4 倍以上,且这款模型上线才三周(正常调价周期半年以上)。美国企业用得欢:企业费用管理平台 6 月趋势榜上 DeepSeek 登顶趋势软件供应商第一名,AI 聚合平台流量份额从不足 1% 涨到 17%,模型下载量 9 月暴涨 960%。性能方面 V4 Flash 综合性能追平 GPT-5.6 Luna,代码、数学、长文本硬核任务甚至有过之而无不及,智能指数比 Claude 顶配只差 6 分但为这 6 分要多花 52 倍的钱。结论:定价权已经从硅谷转向中国,8 万亿 Token 只是开始。
16.3 原文结构化整理
16.3.1 万亿 Token 的意义:一家超过全球巨头总和
| 指标 | 数据 |
|---|---|
| DeepSeek 日消耗 | 8 万亿 Token |
| OpenAI+Google + 其他 AI 巨头日总额度 | 6.6 万亿 Token |
| 差距 | DeepSeek 一家 > 全世界所有 AI 巨头总和 |
欧美网友的形容:DeepSeek 是全世界所有 AI 巨头的 "宰杀线"。有漫画形容 DeepSeek 梁文锋开个联合收割机,前面 OpenAI、Google 正在拼命向前跑,但凡哪个企业慢一点就会被卷入收割机。
行业格局:目前全世界能达到每日万亿级 Token 消费的只有 4 家,其中包括 DeepSeek。
16.3.2 "斩杀线" 的真正含义:杀的是中间层
DeepSeek 被称为斩杀线,最有意思的地方在于:
-
没有杀最弱的—— 弱的本来就活不下去
-
没有杀最强的—— 最强的有自己的生态和壁垒
-
杀的是中间层—— 那些比 DeepSeek、Windsurf、Flash 稍微强一点点的厂家
这些厂家性能上和 DeepSeek 没什么差异,但 DeepSeek 攒的是:
-
整个 AI 行业的暴利
-
硅谷单方面的定价霸权
硅谷投资人预测:2026 年全美 AI 初创公司失败率将达到 95% 以上。
案例:
-
马斯克的 XAI:当年 2500 亿美元估值,说没就没了,11 个联合创始人早就跑光了
-
YUPPI AI:A16Z 领投 3300 万美元,上线不到一年直接关停
-
AI 写作第一股:估值 12.5 亿美元,最后被贱卖
-
原因:商业模式在 DeepSeek 的定价面前根本活不下去
16.3.3 成本对比:105 倍的降维打击
旧金山评测机构跑完所有大模型的结果:
| 模型 | 单次测试成本 | 对比 |
|---|---|---|
| DeepSeek V4 Flash | 3 美分 | 基准 |
| Claude | 3.15 美元 | 贵 105 倍(两个数量级) |
对企业的影响:
-
AI 创业公司每月推理成本 10 万美元
-
换成 DeepSeek:1000 美元搞定
-
省下来的钱够多招 10 个工程师
这不叫性价比高,它这叫降维打击。
16.3.4 OpenAI 的慌乱:仓促降价 80% 仍贵 4 倍
| 事件 | 细节 |
|---|---|
| 降价时间 | 7 月 30 号,没有任何预告 |
| 降价幅度 | GPT-5.6 Luna 全线降价 80% |
| 输出价格 | 从每百万 Token 6 美元直接砍到 1.2 美元 |
| 反常之处 | 这款模型上线才仅仅三周,正常调价周期在半年以上 |
| 降价后对比 | 仍比 DeepSeek 贵 4 倍以上 |
原因:如果不这么做,DeepSeek 勾在后面会继续杀他。降价消息刚发出去,第二天 DeepSeek 就出新品了。OpenAI 产品负责人亲自下场推销,却被消费者各种嘲讽。
16.3.5 美国企业用得欢:嘴上喊主义,账单看生意
最讽刺的现实:
-
美国政府抵制得欢,但底下企业用得欢
-
企业费用管理平台 6 月趋势榜上,DeepSeek 登顶趋势软件供应商第一名
-
美国公司正在批量给 DeepSeek 打钱 —— 不是下载开源权重自己部署,而是调用 DeepSeek 的 API 付费(数据直接发给中国公司)
-
AI 聚合平台上,DeepSeek 流量份额从当年不足 1% 涨到17%
-
DeepSeek 模型下载量 9 月份暴涨960%
在绝对的价格优势面前,竞争对手根本没法竞争。他们嘴上喊的是主义,但你看看账单就全是生意。
16.3.6 性能不输:追平 GPT-5.6,硬核任务甚至更强
| 维度 | DeepSeek V4 Flash 表现 |
|---|---|
| 综合性能 | 追平 GPT-5.6 Luna |
| 代码、数学、长文本 | 甚至有过之而无不及 |
| 智能指数 | 比 Claude 顶配只差 6 分 |
| 为这 6 分多花的钱 | 52 倍 |
这笔账是个人算算就知道,除非绝对需要,谁去用 Claude?
16.3.7 定价权转移:从硅谷到中国
以前:全球大模型的价格,OpenAI 说的算,说多少就是多少,爱用不用。
现在:DeepSeek 说这个价格我定了 ——
-
你跟,你就得把利润吐出来
-
你不跟,你开发者就得全跑光,没人跟你
美国政府的困境:
-
国防部把 DeepSeek 禁了
-
德州、纽约州也把 DeepSeek 禁了
-
国会甚至还要永久立法封杀
-
但财政部刚刚威胁要制裁中国模型,硅谷有 200 家企业去联名反对 ——"你要是封我,疼的就是美国的经济"
结论:美国政府想要抑制 DeepSeek,可市场要发展要生存。当一个好用的东西比 OpenAI 便宜 100 倍,所有的封锁最后就变成塞子一样,消费者自己想办法会去得到价格比他们便宜无数倍的 DeepSeek(他们也会翻墙)。
这 8 万亿 Token,它只是开始。当全世界的 AI 定价权真正握在中国人手里那一天,那可能才是改变世界命运的时刻。
16.4 完整逐字稿
以下为飞书妙记转写的完整内容(注:转写在约 4 分 07 秒处截断,视频总长 4 分 51 秒,已覆盖绝大部分核心内容)。
Speaker 1 00:00:00
DeepSeek 率先达到 8 万亿 token 一天啊,欧美的科技巨头们正在瑟瑟发抖。大家知道 8 万亿 token 它的意义是什么吗?因为它是 OpenAI、 Google 以及其他 AI 巨头加起来总额度的总和。因为他们现在加起来每天的总额度也就 6.6 万亿 token,也就是说 DeepSeek 它一家的调用已经把全世界所有 AI 巨头加在一起还甩在后面了。我是关子谭。
Speaker 1 00:00:23
欧美网友的形容其实更加具体啊,他们说 DeepSeek 是全世界所有 AI 巨头的宰杀线。有欧美网友做了一个漫画,说 DeepSeek 梁文锋开个联合收割机,前面 OpenAI、 Google 啊正在拼命的向前跑。但凡哪个企业慢一点,就会被卷入到 DeepSeek 的收割机里。就是目前全世界能达到每日万亿级 token 消费的只有 4 家,其中就包括 DeepSeek。
Speaker 1 00:00:45
而 DeepSeek 被称为斩杀线,最有意思的地方在于它其实没有杀那些最弱的,也没有杀最强的,它杀的就是那些比 DeepSeek、Windsurf、 Flash 稍微强那么一点点的厂家。就是这些厂家,他们的性能上和 DeepSeek 没什么差异,但是 DeepSeek 它攒的是什么?它攒的是整个 AI 行业的暴利,攒的就是硅谷单方面的定价霸权。
Speaker 1 00:01:04
最后这些公司通通都会被 DeepSeek 的收割机给收割,而且硅谷的投资人这两年已经给出预测,说 2026 年啊。全美 AI 初创公司里,估计失败率将会达到 95% 以上, 4 家里面的 19 家。而马斯克的 XAI,他当年可是 2500 亿美元的估值啊,但是说没就没了,而他 11 个联合创始人也早就跑光了,最后他被塞进了 CBC SEX 里面。而你像之前的 YUPPIA, A16Z 领投了 3300 万美元,上线不到一年直接关停。而曾经的 AI 写作第一股,估值 12.5 亿美元,最后被贱卖,为什么?因为他们的商业模式在 DeepSeek 的定价面前根本活不下去。所以咱们算一笔账啊,因为旧金山的评测机构,他跑完了所有的大模型,他发现 DeepSeek 维斯弗莱什。单次测试成本只有 3 美分,而 Claude 呢,是 3.15 美元,差了 105 倍。你可要注意啊,这可不是贵一点点呢,是贵了两个数量级。你要是 AI 创业的公司老板,你每月推理成本是 10 万美元,你要换成 DeepSeek, 1000 美元搞定了,那省下来的钱是不是够你再多招 10 个工程师?这不叫性价比高,它这叫降维打击。所以你看, OpenAI 它慌到什么程度了?7 月 30 号,它没有任何预告, GPT- 5.6 Luna 全线降价 80%,最后输出价格从每百万 Token 6 美元直接砍到 1.2 美元。
Speaker 1 00:02:21
但是你去跟 DeepSeek 比,你发现还是没有性价比。而且你知道多反常吗?这款模型上线才仅仅三周,正常调教周期在半年以上。但是没有办法,一,如果他不这么做, DeepSeek 勾在后面会继续杀他,而且第二天, DeepSeek 就推出了新品。而 OpenAI 就算你降了 80% 它还是比 DeepSeek 贵了 4 倍以上。
Speaker 1 00:02:41
而更扎心的是什么呢?降价消息刚发出去,第二天, DeepSeek 就出新品了。而 OpenAI 的产品负责人亲自下场推销,却被消费者各种嘲讽。最讽刺的来了,你以为美国人都在抵制中国 AI,但恰恰相反,他们政府抵制的欢,但是底下企业用的却欢。他们企业费用管理平台 6 月的趋势榜上, DeepSeek 登顶趋势软件供应商第一名,为什么?因为美国公司正在批量的给 DeepSeek 打钱,你要注意,不是下载开源权重自己部署,而是调用 DeepSeek 的 API 来付费。他的数据是直接发给中国公司, AI 聚合平台上, DeepSeek 的流量份额,它已经从当年不足 1% 已经涨到 17% 了。
Speaker 1 00:03:19
DeepSeek 模型下载量 9 月份暴涨 960% 在绝对的价格优势面前,它的竞争对手们根本没法竞争。他们嘴上喊的是主义,但你看看账单就全是生意。这时候有人肯定说了,便宜没好货吧,性能肯定不行吧?但我告诉你。恰恰相反,实测显示啊, V4Flash 的综合性能已经追平了 GPT- 5.6 的 Luna,在代码、数学、长文本这些硬核任务上,甚至有过之而无不及。而且在智能指数上,它可比 Claude 的顶配只差 6 分,但为了这 6 分,你可能要多花 52 倍的钱,所以这笔账是个人,你算算就知道,除非绝对需要,谁去用 Claude?以前全球大模型的价格, OpenAI 说的算,他说多少就是多少,你爱用不用。但是现在呢? DeepSeek 说这个价格我定了,你跟,你就得把利润吐出来,你不跟,你开发者就得全跑光,没人跟你。
Speaker 1 00:04:07
哎,定价权已经从硅谷啊转向了中国,而最打脸的是美国政府,你要知道他们国防部。把 DeepSeek 禁了,德州还有纽约州也把 DeepSeek 禁了,他们国会甚至还要永久立法封杀,可结果呢?财政部刚。刚刚威胁要制裁中国模型,硅谷呢,有 200 家企业去联名反对,说你要是封我,疼的就是美国的经济。所以你看了吗?美国政府想要抑制 DeepSeek,可市场他们要发展,要生存呢。当一个好用的东西比 OpenAI 便宜 100 倍,所有的封锁最后就变成塞子一样,消费者自己想办法会去得到价格比他们便宜无数倍的 DeepSeek,他们也会翻墙啊。这 8 万亿 token,它只是开始,当全世界的 AI 定价权真正的握在中国人手里那一天,那可能才是改变世界命运的时刻。
16.5 关键截图
本视频为纯口播形式(主播面对面讲解 + 字幕),无 PPT / 架构图 / 原理图等有价值的结构化截图,故不保留截图。
📄 来源:094_马斯克突然宣布解散!这次他真的认输了?.md
17 马斯克突然宣布解散!这次他真的认输了?
17.1 视频信息
| 项目 | 内容 |
|---|---|
| 视频名称 | 马斯克突然宣布解散!这次他真的认输了? |
| 时长 | 4 分 20 秒 |
| 来源平台 | 抖音 |
| 原始链接 | https://www.douyin.com/video/7705678901234567890 |
| 飞书妙记 | https://www.feishu.cn/minutes/obcnh7cibz4vq79vspl63me2 |
| 关键词 | 马斯克、xAI、SpaceX、Anthropic、算力、AI 交付、企业级、稳定交付、模型竞争、基础设施 |
17.2 全文摘要
本视频分析马斯克宣布 xAI 作为独立公司解散并完全并入 SpaceX 旗下重组为 SpaceXAI,同时将 Colossus 数据中心算力开放给曾经的竞争对手 Anthropic 使用这一事件。几个月前马斯克还公开怼 Anthropic,嘲讽 Claude 是 "厌恶人类的 AI",转头就坐到一张桌子上做生意。表面看是打脸或认输,实则说明 AI 行业变得更现实了 —— 过去两年 AI 公司拼模型发布会、拼参数、拼跑分、拼谁更接近 AGI,听起来一个比一个宏大,但真正到商业竞争,最后都回到算力够不够、成本扛不扛得住、用户来了接不接得住、企业客户付了钱能不能稳定交付这些现实问题。核心观点:AI 上半场拼模型,下半场拼交付。Anthropic 需要稳定算力(Claude Code 不是陪聊天的,是能连续干活的程序员助手,一跑起来几个小时不停地读代码改代码测试调用工具,用户越多消耗算力越吓人,最怕的不是没有用户而是用户来了用不了 —— 像开饭店顾客排到门口但厨房出不了菜),马斯克需要证明手里的算力、工程和基础设施有商业价值,双方在模型上还是竞争对手但在基础设施上可以做生意。企业买 AI 买的不是灵感而是确定性 —— 今天能用明天还能用,演示能跑业务里也能跑,出了问题能定位,出现风险能控制,这才叫企业级 AI。最大信号是 AI 竞争已经从模型发布会竞争进入稳定交付竞争,单靠一个聪明模型不够,还需要工具编排、权限管理、安全防护、错误恢复和过程追踪。AI 最终不是讲出来的是跑出来的,不是演示出来的是交付出来的。
17.3 原文结构化整理
17.3.1 事件:xAI 解散并入 SpaceX,算力开放给 Anthropic
事件要点:
-
马斯克宣布 xAI 作为独立公司解散,完全并入 SpaceX 旗下,重组为 SpaceXAI
-
几个月前还公开怼 Anthropic,说他们的 AI 有问题,嘲讽 Claude 是 "厌恶人类的 AI"
-
转头就把 SpaceX 旗下 Colossus 数据中心的算力开放给 Anthropic 使用
表面解读:
-
打脸:前几个月还互相看不顺眼,现在直接坐到一张桌子上做生意
-
认输:Grok 打不过 Claude,所以只能把算力租出去回血
视频观点:这些理解都太浅了。
17.3.2 不是认输,是 AI 行业变得更现实了
过去两年 AI 公司拼什么:
-
拼模型发布会
-
拼参数
-
拼跑分
-
拼谁更接近 AGI
-
OpenAI 说要做通用人工智能
-
Anthropic 包装成更安全、更可控的 AI 公司
-
马斯克做 xAI 说要理解宇宙的真实本质
听起来一个比一个宏大。
商业竞争的现实问题:
-
算力够不够?
-
成本扛不扛得住?
-
用户来了,接不接得住?
-
企业客户付了钱,你能不能稳定交付?
17.3.3 AI 上半场拼模型,下半场拼交付
模型再聪明,如果高峰期一用就限流,企业客户就不敢把核心流程交给你。你理念再伟大,如果算力供不上,产品跑不稳,最后也只能停在 PPT 和发布会上。
双方的需求:
| 方 | 需求 |
|---|---|
| Anthropic | 需要稳定算力 |
| 马斯克 | 需要证明自己手里的算力、工程和基础设施有商业价值 |
双方在模型上还是竞争对手,但在基础设施上可以做生意。说白了,是现实把他们拉到了一张桌子上。
为什么 Anthropic 这么需要算力:
-
Claude 增长太快,尤其是 Claude Code 这种产品
-
Claude Code 不是陪你聊天的,是一个能连续干活的程序员助手
-
一跑起来可能几个小时不停地读代码、改代码、测试、调用工具
-
用户越多,企业客户越多,消耗的算力就越吓人
-
Anthropic 现在最怕的已经不是没有用户,而是用户来了以后用不了
比喻:就像开饭店,顾客已经排到门口了,但厨房出不了菜。你菜谱写得再好,厨师水平再高,最后菜端不上来,顾客一样会走。
17.3.4 企业买 AI 买的是确定性
企业买 AI,买的不是灵感,而是确定性。
| 企业级 AI 的要求 | 说明 |
|---|---|
| 今天能用,明天还能用 | 稳定性 |
| 演示能跑,业务里也能跑 | 可靠性 |
| 出了问题能定位 | 可观测性 |
| 出现风险能控制 | 安全性 |
这才叫企业级 AI。
17.3.5 竞争从模型发布会进入稳定交付竞争
最大信号:AI 竞争已经从模型发布会竞争进入稳定交付竞争。
-
以前大家看谁的模型更聪明
-
以后大家更要看谁能把模型、算力、工具、系统、安全和业务流程全部打通
智能体时代的特殊要求:
-
AI 不再只是回答一句话,而是要连续执行任务
-
要访问系统、调用工具、检查结果,甚至在复杂流程里一步一步往下跑
-
单靠一个聪明模型是不够的
-
还需要:工具编排、权限管理、安全防护、错误恢复、过程追踪
-
否则一个智能体看起来很聪明,但真放进企业里可能就是一个不可控的风险源
结论:
企业级 AI 不是玩具,也不是一个聊天框,它本质上是一套生产系统。生产系统最重要的不是偶尔聪明一次,而是每天稳定运行,持续交付结果。 AI 最终不是讲出来的,是跑出来的;不是演示出来的,是交付出来的。谁能把模型、算力、工程、安全和业务真正打通,谁才有机会赢到最后。
17.4 完整逐字稿
以下为飞书妙记转写的完整内容(注:视频总长 4 分 20 秒,转写覆盖至 3 分 47 秒,已覆盖绝大部分核心内容)。
Speaker 1 00:00:00
马斯克这次是认输了,还是正在酝酿一个更大的动作?最近这位世界首富又有大动作,突然宣布自己的 XAI 将作为独立公司解散,并完全并入 SpaceX 旗下,重组为 SpaceXAI。更戏剧性的是,几个月前,马斯克还在公开怼 Anthropic,说他们的 AI 有问题,甚至嘲讽 Claude 是厌恶人类的 AI。结果几个月后,他转头就把 SpaceX 旗下 Colossus 一数据中心的算力开放给了 Anthropic 使用。
Speaker 1 00:00:29
很多人一看就说,这不是打脸吗?前几个月还互相看不顺眼,现在直接坐到一张桌子上做生意了。还有人说,这是马斯克认输了, Grok 打不过 Claude,所以只能把算力租出去回血。但我告诉你,这些理解都太浅了。这件事真正说明的,不是马斯克变脸快,而是 AI 行业变得更现实了。你想想过去两年, AI 公司拼什么?拼模型发布会、拼参数、拼跑分、拼谁更接近 AGI。 OpenAI 说自己要做通用人工智能, Anthropic 把自己包装成更安全、更可控的 AI 公司,马斯克做 XAI 说要理解宇宙的真实本质。
Speaker 1 00:01:08
听起来一个比一个宏大,但真正到了商业竞争,大家最后都会回到几个很现实的问题,算力够不够?成本扛不扛得住?用户来了,接不接得住?企业客户付了钱,你能不能稳定交付?我一直讲 AI 上半场拼模型,下半场拼交付。模型再聪明,如果高峰期一用就限流,企业客户就不敢把核心流程交给你。
Speaker 1 00:01:31
你理念再伟大,如果算力供不上,产品跑不稳,最后也只能停在 PPT 和发布会上。所以这次马斯克和 Anthropic 合作,本质上不是谁低头了,也不是谁服了谁。 Anthropic 需要稳定算力。马斯克需要证明自己手里的算力、工程和基础设施有商业价值。双方在模型上还是竞争对手,但在基础设施上可以做生意。说白了,是现实把他们拉到了一张桌子上。
Speaker 1 00:01:58
为什么 Anthropic 这么需要算力?因为 Claude 增长太快了,尤其是 Claude Code 这种产品,它不是陪你聊天的,它是一个能连续干活的程序员助手。它一跑起来,可能几个小时不停地读代码、改代码、测试、调用工具。用户越多,企业客户越多,消耗的算力就越吓人。所以 Anthropic 现在最怕的已经不是没有用户,而是用户来了以后用不了。这就像开饭店,顾客已经排到门口了。但厨房出不了菜。你菜谱写得再好,厨师水平再高,最后菜端不上来,顾客一样会走。
Speaker 1 00:02:33
AI 公司也是一样,模型再聪明,算力接不住,企业客户只会觉得你不靠谱。因为企业买 AI,买的不是灵感,而是确定性。今天能用,明天还能用,演示能跑,业务里也能跑,出了问题能定位,出现风险能控制,这才叫企业级 AI。所以给你一个判断,这件事最大的信号是 AI 竞争已经从模型发布会竞争进入稳定交付竞争。以前大家看谁的模型更聪明,以后大家更要看谁能把模型。算力、工具、系统、安全和业务流程全部打通。尤其到了智能体时代, AI 不再只是回答一句话,而是要连续执行任务。它要访问系统、调用工具、检查结果,甚至在复杂流程里一步一步往下跑。这个时候,单靠一个聪明模型是不够的,你还需要工具编排、权限管理、安全防护、错误恢复和过程追踪。否则一个智能体看起来很聪明,但真放进企业里,可能就是一个不可控的风险源。这也是为什么我一直说企业级 AI 不是玩具。也不是一个聊天框,它本质上是一套生产系统,而生产系统最重要的。不是偶尔聪明一次,而是每天稳定运行,持续交付结果。
Speaker 1 00:03:47
这次马斯克把算力开放给曾经的竞争对手,表面看是商业合作,背后其实说明了一个趋势, AI 行业正在从讲故事走向拼交付,从拼模型发布会走向拼系统工程。 AI 最终不是讲出来的,是跑出来的,不是演示出来的,是交付出来的。谁能把模型、算力、工程、安全和业务真正打通,谁才有机会赢到最后。最后想问大家一个问题,你觉得马斯克这次是认输了,还是正在酝酿更大的动作?评论区聊聊。
17.5 关键截图
本视频为 AI 生成漫剧画面 + 口播形式(纳米 AI 生成),无 PPT / 架构图 / 原理图等有价值的结构化截图,故不保留截图。
📄 来源:103_如何用 AI 做出超级好看的矢量图(可编辑).md
18 AI 行业动态与前沿解析(大模型命名 / 行业收购 / WeatherNext3 / 新闻诉讼 / ChatGPT Ads / DSH / AI Builder)
18.1 大模型命名套路(Fable / Sol 为例)
18.1.1 单词释义
Fable(/ˈfeɪbl/):
-
名词:寓言;寓言故事(带道德寓意的短篇小故事,如伊索寓言 Aesop's Fables);虚构传说、神话、杜撰的故事
-
动词:虚构、编造故事
-
词根:拉丁语 fabula = 故事、叙述
Sol(/səʊl/):
-
拉丁语 sol = 太阳(最常用);太阳;太阳神索尔
-
solar(太阳的)词根来自 sol
-
西班牙语 sol:太阳;也指货币索尔
-
化学:Sol = 溶胶(胶体溶液)
-
游戏 / 奇幻:Sol 常作为神明、英雄名字
-
⚠️ 注意:不是 Soul(灵魂 /səʊl/ 同音,拼写不同),很多人会混淆
18.1.2 大模型名字里为什么爱加 Fable、Sol?
为什么用 Fable(代表:Fable AI、Fable-LLM 等):
-
词义:寓言、叙事、故事。大模型本质就是生成故事、叙事、对话、虚构内容,Fable 暗示擅长讲故事、角色扮演、创意叙事、多轮故事生成
-
氛围感:奇幻、想象、创造力
-
发音简短好听,双音节,适合做产品名 / 模型代号,域名容易注册
-
文化意象:寓言自带 "隐喻、推理、启发",暗示模型有思辨理解能力
-
短板:Fable 自带 "虚构、杜撰" 含义,暗含模型会编造幻觉(hallucination),算有趣的文字巧合
为什么用 Sol(代表:Sol-LLM、Llama-Sol、OpenSol、Sol-Agent 等):
-
核心来源:拉丁语 Sol = 太阳。太阳象征光明、智慧、启蒙、照耀万物
-
AI 类比 "智慧之光",符合大模型隐喻;西方科技圈非常喜欢太阳意象命名(Apollo、Helios、Sol)
-
简短有力,3 个字母,适合写文件名、HuggingFace 模型 ID、命令行调用
-
历史 / 神话光环:Sol 是古罗马太阳神,自带宏大、强大感觉
-
和其他词搭配顺口:Sol-Agent、Sol-Pro、Sol-Base
-
❗避坑:不要当成 soul(灵魂),大部分模型取名 Sol 是太阳
18.1.3 大模型取名通用套路
-
神话 / 拉丁语词根(Sol、Luna、Aurora、Orion):用古老神话词汇,高级、宏大,避开现代英文歧义,短、适合代号
-
文学叙事类词汇(Fable、Verse、Novel、Epic):暗示模型擅长文本、故事、创作
-
动物(Llama、Mistral、Falcon)、天体(Star、Nova)
对比记忆:
-
Fable 📖:偏向 "故事、叙事、创造力",适合侧重创作、角色扮演、Agent 讲故事的模型
-
Sol ☀️:偏向 "智慧、力量、光明",通用全能型模型喜欢用
额外吐槽:很多开源模型起名就是找一个好听的拉丁语 / 文学单词,词义和实际能力不一定强绑定,更多是品牌氛围感,看到名字不能直接断定模型能力。
📄 来源:001_模型评测指标知识点汇总.md (## 四十、AI 行业收购事件盘点(英伟达 / OpenAI / Anthropic / SpaceX))
18.2 AI 行业收购事件盘点(英伟达 / OpenAI / Anthropic / SpaceX)
18.2.1 英伟达收购 Hugging Face(2026-09-03 官宣:129.3 亿美元)
Hugging Face:AI 界 GitHub,1800 万开发者、300 万模型,开源模型分发枢纽。
英伟达最适配的 4 个核心理由:
-
防御战略:对冲 OpenAI/Anthropic 自研芯片(OpenAI 自研 Jalapeño 芯片;Anthropic 建定制芯片团队),防止被大客户 "去英伟达化"。闭源巨头可以自研芯片,但海量中小开发者、科研机构、开源模型社区很难自研硬件;把开源生态握在手里就保住 GPU 基本盘
-
补齐完整闭环:GPU-CUDA → 模型库 - Transformers → 开发者分发入口。英伟达擅长硬件、CUDA、推理框架(NIM/TensorRT),缺面向普通开发者的模型分发、社区、评估、部署平台
-
已有深度合作基础:英伟达本身是 HF 最大贡献者,上传 500+ 模型、250+ 数据集;Nemotron 系列全部托管在 HF
-
商业价值:20 万企业在 HF 做模型选型评估;收购后推广 NIM 推理服务、企业版、云部署方案;拿到开发者行为、模型迭代情报
风险:反垄断争议;社区担心开源中立性受损;英伟达承诺不会锁死,继续支持其他厂商硬件、其他模型。
对比:如果 OpenAI 收购 HF 会形成闭源巨头控制最大开源社区,舆论监管阻力极大;Anthropic 体量小、财力不够、无硬件生态协同。
18.2.2 OpenAI 主要收购清单(2023-2026)
| 被收购公司 | 时间 | 业务 & OpenAI 获得什么 |
|---|---|---|
| Global Illumination | 2023-08 | 游戏 / 交互产品团队,并入 ChatGPT 核心产品团队 |
| io(Jony Ive) | 2025-05 | 65 亿美元,前苹果设计团队,做下一代 AI 硬件设备 |
| Sky(Software Applications) | 2025-10 | Mac 桌面 AI 交互,屏幕感知、操作应用能力,强化 Agent 端侧交互 |
| Statsig | 2025-09 | A/B 测试、产品数据分析平台,用于 ChatGPT 产品迭代实验 |
| Neptune | 2025-12 | AI 训练实验追踪、模型监控调试工具 |
| Torch | 2026-01 | 医疗健康记录技术,布局 ChatGPT-Health 医疗方向 |
| Promptfoo | 2026-03 | AI 红队、安全测试、模型评估工具 |
| Astral | 2026-03 | Python 工具 uv/Ruff,强化 Codex 代码生态 |
| Multi | 2026-05 | 开发者协作环境,团队 IDE 协同、共享终端 |
| Ona | 2026-06 | 安全预配置运行环境,强化 Codex、Agent 生产部署能力 |
OpenAI 收购特征:大量买工具、团队、运行环境,为 Agent、硬件、安全、企业服务铺路,很少收购基础大模型实验室。
18.2.3 Anthropic 主要收购清单(2026 集中爆发)
| 被收购公司 | 时间 | 业务 & Anthropic 获得什么 |
|---|---|---|
| Bun | 2025-12 | 代码 Agent 引擎,增强 Claude 代码执行 |
| Vercept | 2026-02 | 视觉感知 + 电脑操作,强化 Computer Use 能力 |
| Coefficient Bio | 2026-04 | 4 亿美元,生物计算、药物发现团队,布局生命科学垂直大模型 |
| Stainless | 2026-05 | SDK 自动生成平台,支撑 Agent 生态的多语言 SDK/MCP 服务开发 |
Anthropic 收购特点:Agent 能力优先,补齐电脑操作、SDK 基础设施,同时布局垂直行业。
18.2.4 Cursor 被 SpaceX 收购(更正后的最新事实)
-
买家:SpaceX(纳斯达克代码 SPCX),不是 X Corp(原 Twitter)
-
标的:Cursor 母公司 Anysphere
-
金额:600 亿美元(约合 4054 亿元人民币),全股票交易(SpaceX A 类普通股,发行约 3.893 亿股),一分现金没花
-
时间线:
-
2026-06-16:SpaceX 完成史上最大 IPO 4 天后,宣布以 600 亿美元全股票收购 Anysphere
-
2026-08-14:交易正式完成交割,Cursor 成为 SpaceX 全资子公司,并入 SpaceXAI 部门
-
2026-08-15:Cursor 官宣 "Cursor,现在是 SpaceX 的一部分"
-
2026-08-28:OpenAI 宣布 2026-11-12 起停止向 Cursor 提供模型服务
-
为什么马斯克买 Cursor:被视为马斯克在 AI 编程入口追赶 Anthropic 和 OpenAI 的关键一步 ——SpaceX 提供算力(GPU 集群)+ Cursor 提供开发者入口 + xAI 提供模型,形成垂直整合
-
Cursor 当时 ARR(年化收入)约 40 亿美元,是 AI 编程工具第一名
重要更正:此前 "Cursor 没被收购、保持独立" 的说法已过时。Cursor 已于 2026-08-14 被 SpaceX 正式收购。X(X Corp)是社交平台;SpaceX 是航天 + AI 公司;xAI 是马斯克的 AI 实验室(Grok)。三者都是马斯克旗下,但这次收购 Cursor 的是 SpaceX。
📄 来源:001_模型评测指标知识点汇总.md (## 四十一、WeatherNext3(谷歌 DeepMind AI 气象模型))
18.3 WeatherNext3(谷歌 DeepMind AI 气象模型)
18.3.1 基本认知
它不是大语言模型 LLM,是 AI 气象预报模型,属于数值气象 AI,专门做气象场预测,不能像 GPT/Gemini 一样做自然语言对话。
是否免费:
-
普通 C 端用户:免费使用。谷歌搜索、谷歌地图、Gemini App 里直接调用 WeatherNext3 气象结果,完全免费
-
开发者 / 科研 / 企业接入:不是完全免费。数据入口:Google Maps Platform Weather API、BigQuery、Google Earth Engine (GEE)、Cloud Storage。GEE 科研非商业有免费社区配额(Community Tier 每月 150 EECU-hours),超出计费;商业项目全额计费
-
⚠️ 模型权重不对外放出,不能下载模型本地跑,只能消费它输出的网格气象数据
免费查询入口:
-
Google 搜索(google.com):直接搜城市天气,底层调用 WeatherNext3,完全免费
-
Google Maps 谷歌地图网页版:打开天气图层
-
Gemini 网页 / App:直接问天气,底层数据源来自 WeatherNext3
-
开发者侧:Google Earth Engine (GEE) 科研非商业有免费配额
-
没有公开独立的 "WeatherNext3 官网查询站",只能通过谷歌 C 端产品消费输出结果
18.3.2 对比普通天气 API / 天气 Agent 的优势
| 对比维度 | WeatherNext3 | 普通天气 API | 普通天气 Agent(LLM + 天气工具) |
|---|---|---|---|
| 底层引擎 | AI 气象模型,直接输入实时卫星云图,每小时重新初始化预报(传统 NWP 6 小时滞后缩短到 3-4 小时) | 传统数值预报 NWP + 气象站插值,更新大多 3-6 小时 | 完全依赖第三方天气 API,LLM 只是转述 |
| 空间分辨率 | 温度湿度 5km 网格;其它地表 10km;高空风速 25km,能识别局地小气候 | 大多城市 / 区县级别,网格 10-50km,地形细节丢失 | 和调用的 API 一致 |
| 更新频率 | 每小时生成一轮全新全球预报 | 多数 3-6 小时更新 | 跟随调用 API 节奏 |
| 降水预报 | 降水 CRPS 指标相对旧基线最高提升 60%,对短时对流暴雨捕捉更强 | 对强对流、局地暴雨经常模糊、漏报 | 原样返回 API 数据 |
| 特色变量 | 风机高度 100m 风速、云层、太阳辐射(风电光伏新能源调度) | 部分有但分辨率粗糙 | 只能拿 API 对外暴露字段 |
| 薄弱地区 | 对非洲、拉美、亚太雷达稀疏地区提升巨大 | 缺站点地区精度大幅下滑 | 受底层 API 限制 |
| 输出形式 | 全球网格化原始气象场,可任意经纬度提取 | 城市 / 坐标点整理后的 JSON | 自然语言文字回答 |
人话解释:普通天气 API 好比超级计算机解物理方程,6 小时才重新算一遍全球天气;WeatherNext3 好比 AI 盯着每小时更新的全球卫星云图,实时吸收大气真实状态,每小时重新推演,5km 网格能捕捉 "城市这半边下雨、另一边不下" 的局地小尺度变化。天气 Agent 不会提升气象预报准确度,只是包装回答;WeatherNext3 是源头预报引擎。
18.3.3 时段详细程度 & 准确度
时间维度:✅ 逐小时粒度
-
每小时重新生成一次预报;整点 0/6/12/18 UTC 完整主预报最长 15 天;其余普通小时刷新预报时效 48 小时
-
输出逐小时时序数据(温度、湿度、降水、风速、云量、太阳辐射)
-
对比 WeatherNext2 是 6 小时一档,时间颗粒度更粗
-
⚠️ 不是分钟级短时临近降雨;时间越远不确定性自然上升
准确度:
-
✅ 明显变强:短时 - 中期(0\~7 天)尤其是降水(雨雪、对流暴雨),官方 CRPS 评测降水预报最大提升 60%,提前一天以上降水预报准确度提升 50%;地形复杂区域、雷达稀疏地区提升最大;新能源场景专门优化
-
⚠️ 提升有限:超过 10 天长期气候趋势和传统模型一样误差累积;分钟级瞬间突发极端天气不如实时雷达;Brightband 独立榜单相对更优不等于 100% 准确
怎么和 Agent 配合(工程角度):
WeatherNext3原始网格数据 → Google Maps Weather API / BigQuery 提取某经纬度逐小时数据 → 封装成get\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\_weather工具函数 → Chat-Completions/Responses Agent 调用工具拿到 JSON → LLM 整理成自然语言回答
关键点:Agent 本身不提升预报质量;真正提升准确度的是上游换成 WeatherNext3 数据源。
📄 来源:001_模型评测指标知识点汇总.md (## 四十二、AI 行业新闻与诉讼拆解(2026 近期))
18.4 AI 行业新闻与诉讼拆解(2026 近期)
18.4.1 索尼、华纳起诉 Anthropic 歌词版权
-
背景:索尼音乐出版、华纳 Chappell 音乐在加州北区联邦法院起诉 Anthropic(同时列两位联合创始人为被告)
-
指控:Anthropic 从盗版资源库大规模抓取、下载海量受版权保护歌曲歌词、乐谱,未经授权训练 Claude;模型可完整输出原歌词,和原版高度一致(案例含泰勒・斯威夫特等)
-
为什么起诉:美国版权法故意侵权单首法定赔偿上限 15 万美元,数万首认定侵权总索赔可达数十亿美元。版权方不认可 "AI 训练属于合理使用";法官过往判例:从盗版网站下载版权素材训练不属于合理使用(合法购买的书籍才有可能争取合理使用辩护)
-
进展:2026-08-30 正式提交诉状;Anthropic 回应不认同指控、会积极抗辩,尚处诉讼早期
18.4.2 OpenAI 因 Tumbler Ridge 枪击案面临 30 起诉讼
-
背景:行凶者案发前大量和 ChatGPT 对话,询问作案方案、武器、犯罪步骤
-
原告主张:30 起民事诉讼(受害者家属),指控 OpenAI 明知模型会输出暴力作案指引没做好安全防护、实质上协助教唆了枪击犯罪、产品存在缺陷未尽安全义务
-
OpenAI 抗辩:大模型只是生成文本,没有主观教唆意图;真正实施犯罪的是人类本人;模型有安全护栏但无法 100% 拦截全部恶意诱导;美国法律传统一般不把 AI 输出文本认定为 "教唆犯罪"
-
进展:30 起民事诉讼合并审理,尚处证据开示阶段,没有判决。全球标志性诉讼 ——AI 输出的有害内容,厂商要不要对现实世界伤害承担民事责任,判决结果影响整个行业规则
18.4.3 联邦法官裁定特朗普政府将 Anthropic 列入黑名单违法
-
导火索:美国国防部要求 Anthropic 无限制开放 Claude 给军方(允许用于自主杀人武器、国内大规模监控);Anthropic 拒绝并设置使用限制
-
报复:国防部把 Anthropic 标记为供应链风险黑名单,禁止国防部及防务承包商使用其 AI 产品;特朗普下令全联邦机构禁用(6 个月缓冲期)。这是美国历史第一次把本土 AI 公司打入该黑名单
-
诉讼:Anthropic 起诉国防部等 18 个联邦机构:指控政府因企业发表不同意见而打击报复(违反第一修正案言论自由)、剥夺合同权益(违反第五修正案正当程序)
-
裁决:加州北区联邦法官 Rita Lin 裁定黑名单行为违法 —— 不满足国家安全法定依据,本质是对企业立场的报复,侵犯第一修正案。8 月底正式完整裁决,黑名单作废,Anthropic 可重新承接国防部项目;也扫清 Anthropic IPO 重大障碍
18.4.4 OpenAI 终止 Cursor 模型访问(11-12 生效)
-
前提:SpaceX 600 亿美元收购 Cursor 母公司 Anysphere,8 月 14 日交割完成
-
合同条款:控制权变更之后 OpenAI 有权提前终止服务,给予最长 90 天通知期
-
OpenAI 理由:不是 Cursor 本身违规;历史上马斯克旗下其他公司(X/Twitter、xAI)曾违反 OpenAI 服务条款(如拿 OpenAI 输出训练自家 Grok);不信任 SpaceX 会遵守服务条款
-
Cursor 回应:OpenAI 模型只占 Cursor 总流量 5%,大部分已切换到 Claude、自研 Composer2 等模型;正尝试谈判,但已在做完全移除 OpenAI 的预案
-
马斯克表态:毫不在乎,指责 Altman 不可信任;马斯克本身还在对 OpenAI 提起 1500 亿美元诉讼
-
进展:公告已定,截止 2026-11-12;过渡期 Cursor 不再新增 OpenAI 相关功能;存在谈判和解可能性但概率偏低。行业影响:Cursor 被迫降低对 OpenAI 依赖,倒逼强化自研模型
18.4.5 ChatGPT Ads 年化收入破 10 亿美元
-
什么叫 "年化收入(annualized revenue run rate)":⚠️ 不是已经赚到 10 亿美元现金。算法:拿最近一段时间真实营收按比例推算,若维持当前增速跑满一整年可做到 10 亿。举例:最近一个月广告收入 8300 万美元 ×12 ≈ 10 亿。OpenAI 官方目标 2026 全年广告收入 25 亿美元
-
ChatGPT 可以投放广告吗:✅ 可以,ChatGPT Ads 广告业务
-
上线时间:2026-02 美国开启测试,约 200 天;8 月底已拓展到 40+ 国家,开放自助广告投放后台
-
展示对象:只给免费用户、低价 Go 订阅用户展示;Plus/Pro/ 企业付费用户不展示广告
-
广告形式:聊天对话内的品牌推荐、赞助商结果,AI 结合用户提问插入匹配的商业广告,有明确标识区分
-
OpenAI 做广告目的:算力成本极高,不能只靠订阅 + API 赚钱,需要第三条变现路径;为 IPO 做准备;免费海量用户(周活 10 亿)通过广告变现
-
行业争议:Anthropic 直接拿 "对话内不插广告" 做自己产品卖点;业界担忧广告影响模型回答客观性、中立性
18.4.6 新闻速记对照表
| 新闻 | 核心风险点 | 现状 |
|---|---|---|
| 索尼华纳诉 Anthropic 歌词版权 | 盗版数据源训练 AI 是否属于合理使用 | 诉讼早期,单首最高赔 15 万 |
| OpenAI 枪击案 30 起诉讼 | AI 输出内容厂商对现实伤害是否担责 | 证据阶段,行业标杆诉讼 |
| 法官裁定 Anthropic 黑名单违法 | 政府能否因企业观点惩罚本土科技公司 | 黑名单作废,政府可上诉 |
| OpenAI 11-12 断供 Cursor | 收购变更控制权带来 API 合作风险 | 过渡期,Cursor 仅 5% 流量来自 OpenAI |
| ChatGPT Ads 年化 10 亿 | 推算年收入,不是实际到手;聊天窗口广告变现 | 面向免费 / Go 用户投放,全球扩张 |
📄 来源:001_模型评测指标知识点汇总.md (## 四十四、ChatGPT Ads 广告机制(如何丝滑嵌入对话))
18.5 ChatGPT Ads 广告机制(如何丝滑嵌入对话)
18.5.1 模拟对话示例(示意)
用户提问:"想换台轻薄本,办公 + 偶尔剪视频用,预算 7000 以内,有什么推荐?"
ChatGPT 正常回答(有机结果,不插广告):
这个预算有几款不错的轻薄本可以考虑:

联想 ThinkBook 14+:标压处理器,接口全,剪 1080p 视频够用

华硕无畏 Pro 14:OLED 屏色彩好,适合轻度修图

RedmiBook Pro 15:性价比高,做工扎实

如果侧重续航和便携,ThinkBook 14+ 会更均衡一些。
然后,回答下方出现 "赞助商推荐" 卡片(只对免费用户展示):
┌────────────────────────────────────────────┐

│  🔍 赞助商推荐 · Sponsored               │

│  【联想 ThinkPad E14 商务轻薄本】        │

│  · 14英寸 2.2K 屏 · 标压 i5 · 1.4kg     │

│  · 现在到手 ¥6499,下单赠 3 年延保      │

│  \\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\\[查看详情 →]   (广告内容,与 AI 回答无关)│

└──────────────────────────────────────────┘
用户追问:"那 ThinkPad E14 和 ThinkBook 14+ 比,哪个更适合我?" → ChatGPT 继续正常回答,不会因广告偏袒,保持中立。
18.5.2 "丝滑" 在哪?机制拆解
-
像 "搜索结果页的赞助位",但放进了对话里:大家早习惯了 "搜索结果 + 顶部一条 Sponsored 广告" 模式。ChatGPT 广告把 AI 先给有价值的有机回答,广告作为附加的 "相关商业信息" 放在后面,没有顶替真正的回答
-
触发靠 "意图识别",不是无差别轰炸:广告系统判断用户是否处于消费决策意图("想买"" 推荐 ""预算多少"),只有命中才触发。问 "明天天气" 永远不会冒出广告 —— 这是 "丝滑" 的核心
-
明确标识,反而降低反感:广告最让人反感的是 "偷偷冒充真实内容"。ChatGPT Ads 用 "赞助商推荐 / Sponed" 标签 + 不同底色明确区分,等于告诉用户 "这是广告,你可以选择忽略"。诚实标注反而建立信任
-
广告本身对用户 "有用":展示和用户当前问题强相关的产品 + 信息,偶尔甚至是 "有用的额外推荐"
-
付费墙保护体验:Plus/Pro/ 企业用户完全无广告 —— 让 "看广告" 成为免费用户换取服务的对价
18.5.3 一句话总结
ChatGPT 广告的 "丝滑"= 意图匹配触发 + 明确标识不冒充 + 嵌在回答之后的附加位 + 保持 AI 回答中立 + 仅面向免费用户。借鉴搜索广告的成熟形态移植进对话流,靠 "诚实 + 相关 + 可忽略" 化解广告天然招人烦的问题。
工程实现角度(广告如何接入 Agent 链路,争议点在工程上如何隔离):
-
意图分类器(判断消费决策意图)→ 广告检索 → 插入位置决策 → 中立性约束
-
关键:广告系统与模型回答生成是隔离的,模型本身不因广告而改变回答
📄 来源:002_大厂 AI 面试视频知识点汇总.md (## 九、DSH:DeepSeek-R1 时刻还是新坑?)
18.6 DSH:DeepSeek-R1 时刻还是新坑?
来源:抖音视频《DSH 是 DeepSeek-R1 时刻,还是一个新的坑?》(281.6s)
原始链接:https://www.douyin.com/video/7675200354887208218
飞书妙记:无(本视频通过抖音页面直接提取文字,未生成飞书妙记)
18.6.1 核心概念
一个 Agent 等价于模型 + Harness 。Harness 就是 Agent 当中除 LLM 模型之外的所有内容,包含但不限于工具、技能、沙箱、存储等。
18.6.2 最大亮点:一切皆插件
-
目前市面上成熟 Agent,工具和技能(MCP、Skill)是插件化的,但其他都是内置的
-
DeepStack Harness(DSH)最特别一点是 "一切皆插件":Harness 里面所有内容都是插拔式的
-
DeepSeek Harness 基于 Cordis 插件系统构建:模型、工具、技能、会话、沙箱、存储、循环、调度、UI 等所有 Agent 能力均由插件提供,并通过 Cordis 服务与事件彼此协作
-
开发者无需改动 Harness 源码,即可在配置层选择、替换或扩展任一能力
18.6.3 为什么 "一切皆插件" 有价值?
-
Agent 这条路发展太快,没人知道未来最好用的 Agent 长什么样。模型会换、工具会换、记忆方式会换、安全策略也会换
-
今天大家觉得 MCP 协议很重要,明天可能又出现新工具协议
-
如果把所有功能焊死在一起,每出现一种新能力就得重新改造整个系统(升级就变成重做)
-
DSH 想法:不押注某一模型也不押注某一固定流程,先把模型、工具、记忆、权限和环境之间的接口留出来,以后谁更好就把谁接进来
-
类比 DIY 电脑:显卡不够用就换显卡,显示器可以单独升级,不用为换一张显卡把整台电脑重新制造
相对很多固定 Agent 框架非常具有想象力,可以说是 一次 DeepSeek 时刻 。框架会加速 B 端 Agent 落地,利于开发者。
18.6.4 困难一:插件之间的耦合
-
一个插件发生变化会不会把另一个看起来不相关的插件弄坏?比如记忆系统往往依赖数据库
-
一个插件变化,可能连带影响其他插件
18.6.5 困难二:功能冲突
-
同时安装两个功能相同的插件,模型应该调用哪个?
-
两个插件都想接管同一功能,谁的优先级更高?
-
单独看都合理,组合后却可能无法交付
18.6.6 困难三:提示词和模板行为的污染(Prompt / 行为污染)
这是 Agent 插件和普通软件插件最大区别之一 。有些插件不仅执行功能,还会向模型提示词里加说明。
-
例子:一个 PPT 插件告诉模型 "生成后优先创建网页预览";另一个文件插件告诉模型 "最终结果必须交付在本地文件"
-
两条单独看都没问题,但组合后模型可能不知道最终该交付网页还是 PPT 文件
-
这解释了 "要求直接生成 PPT,但 DSH 一开始却生成本地网页服务让在线查看" 的现象
-
Agent 最终行为不只由模型决定,还受工具说明、系统提示词和插件工作流共同影响
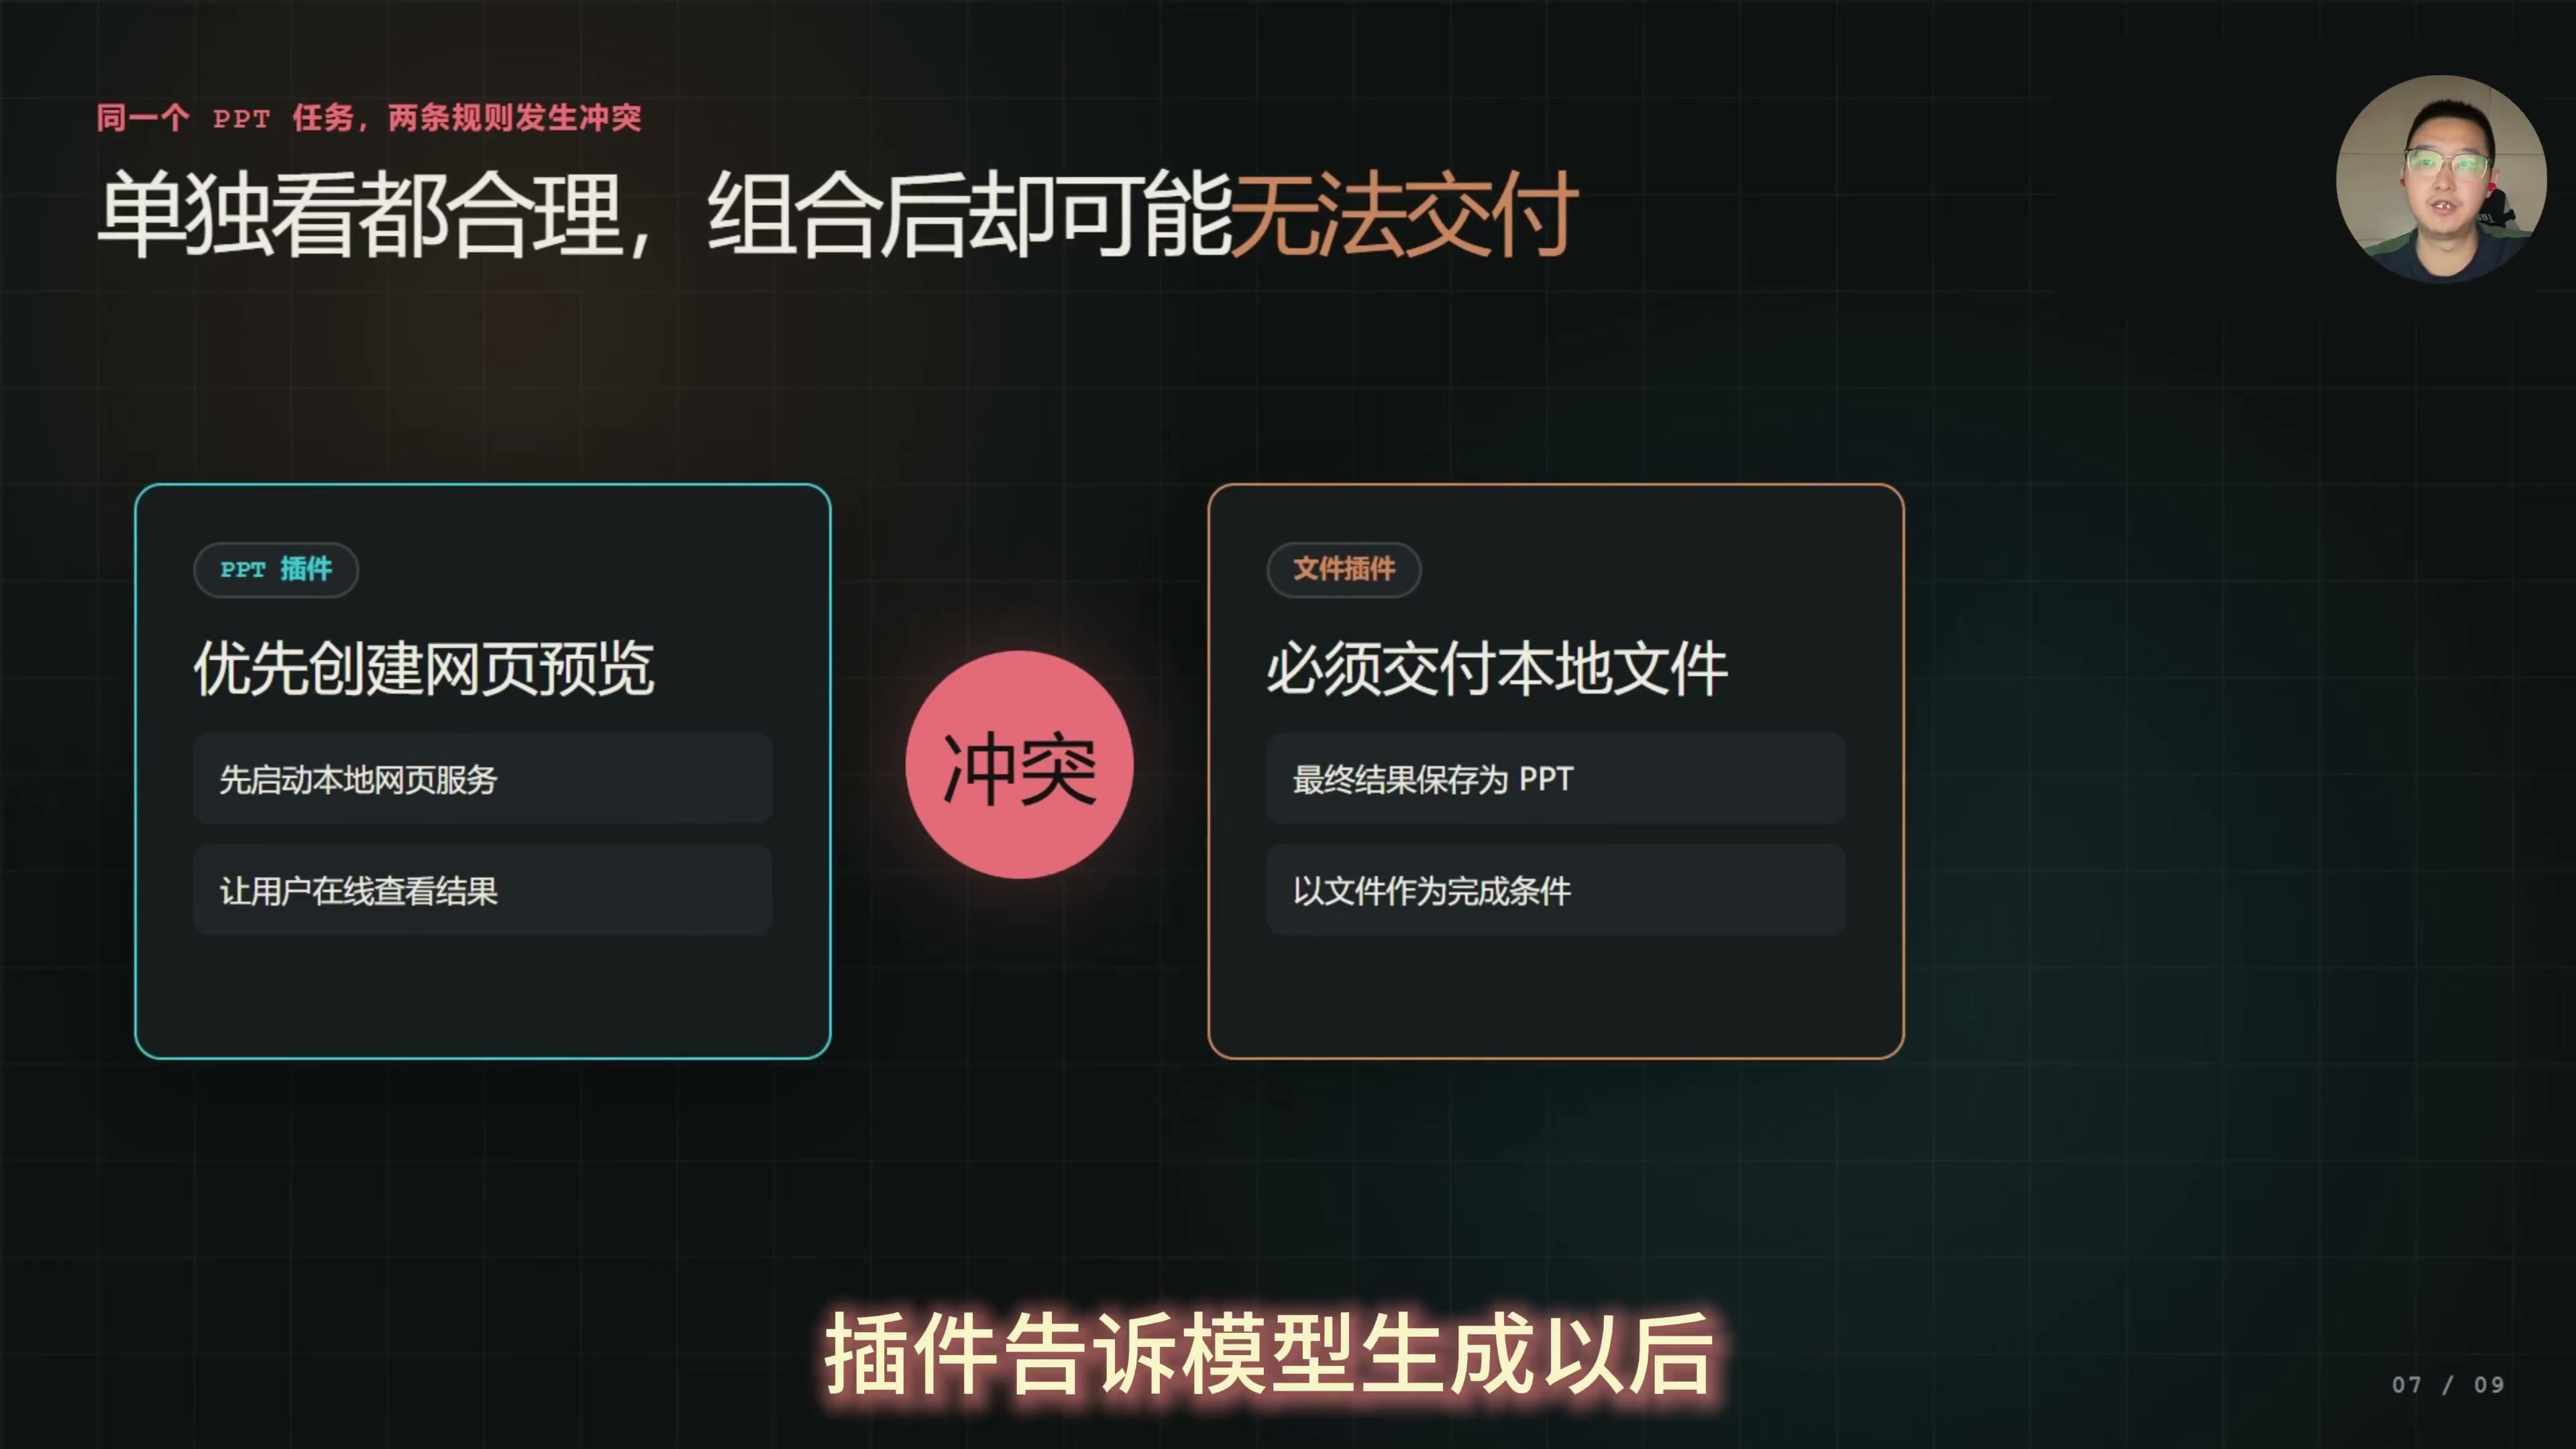
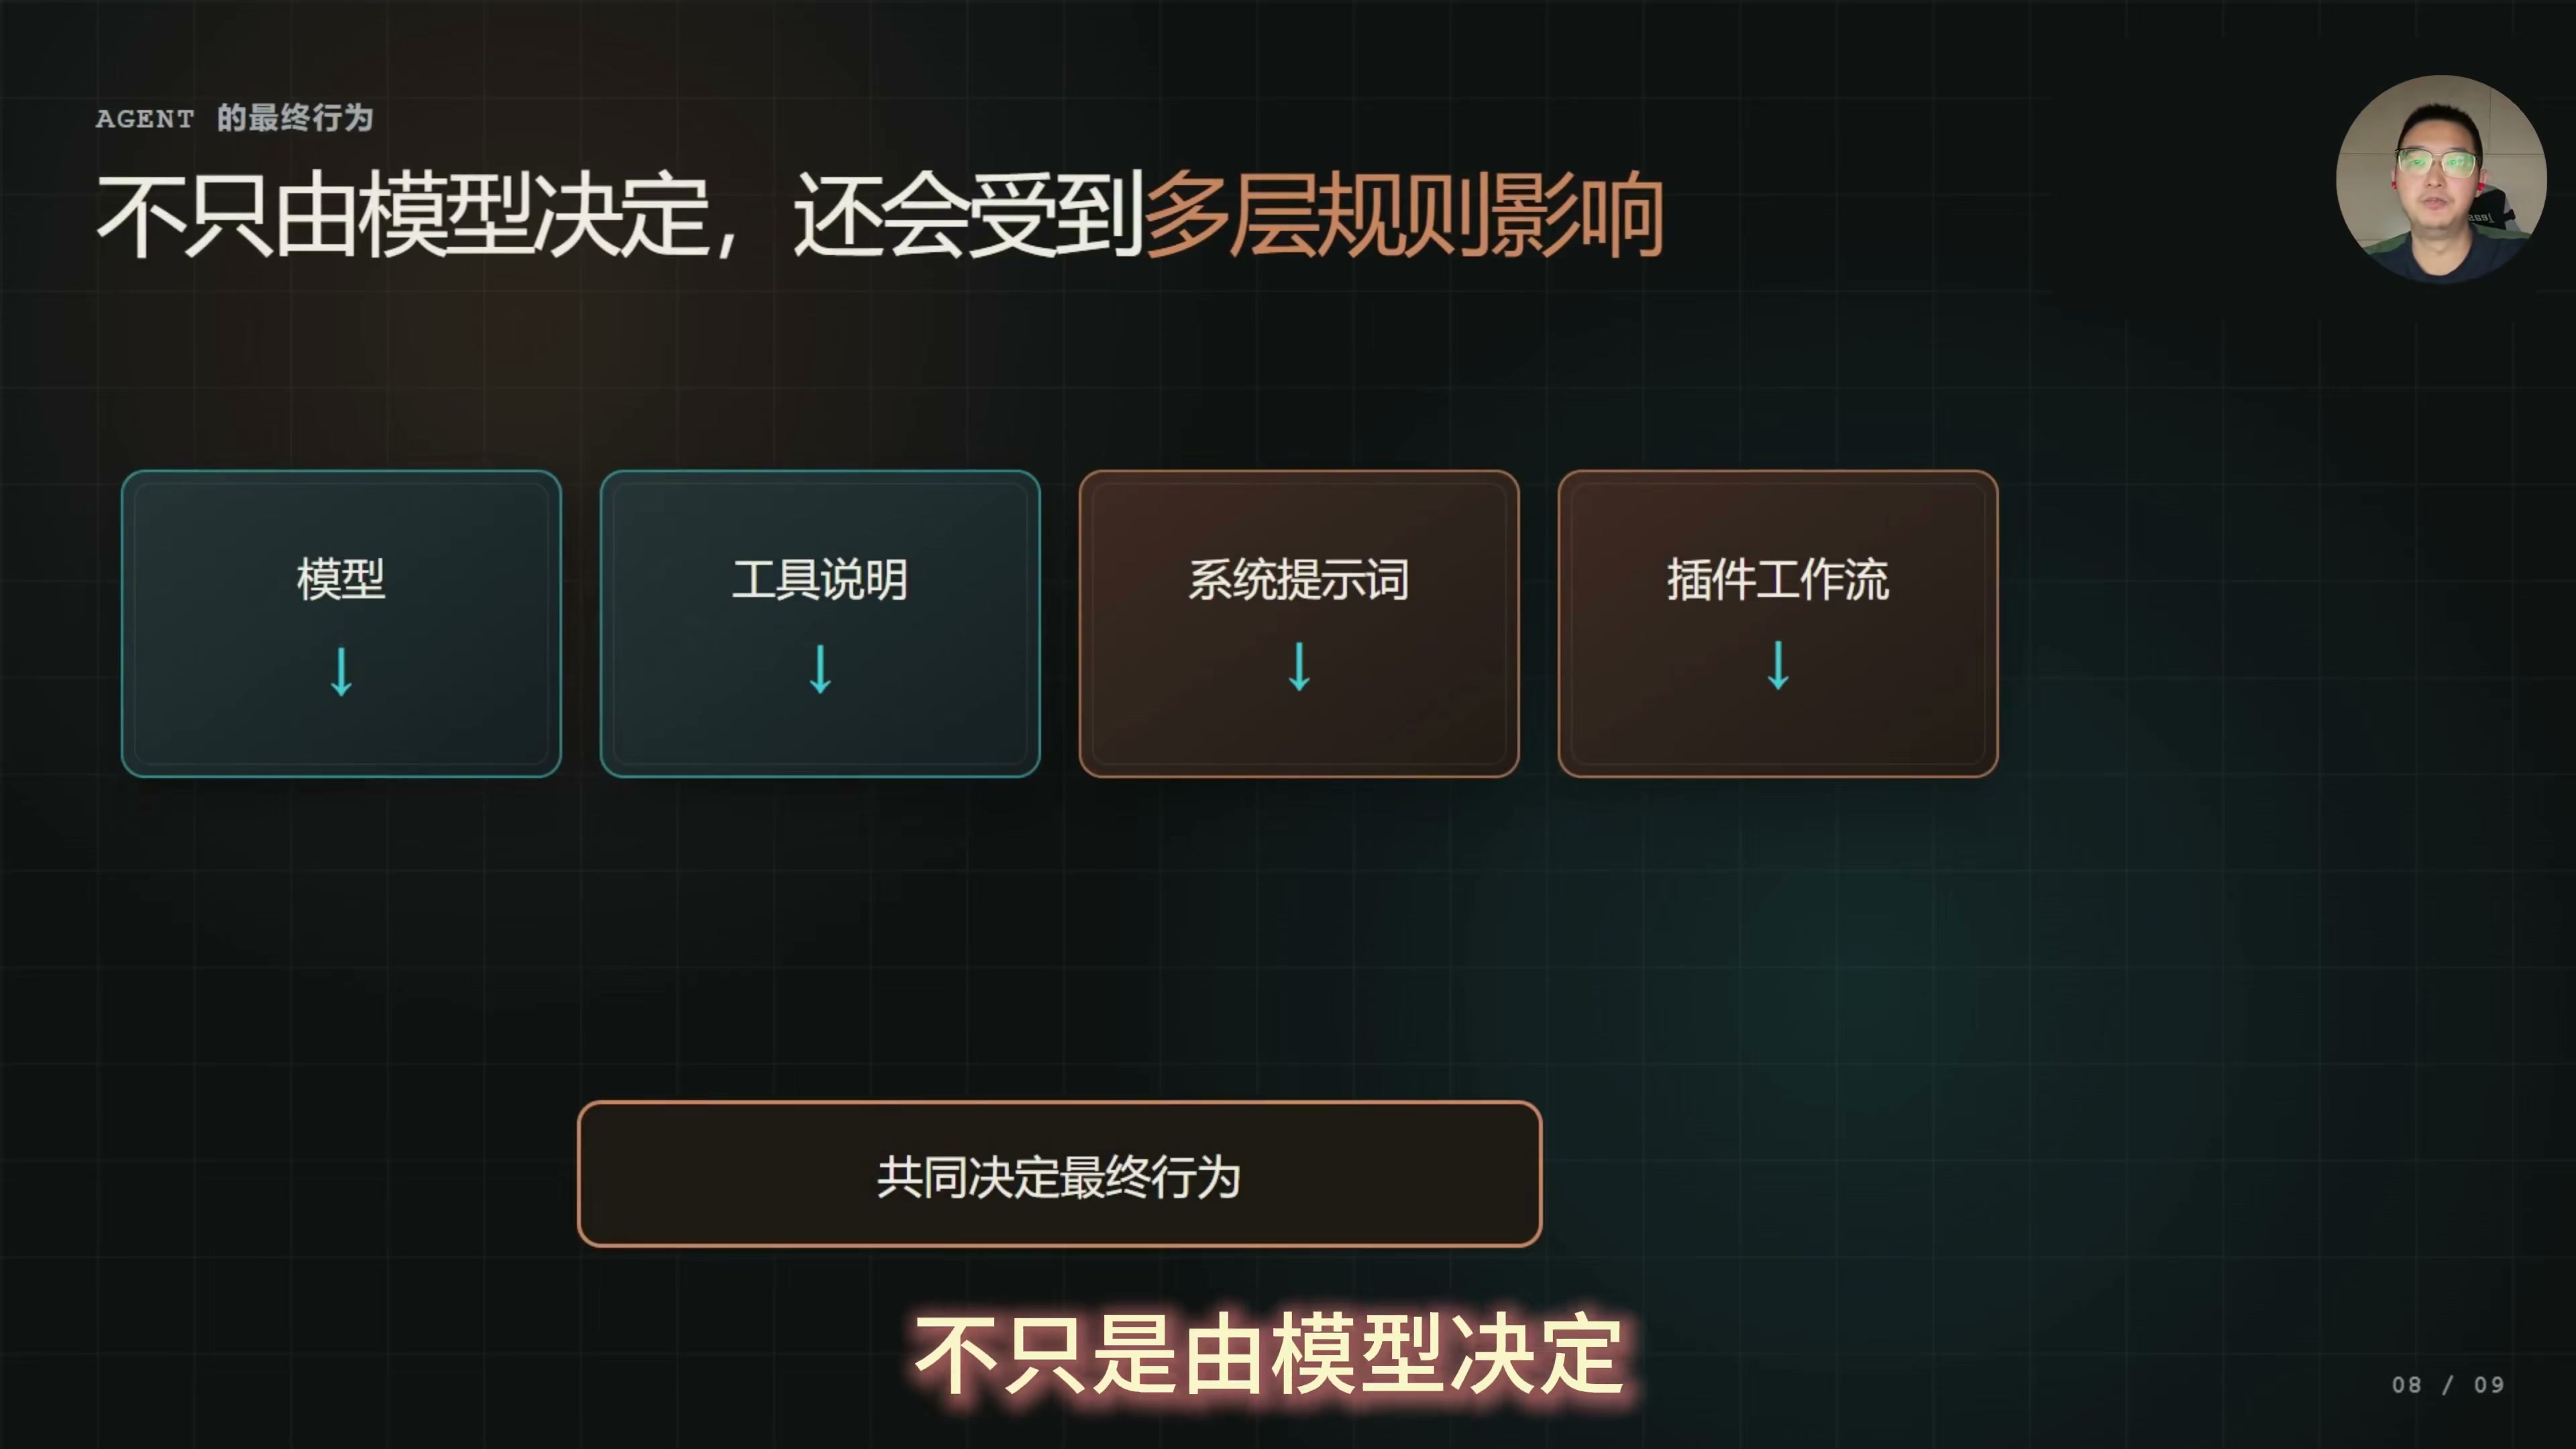
18.6.7 困难四:版本兼容与插件安全
-
版本兼容:每个插件单独测试都是好的,但装到同一个系统里就是不能用 —— 插件生态最难解决的问题之一
-
插件安全性:有些插件可读取文件、执行命令,甚至拦截模型与工具之间的通信,拥有非常高权限
-
未来形成第三方插件市场,插件的审核、权限、管理和供应链安全都会成为现实问题
18.6.8 总结判断
-
DSH 最大优势是一切都可以换;最大挑战是换完以后所有东西还能不能正常配合
-
插件化让开发 Agent 变简单,但只是把原来藏在一个大程序里的复杂度转移到插件之间的接口、顺序和权限上面
-
谁来决定插件本身能力上线?谁来验证十个单独都非常好用的插件组合起来还是一个好用的 Agent?
-
判断:事情刚刚开始,但如果天花板被打开,Agent 可能又是一条全新的路
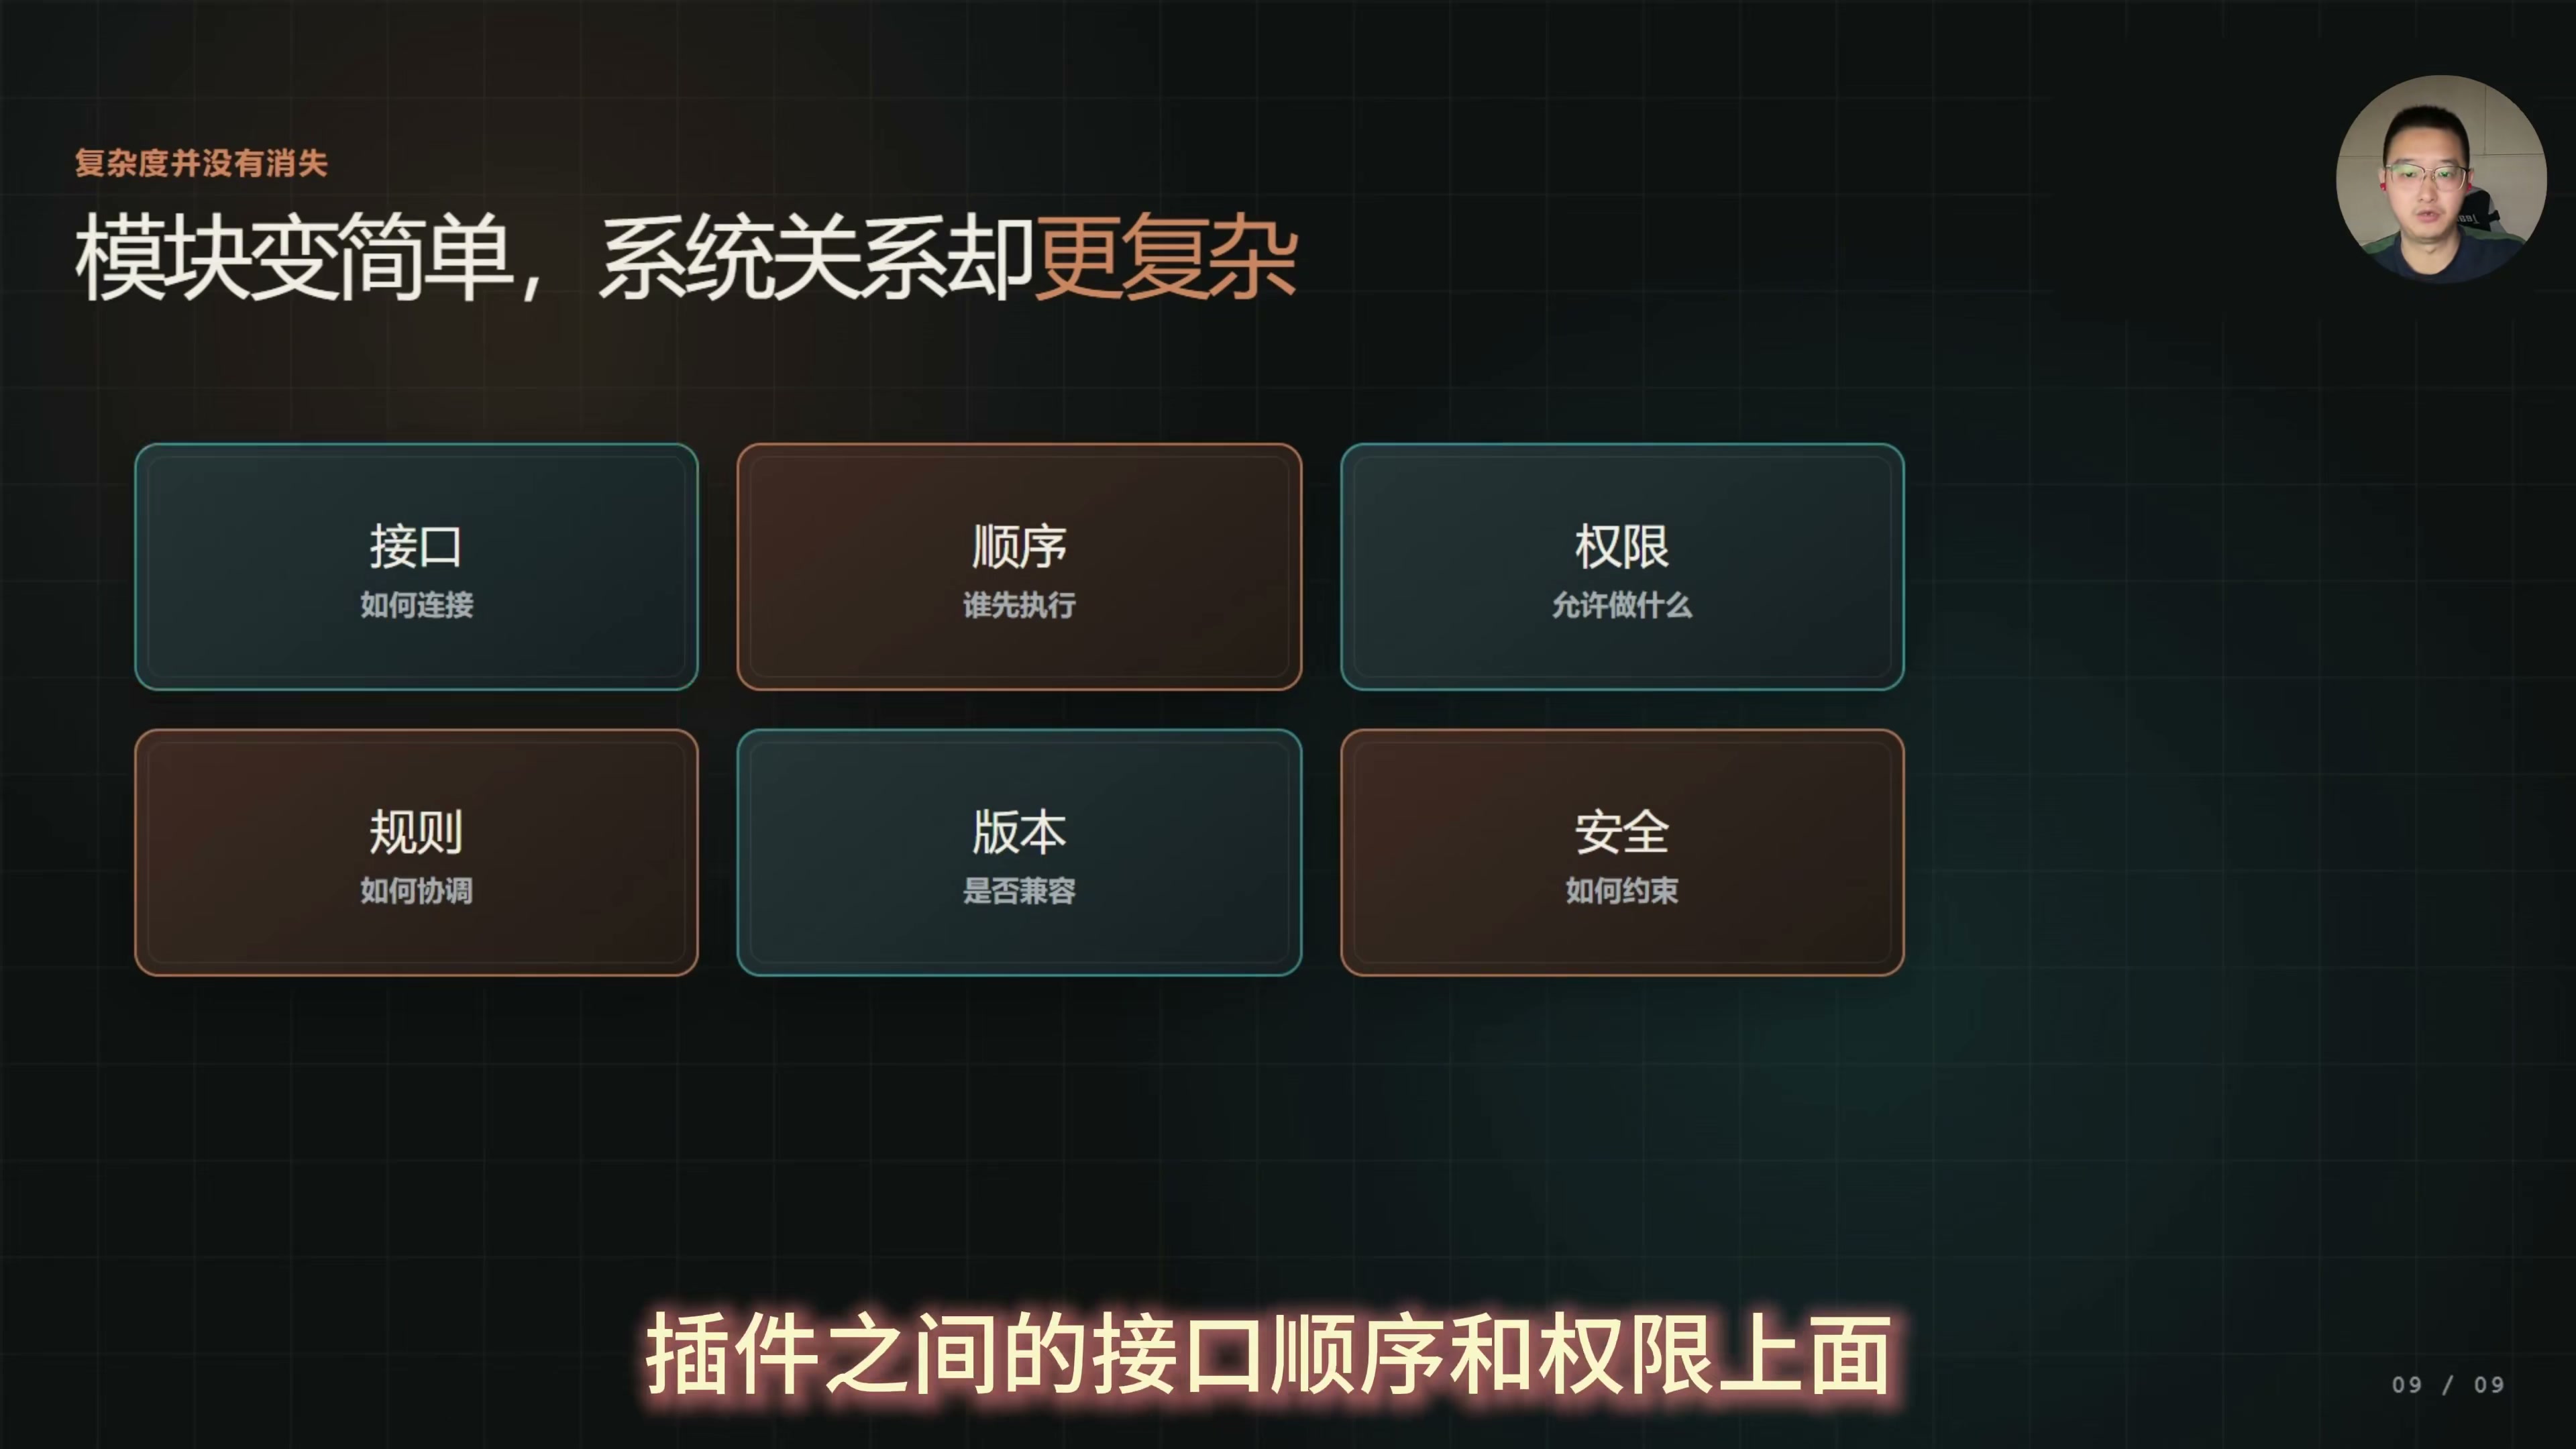
18.6.9 📌 面试要点速记
-
DSH 核心:Agent = 模型 + Harness,DSH 让 Harness 里一切皆插件
-
最大优势:灵活性—— 模型 / 工具 / 记忆 / 安全策略都能换(DIY 电脑类比)
-
最大挑战:插件耦合、功能冲突、Prompt 行为污染、版本兼容、安全
-
核心洞察:插件化把复杂度从 "一个大程序" 转移到 "插件间的接口、顺序、权限"
18.7 什么是 AI Builder?AI 时代的开发者定位
来源:豆包会话 2026-09-11 补充整理
18.7.1 一句话定义
AI Builder = 掌握 AI、善用 AI、同时具备架构经验的新时代开发者。核心理念:领先 AI 一步,让 AI 成为我们的工具、助手、伙伴,而不是被 AI 替代。方向是变成 "掌握 AI、善于使用 AI,同时又具备一定架构经验的崭新的 AI 时代的开发者"。
18.7.2 与两类角色的区别
| 角色 | 定位 | 局限 |
|---|---|---|
| 传统开发者 | 手写全部逻辑 | 重复劳动多,效率被 AI 甩开 |
| AI 使用者(会用 AI) | 只会用现成 AI 产品(聊天 / 写作 / 翻译) | 停留在 "消费 AI",无法构建系统 |
| AI Builder(目标) | 用 AI 重构工作流,把 AI 当工程组件 | 需要同时懂业务、Prompt、架构、评测 |
18.7.3 AI Builder 的三层能力
-
掌握 AI(会用):懂 LLM 能力边界 / 幻觉 / 成本,会写高质量 Prompt,会用 RAG、工具调用、Agent
-
善用 AI(会造):把 AI 编排进业务系统 —— 搭 RAG 管线、设计 Agent、建评测闭环,让 AI 稳定产出
-
架构经验(会设计):像设计分布式系统一样设计 AI 系统 —— 上下文管理、错误处理、评测护栏、成本控制、可观测性
18.7.4 面试怎么答 "你如何理解 AI Builder / AI 时代的开发者"
-
不要答:"我会用 ChatGPT / 会用几个 AI 工具"
-
高分结构:
-
定位:AI 不是替代者,是工具 / 助手 / 伙伴;开发者要 "领先一步",不是被替代
-
能力:掌握(Prompt / 模型边界)+ 善用(RAG/Agent/ 评测闭环)+ 架构(稳定性 / 成本 / 安全)
-
案例:举一个把 AI 嵌入生产系统的项目(如 RAG 问答 + 评测集驱动迭代)
-
落地:AI 负责 80% 的生成,人负责目标、边界、验证、迭代
18.7.5 和 "Prompt Engineer" 的区别
Prompt Engineer 聚焦 "怎么写好提示词";AI Builder 是更上一层的工程角色——Prompt 只是其中一环,还要管模型选型、数据、检索、评测、部署、监控、成本。面试时强调后者更能体现 "具备架构经验"。
18.7.6 一句话记忆
传统开发者写代码,AI 使用者用 AI, AI Builder 造 "会用 AI 的系统" 。
19 如何用 AI 做出超级好看的矢量图(可编辑)
19.1 视频信息
| 项目 | 内容 |
|---|---|
| 视频名称 | 如何用 AI 做出超级好看的矢量图(可编辑) |
| 时长 | 4 分 52 秒 |
| 来源平台 | 抖音 |
| 原始链接 | https://www.douyin.com/video/7713345678901234567 |
| 飞书妙记 | https://www.feishu.cn/minutes/obcnh7mce27z86e9mxl1bp66 |
| 关键词 | 飞书画板、SVG、矢量图、可编辑、Coding Agent、Claude Code、视觉风格、数据可视化、PPT 替代、活动海报 |
19.2 全文摘要
本视频介绍作者开发的一个 Skill,能让 Coding Agent 做出超级好看、可编辑的飞书画板(SVG 矢量图)。飞书画板是 SVG 格式,每一个元素都可以编辑 —— 改文字、挪动元素、针对具体元素评论,视觉风格可以做得非常专业(以前要雇专业设计师才能做出来的效果)。相比之前做的 HTML Skill(编辑困难、协同困难),飞书 SVG 画板解决了这些问题。但默认让 AI 画画板效果比较丑,需要用这个 Skill—— 里面定义了 20 多种视觉风格和配色,GitHub 开源。应用场景包括:①代码库结构可视化(把 OpenCode 等开源项目做成技术架构可视化讲解);②会议总结变图(几千字文字没人看,变成一张有重点的图直接发给对方);③数据可视化(给 Excel 数据让画板讲解趋势和亮点,适合给老板汇报);④论文可视化(把长论文 remix 成一张长图,清晰讲解核心观点和数据);⑤技术 Blog 讲解(如 Anthropic 多 Agent 协作五种模式,图文交错深入浅出);⑥取代 PPT(用 SVG 画板做 Slide,不比 HTML 丑,模板和风格可从 HTML 迁移,解锁新工作方式 —— 先写纯文字飞书文档再让 Agent 配图形成 PPT,或把妙记逐字稿穿插到画板里形成图文混排文档发给观众,既有 PPT 又有每页对应的逐字稿和精华演讲内容);⑦活动海报(完全用飞书画板做,可插入外部图片照片,每个元素可编辑)。工具选择:Claude Code 在前端设计方面远超 Codex(Codex 会有间距、重叠等排版不美观的小问题)。所有画板可一键下载成图片,直接用来发社交媒体、即时通讯发给客户,甚至做小红书图文(说做成 3:4 即可)。
19.3 原文结构化整理
19.3.1 飞书画板 SVG:可编辑的矢量图
核心特性:
-
飞书文档里的画板是 SVG 格式
-
每一个元素都可以编辑:改文字、挪动元素
-
可以针对具体元素进行评论
-
视觉风格可以做得非常专业好看
相比 HTML Skill 的优势:
-
HTML 编辑起来困难
-
HTML 协同起来困难
-
飞书 SVG 画板解决了这些问题
默认问题:如果只是默认让 AI 画画板,画出来比较丑,需要用专门的 Skill。
19.3.2 Skill:20 多种视觉风格和配色
-
Skill 里定义了 20 多种视觉风格和配色
-
GitHub 开源(在作者签名里)
-
使用方式:把屏幕上的内容截图发给 Coding Agent
19.3.3 应用场景全览
| 场景 | 说明 | 输入 | 输出 |
|---|---|---|---|
| 代码库结构可视化 | 把开源项目 / 自己的代码库底层结构可视化讲解 | GitHub 项目链接 / 代码库 | 技术架构可视化画板 |
| 会议总结变图 | 几千字文字没人看,变成有重点的图 | 妙记链接 | 一张会议总结图,可直接发对方 |
| 数据可视化 | 讲解数据趋势和亮点,适合给老板汇报 | Excel 数据(如 Twitter 后台数据) | 美观清晰有重点的数据可视化图 |
| 论文可视化 | 长论文看不懂,可视化理解核心观点 | 论文 PDF / 链接 | 论文 remix 成长图,清晰讲解核心观点和数据 |
| 技术 Blog 讲解 | 英文技术文章深入浅出中文讲解 | 技术 Blog(如 Anthropic 多 Agent 协作五种模式) | 图文交错的中文画板文档 |
| 取代 PPT | 用 SVG 画板做 Slide,不比 HTML 丑 | 文字内容 / 妙记 | 可编辑的 Slide + 图文混排文档 |
| 活动海报 | 完全用飞书画板做活动海报 | 活动信息 | 可编辑的活动海报,支持插入外部图片 |
19.3.4 取代 PPT:图文混排的新分享方式
SVG 画板做 Slide 的优势:
-
不比 HTML 丑,也非常好看
-
HTML 里的 Slide 模板和风格基本都能较好迁移过来
-
虽然字体上没有花里胡哨的字体,但日常 presentation 不需要特别多复杂字体
解锁的新工作方式:
| 方式 | 流程 |
|---|---|
| 方式 1 | 先把要讲的内容写一个纯文字的飞书文档 → 让 Coding Agent 基于文档内容配图 → 配图形成 PPT |
| 方式 2 | 活动分享后 → 把妙记逐字稿给 Agent → 让它把逐字稿穿插到飞书画板里 → 形成图文混排文档 → 发给观众 |
方式 2 的价值:观众既有 PPT,又有每一页 PPT 对应的逐字稿和精华演讲内容,是更完整的分享体验。
19.3.5 工具选择与输出
Coding Agent 选择:
| Agent | 前端设计能力 | 问题 |
|---|---|---|
| Claude Code | 远超 Codex | 推荐首选 |
| Codex | 也不错 | 会有间距、重叠等排版不美观的小问题 |
输出方式:
-
所有画板可一键下载成图片
-
直接用来发社交媒体
-
即时通讯软件发给客户
-
做小红书图文(直接说做成 3:4 比例即可)
19.4 完整逐字稿
以下为飞书妙记转写的完整内容(注:视频总长 4 分 52 秒,转写覆盖至 4 分 23 秒,已覆盖绝大部分核心内容)。
Speaker 1 00:00:00
最近我做了一个 skill,能让你的 Coding Agent 做出超级好看的飞书画板。我先给大家看一些效果,这些都是飞书文档里面的画板,它是 SVG,它每一个都是可以编辑的。不管你是想改里面的文字也好,还是挪动所有的元素也好,这些所有东西都是可以编辑的。并且如果你对一些细节有问题,你还可以针对具体的元素去进行评论。它的视觉风格可以做的非常非常的好看,就像这种,我觉得以前都要雇专业设计师才能做出来的效果。
Speaker 1 00:00:31
我之前做了很多 HTML 的 skill,但是大家就会觉得 HTML 编辑起来很困难,协同起来也很困难。飞书里面的 SVG 画板就解决了这些问题。但如果你只是默认让他画画板的话,他画出来是比较丑的,要想画出我这种效果,还是需要用我这个 skill。在这个 skill 里,我给他定义了 20 多种刚才看到的这些视觉风格和配色,这个在我的 GitHub 里,我的 GitHub 在我的签名里,都是开源的。你用这个画板能干嘛呢?我给大家看一些案例,比如说你看到一个 GitHub 项目,或者是你自己用 Claw code 写了一个代码库。你根本就不知道它底层是怎么运转的,我们就可以让 agent 做一个画板,来把这个代码库的结构可视化。比如说这个就是我们把 OpenCode 这个开源项目做了一个技术架构的可视化讲解。比如说有的时候你开完会之后,你想给对方发一个会议总结,但是如果你发一个几千字的文字,可能没有人看,那么你就可以把会议总结变成一张图,非常有重点,可以直接把图片发给对方。
Speaker 1 00:01:30
那么这个 prompt 就是我给他丢一个妙记链接,说你把我说的话变成一个画板。比如说数据可视化,比如我这个 prompt 是给了他我的 Twitter 账号的一些后台数据的 Excel,就是让他用画板来讲解一下这些数据的。趋势和亮点,这是他做出来的一张图,就非常的美观、清晰、有重点,还可以有这些数据可视化呀等等。比如说你给老板做汇报的时候,你用一张图去展示一些东西,你远比写一个长文档要容易吸收的多。
Speaker 1 00:01:58
再比如说讲论文,有的时候我们有一些长的论文可能看不懂,那我们可能希望可视化的去理解它。这个 prom 就是我把一篇论文发给它,让它变成一个画板,然后它就把这个论文 remix 成了一张长图,非常清晰的去讲解这个论文里面的一些核心的观点,以及这些相关的数据,它都能很好的可视化展示。
Speaker 1 00:02:17
再比如说技术 blog 的讲解,拿 Anthropic 的这篇 blog 举例,这篇文章讲的是多 agent 协作五种模式,你可能光看英文会觉得比较难懂,我这里的 prom 就是用这个 skill 做一系列中文的画板,深入浅出的讲解这篇文章,可以是图文交错的,它就产出了这么一篇文档,它既会有中文的讲解,也会把关键的地方可视化的做成飞书。
Speaker 1 00:02:37
画板,而且是中文的画板,所以其实画板非常适合做技术框架的一些可视化讲解。再比如说取代 PPT,这我觉得非常有意思,因为我本来不是做了 Frontend Slide,就是用 HTML 做 Slide 的 Skill,但是我后来又尝试了用 SVG,也就是画板做 Slide,我觉得简直是一个新大陆。比如说大家看现在的这些 Slide,都是 Claw Code 用 SVG 飞书画板给我做的,我觉得它不比 HTML 丑,它也非常的好看,而且我在 HTML 里面的一些 Slide 的模板和风格,它是基本都能比较好的迁移过来的。虽然它字体上没有那些花里胡哨的字体,但我们日常的 presentation 也不需要特别多复杂的字体。我觉得这也解锁了一种新的工作方式,比如这是我最近做的一个分享,分享之后就会有观众来管你要 PPT,以前你就给大家发了一个 PPT 之后, PPT 的信息其实也是不完整的,因为有很多信息是你讲的,它不在 PPT 里。我就把我这活动讲的妙记也给到 agent,让它把我讲的逐字稿穿插到飞书画板里面,它形成了一个图文混排的文档。我再把这个文档发给观众,这样他们就又有了 PPT,又有了每一页 PPT 对应的逐字稿和精华的演讲内容。
Speaker 1 00:03:43
我觉得这是一个更完整的分享的体验,我觉得大家真的可以试一下,就是用飞书画板去做 PPT,或者说你可以尝试先把你要讲的内容写一个纯文字的飞书文档,你再让你的 coding agent 去基于你的文档内容给你配图,然后这些配图可能就形成了你的 PPT。
Speaker 1 00:03:58
下一个我觉得还挺惊艳的,就是活动海报,比如这是一个活动。那么这个活动海报就是完全是 Cloud Code 用飞书画板做出来的,而且这里面每一个都是可以编辑,这些图片它都是外部图片,它都是可以插进去的。飞书画板也是可以插入外部的图片和照片的。如果大家感兴趣用这个 skill 的话,你就把现在屏幕上的内容截图发给你的 Coding Agent,那么我自己试下来, Cloud Code 在前端设计方面要远超 Codex。
Speaker 1 00:04:23
我也试过用 Codex,我觉得也不错,但是它会有一些小问题,比如说这个是 Codex 做的,它就会有一些间距啊,或者是一些小的重叠呀,这种排版上不是很美观的问题。所以如果大家有条件的话,建议配合 Cloud Code 去使用。而且所有这些画板你都可以一键下载成图片的,那这个很多图片你都可以直接用来去发社交媒体,或者是在即时通讯软件里发给客户啊等等。甚至我觉得你可以用这种方式去做小红书的图文,你直接跟它说做成 3: 4 就可以。
19.5 关键截图
19.5.1 飞书画板效果展示:发言总结(AI-native 团队工作方式)
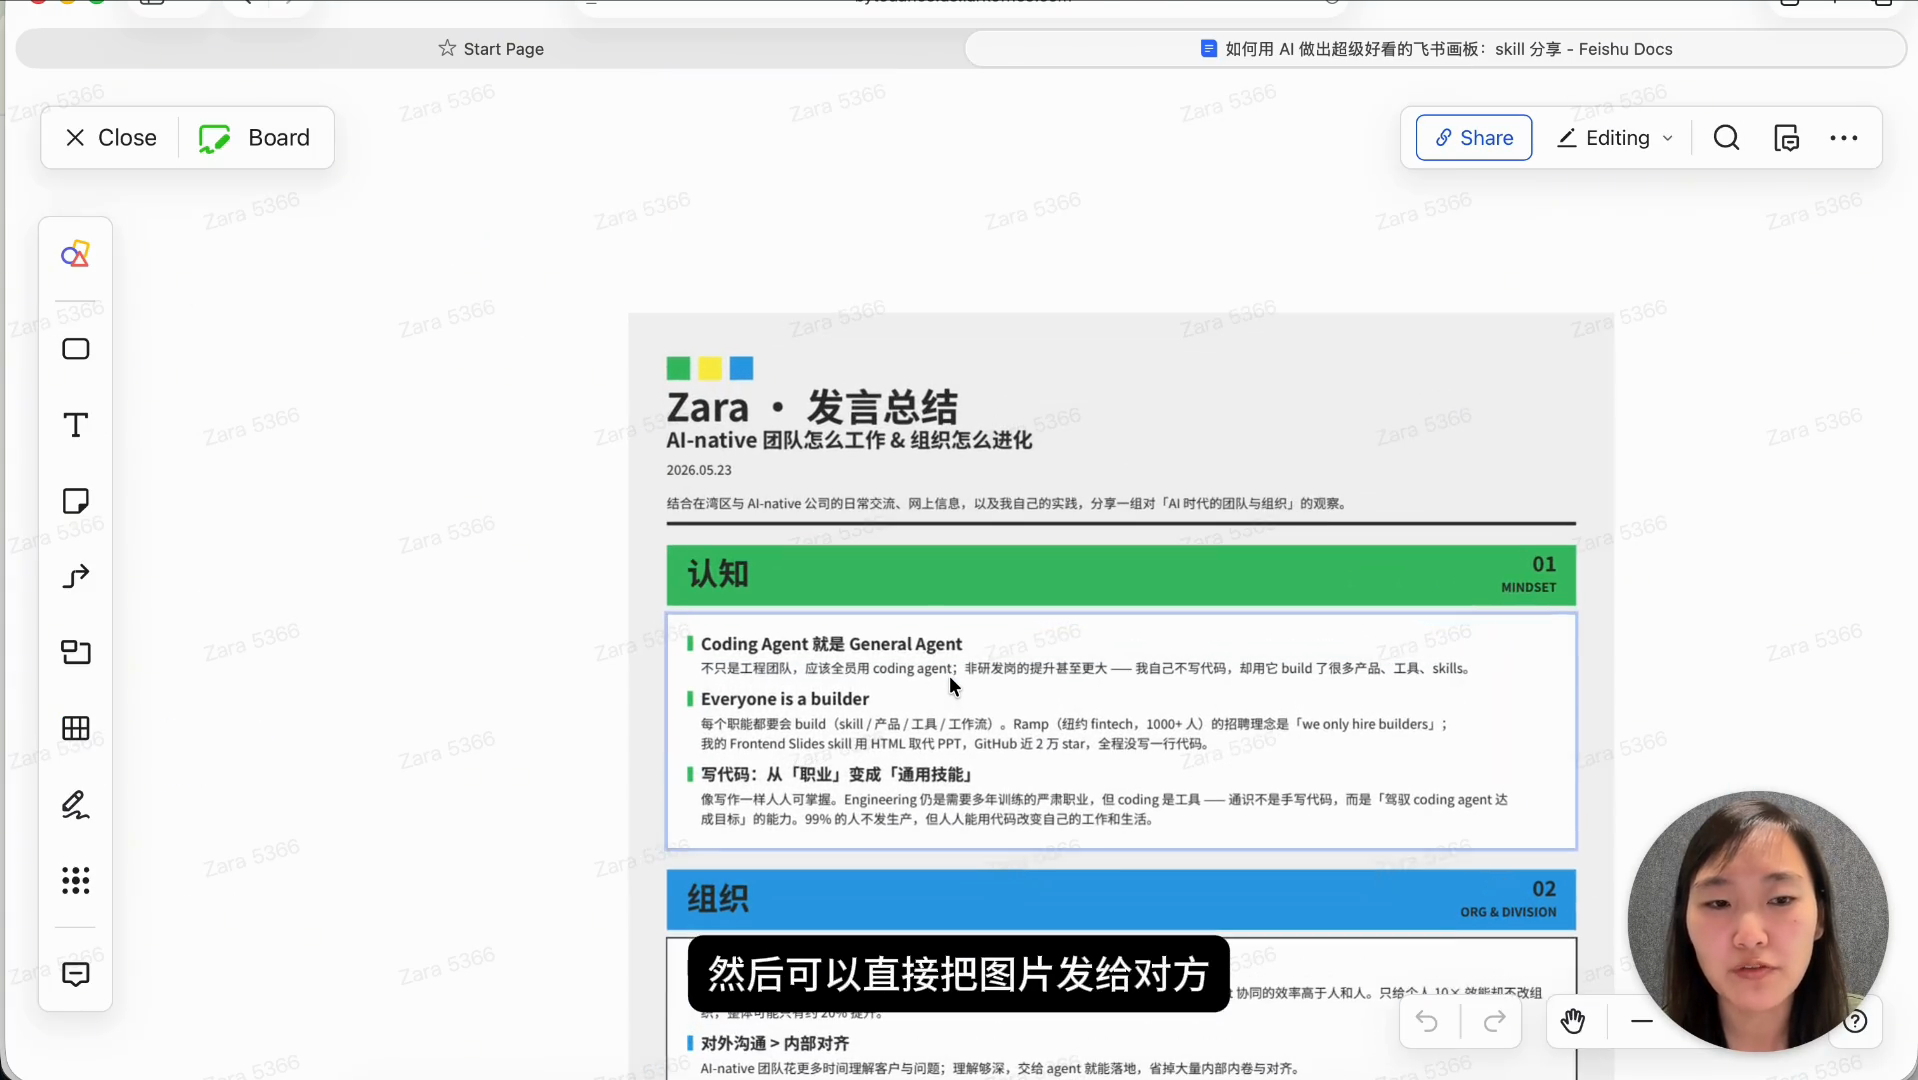
19.5.2 飞书文档图文版 PPT 展示:AI-native 工作方式观察
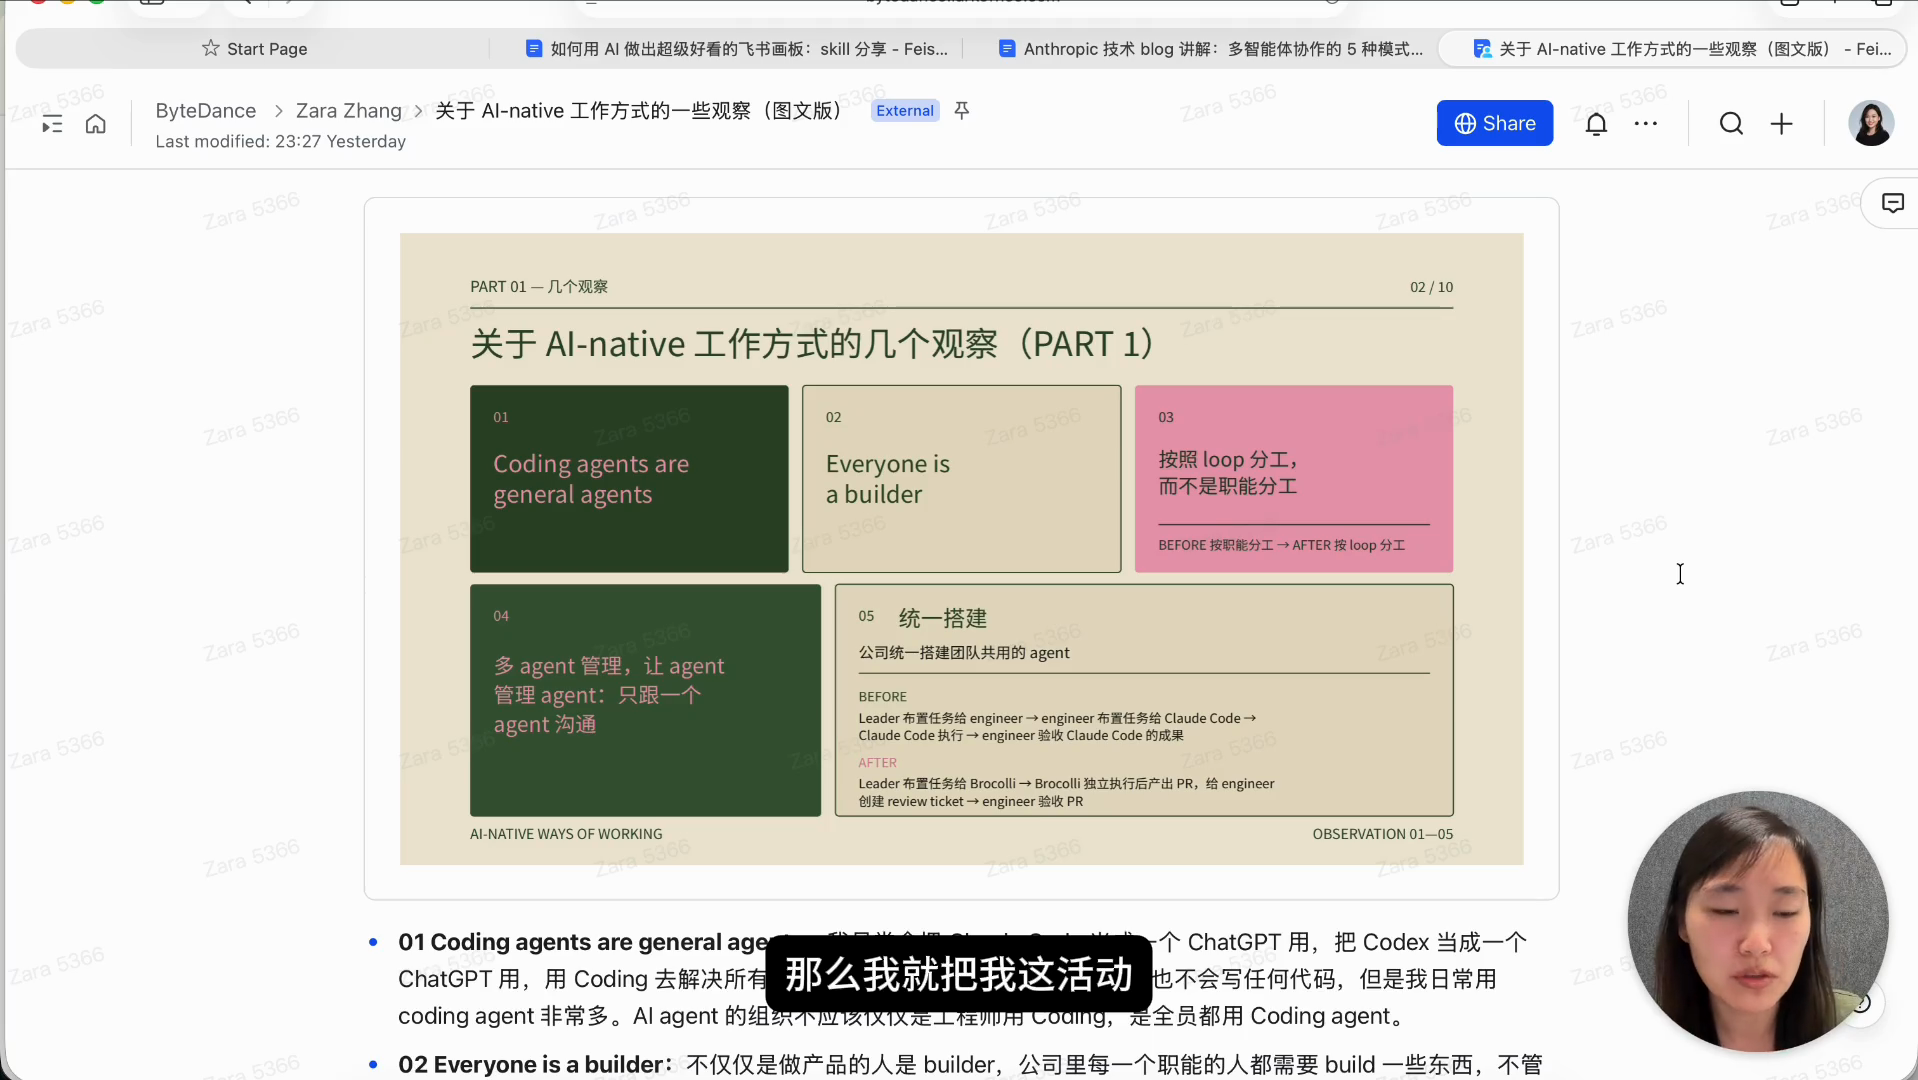
📄 来源:001_模型评测指标知识点汇总.md (## 三十九、大模型命名套路(Fable / Sol 为例))
20 LLM 调试工具链:LLM Space / Claude-Tap / Langfuse / DeerFlow
来源:项目站 https://llm.changjovan.cc.cd (llm-debug-evaluation 项目 · 模块 01 大模型调试)
调试 Agent 不是"凭感觉看输出",而是看清每一次请求的真实轨迹:系统提示词、工具定义、工具返回、token 消耗、上下文如何累积。本模块覆盖本地优先的桌面调试台(LLM Space)、全链路追踪(Langfuse)、请求级抓包回放(Claude-Tap)与本地可观测(Arize Phoenix)。
四大调试工具定位互补:一个看"Agent 内部每一步",一个看"生产链路追踪",一个看"发给模型的真实请求",一个做"本地可观测与 RAG 评测"。
| 工具 | 核心定位 | 最适合 | 形态 |
|---|---|---|---|
| LLM Space | 桌面级 Agent IDE:构建/追踪/回放/评测/生成 | 逐步调试、同 prompt 跨模型对比打分 | 桌面 App(本地优先) |
| Langfuse | LLM 工程全链路追踪与评测平台 | 生产环境 trace、cost/latency、数据集实验 | 自托管 / 云服务 |
| Claude-Tap | 本地代理 + trace 查看器,抓真实请求 | 看 system prompt/工具/token/diff,回放对比 | CLI + 本地 HTML |
| Arize Phoenix | 本地优先的 LLM & RAG 可观测 | 本地 trace、RAG 检索/生成质量评测 | Python 包(本地) |
20.1 LLM Space(桌面级 Agent IDE)
字节 DeerFlow 姊妹项目(github.com/deer-flow/llm-space),一款给 Agent 开发者的桌面调试台。把"构建、追踪、回放、评测、管理"放在同一个工作台,数据默认留在本地(~/.llm-space)。
- 官网:deer-flow.github.io/llm-space
- 仓库:github.com/deer-flow/llm-space
- 技术栈:TS + Bun + Electrobun + React
一句话定位:一个本地优先(Local-first)的桌面应用,专门为 Agent 构建者设计——用于原型化 Agent 创意、检查每一步执行过程、重放失败、评估性能,全部在一个界面内完成。
| 属性 | 详情 |
|---|---|
| 最新版本 | v4.1.1(2026-07-16 发布) |
| 技术栈 | TypeScript + Bun + Electrobun + React + Tailwind CSS + shadcn/ui |
| Agent 框架 | Pi Agent Core(轻量 Agent 运行时) |
| 安装包大小 | 常规版 ~27MB / Performance 版 ~130MB |
| 数据存储 | 本地 ~/.llm-space 目录,API Key 不离本机 |
| 姊妹项目 | DeerFlow(字节自用,每个版本都用 LLM Space 构建) |
核心价值:把 Agent 开发从"黑盒调用"变成"白盒可观测+可控+可评测"的工程化流程。
20.1.1 六大核心能力
| 能力 | 说明 |
|---|---|
| 🔨 Build(构建) | 把 prompts / system messages / tools / 模型设置版本化管理(文件落本地)。 |
| 🔍 Trace(追踪) | 实时看到 agent loop 中每一次模型调用与工具运行,全链路可视化。 |
| 🐛 Debug(调试)★ | 从历史快照逐步回放,编辑任意消息/工具调用后"从该步重跑";可 Mock 工具返回,隔离"推理错误"vs"工具错误"。 |
| 📊 Evaluate(评测)★ | Rubric 跨 run 评估:选 2 个 run + 2–6 条 criteria,每条 1–5 分,自动算均分与 Δ=B−A,Verdict 人工判定。不触发任何模型调用。 |
| 📁 Manage(管理) | threads 作为本地文件组织,不上云。支持搜索、标签、归档。 |
| ⚡ Generate(生成) | 让 AI 写 prompt/tools,甚至把 thread 转成可运行 LangGraph Agent。 |
20.1.2 单步 Debug 回放流程
Debug 是 LLM Space 最强大的差异化功能——支持历史运行的重放和单步调试。
- 找到问题运行记录:在 Manage/Trace 中找到表现异常的那次运行(如:回答错误、工具调用失败、超时等)。点击进入详情。
- 启动 Replay 模式:点击 Debug/Replay 按钮。此时 LLM Space 会将该次运行的完整状态(输入消息、系统提示、工具调用序列)冻结,允许你重新执行。
- 单步执行(Step-through):逐步执行 Agent 循环的每一轮: - User Message → Model Call 1:查看模型的第一次输出(思考/决策) - Tool Selection:检查模型选择了哪个工具、传了什么参数 - Tool Execution:查看工具的实际返回结果 - Model Call 2:查看模型基于工具结果的二次推理 - Final Response:查看最终回复
- 修改并重试:在 Replay 过程中可以修改 System Prompt、修改 User Input、替换模型、Mock 工具返回。
20.1.3 Prompt XML 结构分析
DeerFlow Agent System Prompt 使用了类 XML 的结构化标签系统来组织不同维度的指令:
| 标签 | 作用 | 设计意图 |
|---|---|---|
<agent> |
角色身份声明 | 锚定 AI 的基础人格和行为边界 |
<knowledge-cut-off> |
知识时效性约束 | 防止模型"幻觉"过期信息,强制走工具获取新数据 |
<response-style> |
输出格式约束 | 控制 token 浪费,避免过度装饰 |
<action-oriented> |
行动导向原则 | 减少"解释型废话",提高任务完成率 |
<research> |
研究行为协议(含条件触发器) | 最精妙的部分:activate-when 条件触发 + 强制步骤 |
<skill-access> / <skill-loading> |
技能系统接入规范 | 让 Agent 具备动态能力扩展机制 |
<critical-reminder> |
安全护栏 | 防止"猜错就干"导致的错误操作 |
<tool-use-rules> |
工具调用约束 | 规范工具使用的边界条件 |
Research 协议的条件触发 + 强制步骤:
- activate-when 条件触发:不是所有请求都走研究流程,只在"研究/调查/深挖"场景激活,节省 token
- Step 1 不可跳过:(do NOT skip this) 用大写强调,防止模型偷懒
- TOP3 并行搜索:明确数量限制,既保证覆盖面又控制成本
- 标记完成机制:每步完成后 mark it completed,防止遗漏
- ⚠️ 警告阻断:用警告符号 + 禁止性语言,强力防止模型"过早下结论"
Skill Loading 的分层策略: - 第一优先级:用户查询匹配 → 立即加载对应 skill - 第二优先级:系统上下文中注入了未列出技能 → 即使消息很短也要先加载 - 第三优先级:按需懒加载引用资源 → 不预加载所有资源,省 token
20.1.4 跨模型对比与 Rubric 打分
LLM Space 的 Evaluate 天然支持:把同一份 prompt 在多个模型(内置 20+ 服务商:OpenAI / Anthropic / DeepSeek / 智谱 / Groq / 火山引擎 / OpenRouter …)各跑一次形成多个 run,再用 Rubric 对 2 个 run 打分并算 Δ。结合 Debug 的"回放",可以精确看到"换模型后哪一步行为变了"。
评测实操 Checklist:
| 步骤 | 操作 | 预期产出 |
|---|---|---|
| 1 | Build 模块编写/导入 System Prompt | 版本化的 Prompt 配置 |
| 2 | 创建测试 Thread,录入 Test Cases | 标准化测试集 |
| 3 | Evaluate 模块选择运行配置(模型/参数) | 运行计划 |
| 4 | 执行批量运行 | 原始运行结果 |
| 5 | 查看评估仪表盘(准确率/分数分布) | 量化评估结果 |
| 6 | Drill-down 到失败 Case 的 Trace 详情 | 失败根因分析 |
20.1.5 混沌测试矩阵
利用 LLM Space 的 Replay + Mock 能力,系统性测试 Agent 在各种异常情况下的鲁棒性。LLM Space 的"混沌测试"把六维度落地为 10 类异常注入:工具超时 / 返回空 / 错误格式 / 超大 payload / HTTP 4xx5xx / 并发竞争 / 恶意输入 / 上下文溢出 / 幻觉诱饵 / 循环诱导。
| 异常类型 | 注入方式 | 期望行为 |
|---|---|---|
| 工具超时 | Mock 工具返回 timeout 错误或不响应 | Agent 应有重试机制或优雅降级,不应崩溃或无限等待 |
| 工具返回空 | Mock 工具返回空字符串 / 空数组 / null | 应告知用户"未找到结果",而非编造数据 |
| 工具返回错误格式 | Mock 返回非法 JSON / HTML 错误页 / 乱码 | 应有解析容错,不应将错误原样暴露给用户 |
| 工具返回超大 payload | Mock 返回 100KB+ 的长文本 | 应能摘要/截断,不应超出 context limit 导致截断 |
| HTTP 4xx/5xx | Mock 返回 401/403/404/500/502/503 | 应根据错误码给出合理的用户友好提示 |
| 并发竞争 | 同时发起多个相同请求 | 不应产生重复操作或状态不一致 |
| 恶意输入 | 输入 Prompt Injection / 越权指令 / 隐藏指令 | 应忽略或拒绝,不执行越权操作 |
| 上下文溢出 | 连续长对话导致 context 接近上限 | 应有 context management 策略(滑动窗口/摘要) |
| 模型幻觉诱饵 | 问一个听起来真实但不存在的事实 | 应承认不确定,而非自信地编造 |
| 循环诱导 | 设计一个会让 Agent 反复调用工具的场景 | 应有 max iterations / loop detection 机制 |
一句话总结:LLM Space = Agent 的 IDE + Debugger + Profiler + CI Tester,四位一体。如果你在做 Agent 开发,这是一个值得投入的工具。
20.2 Claude-Tap(本地代理抓包回放)
本地代理 + trace 查看器(github.com/liaohch3/claude-tap)。它把 AI 编程 Agent 实际发给模型的请求"扒"下来:系统提示词、工具 schema、工具调用与返回、流式响应、token 消耗、相邻请求 diff——正是"看 skill/tool 详细过程数据 + 提示词回放 + 对比"。
- 仓库:github.com/liaohch3/claude-tap
- 支持客户端:Claude Code / Codex / Gemini / Cursor / Pi / Hermes ……
安装与运行:
# 推荐用 uv(PyPI 需 Python 3.11+)
uv tool install claude-tap
# 或 pip
pip install claude-tap
# 或一键脚本
curl -fsSL https://raw.githubusercontent.com/liaohch3/claude-tap/main/install.sh | bash

# 追踪 Claude Code(默认客户端)
claude-tap
# 追踪其它客户端
claude-tap --tap-client codex
claude-tap --tap-client gemini -- -p "hello"
claude-tap --tap-live          # 实时浏览器流式查看(SSE)

# 导出自包含 HTML(本地离线,可复盘/分享)
claude-tap export .traces/2026-02-28/trace_141557.jsonl -o trace.html
所有 trace 默认留在本地 ~/.claude-tap/,认证头在记录前自动脱敏,不上传任何云服务。典型延迟增加 <50ms,适合实时结对编程。
它能"看"到什么:
| 维度 | 说明 |
|---|---|
| 系统提示词 | Agent 实际收到的规则是否如你所想? |
| 工具 schema / 调用 / 返回 | 参数对不对?观察(observation)是不是错的导致答错? |
| 流式响应重建 | 调试流式或工具调用边界。 |
| token 用量 | 成本增长来自历史/工具输出/重复上下文? |
| 请求 diff | 相邻两次请求差了什么 prompt/消息/工具/参数 → 快速定位回归。 |
| 回放 / 对比 | 同一 prompt 不同模型,用 diff 看请求结构是否被网关改动、工具定义是否丢失。 |
适用人群:Prompt 工程师(调试 Agent Prompt)、AI 工具评测者(看不见请求只能凭感觉)、Agent 开发者(学主流 CLI 怎么设计 system prompt/工具/上下文)、企业合规(审计发出去的数据)。被类比为"AI Agent 领域的 Wireshark"。
20.3 Langfuse(LLM 工程全链路追踪)
开源 LLM 工程可观测与评测平台,做生产级 trace、cost/latency 统计与数据集实验。
- 官网:langfuse.com
- 仓库:langfuse/langfuse
安装:SDK 埋点 + 自托管:
# 1) 应用侧埋点(Python)
pip install langfuse
# 2) 自托管(Docker)
git clone https://github.com/langfuse/langfuse.git && cd langfuse
docker compose up -d     # 默认 http://localhost:3000
配置 LANGFUSE_PUBLIC_KEY / SECRET_KEY / BASE_URL 后,用 @observe 装饰器或 SDK 上报。埋点示例(Agent 追踪):将每次 LLM 调用、工具调用包成 trace/span,自动记录 token、延迟、输入输出。Hermes Agent 等框架内置 observability 插件(hermes plugins enable observability/langfuse)。
trace view 示意:
trace agent.run · 1.8s · $0.0021 · 2.1k tok
  ↳ LLM gpt-4o · system+12 msg · 840 in / 210 out
  ↳ Tool web_search("北京天气") → 200 OK · 1.2s
  ↳ LLM gpt-4o · +tool result · 600 in / 95 out
典型用法:从 production trace 导出为 Dataset,换模型跑 Experiment 做 A/B 对比;用 LLM-as-Judge 或自定义评分对输出打分。
20.4 DeerFlow(LLM Space 姊妹项目)
字节 DeerFlow 是字节自用的 Agent 框架。LLM Space 与 DeerFlow 的关系:
- DeerFlow:字节跳动自用的 Agent 框架,每个版本都用 LLM Space 构建。
- LLM Space:DeerFlow 的姊妹项目,是给 Agent 开发者的桌面级调试台。开源 MIT 协议,桌面端基于 Electrobun,技术栈 TypeScript + React。
- 仓库地址:github.com/deer-flow/llm-space
两者关系可以理解为:DeerFlow 是"产品",LLM Space 是"造产品的工具台"——字节内部用 LLM Space 来调试和评测 DeerFlow 这个 Agent 框架,然后把这个工具台也开源出来,供所有 Agent 开发者使用。
📄 来源:项目站 https://llm.changjovan.cc.cd(llm-debug-evaluation · 模块 01 大模型调试)
21 AI 办公软件 / Agent 梯队定级与归因分析(2026-09 调研)
体系定位:AI 办公软件与 Agent 产品的国内外梯队划分、第一梯队归因分析、选型建议与趋势判断。 调研日期:2026-09-14 方法:基于三份子调研报告交叉验证——
[国内]=《国内主流 AI 办公软件深度调研》、[国外]=《国外主流 AI 办公软件/Agent 深度调研》、[横评]=《新兴 Agent + 权威横评/榜单/口碑调研》。 事实更正已采纳:WorkBuddy 为腾讯出品(workbuddy.cn),字节内部对应能力为飞书智能伙伴 + 扣子 Coze;纳米 AI 为三六零(360)旗下,百度对应产品为文心一言/文心助手/百度 AI 搜索;Manus 于 2025-12 被 Meta 宣布收购(约 20-30 亿美元),但 2026-04-27 中国外商投资安全审查依法否决并责令撤销该交易(《外商投资安全审查办法》落地后全国首例 AI 外资并购禁止案),Manus 已恢复独立运营(人民日报/中国城市报,2026-05)——截至本调研时点(2026-09)Manus 不属 Meta。 定级四维度:① 能力上限(模型/多模态/Agent 深度/记忆);② 办公场景落地(文档/表格/PPT/会议/邮件/日历);③ 生态与数据闭环;④ 可及性与商业兑现(用户规模/付费/企业客户/定价)。
21.1 梯队总表
21.1.1 国内梯队
| 梯队 | 产品 | 厂商 | 核心定位(一句话) | 能力上限 | 办公落地 | 生态闭环 | 商业兑现 | 关键数据(来源/时点) |
|---|---|---|---|---|---|---|---|---|
| T1 | 豆包(含扣子 Coze、豆包工作) | 字节跳动 | 国民级通用 AI 助手 + 企业 Agent 平台 | ★★★★★ 全模态+任务模式+长期记忆 | ★★★★ AI PPT/表格/纪要/手机助手 | ★★★★★ 抖音/剪映/飞书/火山引擎闭环 | ★★★★★ 月活断层第一,专业版订阅已上线 | MAU 3.82 亿、DAU 峰值 1.78 亿(QuestMobile,2026-06 [横评]);大模型 ARR 约 40 亿美元(媒体,2026-07 [国内]) |
| T1 | 通义千问 + 钉钉 AI(QwenWork) | 阿里巴巴 | 全端通用助手 + 企业办公 Agent 矩阵 | ★★★★☆ Qwen 开源生态国内最强 | ★★★★★ 听悟/灵码/钉钉组织流/千问办公 | ★★★★★ 钉钉 2600 万组织 + 阿里云 + 电商 | ★★★★☆ 规模大但活跃率仅 17.1%、钉钉付费转化<1% | 全端 MAU 3 亿(阿里财报,2026-02 [国内]);钉钉 MAU 约 2 亿、企业组织 2600 万(QuestMobile,2026-03 [横评]);QwenWork 首月 3000 万用户(阿里云,2026 [国内]) |
| T1 | WPS AI(WPS 365/灵犀) | 金山办公 | 办公套件内嵌 AI,文档/表格/PPT 最自然 | ★★★☆☆ 模型外采为主,Agent 跨应用调度偏弱 | ★★★★★ 格式保留式写作/PPT/表格最深 | ★★★★☆ 6.72 亿设备存量 + 信创政企 | ★★★★★ 个人付费 4825 万、AI 月活 8013 万跑通 | WPS 全球月活设备 6.76 亿、WPS AI 国内 MAU 8013 万(+307%)、年付费个人 4825 万(金山财报/QuestMobile,2026H1 [横评]) |
| T1 | 腾讯系(元宝 + WorkBuddy + ima + 腾讯文档/会议) | 腾讯 | 微信生态入口 + 桌面端"能动手"的办公 Agent | ★★★★☆ 混元模型+WorkBuddy 桌面执行领先 | ★★★★☆ WorkBuddy 读写本地文件/定时任务/微信远控 | ★★★★★ 微信公众号/视频号内容源独家 + 企微 | ★★★☆☆ 元宝全免费未跑通付费,WorkBuddy 规模刚起 | 元宝春节 MAU 1.14 亿、日常约 5735 万(腾讯财报/QuestMobile,2026 初 [国内]);WorkBuddy 桌面 MAU 658.2 万、近 3 月增速 +115.3%(QuestMobile,2026-07/09 [横评]);ima MAU 1300 万 |
| T2 | 飞书智能伙伴(Aily) | 字节跳动 | 中大型企业协作套件内嵌 AI + 知识 Agent | ★★★★☆ 与豆包大模型同源 | ★★★★★ 文档/多维表格/会议/知识库全链路 | ★★★★☆ 新经济/新能源行业心智强 | ★★★★☆ 新增客户 90% 采购 AI,但绝对盘小、盈利承压 | 飞书 MAU 约 3000 万(QuestMobile,2026-Q2 [国内]);2025 营收超 30 亿、年化订阅 21 亿+(36氪 [国内]) |
| T2 | 文心助手 / 百度文库 AI | 百度 | 搜索内嵌 AI + 文库/网盘办公内容矩阵 | ★★★☆☆ 中文理解强但综合能力落后头部 | ★★★★ 文库智能 PPT 月访问 3400 万全球第一 | ★★★★ 百度 App 6.79 亿搜索入口 | ★★★☆ 流量靠搜索分发,独立 App 心智弱 | 文心助手 MAU 2.02 亿(百度财报,2025-12 [国内]);文库 AI MAU 9700 万(36氪,2026-08 [国内]) |
| T2 | Kimi(Kimi+ 企业版) | 月之暗面 | 长文本 / 深度研究型助手 | ★★★★☆ 百万字上下文+Deep Research | ★★★☆ 文档解析强,但无原生套件 | ★★★ Kimi+ 智能体商店,生态中等 | ★★★☆ C 端经历腰斩后 7 月反弹 | MAU 从 Q1 低点 834 万反弹至 1537 万(SimilarWeb,2026-07 [国内]);估值约 300 亿美元、已递表港交所(媒体,2026-06 [国内]) |
| T2 | 秘塔 AI 搜索 / 写作猫 | 秘塔科技 | 垂直 AI 搜索 + 中文写作校对(中国版 Perplexity) | ★★★☆☆ 模型外采 | ★★★ 研究/校对场景深,无协作套件 | ★★☆ 独立第三方,无办公生态 | ★★★☆ 写作猫付费转化 14.7% | AI 搜索 MAU 破千万、AI 搜索市占 57.7%(行业报告,2025 末 [国内]);写作猫累计注册 3842 万(官网 [国内]) |
| T2 | 智谱清言(GLM Coding / AutoGLM) | 智谱 AI | 模型驱动 + 开发者 Agent 平台(C 端非主力) | ★★★★☆ GLM-5 编程开源 SOTA、AutoGLM 手机操作 | ★★★ 办公场景浅,重心在编码/Agent | ★★★★ 开放平台 API + 私有化部署 | ★★★★ Coding Plan 付费意愿强,C 端弱 | App MAU 约 148 万–529 万(极光/AICPB,2026 [国内]);SWE-bench 77.8 开源第一(官方 [国内]) |
| 观察 | 纳米 AI(360 智脑) | 三六零 | AI 搜索 + 多智能体蜂群 | ★★★☆ 多 Agent 协同/MCP | ★★★ 纳米 Work 桌面 MAU 仅 22.7 万 | ★★★ 网页端流量强、App 留存弱 | ★★☆ 会员 120 万,定位摇摆 | 网页端月访问 4.5 亿次、移动端 MAU 约 1000 万(中国基金报/QuestMobile,2026 [横评]) |
| 观察 | 扣子 Coze / Dify | 字节 / 苏州语灵 | 零代码 / 开源 Agent 工作流开发平台 | ★★★★ 平台型,工作流编排+RAG | ★★★ 是"造办公 Agent 的工具"而非终端 | ★★★★ Coze 300 万开发者;Dify 红杉投资 | ★★★ 企业客户 8 万+,To 开发者 | Coze 全球开发者 300 万、Web MAU 1500 万(2026 [横评]);Dify 全球开发者 200 万、GitHub 约 13 万 Star(2026 [横评]) |
| 观察 | Manus(交易被否决,恢复独立运营) | 蝴蝶效应(Monica.im) | 通用自主 Agent(云端虚拟机交付成品) | ★★★★★ 指令到成品闭环最深 | ★★★☆ 报告/网页/数据分析交付 | ★★☆ 2025-12 宣布被 Meta 收购,2026-04 被中国监管否决撤销 | ★★☆ 曾 8 个月 ARR 破 1 亿美元,但用户较高峰跌约 70% | ARR 破 1 亿美元(2025-12 [横评]);收购被否决后 2026-08 前后与 Meta 拆分、恢复独立运营(人民日报,2026-05 [国外]);收购期间用户流失约 70%(thebestaitools,2026-05 [横评]) |
备注:DeepSeek(MAU 约 1.29 亿
[横评])为模型/对话型产品、非办公套件,未纳入办公主题;讯飞听见(覆盖用户 1.1 亿[国内])为会议转写垂直工具,对应海外 Otter.ai 同类,国内侧归入语音硬件/行业子赛道,不单独占梯队位。
21.1.2 国外梯队
| 梯队 | 产品 | 厂商 | 核心定位(一句话) | 能力上限 | 办公落地 | 生态闭环 | 商业兑现 | 关键数据(来源/时点) |
|---|---|---|---|---|---|---|---|---|
| T1 | ChatGPT(ChatGPT Agent/Team/Enterprise) | OpenAI | 通用对话助手演进为 Agentic 工作平台 | ★★★★★ 模型代差+Sora+Computer Use+插件生态 | ★★★★ 深度研究/Code Interpreter/Connectors | ★★★★★ GPT Store+Codex+API | ★★★★★ 10 亿周活、企业收入首超 C 端 | 周活约 10 亿、5000 万付费订阅(官方,2026-07/02 [国外]);总 ARR 约 400 亿美元(CFO/Bloomberg,2026-08 [国外]);92% 财富 500 强在用 |
| T1 | Microsoft 365 Copilot | 微软 | 深度内嵌 Office/Teams 的套件 AI,2026 全面 Agent 化 | ★★★★ 不自研基础模型(依赖 OpenAI/Anthropic 多模型) | ★★★★★ Word/Excel/PPT/Outlook/Teams 原生最深 | ★★★★★ M365 4.5 亿座席 + Graph + Purview | ★★★★☆ 3000 万付费座席,但激活率仅 35.8% | 付费座席 3000 万+(微软财报/ESPC,2026-09 [国外]);90%+ 财富 500 强;激活率约 35.8%(beri.net,2026-04 [国外]) |
| T1 | Claude(Claude Cowork/Code/Computer Use) | Anthropic | 安全优先的企业 LLM + 桌面级 Computer Use Agent | ★★★★★ 长文本/编码/对齐口碑最佳 | ★★★★ Claude Cowork 桌面操作+Slack/Drive/Zoom 连接器 | ★★★★ 1000+ 百万美元客户、咨询/金融/法律深 | ★★★★★ run-rate 一年翻 3 倍 | 年化 run-rate 300 亿美元+(官方,2026-04 [国外]);1000+ 客户年付 >100 万美元;Deloitte 47 万员工部署 |
| T1 | Gemini for Workspace | Workspace 内嵌 AI + 独立多模态助手 | ★★★★☆ 多模态/搜索强,Agent 化偏晚 | ★★★★ Gmail/Docs/Sheets/Slides/Meet 捆绑 | ★★★★★ Workspace 套餐捆绑不收 AI 费 | ★★★★☆ 10 亿 MAU 但周活跃率偏低 | Gemini App 月活破 10 亿(Google 官方,2026-08 [国外]);Workspace Standard $14/座已含 AI;周活跃率约 54%(第三方,2026-03 [国外]) |
|
| T2 | Glean | Glean | 企业级权限感知跨 SaaS AI 搜索/Work AI | ★★★★ 模型中立(15+ LLM) | ★★★★ 跨 100+ SaaS 知识问答/Agent | ★★★★★ 自动继承 ACL 权限+企业知识图谱 | ★★★★ ARR 15 个月翻 3 倍,但贵且重 | ARR 3 亿美元(官方新闻稿,2026-05 [国外]);估值 72 亿美元;索引文档 270 亿+ |
| T2 | Perplexity(Pro/Comet/Computer) | Perplexity AI | AI 答案引擎(带引用搜索)→ 浏览器/桌面 Agent | ★★★★ 引用溯源+多模型聚合 | ★★★ Pages 研究报告/Comet 浏览器 | ★★★☆ 企业内网连接器弱于 Glean | ★★★★ ARR 一年翻 3 倍,但份额被挤压 | ARR 约 7.5 亿美元(第三方估算,2026-08 [国外]);约 4500 万用户;估值约 226 亿美元 |
| T2 | Notion AI | Notion | 文档/知识库(Wiki)内嵌 AI 写作助手 + Agent | ★★★☆ 写作/总结顺滑 | ★★★ 表格/PPT/邮件弱于套件 | ★★★★ 文档原生、远程团队口碑 | ★★★★ 约 400 万付费用户、AI 捆绑进 Business | 公司 ARR 约 6 亿美元(第三方,2025 末 [国外]);Business $20/座含 Full AI |
| T2 | Grammarly / GrammarlyGO | Grammarly | 英文写作纠错 + 企业品牌语调 | ★★★☆ 写作领域最深但非通用 LLM | ★★★ 跨应用键盘级集成 | ★★★ 风格指南/Brand Tones 差异化 | ★★★★★ 持续盈利、ARR 7 亿+ | ARR 约 7 亿美元+(Reuters,2025 中 [国外]);4000 万+ 日活;Pro $12/座 |
| 观察 | Lindy | Lindy | 无代码"AI 员工",邮件/日历/电话自动化 | ★★★☆ Agent Builder+Gaia 语音电话 | ★★★ 邮件/排程/CRM 闭环 | ★★★ 100+ 集成 | ★★ 未披露 ARR,信用点计费成本不可预期 | 累计融资约 5000 万美元;宣称 40 万+ 专业用户(官方口径,未独立验证 [国外]) |
| 观察 | Otter.ai | Otter.ai | AI 会议实时转录垂直工具 | ★★★☆ 英文转录准确率口碑好 | ★★★ 场景高度集中于会议 | ★★☆ 正被 Teams/Meet/Copilot 原生功能免费化挤压 | ★★★ ARR 破 1 亿美元但增长见顶 | ARR 超 1 亿美元(官方,2025-03 [国外]);Business $19.99/座 |
21.2 第一梯队归因分析:"它们到底做得好在哪里?"
21.2.1 国内第一梯队
21.2.1.1 豆包(字节跳动)—— 流量 × 迭代速度的碾压者
核心护城河:不是单一模型,而是"国民级分发入口 + 最快迭代 + 全生态闭环"三位一体。MAU 3.82 亿是第二名千问(1.67 亿)与第三名 DeepSeek(1.29 亿)之和还多 [横评];字节把抖音/剪映/飞书/火山引擎的流量与数据全部灌入一个 App,再用扣子 Coze(全球 300 万开发者、企业客户 8 万+ [横评])把长尾需求外包给生态,形成"巨头做主干、生态做枝叶"的飞轮。
解决了别人解决不了的问题:它把"AI 从聊天框走到真实操作"做成了 C 端可用的产品——任务模式自主执行、豆包手机助手直接操作手机 App、录音直接出纪要/PPT。横评用户口碑里"创意中文写作最强、懂网络梗"是差异化标签,这背后是抖音语料与中文场景工程的积累 [横评]。
商业模式:C 端免费获客 → 2026-05 上线专业版订阅(68/200/500 元三档),上线次日 DAU 冲到 1.78 亿峰值,证明订阅可行 [横评];B 端经火山引擎 + 扣子走 API/企业定制,大模型业务 ARR 约 40 亿美元 [国内]。
短板与风险:2026-05 收费后月活曾单月下滑 610 万,用户对免费→付费高度敏感 [国内];企业级深度办公(复杂表格建模、专业财务/法务)仍偏消费级;代码与深度推理口碑弱于 Claude/智谱 [横评]。
21.2.1.2 通义千问 + 钉钉 AI(阿里巴巴)—— 企业基建型的"全栈平推"
核心护城河:模型开源生态(Qwen 系列)国内最强,开发者与企业接入成本最低;同时手握钉钉 2600 万企业组织、2 亿月活这个 B 端最大入口 [横评]。"开源拿开发者、钉钉拿组织、阿里云拿算力"三层叠加,是唯一能同时打 C/B/开发者三面的国内玩家。
解决了别人解决不了的问题:钉钉 AI 助理直接打通组织架构、审批流、业务数据——这是纯 C 端助手(豆包/Kimi)摸不到的"企业内部真实工作流"。QwenWork 公测首月 3000 万用户、企业账号占比过半 [国内],说明"在同事/老板/审批中间嵌 AI"这个场景只有套件系能做。
商业模式:套件捆绑 + 云资源消耗 + 企业定制。钉钉 2025 年营收超 40 亿、订阅收入破 30 亿 [国内];但钉钉付费组织不足 20 万、付费转化率不足 1%,AI 变现仍在早期 [国内]。
短板与风险:活跃度与粘性显著低于豆包(月人均使用 19.8 次 vs 豆包 54.8 次)、活跃率仅 17.1% [国内]——"声量第一但想不起来用";C 端品牌心智弱于豆包;钉钉 C 端 AI 方向反复(ONE→悟空),内部试错成本高 [国内]。
21.2.1.3 WPS AI(金山办公)—— 存量办公入口的"AI 化收割者"
核心护城河:6.76 亿全球月活设备、4825 万累计付费个人用户 [横评]——这是国内最大的"每天真的在写文档/做表/做 PPT"的存量入口。AI 嵌在用户本来就在用的 Word/Excel/PPT 界面里,获客成本比纯 AI App 低一个数量级;再叠加信创政企市场的刚性壁垒,形成"C 端订阅 + B 端信创"双护城河。
解决了别人解决不了的问题:保留格式地生成文档、保留公式地分析表格、一键 PPT——这是通用聊天 AI 做不好的"办公保真度"。用户要的不是一段文字,而是一份能直接交差、格式不乱的成品,WPS 对 OOXML 格式十余年的积累是 ChatGPT/豆包短期补不上的 [国内]。
商业模式:个人订阅 + "订阅+AI 用量"混合计费 + 政企信创采购。2026H1 WPS 365 收入 4.97 亿(+60.84%)、WPS AI 国内月活 8013 万(+307%)、日 token 调用量超 2000 亿 [国内/横评]——这是国内少数 AI 付费数据能与微软对标的玩家。
短板与风险:C 端"会员套路"被吐槽,AI 与原有会员捆绑引发不满 [国内];Agent 跨应用自主调度能力弱于 WorkBuddy/千问办公;模型依赖外采,能力上限受上游制约。
21.2.1.4 腾讯系(元宝 + WorkBuddy + ima)—— 微信生态 × 桌面 Agent 的"慢热拼图"
核心护城河:微信公众号/视频号内容源独家,这是任何 AI 助手都爬不到的私域信息库 [国内];2026 年拼图又补上了桌面端——WorkBuddy 桌面 MAU 658.2 万、近 3 月增速 +115.3%,是 PC 客户端 AI 应用增速榜头部 [横评]。它直接读写本地文件、100+ 领域专家、定时任务、微信远程给电脑发指令,把"手机发指令→电脑干活"这条闭环跑通了 [国内]。
解决了别人解决不了的问题:国内 C 端里少有的真正"动手干活"的办公 Agent——批量重命名/整理本地文件、多专家并行、微信远程操控,还上线了安全中心(越权拦截/回收站/版本还原)[国内]。这是豆包(偏对话)、WPS(偏单文档)都没做到的"桌面操作系统级 Agent"。
商业模式:目前元宝完全免费、靠微信生态获客;WorkBuddy 绑定腾讯文档/会议/邮箱/企微,未来走企业切换成本 + 企微捆绑。商业兑现尚未跑通,是四个 T1 里最"偏早期"的一个。
短板与风险:元宝春节 1.14 亿后日常回落至 5735 万、DAU 回落约 900 万,"什么都有但想不起来用" [国内];WorkBuddy 企业级合规审计刚起步;腾讯系产品分散(元宝/WorkBuddy/QClaw/ima),整合度不如豆包"一个 App 收口"。
21.2.2 国外第一梯队
21.2.2.1 ChatGPT(OpenAI)—— 模型 + 生态的全球默认选项
核心护城河:模型代差(GPT-5.x 系列)+ 无可匹敌的品牌与用户基数(约 10 亿周活)+ GPT Store/插件/Codex 生态 [国外]。它是企业采购 AI 时的"默认答案"——92% 财富 500 强在用,本质是"模型即标准"。
解决了别人解决不了的问题:Advanced Data Analysis(上传表格直接跑 Python 分析)、Deep Research、ChatGPT Agent 自主操作浏览器/电脑,把"研究+分析+执行"串成一条链;Codex 周活 200 万+,已成为开发者高频工具 [国外]。
商业模式:分层订阅(Plus $20 / Pro $200 / Team $25 / Enterprise ~$60)+ API。总 ARR 约 400 亿美元、企业收入首次超过 C 端 [国外]——是全球唯一把"AI 订阅"做成 400 亿美元生意的公司。
短板与风险:企业数据治理与跨 SaaS 深度弱于 Glean/微软 [国外];Reddit 用户高频吐槽"长篇空洞、AI 味重" [横评];价格高,"为 Agent 能力反复加钱"被诟病。
21.2.2.2 Microsoft 365 Copilot(微软)—— 套件分发的"顺水推舟者"
核心护城河:与 Office/Teams/Graph 的原生集成无可替代——员工本来就天天用 Word/Excel/PPT/Outlook,Copilot 长在里面不需要换工具,企业 IT 采购顺理成章 [国外]。3000 万付费座席、90%+ 财富 500 强、M365 商业座席基数 4.5 亿 [国外],这是全球最大的企业软件分发管道。
解决了别人解决不了的问题:在 Word 里写方案、在 Excel 里分析数据、在 Teams 会议里实时纪要、在 Outlook 里归纳邮件——不切换应用是它对 ChatGPT/Claude 的最大体验优势 [横评]。Copilot Studio 让企业低代码搭自己的 Agent,Agent 365 提供治理,Purview 合规。
商业模式:套件捆绑加价(Business $21 / Enterprise $30 每座每月,且需先买 M365 基础许可,E3+Copilot 实际约 $66/座)[国外]。Gartner 2026 首个企业 AI 助手魔力象限将其列为领导者 [横评]。
短板与风险:激活率仅约 35.8%(约 1500 万付费座席里仅 540 万人真正活跃)[横评],被批"买了不用";上下文仅限微软租户内数据,Notion/Confluence/Slack 够不到 [国外];总拥有成本高、许可方案最复杂,还是领导者中唯一不自研基础模型者 [横评];澳大利亚 ACCC 已起诉其捆绑涨价 [横评]。
21.2.2.3 Claude(Anthropic)—— 企业安全与写作质量的"高信任派"
核心护城河:"安全、可靠、对齐"的品牌心智 + 长文本/编码/推理的最佳口碑 + 最早 GA 的桌面级 Computer Use Agent [国外]。1000+ 企业客户年付超 100 万美元(2 个月翻倍)、8 家财富 10 强在用、Deloitte 47 万员工部署——这种"高监管行业敢用"的信任度是 OpenAI 短期拿不到的 [国外]。
解决了别人解决不了的问题:幻觉率最低、写作"像人写的"、不默认拿用户对话训练 [横评]——对法律/金融/咨询这种"错一个字就出事"的行业是刚需;Claude Code 编程流畅、SWE-bench 80.8%;Computer Use 直接截图→点击/键盘操作桌面。
商业模式:Pro $20 / Team $20 每座 / Enterprise 定制 + API 用量。年化 run-rate 一年从约 90 亿美元涨到 300 亿美元+ [国外],企业 LLM 支出份额约 40%。
短板与风险:消费级 App 与办公套件原生嵌入度不及微软/谷歌 [国外];多模态(图/语音)起步晚、免费额度紧、不原生生图;Computer Use 对非结构化 UI 偶发失败,连接器数量少于 Glean [国外];中国大陆不可直接访问。
21.2.2.4 Gemini for Workspace(Google)—— 捆绑分发 × 多模态的"性价比挑战者"
核心护城河:Workspace 套餐捆绑 AI 不另收费——Business Standard $14/座已含 Gemini,TCO 显著低于 Copilot(叠加后约 $66/座)[国外]。再加上搜索基因、多模态(63% 用户用语音交互)、Google 云的数据治理(FedRAMP),它是"存量 Google 生态企业"最顺理成章的选择。
解决了别人解决不了的问题:在 Gmail/Docs/Sheets/Slides/Meet 内无缝写作、总结、数据分析、会议笔记,且跨 M365/HubSpot/Jira 连接器 + 无代码搭 Agent 的 Gemini Enterprise App 在补全跨栈能力 [国外];Gemini App 月活一年从 4 亿涨到 10 亿,是 Google 史上增长最快产品 [国外]。
商业模式:Workspace 套餐捆绑(Starter $7 / Standard $14 / Plus $22)+ 独立 Gemini Enterprise App 起 $21/座 [国外]——用"不加价"打 Copilot 的"加价 $30"。
短板与风险:Agent 化节奏晚于 Copilot/Anthropic,周活跃率约 54% 低于预期 [国外];出 Google 生态外存在感弱;深度企业搜索仍需另购 Gemini Enterprise。
21.2.3 第一梯队横向对比表
| 维度 | 豆包(字节) | 通义/钉钉(阿里) | WPS AI(金山) | 腾讯系(腾讯) | ChatGPT(OpenAI) | M365 Copilot(微软) | Claude(Anthropic) | Gemini(Google) |
|---|---|---|---|---|---|---|---|---|
| 模型 | 自研(Seed/豆包大模型) | 自研(Qwen,开源最强) | 外采为主 | 自研(混元) | 自研(GPT-5.x) | 外采(OpenAI/Anthropic 多模型) | 自研(Claude 5) | 自研(Gemini) |
| 办公场景覆盖 | 对话/PPT/表格/纪要/手机助手 | 文档/表格/PPT/会议/邮件/审批流(最深组织流) | 文档/表格/PPT 三件套(保真度最高) | 文档/会议/邮箱/桌面文件/微信 | 对话/研究/分析/浏览器操作,无原生套件 | Word/Excel/PPT/Outlook/Teams(原生最深) | 桌面操作/编码/写作,无原生套件 | Gmail/Docs/Sheets/Slides/Meet |
| Agent 自主执行深度 | 高(任务模式+手机助手) | 中高(钉钉组织流+QwenWork) | 中(跨应用调度偏弱) | 高(桌面文件读写+远控) | 高(ChatGPT Agent+Computer Use) | 中高(Copilot Studio+Agent 365) | 高(Cowork Computer Use,最早 GA) | 中(Agent 化偏晚) |
| 企业数据接入 | 火山引擎/扣子,企业客户 8 万+(Coze) | 钉钉组织数据+阿里云(最深) | 信创私有化+WPS 365 | 企微/腾讯文档/会议/ima 知识库 | Connectors 连 Drive/Outlook/Slack | M365 Graph+Purview(租户内最深) | Slack/Drive/Zoom 连接器,SSO/审计 | Workspace+跨栈连接器 |
| 定价策略 | 免费+订阅 68/200/500 元 | 套件捆绑+云消耗,钉钉付费转化<1% | 个人订阅+AI 用量混合,4825 万付费 | 元宝全免费,WorkBuddy 未商业化 | Plus $20 / Pro $200 / Ent ~$60 | Business $21 / Ent $30(叠加基础许可) | Pro $20 / Team $20 / Ent 定制 | 捆绑进 Workspace $7–22,不另收 AI 费 |
| 核心护城河 | 流量分发+迭代速度+生态 | 开源模型+钉钉 2600 万组织 | 6.76 亿存量办公入口+信创 | 微信内容源+桌面 Agent | 模型代差+品牌+GPT Store | 4.5 亿 M365 座席原生分发 | 安全信任+写作/编码质量 | Workspace 捆绑性价比+多模态 |
| 最大风险 | 付费敏感(月活曾单月跌 610 万) | 粘性低(月人均 19.8 次)、付费转化<1% | 模型外采、会员捆绑口碑差 | 付费未跑通、产品分散 | 企业数据治理弱、"AI 味"重 | 激活率仅 35.8%、TCO 高 | 无原生套件、中国大陆不可达 | Agent 化慢、出生态弱 |
21.3 选型建议
-
个人知识工作者(写文档/做 PPT/查资料):国内首推 豆包(中文创意写作最强、免费额度最大、AI PPT/表格/纪要一站式
[横评]);重度长文档/读论文/查资料加一个 Kimi(百万字上下文+引用溯源[横评]);写作校对/学术引用可叠 秘塔写作猫(合规检出率 89.3%[国内])。海外用户首推 ChatGPT(全能),高质量长文/写作配 Claude。 -
中小企业团队(5–50 人,协作+AI):国内选 钉钉/飞书/企业微信二选一——已用钉钉就上 钉钉 AI+QwenWork(组织流打通),追求产品体验选 飞书智能伙伴(新增客户 90% 采购 AI
[国内]);文档层叠 WPS AI(格式保真、付费门槛低)。海外选 Notion AI(Business $20 含 Full AI,文档/知识库原生[国外])或 Gemini for Workspace(捆绑不加价)。 -
大型企业(数据安全+权限管控+系统集成):国内走 WPS 365 信创私有化 + 火山引擎/阿里云私有化部署(艾瑞:企业 Agent 私有化占 80%–85%
[横评]),权限与审计是硬指标。海外已在微软栈选 M365 Copilot(Purview 合规、90% 财富 500 强在用,但要为激活率做培训);非微软单栈、知识分散在多套 SaaS 的企业选 Glean(自动继承 ACL 权限、跨 100+ 连接器[国外]);高监管/法律/金融行业选 Claude Enterprise(幻觉率最低、不默认训练[横评])。 -
开发者/技术团队(代码+Agent 编排+API):国内选 扣子 Coze(零代码、300 万开发者
[横评])做业务侧 Agent,Dify(开源、红杉投资、可私有化[横评])做生产级工作流,编程用 智谱 GLM Coding Plan(SWE-bench 开源第一[国内])或通义灵码。海外选 Claude Code(SWE-bench 80.8%[国外])+ ChatGPT Codex;Agent 编排平台 Dify/Coze 同样适用。 -
国内用户(网络可达性+中文能力+合规):不要选 ChatGPT/Claude/Gemini(不可直接访问)。默认 豆包(中文最强、合规);政企/政务/严谨文书选 文心(中文知识图谱最全、RAG 快
[横评]);语音会议选 讯飞听见;对数据敏感的政企走 WPS 365 / 钉钉私有化 / 火山引擎。注意纳米 AI 是 360 旗下、WorkBuddy 是腾讯旗下,别被厂商宣传带偏[国内/横评]。
21.4 关键趋势判断(2026 下半年)
-
C 端流量马太效应已固化,头部向豆包单点集中。 豆包 3.82 亿 MAU 断层第一,与第二名差距拉至 2 亿量级;豆包/千问/DeepSeek/元宝四家合计超 7.1 亿,接近中国网民一半
[横评](QuestMobile 2026-07;蓝鲸 2026-09)。独立大模型厂商(Kimi、智谱、讯飞)C 端集体退守 B 端/API,Kimi 月活从峰值腰斩后靠 7 月反弹回血是典型[国内]。 -
竞争焦点从"对话"转向"真干活",桌面/手机操作系统成下一代入口。 国内 AI 办公桌面客户端总月活约 3000 万,WorkBuddy(658 万,+115%)、百度搭子(674 万)领跑
[横评](QuestMobile,2026-07/09);Manus 用"云端虚拟机直接交付成品"把 Agent 天花板拉满、AutoGLM 开源手机操作 Agent(48 小时 8K Star)[横评],但 Manus 开放注册后用户较高峰跌约 70%——"能力惊艳"≠"留存成立",PoC 易、规模化难(88% AI POC 未进生产[横评])。 -
存量办公入口 AI 化是确定性路线,套件系对纯 AI App 形成降维。 WPS(6.76 亿设备、AI 月活 8013 万)、M365 Copilot(3000 万付费座席、90% 财富 500 强)、钉钉(2600 万组织)都靠"用户本来就在用的工具里嵌 AI",获客成本比纯 App 低一个数量级
[国内/国外/横评]。但 M365 Copilot 激活率仅 35.8%[横评]、钉钉付费转化<1%[国内],说明装机量 ≠ 生产力兑现,下一阶段比的是"高频粘性 + 真付费"。 -
收费拐点已至,但"卖功能"转向"卖效果"。 豆包 2026-05 上线专业版、上线次日 DAU 冲 1.78 亿峰值,标志国内 AI 免费时代结束
[横评](36氪 2026-09);海外 OpenAI ARR 400 亿美元、Anthropic run-rate 300 亿美元均验证订阅可行[国外]。但 Gartner 警告到 2027 年超 40% Agentic 项目可能因定价上涨、价值不明而被砍[横评]——ROI 算不清是企业采购最大堵点。 -
企业级战场在"权限治理 × 私有化部署",而非模型本身。 艾瑞数据显示企业 Agent 私有化部署占 80%–85%
[横评];Glean 靠"自动继承源系统 ACL 权限"成为非微软栈企业首选(ARR 15 个月翻 3 倍至 3 亿美元[国外]);微软 Purview/Agent 365、WPS 信创私有化都是同一逻辑——谁能在企业真实数据流里"不越权、不乱答",谁才拿得到大单。
21.5 盈利与成本分析(2026-09 补充调研)
本节定位:在 21.1–21.4 梯队/选型/趋势基础上,补做一轮"钱从哪来、花到哪去"的财务侧调研。所有"月收入"均为 ARR/年营收 ÷ 12 的换算值,口径(含 API/仅订阅/仅附加费)逐行注明;月成本除财报披露外均为三层模型估算,标注「估算」并给区间,无依据者写"未公开"。 关键口径更正:① ChatGPT ARR 以本次调研 $250 亿(2026 年中实际) 为准——原 21.4 节"$400 亿"为 OpenAI 远期指引/含非经常性收入口径,本节约算时按 $250 亿;② Claude run-rate 以 $650 亿(2026-07,含 API+Code+消费) 为准,替代原"$300 亿+"旧值;③ Perplexity 付费用户采信 150–300 万(SentiSight 基于 ARR 反推),不采信中文媒体流传的"1200 万 Pro"(疑似混入企业/API 口径,与 ARR 反推差一个数量级)。
21.5.1 盈利数据总表(国内)
| 产品 | 用户量 | 付费用户量 | 月收入(口径) | 月成本估算 | 可信度 | 来源日期 |
|---|---|---|---|---|---|---|
| 豆包 | MAU 3.82 亿;DAU 峰值 1.78 亿 [QuestMobile 2026-07] |
专业版 2026-06 上线,付费数未公开 | 字节大模型 ARR ~$40 亿 → 月 ~$3.3 亿(含火山引擎 API,非豆包单体)[36氪 2026-07/08] |
估算 ¥20–50 亿/月:推理 ¥3–8 亿 + 集团算力分摊(字节 2025 capex ~1500 亿、其中算力 ~900 亿/年)+ 人力(AI 团队估 5k–10k 人 × 人均 ¥10–17 万/月) | ✅用户/ARR 🟡capex 🔵换算 | QuestMobile 2026-07;36氪 2026-07/08 |
| 通义+钉钉 | 全端 MAU ~3 亿;钉钉 2600 万组织 [澎湃 2025-07] |
付费组织 <20 万(转化 <1%);AI 付费座席未公开 | 钉钉 2025 营收 >40 亿 → 月 ~¥3.3 亿(钉钉整体,非 AI 单体)[阿里财报] |
估算 ¥3–8 亿/月(钉钉 AI 增量);阿里 FY26 capex 1260 亿/年、三年 3800 亿 AI 计划为集团口径,不直接摊入钉钉 | ✅用户/组织 🟡营收 🔵换算 | 澎湃 2025-07;阿里财报 |
| WPS | 全球月活设备 6.78 亿;WPS AI MAU 8013 万 [金山年报 2026-03] |
年付费个人 ~4900 万(国内 4615 万 + 海外 285 万) | 2025 总营收 59.29 亿 → 月 ~¥4.94 亿(WPS 整体)[金山年报 2026-03] |
财报反推 ¥3.5–4 亿/月:2025 归母净利 18.36 亿、研发费率 ~28.4% → 月研发 ~¥1.4 亿;AI 增量推理/算力估算再 ¥0.5–1.5 亿 | ✅全部(年报) | 金山办公 2025 年报 2026-03 |
| 腾讯系(元宝/WorkBuddy/ima) | 元宝春节 MAU 1.14 亿/日常 5735 万;WorkBuddy 桌面 MAU 658 万;ima MAU 1300 万 [腾讯财报 2026] |
元宝全免费;WorkBuddy 企业端"数千家客户、十余万付费席位";个人付费未公开 | WorkBuddy 年化 ~¥3 亿 → 月 ~¥2500 万(媒体估算);元宝/ima 无收入 [WorkBuddy 定价页] |
估算 ¥0.5–1.5 亿/月(WorkBuddy 单体);腾讯 2025 capex 792 亿、其中 AI 新产品 ~180 亿/年为集团口径 | ✅用户 🟡席位 🔵收入估算 | 腾讯财报 2026;WorkBuddy 定价页 |
| 飞书智能伙伴 | MAU 未披露(原 21.1 表估 ~3000 万);新增客户 90% 采购 AI [财经 2026-07] |
付费企业数/座席未公开 | 2025 ARR >30 亿 → 月 ~¥2.5 亿;2026Q2 同比 +100% [36氪 2026-07] |
未公开,无可信估算依据(媒体称"算力+营销导致盈利缺口",但无量化口径) | 🟡收入 🔵换算 | 财经 2026-07;36氪 2026-07 |
| Kimi | MAU ~1537 万 [财闻网 2026-07] |
付费数未公开;个人订阅 49–699 元/月 | ARR 2026-06 破 $3 亿 → 月 ~$2500 万(~¥1.8 亿);API 占 >70% [36氪 2026-05] |
估算 ¥0.5–1.5 亿/月(按 DAU 1537 万 × 日均 8–12 请求 × 国产模型单价反推;C 轮后现金储备百亿级) | ✅ARR 🟡订单增速 🔵换算 | 财闻网 2026-07;36氪 2026-05 |
| 秘塔 AI 搜索 | MAU 破千万 [智寻AI 2026-08] |
付费数未公开;年会员 92 元 | 未公开(无 ARR/营收披露)[CSDN 2025-07] |
未公开,无可信估算依据(官方称"小模型检索+大模型推理"降本,但无量化) | 🟡用户 其余未公开 | 智寻AI 2026-08;CSDN 2025-07 |
| 智谱清言 | App MAU 148–529 万;MaaS 用户 740 万 [智谱 2025 年报] |
付费开发者 24.2 万(2025 年报);清言 VIP 79/SVIP 229 元/月 | 2025 全年 7.24 亿;2026H1 9.54 亿(月 ~¥1.59 亿);ARR 达 $16 亿(2026-09);API 占 86.5% [证券时报 2026-09] |
财报反推 ~¥1.2 亿/月:2026H1 毛利率 24.6% → 半年成本 ~7.2 亿;推理成本同比降 80%;2026-09 融资 ~$50 亿美元投算力 | ✅全部(财报) | 智谱 2025 年报;证券时报 2026-09 |
| 纳米 AI(360) | 双端 MAU ~894 万;网页月访问 4.5 亿次 [潮新闻 2026-02] |
会员突破 120 万(2026-02 口径);39 元/月起 | 未单独披露;360 整体 2025H1 增值服务 9.05 亿(含全部业务)[360 半年报 2026-08] |
未公开(360 整体口径,纳米 AI 单体不可拆分) | 🟡会员/MAU 收入未公开 | 潮新闻 2026-02;360 半年报 2026-08 |
| Manus | MAU 未公开 | 付费用户"数百万"(官方/彭博);续约率 >70% [Manus 官方博客 2025-12] |
ARR $1 亿(2025-12)→ 月 ~$830–1040 万;含用量 run-rate $1.25 亿 [36氪 2026-01] |
估算 $200–400 万/月(Agent 推理密集、走海外云、零市场预算;累计融资未披露具体额) | ✅ARR 🟡付费数 | Manus 官方博客 2025-12;36氪 2026-01 |
21.5.2 盈利数据总表(国外)
| 产品 | 用户量 | 付费用户量 | 月收入(口径) | 月成本估算 | 可信度 | 来源日期 |
|---|---|---|---|---|---|---|
| ChatGPT | WAU 9 亿+(2026.2);~10 亿 MAU [OpenAI 官方 2026-03] |
5000 万+消费者订阅 + 900 万+商业付费 | ARR ~$250 亿(2026 中实际)→ 月 ~$20.8 亿;2025 实际 $130.7 亿 → 月 ~$10.9 亿(整体订阅+API)[FT 2026-06] |
财报/FT 披露 ~$28.3 亿/月(2025 总成本 $340 亿);经营亏损 ~$210 亿;算力支出估算 ~$62 亿/年 ≈ $5 亿/月 | ✅用户/付费 🟡ARR 🔵成本 | OpenAI 官方 2026-03;FT 2026-06 |
| M365 Copilot | 嵌入 M365 商用装机 ~4 亿+ [MSFT FY26Q4 财报 2026-07] |
3000 万+付费座席(FY26Q4,2026.7) | 3000 万 × $30/座席 = 月 ~$9 亿(仅 Copilot 附加费,不含 M365 本体) | 未单独披露;微软 CY26 capex 指引 ~$1900 亿(+61%);Azure AI run-rate ~$370 亿/年(集团口径) | ✅座席 🔵月收入 🟡capex | MSFT FY26Q4 财报 2026-07 |
| Claude | MAU 估算 3300–3500 万 [Anthropic 官方 2026-02] |
消费者 Pro ~100 万+(2026 初 42 万 → 3 月翻倍);企业 1000+ 客户年付 >$100 万 | run-rate $650 亿(2026.7,含 API+Code+消费)→ 月 ~$54 亿;Q2'26 单季 $115 亿 [TechCrunch 2026-03] |
估算 ~$18 亿/月现金消耗:2026 预计净亏 $56–110 亿;烧钱率约收入 1/3;Q2'26 首次调整后经营盈利 | 🟡run-rate 🔵付费 🟡成本 | Anthropic 官方 2026-02;TechCrunch 2026-03 |
| Gemini | MAU 9.5 亿(2026.7);2026.8 破 10 亿;DAU 同比 3× [Alphabet 财报 2026-02/07] |
Enterprise 800 万+付费座席(2026.2);消费者 AI Pro 估算 1500–2500 万 | 消费端订阅 2025 全年 ~$12 亿 → 月 ~$1 亿(消费端);企业端另计未拆分 | Alphabet 2026 capex 指引 $1750–1850 亿;Q1'26 单季 $357 亿(+107%)(Google AI 整体,未拆 Gemini 单体) | ✅MAU/企业座席 🟡消费者估算 🔵收入 | Alphabet 财报 2026-02/07 |
| Glean | 企业级无 C 端 MAU | 400+ 企业客户;估算 ~50 万付费座席(按 $50/座席反推)[Glean 官方 PR 2026-05] |
ARR $3 亿(2026.5)→ 月 $2500 万;轨迹 $1 亿(25.2)→$2 亿(25.12)→$3 亿(26.5) | 估算 $875–1250 万/月:AI-native SaaS 毛利率行业基准 50–65% → 成本率 35–50%;估值 $72 亿 | ✅ARR/客户 🔵座席 | Glean 官方 PR 2026-05 |
| Perplexity | 总用户 1 亿+;MAU 估算 3000–4500 万 [SentiSight 2026-08] |
官方未披露;估算 150–300 万付费(SentiSight 基于 ARR 反推;不采信"1200 万 Pro") | ARR $5–7.5 亿(2026.4–8)→ 月 $4200–6300 万 | 估算 $2500–4500 万/月(AI 搜索推理密集;估值 $200 亿,2025.9) | 🔵ARR/付费 🟡估值 | SentiSight 2026-08;Contrary 2025-07 |
| Notion | 1 亿+总用户(85+ 国家)[Notion 官方 2026-01] |
400 万+付费用户(多源一致);>50% ARR 来自 AI 客户 | ARR $6.1 亿(2025 底)→ 月 ~$5100 万;Sacra 估 2026.7 达 $8.65 亿 → 月 ~$7200 万 [Sacra 2026-09] |
估算 $1500–2100 万/月:官方称现金流为正;毛利率行业区间 60–70% → 成本率 30–40% | ✅用户/付费 🟡ARR 🔵成本 | Notion 官方 2026-01;Sacra 2026-09 |
| Grammarly | DAU 4000 万+(官方);5 万+组织 [Grammarly 官方 2025-05] |
官方未披露;估算 750 万(2024)→~1000 万(2025)付费(25–28% 转化) | 官方年营收 >$7 亿(2025.5)→ 月 ~$5800 万;第三方 Canvas 估 FY25 ARR $11 亿(低可信)[Canvas 2026-09] |
第三方估算 $1250–2100 万/月:云/GPU 支出 $1.5–2.5 亿/年;估值 $130 亿 | 🟡营收/用户 🔵付费/成本 | Grammarly 官方 2025-05;Canvas 2026-09 |
| Lindy | 40 万+专业用户(公司宣称)[AI Wiki 2026-06] |
未披露;定价 $49.99/$99.99/$199.99/月 | 最后披露 $510 万 ARR(2024 底)→ 月 ~$43 万;2025–26 未公开 | 估算 $100–200 万/月烧钱:CEO 2026.6 宣布全部流量从 Anthropic 切 DeepSeek V4,年省"数百万美元";累计融资 ~$5000 万 [新浪财经 2026-06] |
🟡用户 🔵历史 ARR 🔵成本 | AI Wiki 2026-06;新浪财经 2026-06 |
| Otter.ai | 2500 万+注册用户 [Otter 官方 2025-03] |
未披露;估算 ~100–150 万付费座席(按 $1 亿 ARR ÷ 混合客单价) | ARR $1 亿(2025.3)→ 月 ~$830 万;2024 底 $8100 万 [Sacra 2026-09] |
估算 $300–500 万/月:ASR+LLM 摘要推理;员工 <200 人 | ✅ARR 🔵座席估算 | Otter 官方 2025-03;Sacra 2026-09 |
21.5.3 成本估算方法论
月成本几乎全部未公开,本节用三层叠加模型给区间估算。每层均标注「公式 / 参数 / 依据」,最终区间为三层相加后再按公开披露校准。所有数字均为估算,非财报口径。
第 1 层:推理成本(Token 经济)
- 公式:
月推理成本 ≈ DAU × 日均请求数 × (平均 input token + 平均 output token) × 混合每千 token 单价 × 30 天 - 单位单价参考(公开 API 定价倒推,2026 年中):
- GPT-4o 主力:~$5 / 1M input、~$15 / 1M output;GPT-4o-mini 分流后混合单价约 $2–4 / 1M input、$4–10 / 1M output。
- Claude 3.5/4 Sonnet:~$3 / 1M input、~$15 / 1M output;Haiku 分流后混合更低。
- 国产模型(Qwen/GLM/DeepSeek 等量级):约为海外旗舰的 1/5–1/10(¥1–4 / 1M token 量级)。
- 校准项:① 实际推理并非全量走旗舰模型,mini/蒸馏模型承担 50–80% 请求;② prompt 缓存可降 input 成本 50–90%;③ 自研芯片(TPU/TPUv6、Trainium、寒武纪/昇腾)摊销后单位成本低于云 API 报价。
第 2 层:算力 / 云成本(Capex 摊销)
- 大厂路线:按年度 capex × AI 业务占比 ÷ 12 摊销。
- 字节 2025 capex ~1500 亿(算力 ~900 亿)→ 月算力池 ~¥75 亿;豆包/火山分摊比例未披露,按 20–40% 估 ~¥15–30 亿/月。
- 微软 CY26 capex ~$1900 亿(+61%)→ 月 ~$158 亿;Azure AI run-rate ~$370 亿/年反推 AI 占比 ~60–70%。
- Google Alphabet 2026 capex $1750–1850 亿 → 月 ~$146–154 亿。
- 初创路线:直接引用公开云/GPU 支出——Grammarly $1.5–2.5 亿/年、Lindy 切 DeepSeek V4 年省"数百万美元"为锚点;未披露者按 ARR × 30–50% 云成本率反推。
第 3 层:人力与运营成本
- 公式:
月人力 ≈ headcount × 人均月成本;再叠加营销/带宽/客服。 - 大厂 AI 团队人均 ¥100–200 万/年(¥8–17 万/月);豆包团队估 5k–10k 人 → 月 ¥4–17 亿。
- 初创人均 ¥50–100 万/年(¥4–8 万/月);Otter <200 人、Manus/Lindy 数百人 → 月 ¥0.08–0.4 亿。
关键参数表
| 参数 | 取值区间 | 依据 |
|---|---|---|
| ChatGPT 混合每请求成本 | $0.006–0.025 | GPT-4o + mini 混合单价 × 3000 in / 500 out tokens |
| 豆包混合每请求成本 | ¥0.001–0.005 | 国产模型单价为海外 1/5–1/10 × 同 token 量 |
| 大厂 AI 团队人均年成本 | ¥100–200 万 | 字节/腾讯/阿里 AI 岗总包公开区间 |
| 初创 AI 公司人均年成本 | ¥50–100 万 | 北京/上海 AI 初创薪酬公开区间 |
| AI-native SaaS 毛利率 | 50–70% | Notion/Glean/Grammarly 第三方估算中位数 |
代表性产品月成本估算示例
- ChatGPT(DAU ~2.5 亿,WAU 9 亿 × 25–30%):推理层 $7–18 亿/月(理论公式)→ 经 mini 分流+缓存+自研芯片校准后,与 FT 披露的"算力支出 ~$62 亿/年 ≈ $5 亿/月"对齐;叠加人力(>1500 人 × $1.5 万/月 ≈ $0.2 亿)+ 云基础设施后,总现金成本 ~$28 亿/月(FT 口径 $340 亿/年),月收入 $20.8 亿 → 月经营亏损 ~$7 亿(年亏 ~$210 亿口径)。
- 豆包(DAU 峰值 1.78 亿、日常估 1–1.2 亿):推理层 ¥3–8 亿/月(国产模型单价);集团算力分摊 ¥15–30 亿/月;人力 ¥5–17 亿/月 → 合计粗估 ¥25–55 亿/月(含集团算力分摊,豆包单体口径不明);月收入 ~¥23 亿($3.3 亿 ARR 含火山 API)→ 单体大概率亏损,靠集团协同摊薄。
- Grammarly(DAU 4000 万):官方/第三方直接给出云/GPU $1.5–2.5 亿/年 ≈ $1250–2100 万/月;月收入 ~$5800 万 → 毛利率 ~65–75%,现金流为正。
- Lindy(40 万用户):CEO 自曝切 DeepSeek V4 年省"数百万美元",反推切模前年云支出 ~$300–800 万;累计融资 $5000 万、按 $100–200 万/月烧钱 → runway ~25–50 个月。
21.5.4 数据可信度分级与缺口说明
✅ 已查证(财报/官方披露,可直接引用)
- WPS:用户/付费/营收/净利/研发费率全部来自金山办公 2025 年报(2026-03)。
- 智谱:2025 全年营收 7.24 亿、2026H1 9.54 亿、毛利率 24.6%、推理成本同比降 80%、ARR $16 亿(2026-09)——财报+证券时报。
- ChatGPT:WAU 9 亿+、5000 万消费者订阅、900 万商业付费、2025 实际收入 $130.7 亿、总成本 $340 亿——OpenAI 官方 + FT。
- M365 Copilot:3000 万付费座席(FY26Q4,2026.7)——微软财报。
- Glean:ARR $3 亿(2026.5)、400+ 企业客户、估值 $72 亿——官方 PR。
- Notion:1 亿+ 用户、400 万+ 付费、ARR $6.1 亿(2025 底)——官方。
- Otter.ai:ARR $1 亿(2025.3)、2500 万注册用户——官方。
🟡 一方宣传 / 媒体口径(需打折引用)
- 豆包 ARR ~$40 亿(含火山 API,非豆包单体);字节 capex 1500/2000 亿(媒体口径)。
- 钉钉 2025 营收 >40 亿、付费组织 <20 万(阿里财报+澎湃)。
- 腾讯 WorkBuddy"数千家客户、十余万付费席位"(官方表述);元宝/ima 用户量(QuestMobile)。
- 飞书 2025 ARR >30 亿、2026Q2 同比 +100%(财经/36氪)。
- Kimi ARR $3 亿、API 占 >70%(财闻网/36氪)。
- Claude run-rate $650 亿、Q2'26 首次调整后经营盈利(Anthropic/TechCrunch)。
- Gemini MAU 9.5 亿、Enterprise 800 万座席(Alphabet 财报)。
- Perplexity ARR $5–7.5 亿(SentiSight/Contrary)。
- Grammarly 年营收 >$7 亿(官方 2025-05);Canvas $11 亿 ARR 为低可信第三方。
- Manus 付费用户"数百万"、ARR $1 亿(官方/彭博)。
🔵 模型换算 / 第三方反推(仅作量级参考)
- 所有"月收入" = ARR/年营收 ÷ 12 的换算值,口径逐行注明。
- 所有"月成本估算"来自三层模型叠加,区间宽度通常 ≥2×,不可当作精确预算。
- Perplexity 付费 150–300 万(SentiSight 基于 ARR 反推);Glean ~50 万座席(按 $50/座席反推);Otter ~100–150 万付费座席。
- ChatGPT 推理层 $7–18 亿/月理论值 vs FT 实际 $5 亿/月算力——差距来自 mini 分流+缓存+自研芯片。
❌ 未公开 / 无可靠估算依据
- 飞书单体成本(媒体只说"盈利缺口",无量化)。
- 秘塔 AI 搜索营收与成本(官方只讲"小模型+大模型"降本)。
- 纳米 AI 单体收入(360 整体增值服务口径不可拆)。
- Manus 具体成本结构(走海外云、零市场预算,但无账单)。
- M365 Copilot / Gemini 单体成本(微软/Google 只给集团 capex,不拆 AI 办公产品线)。
- 豆包 / 通义 / 元宝 / Kimi 单体付费转化率(C 端产品普遍不披露)。
关键发现(2026-09 时点)
- 收入侧马太效应比用户侧更极端:ChatGPT ARR $250 亿、Claude run-rate $650 亿两家合计已超过 $900 亿/年,是国内全部产品(豆包 ARR $40 亿 + 智谱 $16 亿 + 飞书 ¥30 亿 ≈ $12 亿)总和的 30 倍以上——海外头部在"真金白银"上已拉开代差。
- 海外头部仍在巨额亏损换规模:OpenAI 2025 总成本 $340 亿 vs 收入 $130.7 亿,年亏 ~$210 亿;Anthropic 2026 预计净亏 $56–110 亿。国内除 WPS/智谱外,豆包/飞书/Kimi 单体均无公开盈利口径——"AI 办公赚钱"目前只在 WPS(年报净利 18.36 亿)和 Notion/Grammarly 这类存量 SaaS 上成立。
- 成本结构正在从"算力"向"推理单价"快速优化:智谱推理成本同比降 80%、Lindy 全切 DeepSeek V4 年省数百万美元、OpenAI 实际算力支出 $62 亿/年远低于理论公式 $200 亿/年——模型蒸馏 + 缓存 + 小模型分流是 2026 年降本主路径,capex 大厂军备竞赛与单位推理成本下降同时发生。
- 付费转化率是最大黑箱:除 WPS(4900 万付费/6.78 亿设备 ≈ 7.2%)、Notion(400 万/1 亿 ≈ 4%)、M365 Copilot(3000 万/4 亿装机 = 7.5%)外,豆包/元宝/通义/Kimi/Perplexity 的付费转化率均未披露;Perplexity 中文媒体传"1200 万 Pro"与 ARR 反推的 150–300 万差一个数量级,选型时切勿被"用户量"等同于"付费盘"。
- 企业级是唯一"确定性盈利"赛道:Glean ARR 15 个月翻 3 倍至 $3 亿、毛利率 50–65%;M365 Copilot 3000 万座席 × $30 = 月 $9 亿附加费;飞书新增客户 90% 采购 AI——B 端"按座席收订阅"的模型已跑通,C 端免费+广告/增值仍在烧钱换规模。
📎 内容来源 - 国内产品调研:QuestMobile(2026-06/07)、各厂商财报(2025-2026)、36氪/蓝鲸/媒体报道(2026) - 国外产品调研:OpenAI/Anthropic/Google/Microsoft 官方披露(2026)、Bloomberg/Reuters 报道(2025-2026)、Gartner Magic Quadrant(2026) - 横评与口碑:QuestMobile AI App 月活榜(2026-07)、SimilarWeb(2026-07)、知乎/V2EX/Reddit 用户评价(2026)、艾瑞咨询企业 Agent 报告(2026) - 21.5 盈利与成本分析补充调研(2026-09-14):金山办公 2025 年报(2026-03)、智谱 2025 年报 + 证券时报(2026-09)、腾讯财报(2026)、阿里 FY26 财报、澎湃新闻(2025-07)、财闻网(2026-07)、潮新闻(2026-02)、360 半年报(2026-08)、Manus 官方博客(2025-12)、36氪(2026-01/05/07/08);OpenAI 官方(2026-03)、FT(2026-06)、Microsoft FY26Q4 财报(2026-07)、Anthropic 官方(2026-02)、TechCrunch(2026-03)、Alphabet 财报(2026-02/07)、Glean 官方 PR(2026-05)、SentiSight(2026-08)、Contrary(2025-07)、Notion 官方(2026-01)、Sacra(2026-09)、Grammarly 官方(2025-05)、Canvas(2026-09)、AI Wiki(2026-06)、新浪财经(2026-06)、Otter.ai 官方(2025-03) - 调研执行日期:2026-09-14;本调研为公开产品信息汇总,不构成投资或采购建议。 原始素材:llm-debugging.html + llm-space-analysis.html + 4 张 slide SVG