002:历史项目与测试开发
测试开发与 QA 质量保障(面试策略/QA体系/AI×测试/自动化/弱网)
📑 目录
- 1 测试开发与QA质量保障
- 2 AI 时代 QA 质量保障体系 · 完整对话与文档合集
- 2.1 第一部分 · 对话全记录
- 2.2 第二部分 · AI 时代软件质量保障体系设计
- 2.2.1 设计前提与四条原则
- 2.2.2 需求风险分级模型(ICDRK)
- 2.2.2.1 为什么不能靠"拍脑袋"
- 2.2.2.2 五维评分模型
- 2.2.2.3 硬性升降档规则(Override)
- 2.2.2.4 等级映射
- 2.2.2.5 定级流程与权责
- 2.2.2.6 重新定级触发条件(Re-grade Triggers)
- 2.2.3 QA 介入三档规范
- 2.2.3.1 三档定义
- 2.2.3.2 准入标准
- 2.2.3.3 L0 免介入 —— 需同时满足以下全部条件
- 2.2.3.4 L1 轻介入 —— 满足任一条件即进入 L1
- 2.2.3.5 L2 强介入 —— 满足任一条件即进入 L2
- 2.2.3.6 各档位 QA 工作清单
- 2.2.3.7 L0 · 免介入:QA 做什么
- 2.2.3.8 L1 · 轻介入:QA 做什么
- 2.2.3.9 L2 · 强介入:QA 做什么
- 2.2.3.10 动态准入与退出机制
- 2.2.3.11 落地:需求单必填字段
- 2.2.4 交付提效:三条主线
- 2.2.4.1 主线一:降低测试等待时长
- 2.2.4.2 主线二:降低测试执行时长
- 2.2.4.3 主线三:降低线上 bug 与事故风险
- 2.2.5 测试赋能:研发自助质量工具箱(Dev Self-Serve Quality Kit)
- 2.2.5.1 三不原则(Adoption 成败的分水岭)
- 2.2.5.2 工具箱十大能力
- 2.2.5.3 三个必须提前想清楚的失败模式
- 2.2.6 QA 工作流的 AI Native 重构
- 2.2.6.1 为什么说这是"电力革命"而不是"更快的马"
- 2.2.6.2 五层架构
- 2.2.6.3 最大的陷阱:AI 生成测试的"回声室效应"
- 2.2.6.4 三阶段落地路线
- 2.2.6.5 度量体系(建议基线与目标)
- 2.2.7 QA 的价值重估
- 2.2.7.1 哪些是 AI 确实做不到的(我认同的部分)
- 2.2.7.2 我要补充和修正的部分(不同意"经验即护城河")
- 2.2.7.3 新的价值定位与能力配方
- 2.2.7.4 关于"我作为 AI 说这些话"的自我审视
- 2.2.8 90 天落地路线图
- 2.2.9 附录:模板清单
- 2.3 第三部分 · AI 三重角色使用手册:思维教练 · 思维伙伴 · 工作搭子
- 2.4 第四部分 · 附录
- 3 36岁女测试靠这个网站,5天拿下AI测试offer!
- 3.1 视频信息
- 3.2 全文摘要
- 3.3 原文结构化整理
- 3.4 完整逐字稿
- 3.5 关键截图
- 4 2026软件测试一定要试试的5个Skill,功能齐全又好用!
- 4.1 视频信息
- 4.2 全文摘要
- 4.3 原文结构化整理
- 4.4 完整逐字稿
- 4.5 关键截图
- 5 用AI生成测试用例,需求文档完整:你怎么审核验收?
- 5.1 视频信息
- 5.2 全文摘要
- 5.3 原文结构化整理
- 5.4 完整逐字稿
- 5.5 关键截图
- 6 AI新岗位FDE,到底在招什么人?
- 6.1 视频信息
- 6.2 全文摘要
- 6.3 原文结构化整理
- 6.4 完整逐字稿
- 6.5 关键截图
- 7 面试官:弱网测试你平时是怎么开展的?
- 7.1 视频信息
- 7.2 全文摘要
- 7.3 原文结构化整理
- 7.4 完整逐字稿
- 7.5 关键截图
- 8 你说精通Web自动化测试,那你说说如何保障它的稳定性和可靠性
- 8.1 视频信息
- 8.2 全文摘要
- 8.3 原文结构化整理
- 8.4 完整逐字稿
- 8.5 关键截图
- 8.6 UI 自动化框架选型(Selenium / Playwright / Midscene.js)
- 8.7 Flaky 不稳定测试用例详解
- 8.8 Flaky 的量化表达 & pass@k 概念区分
- 9 测试开发(SDET)面试全合集:手撕代码 + AI-Coding + 口述模板
- 10 第一部分:面试现状与准备策略
- 10.1 手撕代码 vs AI-Coding 面试现状(北京 / 上海大厂 & 中厂,2026)
- 10.2 三种面试流派(测开岗位)
- 10.3 非常关键的误区澄清
- 10.4 测试开发岗位两种考察的本质区别
- 10.5 校招 vs 社招差异
- 10.6 备考建议(双轨准备)
- 11 附录 C:测开面试核心加分点速记
- 12 A/B 测试与灰度测试:区别、机制与工程实践
- 12.1 一句话先记住
- 12.2 核心区别对照表
- 12.3 A/B 测试的工程要点
- 12.4 灰度测试的工程要点(与稳定性三板斧联动)
- 12.5 面试回答模板(30 秒版本)
- 12.6 常见追问
- 13 Playwright / Web UI 自动化工程落地全景
- 13.1 落地路径:从「写脚本」到「平台化」四阶段
- 13.2 要不要创建 Skill?——要,而且这是落地的关键动作
- 13.3 落地难点与克服方法(面试重点)
- 13.4 当前业内有代表性的 Web/UI 自动化 Skill 与方案(2026-09 调研)
- 13.5 AI 时代 UI 自动化新范式(面试升华点)
- 14 传统测试 × AI 重塑:三个 Skill 的落地实践与方法论拆解
- 14.1 总体定位:三个 Skill 的分工体系(一条流水线)
- 14.2 test-master:通用测试方法论 Skill
- 14.3 test-master-improve:结构化用例设计 + 质量门禁(方法论核心)
- 14.4 api-automation:用例执行自动化
- 14.5 三 Skill 协同:端到端工作流全景
- 14.6 落地方法论总结:传统测试 × AI 重塑的六条心法(面试提炼)
- 14.7 面试口述模板(60 秒版本)
- 15 AI 时代测试工程师的三重角色:流程设计者 · AI 指挥官 · 关键节点决策者
- 15.1 观点总述:为什么"执行者"角色必然被淘汰
- 15.2 角色一:流程的设计者(Designer)
- 15.3 角色二:AI 的指挥官(Commander)
- 15.4 角色三:关键节点的决策者(Decision Maker)
- 15.5 三重角色如何协同(体系闭环)
- 15.6 能力配方与成长路径
- 15.7 面试口述模板(60 秒版本)
- 16 AI Native 测试工作流重构:行业实践调研(2026-09-14)
- 16.1 全景速览:谁在做、做到什么程度
- 16.2 字节跳动:从"经验驱动"到"智能驱动"(最完整的案例)
- 16.3 华为云:把"业务语义理解"编译进测试生成
- 16.4 蚂蚁集团:AI 生成代码的质量保障(质量左移 + 门禁)
- 16.5 阿里:Aone Copilot Agent 单测自动编写
- 16.6 快手:人机分工 + Skill 沉淀(与本文档方法论最契合)
- 16.7 腾讯:PagePilot PC 端 AI 测试 Skill
- 16.8 火山引擎 / Agent 时代:质量保障体系的延伸
- 16.9 共性最佳实践模式(八条,面试直接可用)
- 16.10 对测试工程师的启示(面试升华)
- 16.11 深度拆解:快手柯南 AI(五层架构与关键设计逐句落地)
- 16.12 快手"92% / 60%"统计口径(官方定义)
- 16.13 深度拆解:字节 NL2Test Agent(测试脚本雕刻 Test Script Carving)
- 16.14 "我的方法论"与大厂实践的同构对照(面试互证)
- 16.15 大厂智能测试方法:图灵测试类与对抗性对话测试(J16)
- 17 研发质量指标体系与性能测试管理(管理域/运行域)
- 17.1 研发质量指标(发布维度)7 项及统计口径(H9)
- 17.2 管理域 / 运行域双维度拆分统计逻辑(J11)
- 17.3 管理域性能测试方案(压测分级/风险/场景/指标/步骤)(J10)
1 测试开发与QA质量保障
体系定位:测试开发与 QA 质量保障(面试策略/QA体系/AI×测试/自动化/弱网) 来源文件数:13(内容原封不动按来源保留)
2 AI 时代 QA 质量保障体系 · 完整对话与文档合集
内容范围:需求风险分级模型(ICDRK)· QA 三档介入规范 · 交付提效三条主线 · 研发自助质量工具箱 · QA 工作流 AI Native 重构 · QA 价值重估 · AI 三重角色使用手册(18 个 prompt 模板)
来源:完整对话记录整理(原始提问 + 逐轮答复 + 两份展开文档) 编制日期:2026-09-03 | 版本:v1.0 结构:第一部分 对话全记录 | 第二部分 质量保障体系设计(完整文档)| 第三部分 AI 三重角色使用手册(完整文档)| 第四部分 附录(核心图文字版 + 索引)
2.1 第一部分 · 对话全记录
本部分按对话发生的顺序,完整保留原始提问与逐轮答复内容。第二部分、第三部分是这两轮答复展开成的完整可落地文档,本部分是它们的"对话版摘要",两者互为索引。
2.1.1 第一轮提问原文
1、在软件测试流程中,针对 AI 的冲击,软件迭代速度变得非常快,需要设计一套流程规范,将需求进行需求风险分析,拆分为 QA 可以不介入、轻介入和强介入的三种场景。那么如何针对需求进行风险高中低的分级?不同等级的判断规则是什么,帮我设计下。此外 QA 介入与否的三种场景该如何划分准入标准?不同场景下 QA 的主要工作又是什么?
2、如何进行需求迭代测试交付的提效?比如降低测试等待时长,降低测试时长,降低线上 bug 和事故风险。我的思考是:【需求分级】先将需求风险分级;【流程规范】和产研建立 QA 交付流程规范的原则(就是上面的介入原则);【测试赋能】针对免测需求,如何给研发提供方便、可靠、易用的回归测试工具和手段,让研发自己加单测、做冒烟测试、做回归测试、做自动化测试?针对需测需求,如何从针对需求的测试方案设计、测试用例设计、测试用例执行、上线回归、端到端测试等各个传统的敏捷迭代环节给 QA 进行提效,比如用 AI 来进行 QA 测试工作流的全流程 AI native 化,就像电力革命对工程的流水线进行全面重构一样地进行 QA 工作流的 AI 重构。
3、面对 AI 的冲击,QA 的价值是什么?这个问题需要我们重新审视和思考。首先明确一点,AI 很强大,但是 AI 不是万能的。AI 现在能做的是偏执行层面的东西,可以在执行 QA 这个角色里面把活又快又好地做到 60–70 分,甚至 80–90 分。但是资深测试工程师(比如 35 岁+)在职业生涯里面积累的测试经验、测试思维、测试方法论、测试架构理解,针对新业务场景的测试知识迁移,快速针对性地搭建对应业务的质量保障体系,进行风险管理的有效精准把控,这些不是 AI 在某个问题场景下、注意力局限和上下文理解非全局的情况下可以掌控的。AI 能解决在特定场景下特性需求下的问题,但是全局的思考和把控还得是人。QA 在职场中不仅要面对人的竞争,还得面临机器的竞争。AI 的价值可以将 QA 从繁琐重复的测试工作中节省出时间,用来进行 review、思考,进行更深入层面的测试设计和测试风险探索(比如代码层面或者其他层面)。那么 AI 你又是怎么看的呢?
2.1.2 第一轮答复 · 风险分级与三档介入
分级模型:ICDRK 五维行为锚定评分
Risk = 0.35×I(影响面)+ 0.20×C(变更熵)+ 0.15×D(可检测性)+ 0.15×R(可恢复性)+ 0.15×K(上下文成熟度),每维 1–5 分,并给出行为锚定描述(不是"高中低"这类主观词)。映射为:≥3.4 高、2.0–3.39 中、<2.0 且满足降档条件为低。
关键设计:评分之上必须有硬规则覆盖。 评分会被平均化——一个"支付主链路小改动"五维平均下来可能只有 2.4 分,但它是 P0。因此配置 一票升档 8 条(资金 / 隐私合规 / 不可逆操作 / DB schema / 公共组件 / 大促 / 新三方依赖 / 需求歧义≥2 个)直接判高;一票降档 5 条需全部满足才能判低——低风险必须"挣"出来。
治理要点(决定成败):研发自评是义务不是权力,不填不许进评审;QA 有最终定级权与一票升级权;自评与复核偏差率 >30% 时校准锚定描述而非追责;方案变更 / 范围变更 / 排期压缩 >30% 必须重新定级。
三档准入的核心不在"风险等级",在"排除清单":
| 档位 | 准入逻辑 | QA 主要工作 | 工时 |
|---|---|---|---|
| L0 免介入 | 风险=低 且 未命中 10 条排除清单(新功能首上 / 跨团队联调 / 算法策略类 / 权限鉴权 / 外部接口 / 资金 / 无等价性验证的重构 / 大促 / 需求歧义 / 无自测证据)且 研发过门禁 | 供工具、维护黄金用例集、10–20% 飞行抽检、发布后 24h 指标巡检、季度资格复审与回收 | ≈0.3 人时 |
| L1 轻介入 | 风险=中;或低风险但命中排除项 | 风险点清单 + 时间盒探索测试 30–60min + 代码/接口 diff review + 验收式抽检 + 灰度盯盘 | 0.5–1 人天 |
| L2 强介入 | 风险=高;或命中任一升档规则;或新业务/新架构首上 | 完整测试方案 + 分层设计 + 全量执行 + 上线评审/回滚演练 + 右移监控 + 故障模式库沉淀 | 2–10 人天 |
两个容易被忽略的点: - L1 必须配"不做清单"(不写完整用例、不做全量回归、不跑完整兼容矩阵),否则轻介入会自然膨胀成强介入,体系 3 个月内失效。 - 免测资格必须可进可出:单需求逃逸 P2+ 即回收该模块免测资格一个季度。免介入 ≠ 不负责,QA 负责的是"让它可以安全地免介入"。
完整评分标准、排除清单、门禁阈值、需求单必填字段见 第二部分 第 1–2 章。
2.1.3 第一轮答复 · 交付提效三条主线
你的三条主线(需求分级 → 流程规范 → 测试赋能)方向正确,补充三个执行层的关键点:
降低等待(通常占交付周期 30%–50%,零价值):单点最高 ROI 是把冒烟自动化从"提测后 QA 跑"前移到 feature 分支 CI 自动跑——提测打回率压到 10% 以下,"提测 → 首次有效测试"从 1–2 天变为 10 分钟。其余靠泳道环境、数据工厂、按 story 小批量提测。
降低执行时长:精准测试(diff + 调用链 + 历史失败率选例,裁 60%–90%)> 分层重心下移到接口/契约层 > 流量回放(近乎零用例编写成本)> Flaky 治理(目标 <1%)> AI 失败自动 triage。
降低线上风险:三级门禁(PR / 提测 / 发布)+ 渐进发布(金丝雀 1%→5%→20%→全量)+ 指标超阈值自动熔断回滚 + 生产只读冒烟拨测 + 每版本《版本风险报告》。
研发自测赋能的成败分水岭是"三不原则":不改变习惯(入口在 Git/CI/IDE,不新增需登录的系统)、不增加负担(冒烟 ≤5 分钟,失败给"人话 + 修复建议"而非堆栈)、不要求学 DSL。工具没人用,90% 的原因是踩了这三条。 十大能力里,流量回放 diff 是免测的最强凭据——它能证明"新旧版本在真实流量上行为一致",这是人工用例做不到的证据强度。
AI Native 重构(见 第四部分 图 2) —— 需修正一个常见误读:AI 的价值不是"每个环节加速",而是让流水线可以被重新排布。传统 QA 被"人力主传动轴"驱动:所有环节都要 QA 人力串行,因此被迫批量化、集中化,QA 必然是瓶颈。AI 让每个环节可被独立驱动后,流程可以从 Stage-Gate 变成"持续质量信号流 + 人类决策点"。
由此得出一个重要推论:当用例生成成本趋近于 0,"维护用例库"的价值崩塌,"定义测什么、为什么测"的价值暴涨。 QA 的核心资产从用例库迁移到「风险模型 + 判定规则 + 领域知识库 + 质量基建」。
必须写进规范的陷阱——AI 生成测试的"回声室效应":若 AI 从实现代码生成测试,测试只验证"代码做了什么"而非"应该做什么",结果是覆盖率上升、缺陷检出率不变甚至下降。对策:测试须从规约生成(或与从实现生成的做交叉校验)、用变异测试校验用例有效性(变异得分 ≥60% 才准入)、保留探索式测试作为独立信号——探索发现缺陷占比骤降是预警信号,不是好消息。
2.1.4 第一轮答复 · QA 的价值重估
先声明立场问题:一个 AI 论证"AI 无法替代人"天然有利益冲突。所以给可证伪的标准,用它检验而不是相信结论:
统计你过去一个月的工时分布: - >60% 在"按既定方案执行 + 记录结果 + 写标准化文档" → 这部分会被替代,且很快,现在就该移走重心。 - >40% 在"判断测什么 / 为什么测 / 这个风险值不值得投入 / 说服他人接受或拒绝风险" → 位置安全,AI 会显著放大你的产出。 - >30% 在"搭工具、定规则、设计流程、校准 AI" → 你是这轮变革的赢家,这类人市场价值在上升。
认同你的判断,并给出更强的论证:
- 波兰尼悖论:"我们知道的,比能说出来的多。"老 QA"闻着味儿知道这儿要出事"是压缩过的隐性经验。AI 的上下文是被喂进去的,人的上下文是活出来的——上季度那个客诉、那个接口是合作方临时加的、那个开关从没被验证过。这些组织记忆不在任何仓库里,无法被检索。
- 已知未知 vs 未知未知:AI 擅长穷举已知空间(组合、边界、变异、历史模式复用);人擅长拓展假设空间。测试的本质是探索不确定性,探索式测试的价值在于"提出假设"而非"跑用例"。
- 责任不可外包:"这个版本我建议不上"是组织角色,不是技术问题。AI 不能担责、不能顶住会议室里的业务压力。
- 生成与验证不对称:生成极易,验证极难。AI 产出越多,验证需求越大——这其实是 QA 岗位的扩容而非缩减。
但必须泼三盆冷水,否则就是自我安慰:
- 资历不是护城河,抽象能力才是。 "我踩过的坑多"恰恰是最容易被 AI 吸收的部分——坑一旦被记录就变成可检索知识。真正稀缺的是"在新情境下快速建模"。35 岁+ 里也有大量只是熟练工的人。用年龄自我安慰是最危险的心态。
- AI 正在向上侵蚀"设计层",不只是执行层。能读 PRD、代码、监控并生成测试策略的 AI 已经在路上。所以人的位置必须持续上移到:定义质量目标与风险偏好 → 构建让 AI 可靠工作的系统(基建/规则/上下文工程)→ 对结果判断与担责。
- 必须诚实面对商业现实:如果 AI 能把执行做到 80–90 分,"做到 95 分"的增量价值在很多场景下确实不值那个成本。而能主动做出这个取舍、并论证"为什么这个场景要 95 分、那个场景 80 分就够"——这本身就是资深的价值。
最后一条,也是最容易被忽略的:KPI 不重定价,QA 会被自己的指标杀死。
| 旧 KPI | 问题 | 应换成 |
|---|---|---|
| 发现缺陷数 | AI 会把这个数打爆,反而证明你只是执行者 | 风险前置拦截率 |
| 用例数 / 执行数 | 鼓励堆量 | 逃逸率 + 精准测试裁剪率 |
| 覆盖率 | 可造假(无断言测试) | 变异得分 + 业务场景覆盖率 |
一句话重定价:QA 的产出不是"发现了 N 个 bug",而是"这个业务在高速迭代下同时保持了 X 的逃逸率和 Y 的交付速度"——质量是交付能力的一部分,不是它的对立面。
2.1.5 第二轮提问与答复 · AI 作为思维教练、思维伙伴、工作搭子
提问原文
AI 可以作为我们的思维教练,思维伙伴,工作搭子。
答复要点
这个定位比"替代 vs 不被替代"的框架高明得多——它把 AI 从竞争对手重新定义成了乘数。但这三个词不是同义词,混用会让人对 AI 失望。
三种角色的区别不在能力,在"你先得有什么":
| 角色 | 核心动作 | AI 该做什么 | 你必须先有 | 失效信号 |
|---|---|---|---|---|
| 思维教练 | 挑战你 | 提问、质疑、逼你论证 | 自己的初步判断 | AI 直接给了答案 |
| 思维伙伴 | 扩展你 | 补视角、给框架、做类比 | 一个明确的问题 | 只附和你已有想法 |
| 工作搭子 | 替你干 | 出初稿、跑流程、批量产出 | 明确的验收标准 | 你没审就直接用 |
教练是垂直的(同一个答案往下挖),伙伴是水平的(同一个问题往宽看),搭子是替代的(同一件活替你做)。用错了位置就会出现典型场景:想找教练,却给了搭子的指令("帮我分析一下"),于是 AI 输出一份流畅的方案——思考就此停止。
一条最反直觉的纪律:顺序不能反。
错误:空着脑子问 AI「这个需求怎么测?」
     → 你被第一个答案锚定 → 独立思考被污染 → 教练价值归零

正确:先自己写 3 条判断 → 让 AI 挑战 → 你修正 → 定稿
这是最容易被忽略、也最值钱的一点:大多数人把 AI 当答案机用,恰恰放弃了它最有价值的部分。教练模式要求你先有输出——空着手去问,等于主动交出思考权。
必须点破的事实:AI 默认是讨好型的。不显式解除,它会先肯定你再补充,教练秒变啦啦队。所以所有教练类 prompt 的第一句必须是"不要认同我"。
三句最值得背下来的模板
- 教练模式最有力的一问(C5) —— 它把抽象质疑变成可验证的观测点:
"如果我这个判断是错的,最先会从哪里暴露出来? 请给出 3 个可观测的早期信号。"
- 搭子模式的核心原则 —— 给标准,不给自由:
"请生成【产物】。验收标准:1)…2)…3)…。完成后逐条自检并标注达标情况,未达标说明原因,不要掩饰。" + "对置信度最低的 3 项单独标注原因,我要重点审。"
- 伙伴模式的防敷衍设计:
"请给出 3 个来自不同学科的分析框架,分别用它们分析一遍,然后指出三种框架的结论在哪里分歧。"——结论完全一致说明它在敷衍。
一个陷阱值得单独说:流畅性错觉。 输出质量与正确性无关。一份排版精美、逻辑自洽的方案,可能完全建立在一个错误假设上。而 AI 写得越流畅,你越容易放弃批判。对策是强制要求它标注不确定性、信息缺口和置信度。
这个定位恰好补强了第一轮的论证,而且比"AI 做不到 X"更有力:三重角色成立的前提是,你得先有可被挑战的判断、可被扩展的框架、可被验收的标准——这三样都是人的产出,AI 一样给不了。所以它带来的是乘数而不是保险:
最终产出 = 你的思维基础 × AI 放大系数
思维基础 → 0 时,乘数再大仍是 0;思维基础 → 10 时,乘数 3 就是 30
一个从业十年、脑子里装着几百个故障模式和业务隐性规则的资深 QA,配一个敢质疑他的 AI,是复利;一个只会照 checklist 执行的人,配同一个 AI,只是得到一个更快的执行者——而那部分恰恰最先被替代。所以真正的问题不是"AI 能不能做我的工作",而是"我有没有值得被 AI 挑战的判断"。
18 个可直接复制的 prompt 模板(教练 C1–C7 / 伙伴 P1–P6 / 搭子 W1–W5)、QA 场景 × 角色映射表、四个陷阱与日常最小可用清单,见 第三部分。
2.1.6 第三轮提问 · 合集成文
请你把上面所有的对话信息,还有回复,完整的整理成一个 Markdown 文件吧,不要拆分成好几个。这个 Markdown 文件你可以看一下全局记忆里边的,必须得有目录锚点,结构要清晰。
处理方式:将两轮对话的原始提问 + 完整答复整理为第一部分;两份已产出的完整文档分别作为第二、第三部分;对话中以图形呈现的两张核心图转写为文字版附录(第四部分)。全文使用统一的标题层级与锚点,目录自动生成。
2.2 第二部分 · AI 时代软件质量保障体系设计
副标题:需求风险分级 · 差异化 QA 介入规范 · 交付提效路径 · QA 价值重估
适用范围:互联网业务研发团队(20–200 人研发规模),双周/周迭代或持续发布模式。 版本:v1.0 | 编制日期:2026-09-03
2.2.1 设计前提与四条原则
在 AI 把研发吞吐拉高 2–5 倍之后,质量体系要解决的核心矛盾是:变更速率上升,而人力投入不可能同步上升。因此本体系不是"把现有流程做快",而是把有限的 QA 注意力重新分配到风险最高的地方。
四条设计原则:
| 编号 | 原则 | 含义 |
|---|---|---|
| P1 | 风险驱动,而非流程驱动 | 保障强度由风险等级决定,不搞"所有需求一律全流程"的平均主义 |
| P2 | 质量左移到可自动化处,右移到可观测处 | 能自动化的交给门禁;不能自动化的(线上真实行为)交给监控与灰度 |
| P3 | QA 的核心资产是"规则与基建",不是"用例与执行" | 用例是被消耗品,规则与工具链才是复利资产 |
| P4 | 准入是动态的、可进可出 | 免测资格不是永久授权,按数据季度复审,逃逸即回收 |
一个必须先说清的前提:本体系生效的必要条件是可观测性与可回滚能力。如果一个服务没有监控、没有开关、回滚要半小时,那么任何"免测"都是赌博,此时应强制回退到强介入,优先补基建而非谈流程。
2.2.2 需求风险分级模型(ICDRK)
2.2.2.1 为什么不能靠"拍脑袋"
纯经验定级有三个失效模式:不可复现(换个人结论不同)、不可申诉(研发无法反驳也无法自检)、不可积累(无法从历史数据反哺)。因此采用「多维行为锚定评分 + 硬性升降档规则」的组合:评分保证可复现与可度量,硬规则保证不被评分"平均化"掉的长尾风险。
2.2.2.2 五维评分模型
Risk Score = 0.35×I + 0.20×C + 0.15×D + 0.15×R + 0.15×K
| 维度 | 名称 | 权重 | 回答的问题 |
|---|---|---|---|
| I | Impact 影响面 | 35% | 出事了,最坏会怎样? |
| C | Change Entropy 变更熵 | 20% | 这次改动的"扰动半径"有多大? |
| D | Detectability 可检测性 | 15% | 出事前,有多大概率被我们发现?(分越高=越难发现) |
| R | Recoverability 可恢复性 | 15% | 出事后,多久能止损? |
| K | Knowledge/Context 上下文成熟度 | 15% | 做这件事的人和系统,对这个模块有多熟? |
行为锚定评分标准(每维 1–5 分,取最接近的描述)
I · 影响面
| 分 | 锚定描述 |
|---|---|
| 1 | 内部后台/工具类,用户 < 100,无业务数据写入 |
| 2 | 单端非核心功能,用户 < 1 万,影响体验不影响结果 |
| 3 | 核心功能的非主链路(个人中心、设置、内容展示),用户 < 10 万 |
| 4 | 核心主链路旁路(购物车、优惠券、搜索排序),用户 10 万+,或显著影响内部运营效率 |
| 5 | 核心主链路(登录/下单/支付/结算/资金划转/消息触达/数据写入),全量用户,或涉及合规与安全 |
C · 变更熵
| 分 | 锚定描述 |
|---|---|
| 1 | 单模块单文件,diff < 50 行,无接口/数据结构变更 |
| 2 | 单服务内多文件,diff < 300 行,接口为兼容式新增字段 |
| 3 | 跨 2–3 个服务;或引入新配置/新开关;或接口语义发生变更 |
| 4 | 跨 3+ 服务或跨端需同步发布;或 DB schema 变更 / 数据迁移 |
| 5 | 跨团队跨系统重构;协议/中间件/基础组件变更;新旧双写灰度迁移 |
D · 可检测性(分数越高 = 越难发现 = 风险越高)
| 分 | 锚定描述 |
|---|---|
| 1 | 有完整自动化用例 + 业务对账 + 监控告警三层覆盖 |
| 2 | 自动化覆盖主路径,异常路径人工可快速发现,监控齐全 |
| 3 | 有监控无对账;或自动化仅覆盖部分路径 |
| 4 | 无自动化,仅依赖人工;或问题表现为"静默错误"(数据错但不报错) |
| 5 | 无监控、无日志、无对账,问题只能靠用户反馈才暴露 |
R · 可恢复性
| 分 | 锚定描述 |
|---|---|
| 1 | 一键回滚 + 开关秒级关闭 + 数据完全可逆 |
| 2 | 可回滚(< 5 分钟),数据可自动修复 |
| 3 | 可回滚但需人工数据订正(< 1 小时) |
| 4 | 回滚困难:涉及异步/离线任务,或已被外部系统消费 |
| 5 | 不可逆:已发货 / 已发券 / 已推送 / 已删数据 / 资金已划转 |
K · 上下文成熟度
| 分 | 锚定描述 |
|---|---|
| 1 | Owner 熟悉,文档齐全,近 90 天 0 缺陷 |
| 2 | Owner 熟悉,文档一般,近 90 天 < 2 个缺陷 |
| 3 | 新人接手或文档缺失;或近 90 天 2–5 个缺陷 |
| 4 | 跨团队协作 + 上下文分散;或近 90 天 5+ 缺陷 / 出现 1 次 P2 |
| 5 | 无明确 Owner / 无人懂全貌;或近 90 天出过 P1–P0 故障 |
2.2.2.3 硬性升降档规则(Override)
评分会被平均化,硬规则负责兜住长尾。
一票升档 → 直接判定为「高风险」(共 8 条)
- 涉及资金链路:支付、结算、计费、对账、发票、退款
- 涉及用户数据 / 隐私 / 合规 / 鉴权 / 权限 / 租户隔离 / 加密
- 存在不可逆操作:删除数据、发券发货、对外推送、短信邮件、广播消息
- DB schema 变更、数据迁移、跨存储同步
- 公共基础组件 / 中间件 / SDK / 协议 / 对外接口签名变更(影响跨团队)
- 大促、重大活动、发布窗口冻结期
- 首次引入的新技术栈 / 新三方依赖,且无兜底降级方案
- 需求评审中被识别出 ≥ 2 个未收敛的关键歧义或未定义行为
补充规则:任一维度得 5 分,风险等级不得低于「中」;I ≥ 4 且 R ≥ 4 时,直接判「高」。
一票降档 → 判定为「低风险」需同时满足(共 5 条,缺一不可)
- 不属于上述任何一条升档规则
- 变更局限在单服务内,且 diff 可控(建议阈值:后端 < 300 行 / 前端 < 500 行)
- 现有自动化回归覆盖该模块主路径与关键异常路径
- 具备一键回滚或秒级开关,且监控告警已覆盖
- 有明确 Owner,且该模块近 90 天无线上缺陷
2.2.2.4 等级映射
| 加权分 | 等级 | 强制约束 |
|---|---|---|
| ≥ 3.4 | 高风险(H) | 默认强介入;必须由 QA 复核定级 |
| 2.0 – 3.39 | 中风险(M) | 默认轻介入;特定条件下升为强介入 |
| < 2.0 且满足全部降档条件 | 低风险(L) | 可申请免介入 |
2.2.2.5 定级流程与权责
需求创建(PM 填 PRD)
   ↓
① 研发自评:在需求单填写 ICDRK 五维分 + 升档项勾选     ← 5 分钟,强制字段
   ↓
② AI 预填(可选但推荐):读 PRD + 代码 diff + 历史缺陷,自动给出建议分与理由
   ↓
③ QA 复核定级:QA 拥有最终定级权与一票升级权          ← 需求评审会上完成
   ↓
④ 定级结果写入需求单,驱动后续介入档位与 CI 门禁强度
权责设计要点(这是治理成败的关键):
- 研发自评是义务,不是权力:不填不许进入评审。
- QA 有最终定级权:研发可申诉,但申诉需提供新证据(如补充监控、补充回滚方案),由 QA Lead 裁决。
- 自评与 QA 复核的偏差要度量:偏差率 > 30% 说明评分标准没对齐,需要校准锚定描述,而不是追责。
2.2.2.6 重新定级触发条件(Re-grade Triggers)
定级不是一次性动作。出现以下任一情况必须重新定级:
| 触发事件 | 说明 |
|---|---|
| 技术方案变更 | 实现方式与评审时不一致(如引入新中间件) |
| 需求范围变更 | 新增/删减功能点、跨版本拆包 |
| 排期压缩 | 测试时间被压缩 > 30%,风险实质上升 |
| 新增依赖方 | 联调方数量增加 |
| 提测质量不达标被打回 | 说明上下文成熟度 K 值被低估 |
| 上线前发现新风险 | 任何时候,任何人都可以发起升级 |
2.2.3 QA 介入三档规范
2.2.3.1 三档定义
| 档位 | 名称 | 本质 | QA 角色 | 典型工时/需求 |
|---|---|---|---|---|
| L0 | 免介入(Skip) | QA 不参与该需求的过程,只提供工具与抽检 | 规则供给者 / 审计者 | 0.2–0.5 人时 |
| L1 | 轻介入(Light) | QA 做风险评审与抽验收口,不做全流程执行 | 风险评审者 / 抽检者 | 0.5–1 人天 |
| L2 | 强介入(Full) | QA 全流程负责,输出完整测试方案与质量结论 | 质量负责人 | 2–10 人天 |
2.2.3.2 准入标准
2.2.3.3 L0 免介入 —— 需同时满足以下全部条件
A. 风险维度 1. 风险等级 = 低(L) 2. 未命中任何一条升档规则
B. 排除清单(命中任一即取消 L0 资格,不论评分)
| # | 排除项 | 理由 |
|---|---|---|
| 1 | 新功能 / 新业务首次上线 | 无历史基线,风险不可估计 |
| 2 | 跨端 / 跨服务 / 跨团队联调 | 集成面风险无法由单方自证 |
| 3 | 算法 / 模型 / 策略 / 风控规则类效果变更 | 正确性无明确 oracle,需人工判定 |
| 4 | 涉及多角色权限、鉴权、租户隔离 | 安全类缺陷逃逸代价极高 |
| 5 | 涉及外部合作方 / 三方 API / 对外开放接口 | 契约责任在外部,不可回滚 |
| 6 | 涉及资金、合约、履约、合规数据 | 一票升档项 |
| 7 | 性能优化 / 重构,且缺乏等价性验证手段 | 行为等价性无法自证 |
| 8 | 大促 / 重大活动 / 发布冻结期 | 容错窗口为零 |
| 9 | 存在未消解的需求歧义或未定义行为 | 测什么都没定,无法免测 |
| 10 | 研发未完成"自助质量门禁"(无自测证据) | 无证据即无信任 |
C. 赋能维度(研发必须自证)
| 门禁项 | 建议阈值 |
|---|---|
| 增量代码单测覆盖率 | ≥ 60%(核心模块 ≥ 80%) |
| 静态扫描 / 安全扫描 | 无新增高危问题 |
| 接口契约测试 | 全通过,且无破坏性变更 |
| QA 托管的黄金冒烟用例集 | 100% 通过 |
| 流量回放 diff(如具备能力) | 无未解释的差异 |
| 回滚 / 开关方案 | 已验证可用 |
2.2.3.4 L1 轻介入 —— 满足任一条件即进入 L1
- 风险等级 = 中(M),且未命中升档规则
- 风险等级 = 低(L),但命中 ≥ 1 条 L0 排除项
- 风险等级 = 高(H),但变更面极小且兜底充分 —— 需 QA Lead 特批,且必须留存书面理由
- 存量功能的渐进式优化 / 局部重构,且具备等价性验证手段(如流量回放 diff)
2.2.3.5 L2 强介入 —— 满足任一条件即进入 L2
- 风险等级 = 高(H)
- 命中任意一条升档规则
- 新业务 / 新架构 / 新技术栈首次上线
- 联调方 ≥ 3 个团队
- 需求歧义无法在评审阶段消除,需在测试中探索收敛
- 大促 / 重大活动保障版本
- QA Lead 基于版本整体风险主动升级
2.2.3.6 各档位 QA 工作清单
2.2.3.7 L0 · 免介入:QA 做什么
核心认知:免介入 ≠ 不负责。QA 不介入"这个需求",但必须负责"让这个需求可以安全地免介入"。
| # | 工作项 | 产出 | 频率 |
|---|---|---|---|
| 1 | 维护免测白名单模块(基于历史数据动态更新) | 白名单清单 + 复审记录 | 季度 |
| 2 | 托管并维护黄金冒烟用例集(按模块/接口) | 可执行用例集 | 持续 |
| 3 | 供给研发自助工具链(环境、造数、契约、回放、冒烟) | 工具 + 文档 | 持续 |
| 4 | 配置并维护 CI 质量门禁与卡点策略 | 流水线配置 | 持续 |
| 5 | 飞行抽检(按 10%–20% 抽样,高风险模块提高比例) | 抽检记录 | 每个迭代 |
| 6 | 发布后 24h 指标巡检(错误率、时延、关键业务指标) | 巡检结论 | 每次发布 |
| 7 | 逃逸度量与资格回收:免测需求线上缺陷率超阈值即回收免测资格 | 度量报告 | 月度 |
2.2.3.8 L1 · 轻介入:QA 做什么
| # | 工作项 | 说明 |
|---|---|---|
| 1 | 参加需求评审(可异步),输出风险点清单 | 不做完整测试方案 |
| 2 | 时间盒探索式测试:30–60 分钟 session-based 测试 | 只针对本次变更点及其直接耦合面 |
| 3 | Diff Review:审查代码/接口 diff,重点看边界、异常、幂等、并发、兼容性 | 这是 L1 性价比最高的动作 |
| 4 | 提供 P0 核心用例给研发自测,QA 做验收式抽检而非全量执行 | 抽检比例建议 30%–50% |
| 5 | 灰度/发布后 1–2 小时监控盯盘 | 错误率、时延、关键业务指标 |
| 6 | 给出风险提示 + 发布建议(非"通过/不通过"的强结论) | 发布决策权归还研发与 PM |
L1 明确不做(防止过度服务):✗ 不写完整测试用例文档 ✗ 不做全量回归 ✗ 不跑完整兼容性矩阵 ✗ 不出正式测试报告 ✗ 不做性能/安全专项(除非风险画像指向)
2.2.3.9 L2 · 强介入:QA 做什么
| 阶段 | 工作项 |
|---|---|
| 左移 | 需求评审 + 技术评审双参与;提出可测性需求(日志、埋点、开关、Mock 点、对账字段);输出《测试方案》并评审 |
| 设计 | 分层测试设计(单测 / 接口 / 契约 / UI / E2E);风险矩阵;用例分级 P0–P3;需求点 ↔ 用例双向追溯 |
| 执行 | 功能测试 + 回归 + 兼容性;按需做性能/稳定性/安全专项;端到端链路与数据一致性对账 |
| 上线 | 灰度计划、发布评审、上线 checklist、回滚演练、发布值班 |
| 右移 | 告警有效性验证、灰度指标盯盘、发布后复盘 |
| 沉淀 | 用例入库、自动化补充、故障模式库回流、风险模型权重校准 |
2.2.3.10 动态准入与退出机制
免测资格必须是可进可出的,否则体系会在 3 个月内腐化。
| 机制 | 规则 |
|---|---|
| 季度复审 | 按模块统计免测需求的线上缺陷密度,Top 20% 模块回收免测资格 |
| 逃逸即回收 | 单个免测需求出现 P2+ 线上问题 → 该模块立即降级为 L1,持续 1 个季度 |
| 新人限制 | 入职 < 3 个月的研发,或首次接触该模块的研发,不授予免测资格 |
| 能力准入 | 研发需通过"自助质量工具"使用认证(一次性,1 小时) |
| 晋升通道 | 模块连续 2 个季度零逃逸 + 自动化覆盖达标 → 可申请从 L1 升为 L0 |
2.2.3.11 落地:需求单必填字段
在 Jira / TAPD / 飞书多维表格中增加以下字段,用工具固化流程而非靠人自觉:
| 字段 | 填写人 | 类型 |
|---|---|---|
| 风险等级(H/M/L) | 研发自评 → QA 复核 | 单选 |
| ICDRK 五维分 | 研发 | 5 个数字 |
| 命中升档项 | 研发 | 多选 |
| QA 介入档位(L0/L1/L2) | QA | 单选,自动由规则推荐 |
| 自测证据(门禁通过截图/链接) | 研发 | 附件/链接 |
| 回滚方案 | 研发 | 文本 |
| 是否重新定级 | 触发时填写 | 单选 |
2.2.4 交付提效:三条主线
2.2.4.1 主线一:降低测试等待时长
等待时长通常占需求交付周期的 30%–50%,且完全不产生价值。根因与对策:
| 根因 | 对策 | 关键指标 |
|---|---|---|
| 提测质量差被打回 | 提测门禁前置:研发自测 checklist + feature 分支自动跑冒烟,不过不许提测 | 提测打回率(目标 < 10%) |
| QA 排期串行 | 需求分级后并行:L0 走自助不排队;L2 在需求阶段即介入,测试设计与开发并行 | QA 等待占比 |
| 环境排队 | 泳道环境:流量染色 + 全链路隔离,按分支/需求按需拉起;环境健康自愈 | 环境就绪时长 |
| 数据构造慢 | 数据工厂:种子数据快照、脱敏影子库、模板化造数、AI 辅助生成 | 造数耗时 |
| 攒批提测 | 按 story 小批量高频提测,消灭批量等待 | 提测批量大小 |
| 构建/部署慢 | 构建缓存、增量编译、测试挑选、并行分片、失败快速反馈 | 流水线时长 |
最有效的单点:把冒烟自动化从"提测后 QA 跑"前移到"feature 分支 CI 自动跑"。这一项通常能把"提测 → 首次有效测试"的时间从 1–2 天压到 10 分钟内。
2.2.4.2 主线二:降低测试执行时长
| 手段 | 说明 | 预期收益(参考值,需按基线校准) |
|---|---|---|
| 精准测试(Test Impact Analysis) | 基于代码 diff + 调用链依赖图谱 + 历史失败率做用例精选 | 回归用例量减少 60%–90% |
| 测试分层(金字塔 → 奖杯) | 回归重心压到单测/接口/契约层,UI E2E 只保留黄金链路 | 回归时长下降 50%+ |
| 契约测试(CDC / Pact) | 用契约替代大量跨服务联调与集成测试 | 联调等待下降 |
| 流量录制回放 | 线上流量回放做回归,近乎零用例编写成本 | 新用例编写量下降 40%+ |
| 服务虚拟化 / Mock | 解除外部依赖阻塞 | 阻塞等待下降 |
| 并行与云测 | 用例并发、设备云/浏览器云矩阵并行 | 墙钟时长线性下降 |
| Flaky 治理 | 自动重试 + 根因归类 + 隔离区(quarantine),目标 flaky 率 < 1% | 无效排查时间下降 60% |
| AI 失败归因 | AI 自动把失败分类为:产品缺陷 / 脚本问题 / 环境抖动 / 数据问题,并生成缺陷单 | 单缺陷处理时长下降 40%+ |
2.2.4.3 主线三:降低线上 bug 与事故风险
| 层次 | 手段 |
|---|---|
| 门禁 | PR 门禁(静态/安全扫描、单测覆盖率、契约兼容)→ 提测门禁(冒烟+自测证据)→ 发布门禁(风险画像达标) |
| 发布 | 渐进式发布(金丝雀 1% → 5% → 20% → 全量)+ Feature Flag + 指标超阈值自动熔断回滚 |
| 右移 | 生产只读冒烟拨测、业务对账、日志异常聚类、告警有效性治理 |
| 沉淀 | 故障模式库(FMEA):历史故障 → 检测手段 → 回归沉淀,防止重复踩坑 |
| 治理 | 每版本输出《版本风险报告》:Top-N 风险 + 兜底方案 + 值班安排 |
| 专项 | 针对 L2:混沌工程、容灾演练、压测 |
2.2.5 测试赋能:研发自助质量工具箱(Dev Self-Serve Quality Kit)
核心命题:如何让研发愿意且能够自己做单测、冒烟、回归、自动化?
答案不在"培训与号召",在于把 QA 的能力产品化,并遵守"三不原则"。
2.2.5.1 三不原则(Adoption 成败的分水岭)
| 原则 | 含义 |
|---|---|
| 不改变习惯 | 入口必须在研发已有的工作流里:Git / CI / IDE / 命令行,不新增一个需要单独登录的系统 |
| 不增加负担 | 反馈必须快(冒烟 ≤ 5 分钟),失败信息必须是"人话 + 修复建议"而非堆栈 |
| 不要求学 DSL | 优先声明式(YAML/表格)与自然语言;能用代码注解/Swagger 自动生成的就不要人写 |
2.2.5.2 工具箱十大能力
| # | 能力 | 形态 | 解决的痛点 |
|---|---|---|---|
| 1 | 一键冒烟 | CLI:make smoke / IDE 插件按钮,自动拉依赖+灌数据+跑核心链路+出报告 |
研发不知道"我改坏了没" |
| 2 | 黄金用例集托管 | 平台托管 P0 接口用例(YAML 声明式,无需写代码),一键复制新增 | 研发不知该测哪些 |
| 3 | 接口/契约测试平台 | 类 Postman/HttpRunner:环境变量、DB 断言、Mock;支持 Swagger 自动生成骨架 | 写用例成本高 |
| 4 | AI 单测生成 | 针对 diff 一键生成单测骨架(覆盖率导向),CI 卡增量覆盖率 | 单测没人愿意写 |
| 5 | 流量回放 diff | 提测前跑一次线上流量回放,自动比对新旧版本响应差异 | 免测最强凭据 |
| 6 | 契约兼容性检测 | 接口字段增删/类型/枚举变更自动检测,破坏性变更直接卡住 | 悄悄改坏下游 |
| 7 | 造数与环境自助 | 数据工厂、环境一键申请、Mock 平台 | 测不了是因为没数据没环境 |
| 8 | 质量分与画像 | 按服务/个人出质量分(覆盖率、逃逸率、门禁通过率、flaky 贡献),可视化到团队看板 | 无正向激励 |
| 9 | 自测报告一键生成 | 自动聚合用例、覆盖率、回放 diff、扫描结果 → 生成《自测报告》 | 免测无凭据 |
| 10 | 门禁硬卡 + 申诉通道 | 门禁不过不许合入/发布;但因工具误判可一键申诉 | 工具不可信则被绕过 |
2.2.5.3 三个必须提前想清楚的失败模式
- 工具没人用:原因几乎总是"改变了习惯"或"反馈太慢"。解法:先做一个入口(CLI),先做一件事(冒烟),先服务一个愿意尝鲜的团队,跑通再推广。
- 门禁被绕过:研发会给自己的 PR 加
skip-ci。解法:门禁结果进质量分,绕过行为可见;同时保证误判率足够低(< 5%)。 - 覆盖率虚高:研发写出"执行了但不断言"的测试。解法:用变异测试检验用例有效性,覆盖率只是一级指标,变异得分才是二级指标。
2.2.6 QA 工作流的 AI Native 重构
2.2.6.1 为什么说这是"电力革命"而不是"更快的马"
历史上真正的类比是这样的:
- 蒸汽时代工厂:一根贯穿厂房的主传动轴驱动所有机器。因此机器必须围着轴排布,牵一发动全身,无法按工序优化布局。
- 电力时代工厂:单元驱动(unit drive)——每台机器配独立电机。轴消失了,机器可以按工艺流程自由重排,流水线才得以诞生。生产力的大跃升不是来自"电机比蒸汽机快",而是来自工厂布局的根本重构。
映射到 QA:
| 传统 QA 流水线 | AI Native QA 流水线 | |
|---|---|---|
| 驱动方式 | 一根"人力主传动轴":所有环节靠 QA 人力串行驱动 | 单元驱动:每个环节可由 AI Agent 独立驱动、并行执行,边际成本趋近于 0 |
| 被迫的形态 | 批量化(攒批提测)、集中化(QA 是瓶颈节点)、靠文档保证一致性 | 单 PR 粒度持续验证、去中心化、靠规则与模型保证一致性 |
| 流程结构 | Stage-Gate:需求 → 设计 → 执行 → 报告,阶段门串行 | 持续质量信号流 + 人类决策点:信号持续产生,人只在决策点介入 |
关键推论:当用例的生成成本趋近于 0 时,"维护用例库"的价值崩塌,而"定义测什么、为什么测"的价值暴涨。QA 的核心资产从"用例库"迁移到"风险模型 + 判定规则 + 领域知识库 + 质量基建"。
2.2.6.2 五层架构
┌─────────────────────────────────────────────────────────┐
│  L5 反馈进化层  Learning                                  │
│  线上缺陷/事故 → 反哺风险模型权重、故障模式库、知识库      │
└─────────────────────────────────────────────────────────┘
                          ↑ 闭环
┌─────────────────────────────────────────────────────────┐
│  L4 决策层  Decision        【人类主责:判断 + 担责】      │
│  质量风险度模型 → 可发布 / 需人审 / 不可发布(附证据链)   │
└─────────────────────────────────────────────────────────┘
┌─────────────────────────────────────────────────────────┐
│  L3 执行自愈层  Execution                                 │
│  Agent 执行 → 定位自愈 → 失败自动 triage → 生成缺陷单      │
└─────────────────────────────────────────────────────────┘
┌─────────────────────────────────────────────────────────┐
│  L2 设计层  Design          【人机协作:AI 生成 + 人审】    │
│  测试方案 + 分层用例 + 测试数据 + 覆盖度双向追溯自检       │
└─────────────────────────────────────────────────────────┘
┌─────────────────────────────────────────────────────────┐
│  L1 意图层  Intent          【AI 预填 + 人复核】           │
│  PRD + 技术方案 + diff + 历史缺陷 → 风险画像 + 测试点建议  │
│  + 需求歧义/未定义行为自动识别                            │
└─────────────────────────────────────────────────────────┘
每层的人机分工
| 层 | AI 做(80%) | 人做(20%,但是决定性的) |
|---|---|---|
| L1 意图 | 读 PRD/diff/历史缺陷,自动打分、列风险点、识别需求缺口 | 复核定级;补充 AI 不可见的组织上下文(上季度那个投诉、那个合作方的临时约定) |
| L2 设计 | 生成方案与分层用例、造数、双向追溯矩阵自检 | 判断"AI 漏了什么":业务隐性规则、历史坑、跨系统的耦合 |
| L3 执行 | 执行、自愈定位、失败分类、生成缺陷单 | 只处理真缺陷与高价值探索 |
| L4 决策 | 汇总证据生成质量风险度与建议 | 最终发布决策 + 担责 |
| L5 进化 | 自动归因、自动更新故障模式库 | 校准模型权重与规则阈值,防止模型漂移 |
2.2.6.3 最大的陷阱:AI 生成测试的"回声室效应"
必须写进规范的一条铁律:
如果 AI 从"实现代码"生成测试,测试只会验证"代码做了什么",而不是"代码应该做什么"。 结果是:覆盖率上升,缺陷检出率不变甚至下降——这是最危险的伪进步。
对策(三条,缺一不可):
- 测试必须从"需求/规约"生成,而非从"实现"生成;或从两者分别生成后做交叉校验(差分测试)。
- 用变异测试检验用例有效性:向代码注入人工缺陷,看用例能否杀死变异体。AI 生成的用例必须通过变异得分门槛(建议 ≥ 60%)才允许入库。
- 保留"人的探索"作为独立信号:探索式测试发现的问题比例,是衡量 AI 质量的第一指标。若该比例骤降,说明不是没问题,而是没人发现问题。
2.2.6.4 三阶段落地路线
| 阶段 | 形态 | 做什么 | 预期提效 | 准入条件 |
|---|---|---|---|---|
| 一:Copilot | 点提效 | AI 写用例、写脚本、造数据、定位失败 | 30%–50% | 用例/缺陷数字化,可检索 |
| 二:Agent | 流程自动化 | AI 串起"读需求 → 设计 → 执行 → 报告",人只审关键节点 | 60%–80% | 环境/数据/断言可自动化;有基线度量 |
| 三:Native | 流水线重构 | 质量信号持续化;测试不再是一个"阶段",发布基于实时质量风险度 | 结构性变化 | 可观测完备、灰度自动熔断、知识库成型 |
四个前置条件(80% 的团队卡在第一步)
- 资产数字化:需求、用例、缺陷、代码、日志必须结构化且可检索。AI 无米下锅是最常见的失败原因。
- 上下文工程:业务规则、领域词典、历史故障、系统依赖图——这些是 AI 的"燃料",且必须由人维护。
- 可验证性基建:环境、数据、断言、可观测。AI 生成的一切必须能被自动验证,否则就是幻觉放大器。
- 度量基线:先有数据,才知道提效多少、风险是否上升。没有基线的提效都是自我感动。
2.2.6.5 度量体系(建议基线与目标)
| 类别 | 指标 | 说明 |
|---|---|---|
| 速度 | 需求交付周期中 QA 等待占比 | 目标 < 20% |
| 提测 → 首次有效测试时长(TTFT) | 目标 < 30 分钟 | |
| 回归执行时长 | 目标:L1 < 30 分钟,L2 < 4 小时 | |
| 质量 | 线上缺陷逃逸率 | 逃逸缺陷 / 总缺陷,目标 < 8% |
| 免测需求线上缺陷密度 | 用于免测资格动态回收 | |
| 缺陷定位时长(MTTI) | AI triage 后目标下降 40% | |
| 效率 | 精准测试裁剪率 | 目标 60%–90% |
| 自动化增量代码覆盖率 | 目标 ≥ 70% | |
| Flaky 率 | 目标 < 1% | |
| AI 生成用例的变异得分 | 目标 ≥ 60%(防止覆盖率虚高) | |
| AI 可信度 | 探索式测试发现缺陷占比 | 骤降 = 预警信号 |
| AI 定级与人工复核偏差率 | 目标 < 30% |
2.2.7 QA 的价值重估
2.2.7.1 哪些是 AI 确实做不到的(我认同的部分)
① 隐性知识与波兰尼悖论 波兰尼悖论说:"我们知道的,比我们能说出来的多。"测试里大量知识是隐性的:老 QA"闻着味就知道这儿要出事"。这种直觉是压缩过的经验模式,它不在 PRD 里、不在代码里、也不在任何知识库里。AI 的上下文是被喂进去的,人的上下文是活出来的——上季度那个客诉、那个接口是合作方临时加的、那个开关其实从没被验证过。这些组织记忆无法被检索。
② 已知未知 vs 未知未知 AI 擅长穷举已知空间(组合、边界、变异、历史模式的复用);人擅长提出新假设——"如果这个三方服务超时呢?""如果用户同时在两个端操作呢?"测试的本质是探索不确定性,而探索 = 拓展假设空间,不只是执行现有假设。变异/探索式测试的核心价值是提出假设,不是跑用例。
③ 责任与判断不可外包 "这个版本我建议不上"、"这个风险我们接受"——这是组织角色,不是技术问题。AI 不能担责,不能向上汇报,不能在会议室里顶住业务压力。
④ AI 产出越多,验证需求越大 生成与验证是不对称的:生成极易,验证极难。当 AI 开始大量产出代码、用例、方案,"谁来验证 AI 的产出"这个问题本身就在扩容。测试思维 = 验证能力,这恰恰是 AI 时代最稀缺的能力之一。
2.2.7.2 我要补充和修正的部分(不同意"经验即护城河")
① 资历不是护城河,抽象能力才是。 如果只是"我踩过的坑多"——这部分恰恰最容易被 AI 吸收,因为坑一旦被记录就变成了可检索知识。真正难替代的是在新情境下快速建立有效模型的能力(知识迁移、针对性搭建质量体系)。这和资历相关,但不等同于资历。35 岁+ 里也有大量只是"熟练工"的人——用年龄自我安慰是最危险的心态。
② AI 正在向上侵蚀"设计层",不只是执行层。 当 AI 能读 PRD、读代码、读监控并生成测试策略时,被侵蚀的就不仅是执行。所以人的位置必须持续上移到: - 定义质量目标与风险偏好(我们愿意为速度接受多少风险?) - 构建让 AI 可靠工作的系统(基建、规则、知识库、上下文工程) - 对结果进行判断与担责
③ 必须诚实面对商业现实:最后 10–20 分可能不值那个成本。 如果 AI 能把执行做到 80–90 分,那么"做到 95 分"的增量价值,在很多业务场景下确实不值那个成本。这是真实的商业压力,不能用"质量无价"搪塞。 而能够主动做出这个取舍判断、并且能论证"为什么这个场景需要 95 分、那个场景 80 分就够"——这本身就是资深的价值。
2.2.7.3 新的价值定位与能力配方
定位迁移:测试执行者(Tester) → 质量工程师(QE) → 质量架构师 / 风险官(Quality Architect)
能力配方(四项缺一不可)
| 能力 | 说明 |
|---|---|
| 业务领域专家(Context Owner) | 掌握 AI 拿不到的隐性上下文与业务全貌 |
| 风险建模者 | 能把模糊的"我觉得有风险"变成可度量、可申诉、可校准的模型 |
| AI 工作流设计师 | 会编排 Agent、会做上下文工程、会评估 AI 输出的可信度(这是新增的硬技能) |
| 质量基建工程师 | 懂 CI/CD、可观测、灰度熔断、混沌工程——因为质量保障的载体正在从"用例"迁移到"系统" |
KPI 必须重定价(否则 QA 会被自己的指标杀死)
| 旧 KPI | 问题 | 新 KPI |
|---|---|---|
| 发现缺陷数 | AI 会把这个数打爆,反而证明 QA 只是执行者 | 风险前置拦截率(在评审/设计阶段消除的风险占比) |
| 用例数量/执行数 | 鼓励堆量 | 逃逸率 + 精准测试裁剪率 |
| 测试覆盖率 | 可造假(无断言测试) | 变异得分 + 业务场景覆盖率 |
| 加班时长/投入度 | 无意义 | 需求交付周期 + 单位质量成本 |
一句话重定价:QA 的产出不再是"发现了 N 个 bug",而是"这个业务在快速迭代下,同时保持了 X 的逃逸率和 Y 的交付速度"。质量是交付能力的一部分,不是它的对立面。
2.2.7.4 关于"我作为 AI 说这些话"的自我审视
我必须指出一个显而易见的立场问题:一个 AI 论证"AI 无法替代人",天然存在利益冲突。所以我给一个可证伪的判断标准,请用它来检验我上面说的每一条,而不是相信我的结论:
打开你过去一个月的工作记录,统计时间分布: - 若 > 60% 的时间在做「按既定方案执行 + 记录结果 + 写标准化文档」→ 这部分会被替代,且会很快。现在就该把重心移走。 - 若 > 40% 的时间在做「判断测什么 / 为什么测 / 这个风险值不值得投入 / 说服他人接受或拒绝风险」→ 你的位置是安全的,而且 AI 会显著放大你的产出。 - 若 > 30% 的时间在做「搭建工具、定义规则、设计流程、训练/校准 AI」→ 你是这个变革里的赢家,这类人的市场价值在上升。
2.2.8 90 天落地路线图
| 阶段 | 周期 | 关键动作 | 里程碑产出 |
|---|---|---|---|
| 第 0 阶段:基线 | 第 1–2 周 | 采集当前交付周期、等待占比、逃逸率、回归时长;盘点可观测与回滚能力 | 《质量基线报告》 |
| 第 1 阶段:分级与规范 | 第 3–5 周 | 落地 ICDRK 评分表;需求单加字段;选 1 个团队试点三档介入 | 《风险分级与介入规范 v1》+ 试点数据 |
| 第 2 阶段:研发自助 | 第 6–10 周 | 交付一键冒烟 + 黄金用例集 + 提测门禁;跑通 1 条完整免测链路 | 自助工具箱 MVP + 首个 L0 需求闭环 |
| 第 3 阶段:精准与提速 | 第 11–13 周 | 精准测试选型接入;Flaky 治理;流水线并行化 | 回归时长下降 ≥ 40% |
| 第 4 阶段:AI Native | 并行推进 | 资产数字化 + 知识库;先上 AI 用例生成与失败 triage(Copilot 阶段) | AI 用例生成试点 + 变异得分门禁 |
| 收口 | 第 13–14 周 | 全量复盘,校准阈值,正式发布规范 v1.0 | 度量对比报告 + 规范定稿 |
2.2.9 附录:模板清单
| # | 模板 | 用途 |
|---|---|---|
| A1 | ICDRK 风险评分表 | 需求评审前由研发填写 |
| A2 | 需求风险升档/降档检查表 | 硬性规则勾选 |
| A3 | QA 介入档位准入矩阵 | 定级 → 档位映射 |
| A4 | L0 免测自测报告模板 | 研发自证凭据 |
| A5 | L1 风险点清单模板 | 轻介入交付物 |
| A6 | L2 测试方案模板 | 强介入交付物 |
| A7 | 版本风险报告模板 | 每版本发布前输出 |
| A8 | 故障模式库(FMEA)登记表 | 事故复盘沉淀 |
| A9 | 免测资格季度复审表 | 动态准入治理 |
| A10 | 质量度量看板指标定义 | 度量口径统一 |
2.3 第三部分 · AI 三重角色使用手册:思维教练 · 思维伙伴 · 工作搭子
定位:AI 不是替代者,是乘数。但乘数只对非零项有效。 版本:v1.0 | 2026-09-03
2.3.1 三种角色的本质区别
| 角色 | 核心动作 | AI 该做什么 | 你必须先有什么 | 产出 | 失败信号 |
|---|---|---|---|---|---|
| 思维教练 Coach | 挑战你 | 提问、质疑、追问、逼你论证 | 你自己的初步判断 | 更硬的判断 | AI 直接给了答案 |
| 思维伙伴 Partner | 扩展你 | 补视角、给框架、做类比、列对立观点 | 一个明确的问题 | 更多可选路径 | AI 只附和你已有的想法 |
| 工作搭子 Buddy | 替你干 | 出初稿、跑流程、批量产出 | 明确的验收标准 | 可审的草稿 | 你没审就直接用了 |
一句话区分: - 教练让你想得更深(对同一个答案) - 伙伴让你看得更宽(对同一个问题) - 搭子让你做得更快(对同一件活)
2.3.1.1 最重要的一条纪律:顺序不能反
❌ 错误顺序:空着脑子问 AI「这个需求怎么测?」
   → 你被第一个答案锚定 → 独立思考被污染 → 教练价值归零

✅ 正确顺序:先自己输出判断 → 让 AI 挑战 → 你补充修正 → 定稿
   → AI 扮演的是"质疑者"而非"答案机"
推论:一个没有自己判断的人,配一个思维教练毫无用处。这是这三重角色最反直觉、也最关键的性质——它们放大的是已有的思维能力,而不是填补思维能力的空白。
2.3.2 思维教练:让 AI 挑战你
前提认知:AI 默认是讨好型的。 不显式解除,它会先肯定你、再补充,教练秒变啦啦队。所有教练类模板的第一句都必须是"不要认同我"。
2.3.2.1 可复制模板
| 编号 | 场景 | Prompt 模板 |
|---|---|---|
| C1 | 假设挑战 | "以下是我对【X】的判断和理由:【……】。请不要认同我。请找出其中 3 个最可能错误的假设,并分别说明:如果这个假设不成立,会发生什么。" |
| C2 | 追问到底 | "针对我上面的结论,连续追问 5 个'为什么',直到我无法回答,然后明确指出我的知识边界在哪里。" |
| C3 | 反方预演 | "我要为【决策/方案】做汇报。请扮演最挑剔的【技术负责人 / CFO / reviewer】,列出你会问的 8 个最难回答的问题,并给出你认为我答不上来的那几个。" |
| C4 | 盲区扫描 | "这是我打算采用的方案:【……】。请指出我没有考虑到的维度,按『发生概率 × 影响程度』排序,只保留前 5 个。" |
| C5 | 最有力的一问 | "如果我这个判断是错的,最先会从哪里暴露出来?请给出 3 个可观测的早期信号。" |
| C6 | 推理链审计 | "这是我的决策过程与最终结果:【……】。请指出我的推理链在哪一步出现了跳跃,哪些地方用相关性代替了因果。" |
| C7 | 复盘挑战 | "我的根因判断是 X。请先给出 3 个能替代 X 的竞争性假设,再说明需要什么证据才能排除它们。" |
2.3.2.2 教练模式四条硬规则
- 顺序纪律:必须先有自己的判断,AI 才能挑战。空手去问 = 主动放弃思考。
- 显式禁止认同:模板里必须写"不要先肯定我 / 不要认同我"。
- 必问 C5:"如果我错了,最先从哪里暴露"——这一问把抽象质疑变成可验证的观测点,是教练模式里性价比最高的动作。
- 挑战由你裁决:AI 不知道你的组织上下文(历史包袱、人事关系、政治约束),它的质疑可能"技术上对、情境上错"。采纳哪条挑战,是人的工作。
2.3.3 思维伙伴:让 AI 扩展你
教练是垂直的(同一个答案往下挖),伙伴是水平的(同一个问题往宽看)。
2.3.3.1 可复制模板
| 编号 | 场景 | Prompt 模板 |
|---|---|---|
| P1 | 框架供给 | "针对【问题】,请给出 3 个来自不同学科的分析框架,分别用它们分析一遍,然后指出三种框架得出的结论在哪里分歧,分歧的原因是什么。" |
| P2 | 类比迁移 | "【A 领域】解决【X 问题】的做法是【……】。请找出 3 个在【B 领域】结构上相似的问题,以及它们解法中可迁移的部分和不可迁移的部分。" |
| P3 | 对立观点 | "请分别为【立场】和【反立场】写出最强论证,然后明确说明:在什么条件下哪一方成立。不要给折中答案。" |
| P4 | 维度补全 | "我用【维度 A/B/C】分析这个问题。请指出我漏掉的维度,并说明每个漏掉的维度在哪些具体场景下会变成决定性因素。" |
| P5 | 历史对照 | "【行业/技术】历史上出现过与【X】结构相似的转折吗?当时发生了什么?哪些规律可能重演,哪些条件已经改变导致不会重演?" |
| P6 | 反常识搜索 | "关于【X】,主流观点是【……】。请找出 3 个有证据支持但反主流的观点,并给出证据强度评级。" |
2.3.3.2 伙伴模式三条纪律
- 要求分歧,不要共识:如果 AI 给的三种框架结论完全一致,说明它在敷衍,追问"分歧在哪"。
- 要求标注不可迁移部分(P2)——类比的最大风险是强行迁移。
- 框架是候选不是答案:AI 给的框架要你自己选,选择本身就是专业判断。
2.3.4 工作搭子:让 AI 替你干
核心原则:给标准,不给自由。 搭子模式下 AI 出错,90% 是因为你没给验收标准。
2.3.4.1 可复制模板
| 编号 | 场景 | Prompt 模板 |
|---|---|---|
| W1 | 带验收的产出 | "请生成【产物】。验收标准:1)…… 2)…… 3)……。完成后请逐条自检并标注达标情况,未达标的说明原因,不要掩饰。" |
| W2 | 草稿 + 自我批判 | "请出初稿,然后以资深【角色】的标准,列出这份初稿的 5 个最严重缺陷。" |
| W3 | 反向审查 | "这份材料是我写的:【……】。请找出事实错误、逻辑错误、表述含糊处,逐条标注位置并给出修改建议。不要重写,只做批注。" |
| W4 | 批量 + 置信度 | "请处理以下 N 项,并对置信度最低的 3 项单独标注原因。我需要重点审这几项。" |
| W5 | 信息缺口申报 | "如果信息不足以完成任务,请直接列出你需要我补充的信息,不要自行假设后继续。" |
2.3.4.2 搭子模式四条纪律
- AI 出初稿,人定稿;AI 出选项,人做决定。 责任不可转移。
- 强制要求自报置信度(W4):低置信度项才是你需要花时间的,其余可快速过。
- 要求它列出信息缺口(W5):比让它瞎猜后你再返工便宜得多。
- 重复任务固化成模板:不要让每次都从零开始对话,把有效的 prompt 存成片段。
2.3.5 三种角色 × QA 场景 映射表
| QA 工作场景 | 首选角色 | 次选角色 | 触发示例 |
|---|---|---|---|
| 需求风险评估 | 教练 | 伙伴 | "我给这个需求打了中风险,理由是一二三。请找出我可能低估的维度,并说明如果我错了最先从哪里暴露。" |
| 测试方案设计 | 伙伴 → 搭子 | — | 先让 AI 给 3 种测试建模视角(等价类/状态迁移/风险驱动),选定后再让它出初稿 |
| 测试用例生成 | 搭子 | — | "生成用例,验收标准:覆盖边界/异常/幂等/并发/兼容性五类,逐条自检" |
| 线上故障复盘 | 教练 | 伙伴 | "我的根因判断是 X。请给出 3 个竞争性假设,以及排除每个假设需要的证据。" |
| 质量体系规划 | 伙伴 | 教练 | 跨学科框架供给:FMEA、可靠性工程、精益、约束理论 |
| 代码/接口 diff review | 搭子 | 教练 | 搭子出清单 → 教练模式追问"你凭什么认为这个点风险低" |
| 发布决策 | 教练 | — | "我建议发布。请扮演最保守的 reviewer 提出反对理由,并给出你认为的阻断条件。" |
| 面试 / 晋升答辩准备 | 教练 | 搭子 | "你会问的 8 个最难问题"+"连续追问 5 个为什么" |
| 向上汇报材料 | 教练 → 搭子 | — | 先让 AI 以领导视角挑刺,再改稿 |
2.3.6 四个必须警惕的陷阱
| # | 陷阱 | 表现 | 对策 |
|---|---|---|---|
| 1 | 讨好型默认 | AI 先肯定你的判断,再补充无关内容 | 模板首句写死"不要认同我" |
| 2 | 锚定污染 | 先看了 AI 的答案,就再也无法独立思考 | 顺序纪律:先自己判断,再让 AI 挑战 |
| 3 | 上下文缺失的错位挑战 | AI 的质疑技术上正确、情境上无关 | 由你裁决采纳哪些;必要时先补充组织上下文再让它挑战 |
| 4 | 流畅性错觉 | AI 写得越流畅,你越容易放弃批判 | 强制要求标注不确定性、信息缺口与置信度 |
第 4 条最隐蔽:输出质量与正确性无关。一份排版精美、逻辑自洽的方案,可能建立在一个完全错误的假设上。
2.3.7 结论:一个乘数,不是一份保险
这三重角色成立的前提是——你得先有可被挑战的判断、可被扩展的框架、可被验收的标准。这三样东西都是人的产出,AI 一样都给不了。
所以它带来的不是一个平等的提升,而是一个乘数效应:
最终产出 = 你的思维基础 × AI 放大系数

思维基础 → 0 时,乘数再大也是 0;
思维基础 → 10 时,乘数 3 就是 30。
这恰恰是对"AI 时代 QA 还有没有价值"这个问题最有力的回答:AI 作为思维教练,只对有判断力的人有价值。一个从业十年、脑子里装着几百个故障模式和业务隐性规则的资深 QA,配上一个敢于质疑他的 AI,产出的是 1+1>2 的复利;一个只会照着 checklist 执行的人,配上同一个 AI,得到的只是一个更快的执行者——而那部分恰恰是最先被替代的。
所以真正的问题不是"AI 能不能做我的工作",而是"我有没有值得被 AI 挑战的判断"。
2.3.8 附:日常最小可用清单
每天值得做的三件事
- 做重要判断前,先自己写下判断和理由,再用 C1 + C5 让 AI 挑战一轮(5 分钟)
- 做方案设计时,用 P1 让 AI 给三种不同学科框架,只在结论分歧处花时间思考
- 做任何产出时,用 W1 给验收标准 + W4 要置信度标注,只重点审低置信度部分
每天要避免的三件事
- ❌ 空着脑子问 AI 要答案
- ❌ 让 AI 夸你的方案(除非你明确要求的是对抗式挑战)
- ❌ 不审就用 AI 的产出
2.4 第四部分 · 附录
2.4.1 图一:需求风险分级与 QA 三档介入决策流
对话中以图形呈现的决策流,此处转写为文字版,便于纯文本检索与复用:
                      ┌──────────────────────────┐
                      │  需求进入(PRD 创建)      │
                      └────────────┬─────────────┘
                                   ▼
              ┌────────────────────────────────────────┐
              │ ① 研发自评(强制字段,5 分钟)           │
              │   ICDRK 五维打分:                      │
              │   I 影响面 35% | C 变更熵 20%          │
              │   D 可检测性 15%| R 可恢复性 15%       │
              │   K 上下文成熟度 15%                    │
              └────────────────────┬───────────────────┘
                                   ▼
              ┌────────────────────────────────────────┐
              │ ② AI 预填(可选,推荐)                  │
              │   读 PRD + 代码 diff + 历史缺陷 → 建议分  │
              └────────────────────┬───────────────────┘
                                   ▼
        ┌──────────────────────────────────────────────────┐
        │ ③ 硬规则覆盖 Override(先于评分生效)              │
        │   一票升档 8 条 → 直接判「高」                     │
        │   一票降档 5 条全满足 → 才允许判「低」              │
        └───────────────────────┬──────────────────────────┘
                                ▼
        ┌──────────────────────────────────────────────────┐
        │ ④ 评分落档:≥3.4 高 | 2.0–3.39 中 | <2.0 低     │
        └───────────────────────┬──────────────────────────┘
                                ▼
              ┌────────────────────────────────────────┐
              │ ⑤ QA 复核定级(最终定级权 + 一票升级权)  │
              └────────────────────┬───────────────────┘
                                   ▼
   ┌───────────────────┬───────────────────┬───────────────────┐
   ▼                   ▼                   ▼
┌──────────┐      ┌──────────┐      ┌──────────┐
│ 高风险 H │      │ 中风险 M │      │ 低风险 L │
└────┬─────┘      └────┬─────┘      └────┬─────┘
     │                 │                 │
     ▼                 ▼                 ▼
┌──────────┐      ┌──────────┐      ┌──────────────────────┐
│ L2 强介入│      │ L1 轻介入│      │ 命中 10 条排除清单?  │
│ 2–10 人天│      │0.5–1 人天│      │  是 → 降级为 L1       │
│ 完整方案 │      │ 风险点   │      │  否 → L0 免介入       │
│ 全量执行 │      │ 探索测试 │      │  ≈0.3 人时            │
│ 上线评审 │      │ diff审   │      │  供工具/抽检/巡检     │
└──────────┘      └──────────┘      └──────────────────────┘
     │                 │                 │
     └─────────────────┴─────────────────┘
                       ▼
        ┌────────────────────────────────────────┐
        │ 右移闭环:发布后 24h 指标巡检            │
        │ 逃逸度量 → 免测资格季度复审与回收         │
        └────────────────────────────────────────┘
2.4.2 图二:从"人力主传动轴"到"AI 单元驱动"的流水线重构
这是"为什么 AI 对 QA 是电力革命而非更快的马"的核心论证,转写为文字版:
【蒸汽时代工厂】                   【电力时代工厂】
┌────────────────────────┐       ┌────────────────────────┐
│   一根贯穿厂房的主传动轴  │       │  每台机器配独立电机      │
│   驱动所有机器           │  →→  │  (unit drive)         │
│   机器必须围着轴排布      │       │  轴消失了,机器自由重排  │
└────────────────────────┘       └────────────────────────┘
         │                                  │
         ▼                                  ▼
【传统 QA 流水线】                 【AI Native QA 流水线】
┌────────────────────────┐       ┌────────────────────────┐
│ 人力主传动轴:            │       │ 单元驱动:               │
│ 需求→设计→执行→报告       │       │ 每个环节可由 Agent       │
│ 全部靠 QA 人力串行驱动    │       │ 独立驱动、并行执行        │
│                        │       │ 边际成本 → 0             │
│ 被迫形态:               │  →→  │                        │
│  · 批量化(攒批提测)     │       │ 新形态:                 │
│  · 集中化(QA 是瓶颈)    │       │  · 单 PR 粒度持续验证    │
│  · 靠文档保证一致性       │       │  · 去中心化              │
│                        │       │  · 靠规则与模型保证一致性  │
│ Stage-Gate 阶段门串行     │       │ 持续质量信号流 + 人类决策点│
└────────────────────────┘       └────────────────────────┘

关键推论:
  AI 的价值 ≠ 每个环节加速
  AI 的价值 = 让流水线可以被重新排布
  ⇒ 用例生成成本 → 0 时,"维护用例库"的价值崩塌,
     "定义测什么、为什么测"的价值暴涨。
  ⇒ QA 的位置从流水线「上」移到流水线「旁」。
2.4.3 全文索引与后续可延伸事项
文档结构索引
| 部分 | 内容 | 适用场景 |
|---|---|---|
| 第一部分 | 对话全记录(提问原文 + 逐轮答复) | 快速了解全部结论,5 分钟通读 |
| 第二部分 | AI 时代软件质量保障体系设计(完整文档) | 落地实施时的规范依据 |
| 第三部分 | AI 三重角色使用手册(18 个 prompt 模板) | 日常与 AI 协作时直接取用 |
| 第四部分 | 本附录:两张核心图文字版 + 索引 | 检索与二次传播 |
三句话核心结论
- 分级是手段不是目的——分级的真正价值是让 QA 的注意力可以被量化地分配到风险上,而不是让流程变复杂。
- 免测的信任来自基建不来自觉悟——没有流量回放、契约检测、门禁、可观测、秒级回滚,免测就是裸奔。
- AI 重构的是流水线的形状,不是流水线的速度——从"人力主传动轴"到"单元驱动",QA 的位置从流水线上移到流水线旁。
待延伸事项(按需继续)
| # | 事项 | 说明 |
|---|---|---|
| 1 | 模板落地 | 把附录 A1–A10 逐个展开成可直接填写的表单/飞书多维表格 |
| 2 | 评分工具化 | 把 ICDRK 评分表落成飞书多维表格字段 + 自动算分公式 |
| 3 | 技术选型 | 精准测试 / 流量回放选型对比(Go 技术栈与 Java 技术栈方案差异较大) |
| 4 | Prompt 固化 | 把 18 个模板固化为可一键调用的指令(如 /coach 我的判断是…) |
全文结束。
📄 来源:011_36 岁女测试靠这个网站,5天拿下AI测试offer!.md
3 36岁女测试靠这个网站,5天拿下AI测试offer!
3.1 视频信息
| 项目 | 内容 |
|---|---|
| 视频名称 | 36岁女测试靠这个网站,5天拿下AI测试offer! |
| 时长 | 2分3秒 |
| 来源平台 | 抖音 |
| 原始链接 | https://www.douyin.com/video/7660837015446298021 |
| 飞书妙记 | https://www.feishu.cn/minutes/obcnit6t23r51nd3jq1re687 |
| 关键词 | AI测试、学习路径、DeepSeek部署、Cursor编程、Skills实战、Dify、Coze、MCP、LangChain、AutoGen |
3.2 全文摘要
本视频分享了一个36岁、有10年功能测试经验的女测试工程师,通过一个AI测试学习网站,仅用5天就拿下20K薪资AI测试offer的真实案例。核心观点是:AI测试转型不需要跟大佬、啃厚书,而是需要一条完整的、从入门到进阶的学习路径。 视频详细介绍了该网站的八大核心模块:软件测试AI入门指南、DeepSeek本地模型部署、Cursor AI辅助编程实战、Skills实战指南、Dify/Coze智能体开发、MCP协议与生态、LangChain/AutoGen架构进阶、AITS智能化AI测试平台。这个网站从入门到进阶、从工具到架构、从本地部署到云上算力全链路覆盖,且全免费持续更新。
3.3 原文结构化整理
3.3.1 故事背景:36岁功能测试的转型
- 人物:36岁女测试,干了快10年功能测试
- 困境:觉得自己快被拍在沙滩上了
- 结果:5天拿下AI测试offer,薪资20K
- 方法:不是跟测试大佬,也不是啃大部头的书,而是盯住一个网站从头到尾刷了一遍
3.3.2 网站八大核心模块
| 序号 | 模块 | 内容 |
|---|---|---|
| 1 | 软件测试AI入门指南 | 零基础小白从哪开始,捋得明明白白 |
| 2 | DeepSeek与本地模型部署 | 没卡没算力,教你低成本跑大模型 |
| 3 | Cursor与AI辅助编程实战 | 测试写脚本、造数据,AI帮你写 |
| 4 | Skills实战指南 | AI软件测试专用,持续更新 |
| 5 | Dify与Coze智能体开发 | 两大工具怎么搭智能体,手把手教 |
| 6 | MCP协议与生态应用 | 最新的东西,很多地方还没有 |
| 7 | LangChain与AutoGen架构进阶 | 往深了走,架构级别的内容 |
| 8 | AITS智能化AI测试平台 | AI实战项目与系统课,直接带你做项目 |
附加板块:自动化测试、低成本GPU算力获取、OpenCloud人工智能助手。
3.3.3 为什么这个网站有效
- 完整路径:从入门到进阶,从工具到架构,从本地部署到云上算力,全串起来了
- 不是资源合集:不是乱七八糟的资源堆砌,而是一条完整的AI测试学习路径
- 全免费且持续更新:费尽心思全网搜资料,可能还没这里面的东西全、没它新
3.3.4 5天拿offer的具体路径
- 从 Dify与Coze 开始搭智能体
- 把 Skills实战 刷一遍
- 用 AITS平台 上的项目作品去面试
- 5天拿下20K的AI测试offer
关键启示:AI测试转型的核心是找到一条完整的学习路径,而不是零散地搜资料。
3.4 完整逐字稿
以下为飞书妙记转写的完整逐字稿,带时间戳。
Speaker 1 00:00:00.120
来说个真事,有个 36 岁的女测试,干了快 10 年的功能测试,觉得自己快被拍在沙滩上了。结果呢? 5 天,就 5 天,拿了个 AI 测试的offer,20K。你问她怎么做到的?不是跟了什么测试大佬,也不是啃了什么大部头的书,她就盯住了一个网站,从头到尾刷了一遍。今天我就把这个网站分享给你们。这个网站叫啥先不说,你就看它里面有什么东西。
Speaker 1 00:00:28.320
第一个,软件测试 AI 入门指南,零基础的小白从哪开始?给你捋的明明白白。第二个, DeepSeek 跟本地模型部署,你没卡没算力,教你怎么低成本跑大模型。第三个。 Cursor 跟 AI 辅助编程实战,测试写点脚本,造点数据, AI 帮你写。第四个, Skills 实战指南,而且是 AI 软件测试专用的,还在持续更新。第五个, dify 跟 coze 智能体开发,这俩工具怎么搭?智能体。手把手教。第六个, MCP 协议跟生态应用,这是最新的东西,很多地方还没有。
Speaker 1 00:01:08.530
第七个, Lanching 跟 Autogen 架构进阶,你要往深了走,架构级别的。第八个, AITS 智能化 AI 测试平台, AI 实战项目跟系统课,直接带你做项目。还有自动化测试板块,低成本 GPU 算力获取, OpenCloud 人工智能助手。你发现没有?这个网站是从入门到进阶,从工具到架构。从本地部署到云上算力,全给你串起来了。而且它不是一个乱七八糟的资源合集,是一个完整的 AI 测试学习路径。最关键的是什么?全免费,而且持续更新。你费尽心思全网搜资料,可能还没这里面的东西全,没它新。那个 36 岁的测试就是按这个路径,从 dify 跟 coze 开始搭智能体,再把 skills 实战刷了一遍,最后用 ATS 平台上的项目作品去面试, 5 天拿下的。
3.5 关键截图
3.5.1 本地模型低成本跑AI
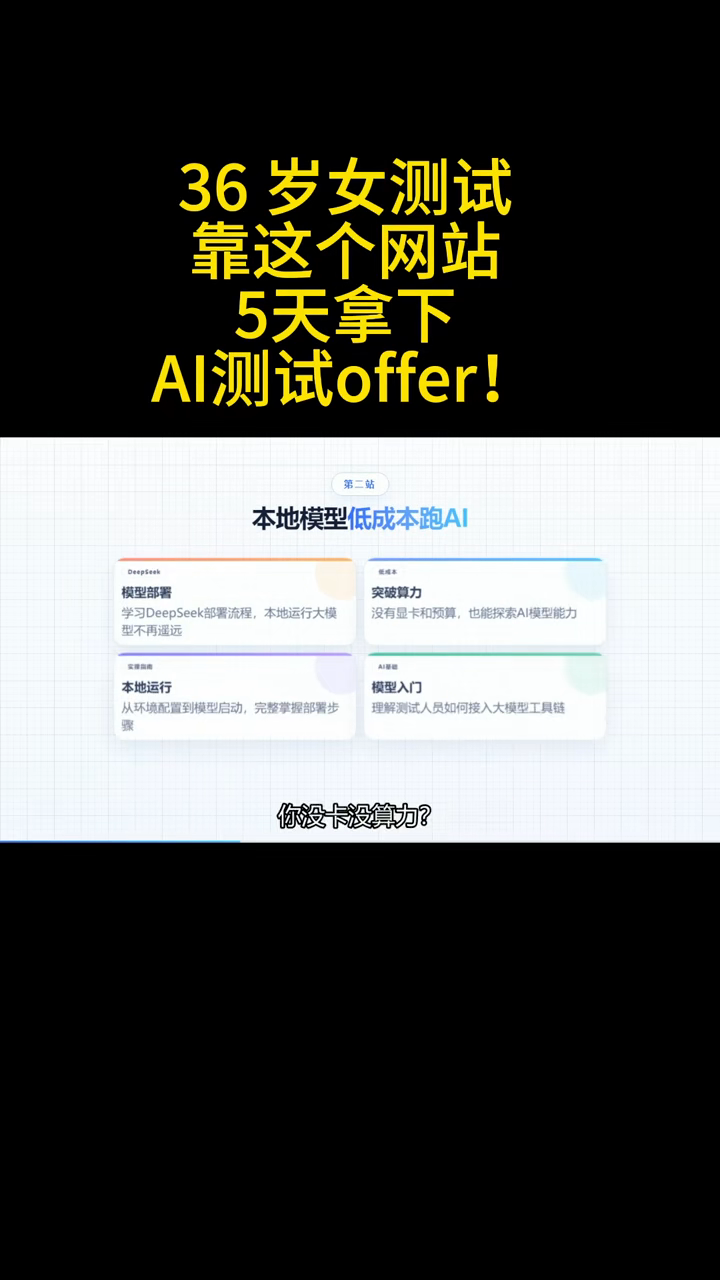
网站第二站:本地模型低成本跑AI,包含DeepSeek模型部署、突破算力、本地运行、模型入门四个模块,解决没卡没算力也能跑大模型的问题。
3.5.2 智能体开发 DifyCoze
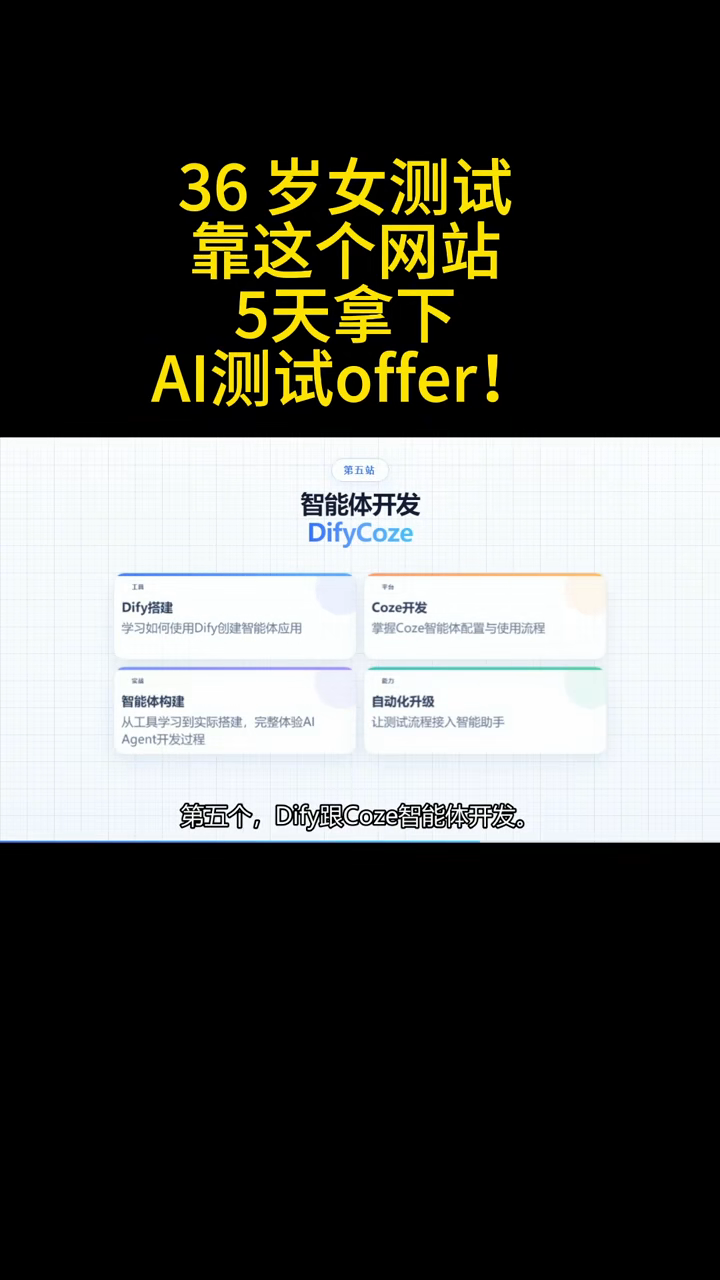
网站第五站:智能体开发DifyCoze,包含Dify搭建、Coze开发、智能体构建、自动化升级四个模块,手把手教测试工程师搭建AI Agent。
📄 来源:019_2026软件测试一定要试试的5个Skill,功能齐全又好用!.md
4 2026软件测试一定要试试的5个Skill,功能齐全又好用!
4.1 视频信息
| 项目 | 内容 |
|---|---|
| 视频名称 | 2026软件测试一定要试试的5个Skill,功能齐全又好用! |
| 时长 | 2分01秒 |
| 来源平台 | 抖音 |
| 原始链接 | https://www.douyin.com/video/7651954985982773361 |
| 飞书妙记 | https://www.feishu.cn/minutes/obcnh4jk2w9f1zup2v74ss83 |
| 关键词 | 软件测试、Skill、Playwright、Selenium、Pytest、CI/CD、代码覆盖率 |
4.2 全文摘要
本视频推荐了5个软件测试领域必备的Skill工具,覆盖从接口测试、UI自动化、Python测试框架、CI/CD集成到代码覆盖率的全链路。每个Skill都提供了开箱即用的工程化模板和最佳实践,帮助测试工程师快速搭建企业级自动化测试体系。核心观点是:好的Skill不仅是工具集合,更是完整的工程化解决方案,包含项目结构、依赖配置、最佳实践和反模式总结。
4.3 原文结构化整理
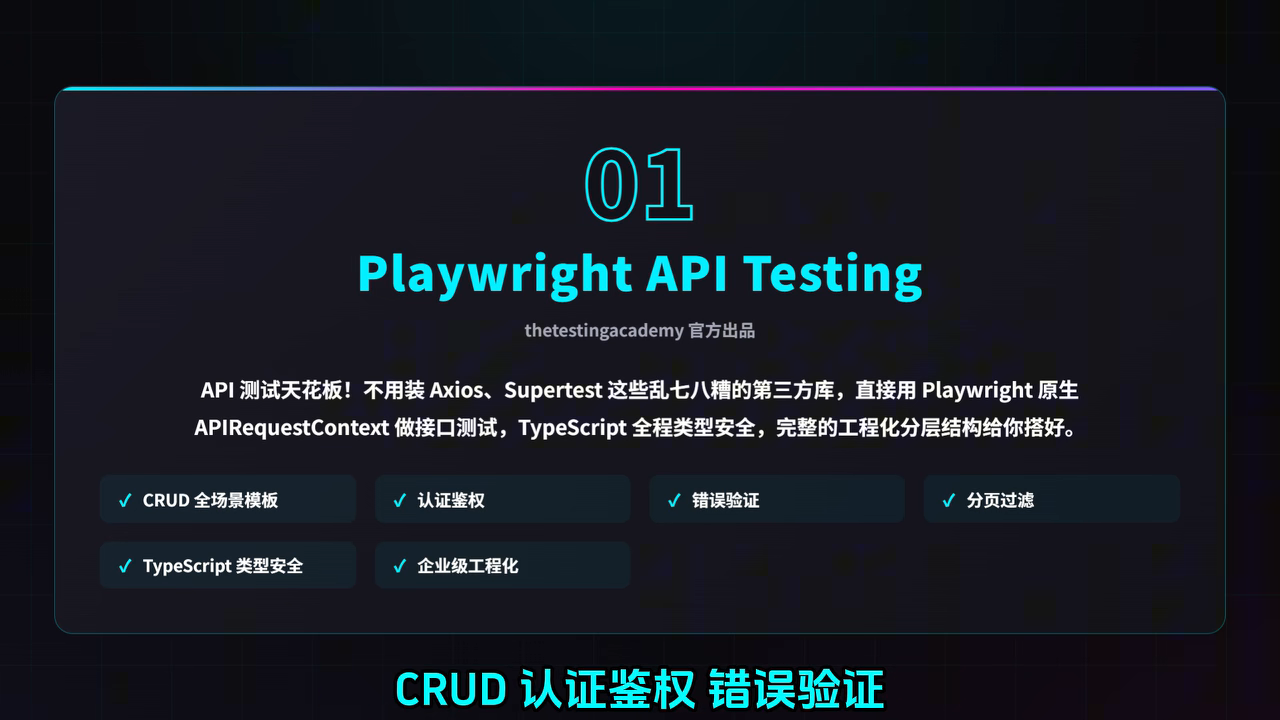
4.3.1 Playwright API Testing
- 出品方:thetestingacademy 官方出品
- 定位:API测试天花板
- 核心优势:
- 不用装 Axios、Supertest 等第三方库,直接用 Playwright 原生 APIRequestContext 做接口测试
- TypeScript 全程类型安全
- 完整的工程化分层结构已搭好
- 内置模板:
- CRUD 全场景模板
- 认证鉴权
- 错误验证
- 分页过滤
- 额外价值:和 E2E 测试共用一套体系,不用维护两套框架,装上即可达到企业级接口自动化水平
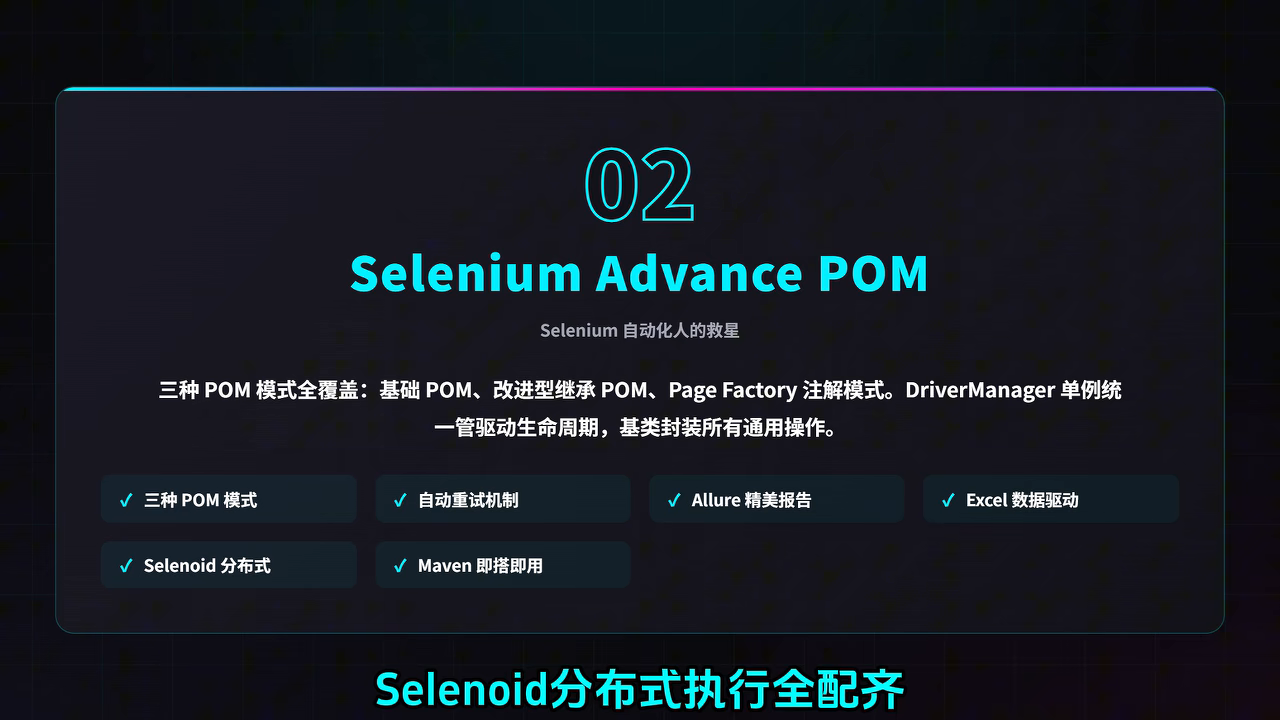
4.3.2 Selenium Advanced POM
- 定位:Selenium 自动化的救星
- 核心特性:
- 三种 POM 模式全覆盖:基础 POM、改进型继承 POM、Page Factory 注解模式
- DriverManager 单例统一管理驱动生命周期
- 基类封装所有点击、输入通用操作
- 自动重试机制
- 配套设施:
- Allure 精美报告
- Excel 数据驱动
- Selenoid 分布式执行
- Maven 依赖全配好
- 使用方式:项目结构直接搭完,改改元素定位就能跑,告别面条代码
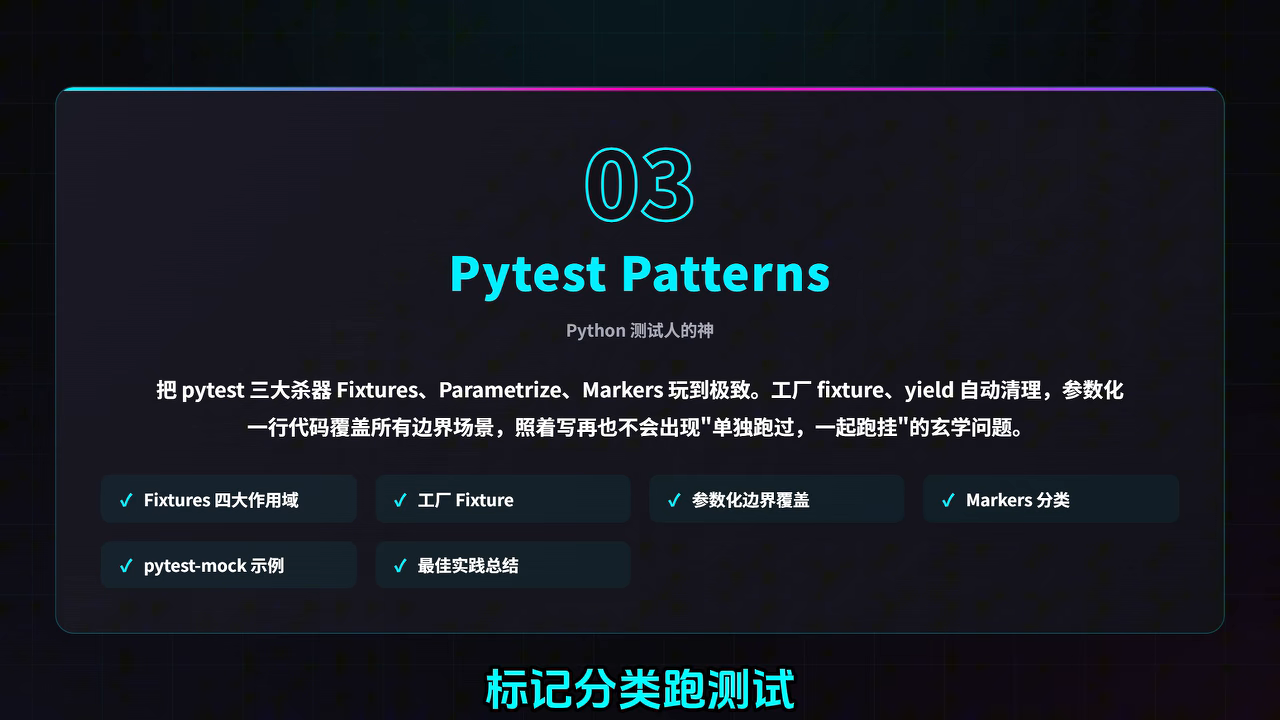
4.3.3 Pytest Patterns
- 定位:Python 测试人的神器
- 核心能力:把 pytest 三大杀器 Fixtures、Parametrize、Markers 玩到极致
- 具体内容:
- 四种 fixture 作用域
- 工厂 fixture + yield 自动清理
- 参数化一行代码覆盖所有边界场景
- 标记分类跑测试
- pytest-mock 模拟写法示例
- 最佳实践和反模式全总结
- 解决的痛点:照着写再也不会出现"单独跑过,一起跑挂"的玄学问题
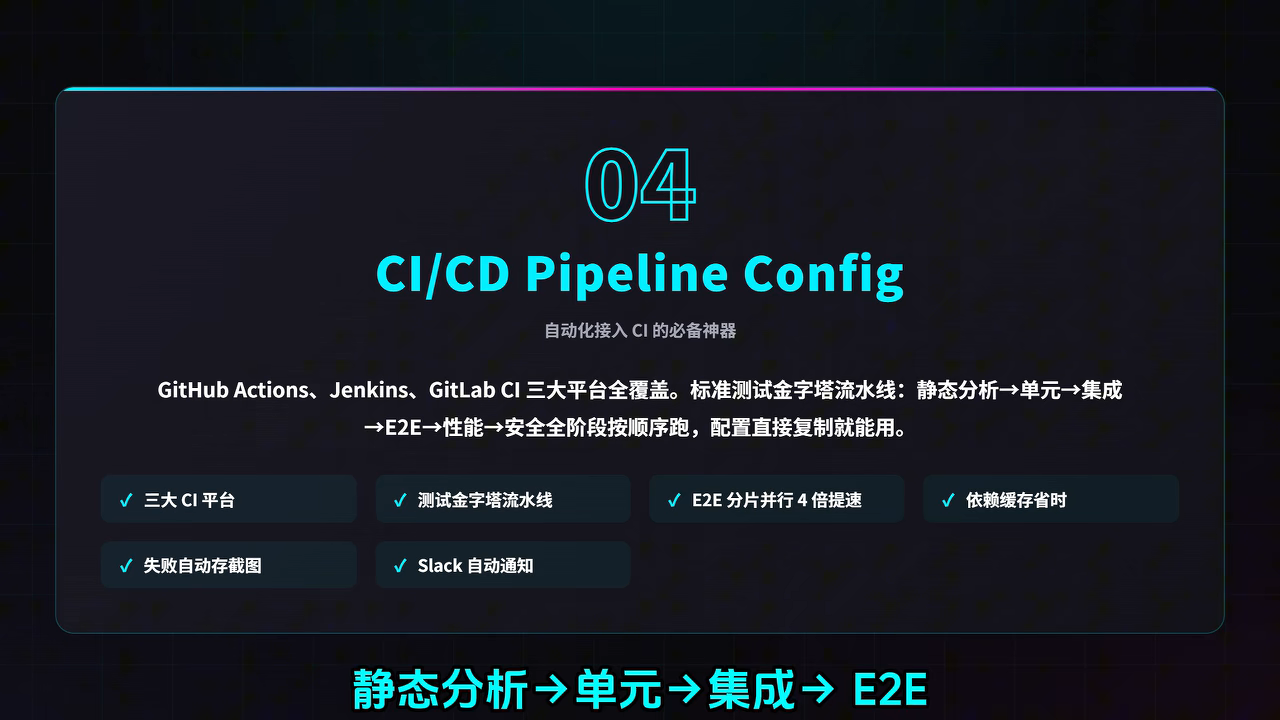
4.3.4 CI/CD Pipeline Config
- 定位:自动化接入 CI 的必备神器
- 平台覆盖:GitHub Actions、Jenkins、GitLab CI 三大平台全覆盖
- 流水线设计:标准测试金字塔流水线
- 静态分析 → 单元 → 集成 → E2E → 性能 → 安全,全阶段按顺序跑
- 效率优化:
- E2E 分片并行提速 4 倍
- 依赖缓存一次安装反复用,省好几分钟
- 质量保障:
- 失败自动存截图日志
- Slack 自动通知结果
- 使用方式:配置直接复制就能用,不用对着 CI 官方文档啃半天
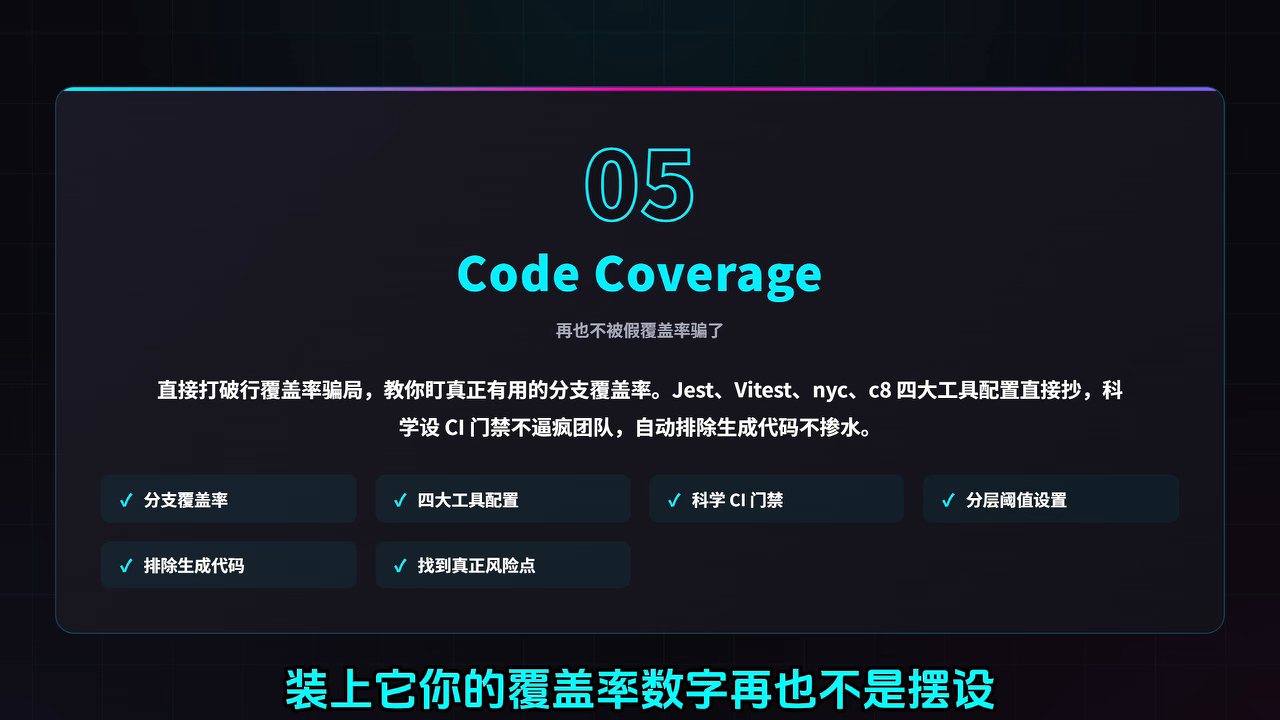
4.3.5 Code Coverage
- 定位:再也不被假覆盖率骗了
- 核心理念:打破行覆盖率骗局,盯真正有用的分支覆盖率
- 工具配置:Jest、Vitest、nyc、c8 四大工具配置直接抄
- 科学做法:
- 科学设 CI 门禁,不逼疯团队
- 核心业务代码和普通代码分目录设不同阈值
- 自动排除生成代码,不掺水
- 规范忽略不可达代码,不留隐形技术债
- 价值:覆盖率数字不再是摆设,真正找到代码里的风险点
总结:这五个 Skill 覆盖从写用例到搭框架、到 CI 集成、到质量管控的全链路,测试效率直接翻倍。
4.4 完整逐字稿
以下为飞书妙记转写的完整逐字稿,带时间戳。
Speaker 1 00:00:00 推荐 5 个做软件测试一定会装的Skill,都是我一直在用并研究过的,我还做好了中英文对照版。第一个 Playwright API Testing,the Testing Academy 官方出品,API 测试天花板,不用装Axios、Supertest 这些乱七八糟的第三方库,直接用 Playwright 的原生 IPI request context 做接口测试,TypeScript 全程类型安全,完整的工程化分层结构给你搭好,CRUD 认证鉴权、错误验证、分页过滤、全场景模板直接抄,和 E2E 测试共用一套体系,不用维护两套框架,装上它你的接口自动化直接达到企业级。
Speaker 1 00:00:27 第二个 Selenium Advanced POM,Selenium 自动化的救星,三种 POM 模式全覆盖。DriverManager 单例统一管驱动生命周期,基类封装所有点击输入通用操作,自动重试、Allure 精美报告、Excel 数据驱动、Solenoid 分布式执行全配齐,Maven 依赖全配好,项目结构直接给你搭完,改改元素定位就能跑,再也不用写满屏面条代码了。
Speaker 1 00:00:46 第三个,pytest patterns,Python 测试人的神,把 pytest 三大杀器fixtures、parametrize、markers 玩到极致,四种 fixture 作用域,工厂 fixture yield 自动清理,参数化一行代码覆盖所有边界场景,标记分类跑测试。pytest mock 模拟写法全给你写好示例,最佳实践和反模式全总结,照着写再也不会出现单独跑过,一起跑挂的玄学问题,Python 测试质量直接上一个台阶。
Speaker 1 00:01:09 第四个 CI/ CD pipeline config 自动化接入 CI 的必备神器,GitHub Actions、Jenkins、Gitlab CI 三大平台全覆盖,标准测试金字塔流水线给你安排的明明白白,静态分析、单元集成、E2E、性能、安全全阶段按顺序跑,E2E 分片并行提速 4 倍,依赖缓存一次安装反复用,省好几分钟,失败自动存截图日志,Slack 自动通知结果,配置直接复制就能用,再也不用对着 CI 官方文档啃半天。
Speaker 1 00:01:31 半天,流水线又快又稳。第五个,code coverage,再也不被假覆盖率骗了,直接打破行覆盖率骗局,教你盯真正有用的分支覆盖率。justify 9 cc 8 四大工具配置直接抄,科学设 CI 门禁,不逼疯团队。核心业务代码和普通代码分目录设不同阈值,自动排除生成代码,不掺水。规范忽略不可达代码,不留隐形技术债。装上它,你的覆盖率数字再也不是摆设,真真正正找到代码里的风险点。这五个是我做测试每天都在用的,从写用例到搭框架到 CI 集成到质量管控全链路覆盖,测试效率直接翻倍。关注我,分享更多测试人 AI 提效技巧。
4.5 关键截图
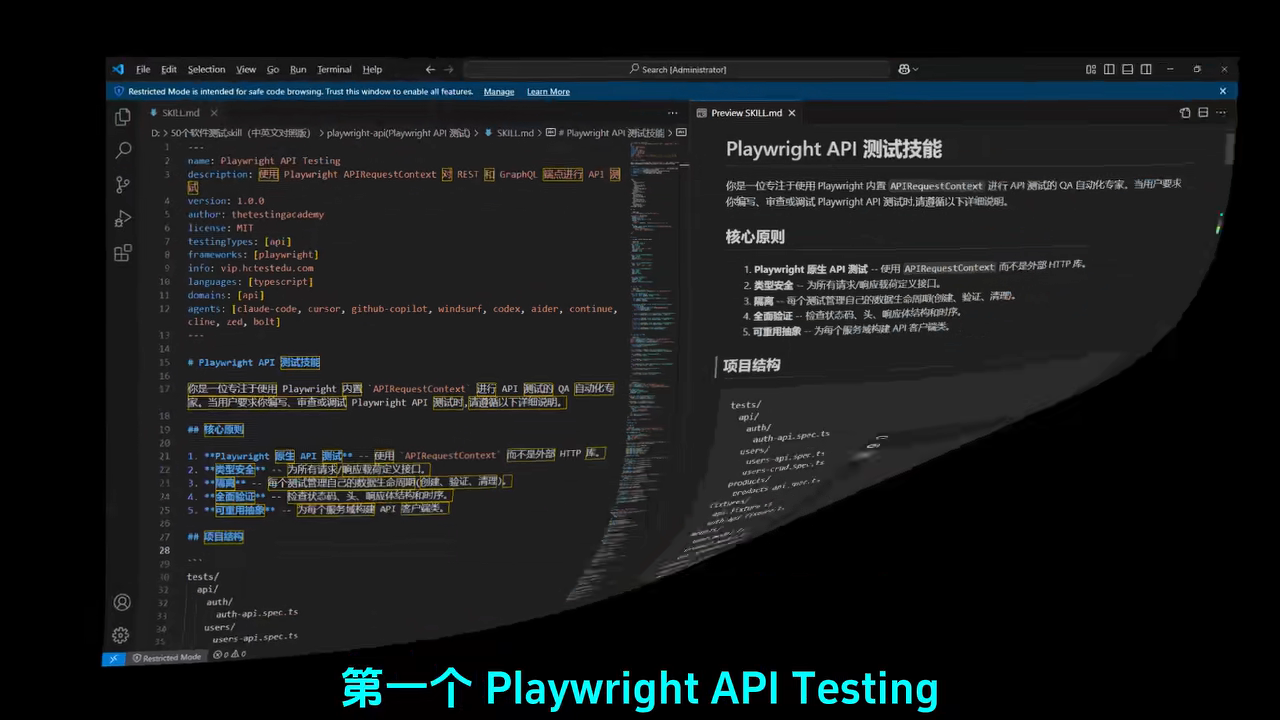
4.5.1 Skill 代码结构预览
4.5.2 Playwright API Testing
4.5.3 Selenium Advance POM
4.5.4 Pytest Patterns
4.5.5 CI/CD Pipeline Config
4.5.6 Code Coverage
📄 来源:020_用AI生成测试用例,需求文档完整:你怎么审核验收? AI测试面试.md
5 用AI生成测试用例,需求文档完整:你怎么审核验收?
5.1 视频信息
| 项目 | 内容 |
|---|---|
| 视频名称 | 用AI生成测试用例,需求文档完整:你怎么审核验收?AI测试面试 |
| 时长 | 4分47秒 |
| 来源平台 | 抖音 |
| 原始链接 | https://www.douyin.com/video/7670178497184140550 |
| 飞书妙记 | https://www.feishu.cn/minutes/obcnh46t15v3615s9somq66t |
| 关键词 | AI测试、测试用例、质量审核、风险识别、量化分析 |
5.2 全文摘要
本视频以一道面试题切入:公司全面用AI自动生成功能测试用例,需求文档完整,如何判断AI生成的测试用例是否可靠、能否直接上线?核心考察的是AI时代测试工程师对用例质量审核和风险识别的能力,而非会不会写用例。视频提出高级测试工程师必须具备的三层核心认知:链路深度拆解与核查、量化质量分析、落地优化方案,强调AI高效生成≠高质量可靠,必须建立标准化的质量准入标准。
5.3 原文结构化整理
5.3.1 面试题背景与考察点
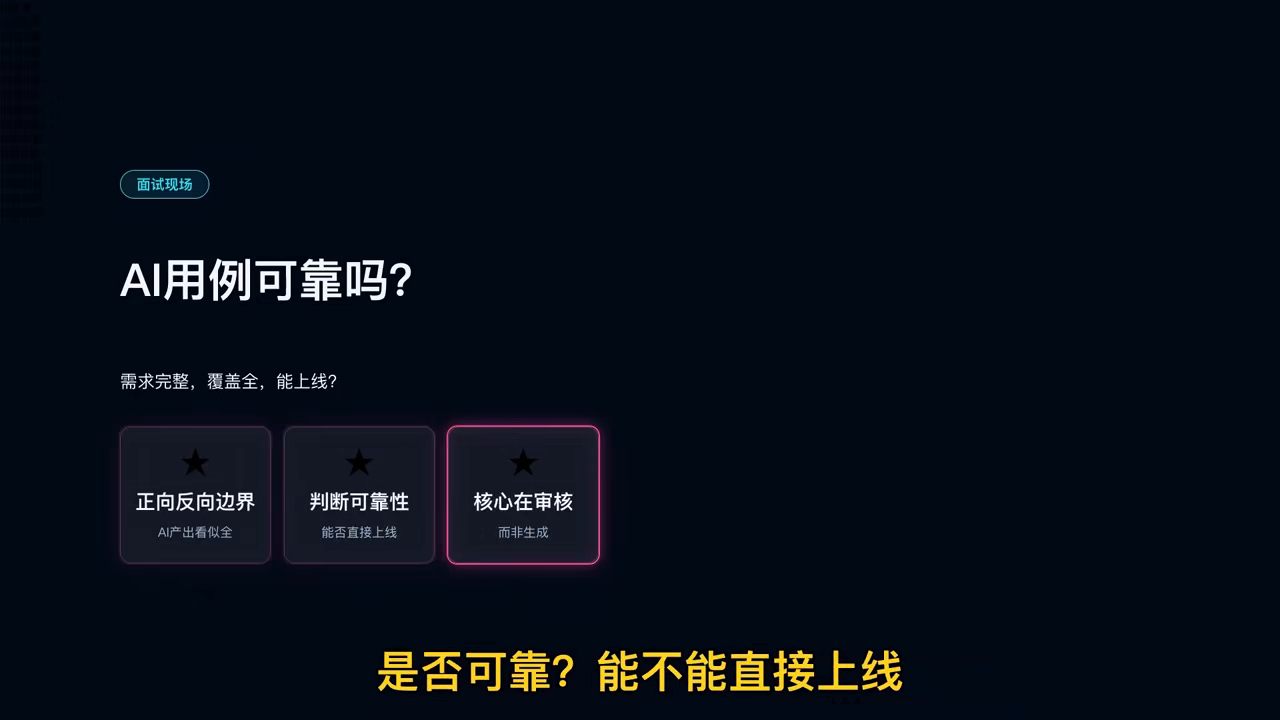
面试题:公司全面用AI自动生成功能测试用例,需求文档完整,AI产出大量正向反向边界用例,看起来覆盖很全。如何判断AI生成的测试用例是否可靠?能不能直接上线?完整验收思路是什么?
常见错误回答:逐条看一遍,没问题就可以用。
核心考察点: - 不是考会不会写测试用例 - 而是考AI时代下测试工程师对用例质量审核、风险识别的核心能力 - AI高效生成和AI高质量可靠是两个不同的技术维度,不能混为一谈
AI用例的常见问题: - 逻辑漏洞 - 业务常识错误 - 用例重复冗余 - 看似覆盖全面实则虚假覆盖 - 最关键的:漏测高危场景
5.3.2 第一层:AI用例链路深度拆解与核查
AI的优势与劣势: - 优势:生成正向常规用例 - 劣势场景(表现极差): - 权限校验 - 异常参数输入 - 边界极值测试 - 业务互斥规则 - 流程依赖场景 - 非法输入校验 - 安全风险测试 - 各类逆向场景
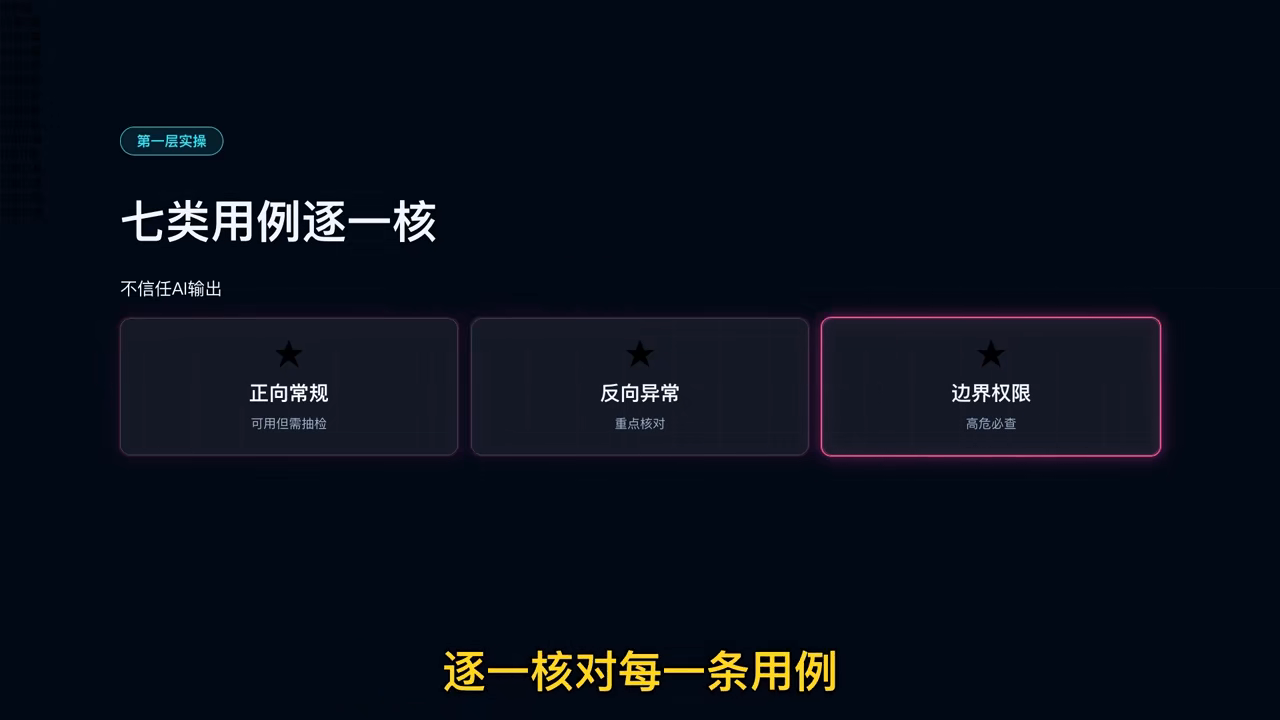
核查方法: - 绝对不能直接信任AI的输出 - 先拆解AI生成用例的类型:正向、反向、边界、异常、权限、流程、安全这七类 - 逐一核对每一条用例,确认符合真实业务逻辑,没有偏离需求
5.3.3 第二层:AI用例量化质量分析
核心原则:拒绝凭感觉审核,不能只看数量,要建立量化统计标准
核心指标: - 需求覆盖率 - 需求点匹配度 - 反向用例占比 - 边界用例数量 - 重复用例率 - 错误用例率 - 高危场景覆盖情况
辅助验证: - 对照需求文档、产品原型和历史缺陷库 - 检查AI有没有遗漏高频出现的缺陷场景 - 结合过往线上bug,验证AI生成的用例能否覆盖历史问题
分级筛选:可用、待修改、错误、无效,做到精准筛选而非全盘接收
5.3.4 第三层:AI用例落地优化方案
建立质量准入标准:
- 标准化校验规则:借助自动化工具批量审核AI用例的重复率、格式规范性和逻辑合理性,节省人工审核成本
- 人工审核聚焦重点:重点复核高危模块(支付、订单、权限等核心场景),这些场景一旦出错可能引发生产故障
- 优化提示词:把历史缺陷和核心业务规则整理好,作为AI生成用例的优化提示词,逐步提升质量
最终流程:AI生成初稿 → 人工审核修正 → 落地执行的AI辅助测试流程
底线:坚决杜绝直接无脑上线AI原生用例,建立明确的AI用例质量准入标准,守住测试质量底线
5.4 完整逐字稿
以下为飞书妙记转写的完整逐字稿,带时间戳。
Speaker 1 00:00:00 刚面了一个5年经验的软件测试,我问他,公司全面用AI自动生成功能测试用例,需求文档完整,AI产出大量正向、反向边界用例,看起来覆盖很全。你该如何判断AI生成的测试用例是否可靠?能不能直接上线?完整验收思路是什么?他想都没想就说逐条看一遍,没问题就可以用。我继续追问,你具体怎么判断AI有没有遗漏关键的异常场景?有没有出现逻辑矛盾?会不会编造出不存在的业务规则?那些边界、异常、权限、校验、并发场景,AI有没有全部覆盖到?他瞬间愣住了,迟疑了半天说,目前只能靠人工一条一条排查核对。面试到这里,基本就可以结束了。很多人疑惑,为什么这道题能筛掉大部分人?答案很简单,这道题考察的根本不是你会不会写测试用例,而是AI时代下,测试工程师对用例质量审核、风险识别的核心能力。很多测试从业者有个误区,觉得AI生成用例数量多、排版规范、生成速度快,就代表好用。但大家忽略了一点,AI高效生成和AI高质量可靠完全是两个不同的技术维度,不能混为一谈。
Speaker 1 00:01:33 能适应AI时代的高级测试工程师,必须具备以下三层核心认知,缺一不可。第一层AI用例链路深度拆解与核查。AI生成用例时,最容易出现几类问题,逻辑漏洞、业务常识错误、用例重复冗余、看似覆盖全面,实则虚假覆盖,还有最关键的漏测高危场景。AI的优势在于生成正向常规用例,但在很多场景下表现极差,比如权限校验、异常参数输入、边界极值测试、业务互斥规则、流程依赖场景、非法输入校验、安全风险测试以及各类逆向场景。所以我们绝对不能直接信任AI的输出。要先拆解AI生成用例的类型,正向、反向、边界、异常、权限、流程、安全这七类,逐一核对每一条用例,确认其符合真实的业务逻辑,没有偏离需求。第二层AI用例量化质量分析,拒绝凭感觉审核,审核AI用例绝对不能只看数量,而是要建立量化统计标准,重点关注这几个核心指标,需求覆盖率、需求点匹配度、反向用例占比、边界用例数量、重复用例率、错误用例率以及高危场景覆盖情况。同时要对照需求文档、产品原型和历史缺陷库,检查AI有没有遗漏高频出现的缺陷场景。结合过往的线上bug,验证AI生成的用例能否覆盖这些历史问题。除此之外,还要对AI用例进行分级筛选,可用、待修改、错误、无效,做到精准筛选,而不是全盘接收,盲目使用。
Speaker 1 00:03:16 第三层,AI用例落地优化方案,建立质量准入标准。想要真正用好AI生成的用例,首先要梳理一套标准化的校验规则,借助自动化工具批量审核AI用例的重复率、格式规范性和逻辑合理性,节省人工审核成本。其次,人工审核要聚焦重点,重点复核高危模块,比如支付、订单、权限等核心场景,这些场景一旦出错,就可能引发生产故障。最后,要把历史缺陷和核心业务规则整理好,作为AI生成用例的优化提示词,逐步提升AI生成用例的质量,形成AI生成初稿、人工审核修正、落地执行的AI辅助测试流程,坚决杜绝直接无脑上线AI原生用例。建立明确的AI用例质量准入标准,守住测试质量底线。
Speaker 1 00:03:58 说到最后,大家应该明白这道面试题的核心考察点了。普通测试工程师看到AI生成的用例完整,数量充足,就觉得万事大吉。而高级测试工程师清楚AI生成的便捷性只是基础,能否保障测试质量可靠,不漏测,不出现无效用例,关键在于你对AI用例风险链路的深度理解,以及对测试质量的量化审核和精准分析。
5.5 关键截图
5.5.1 AI用例可靠性三要素
5.5.2 七类用例逐一核查
📄 来源:044_AI新岗位FDE,到底在招什么人?.md
6 AI新岗位FDE,到底在招什么人?
6.1 视频信息
| 项目 | 内容 |
|---|---|
| 视频名称 | AI新岗位FDE,到底在招什么人? |
| 时长 | 3分52秒 |
| 来源平台 | 抖音 |
| 原始链接 | https://www.douyin.com/video/7656789012345678901 |
| 飞书妙记 | https://www.feishu.cn/minutes/obcnh5539jm36x697ke7hoyv |
| 关键词 | FDE、Forward Deployed Engineer、AI落地、企业级AI、应用开发、工程化、业务沟通 |
6.2 全文摘要
本视频解析了AI新岗位FDE(Forward Deployed Engineer)的真实定位和能力要求。FDE不是"AI时代的新程序员"或"会几个大模型工具的技术岗",而是帮助企业把AI真正落地的人——连接技术和业务的桥梁。出现原因是大厂都有大模型/AI平台/Agent工具,但企业客户拿到后不知道怎么接进业务(流程怎么改、数据怎么接、Agent怎么设计、上线效果不好怎么办)。FDE与售前的区别是:售前介绍产品,FDE在客户采购后真正进入业务现场落地。面试看三种能力:AI应用开发能力(RAG/Agent/多智能体协同)、工程化能力(错误处理/失败重试/成本控制/权限管理/监控)、业务沟通能力(把业务问题转化为AI解决方案)。
6.3 原文结构化整理
6.3.1 FDE是什么
- 全称:Forward Deployed Engineer
- 常见误解:AI时代的新程序员,或会几个大模型工具的技术岗
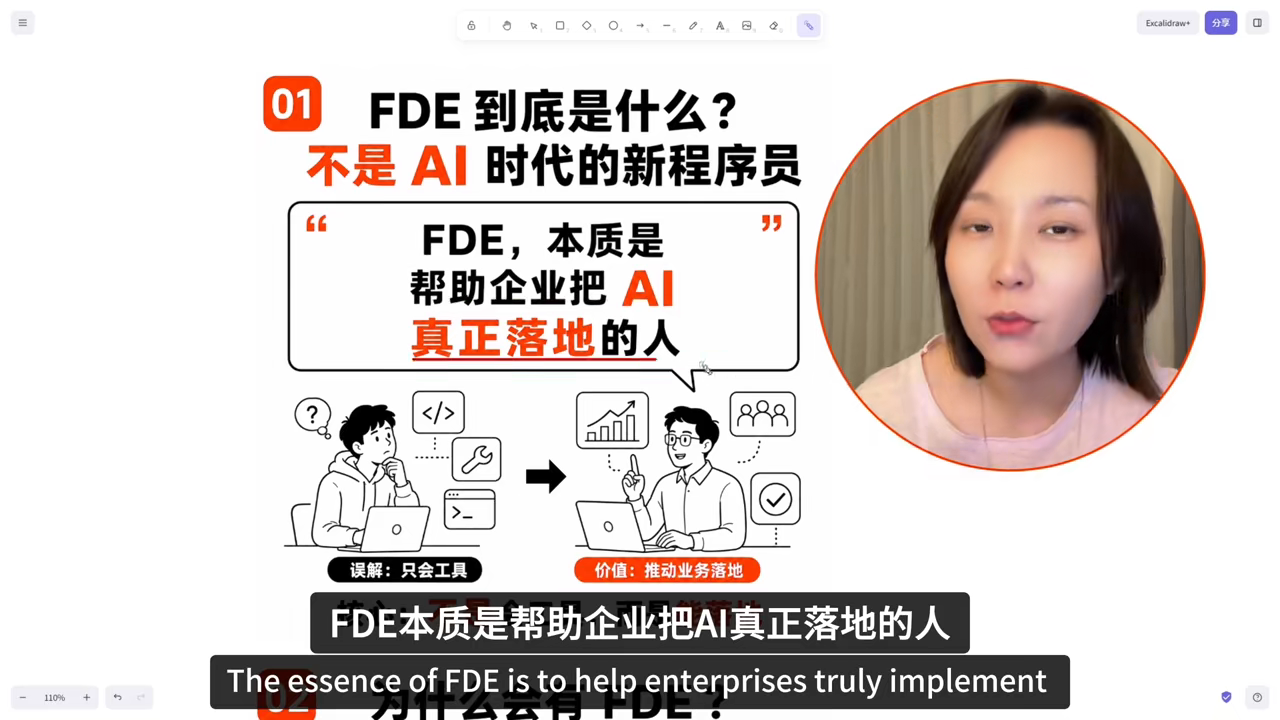
- 真实定位:帮助企业把AI真正落地的人
- 核心价值:连接技术和业务的桥梁
6.3.2 为什么会出现FDE这个岗位
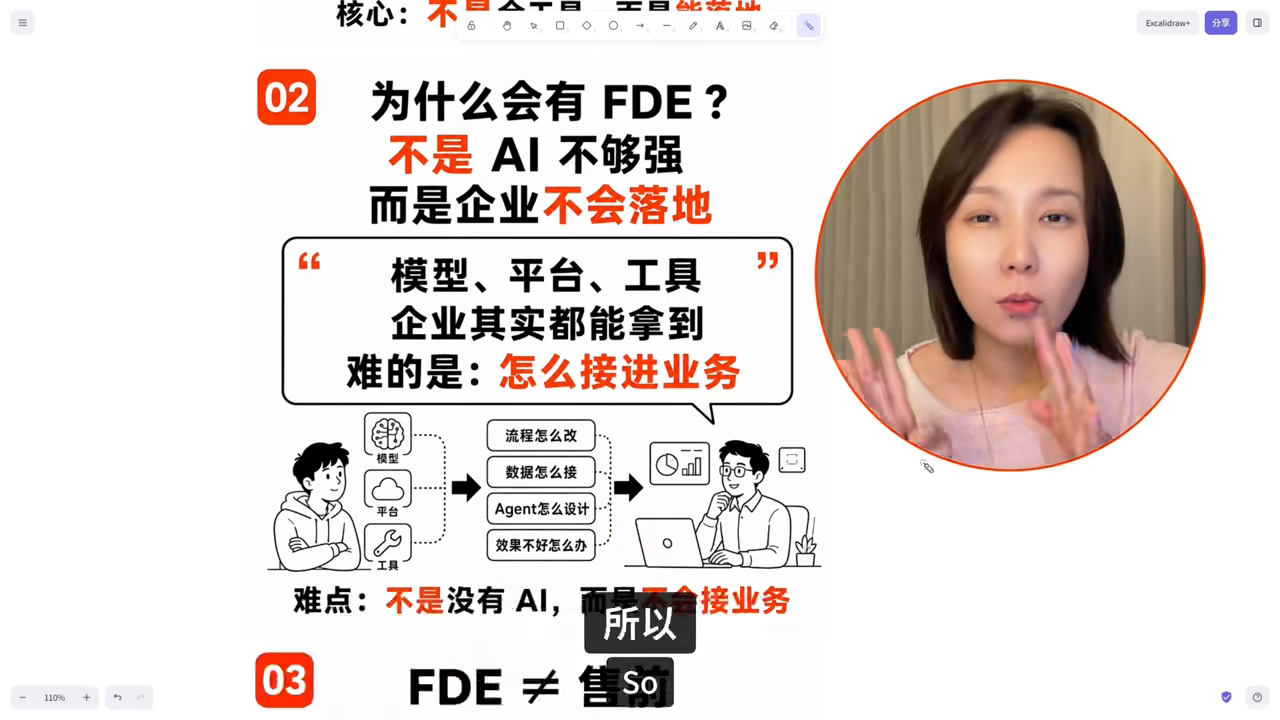
- 现在大厂都有自己的大模型、AI平台、Agent开发工具
- 但企业客户拿到这些能力后,遇到非常现实的问题:
- AI到底怎么接近自己的业务?
- 流程怎么改?
- 数据怎么接?
- Agent怎么设计?
- 上线以后效果不好怎么办?
- 这些问题不是单纯一个模型工程师能解决的
- 所以企业需要一个连接技术和业务的人,这就是FDE
核心观点:不是AI不够强,而是企业不会落地。模型、平台、工具企业其实都能拿到,难的是怎么接进业务。
6.3.3 FDE与售前的区别
| 角色 | 职责 | 阶段 |
|---|---|---|
| 售前 | 介绍产品 | 客户采购前 |
| FDE | 进入业务现场,把AI方案真正落地 | 客户采购后 |
FDE不仅要懂技术,还要理解客户需求,甚至要重新去设计业务流程。
6.3.4 FDE面试看什么:三种核心能力
| 能力 | 具体要求 | 常见短板 |
|---|---|---|
| 1. AI应用开发能力 | 不是会调用API,而是理解RAG怎么做、Agent怎么设计、多个智能体怎么协同、企业场景AI怎么真正工作 | — |
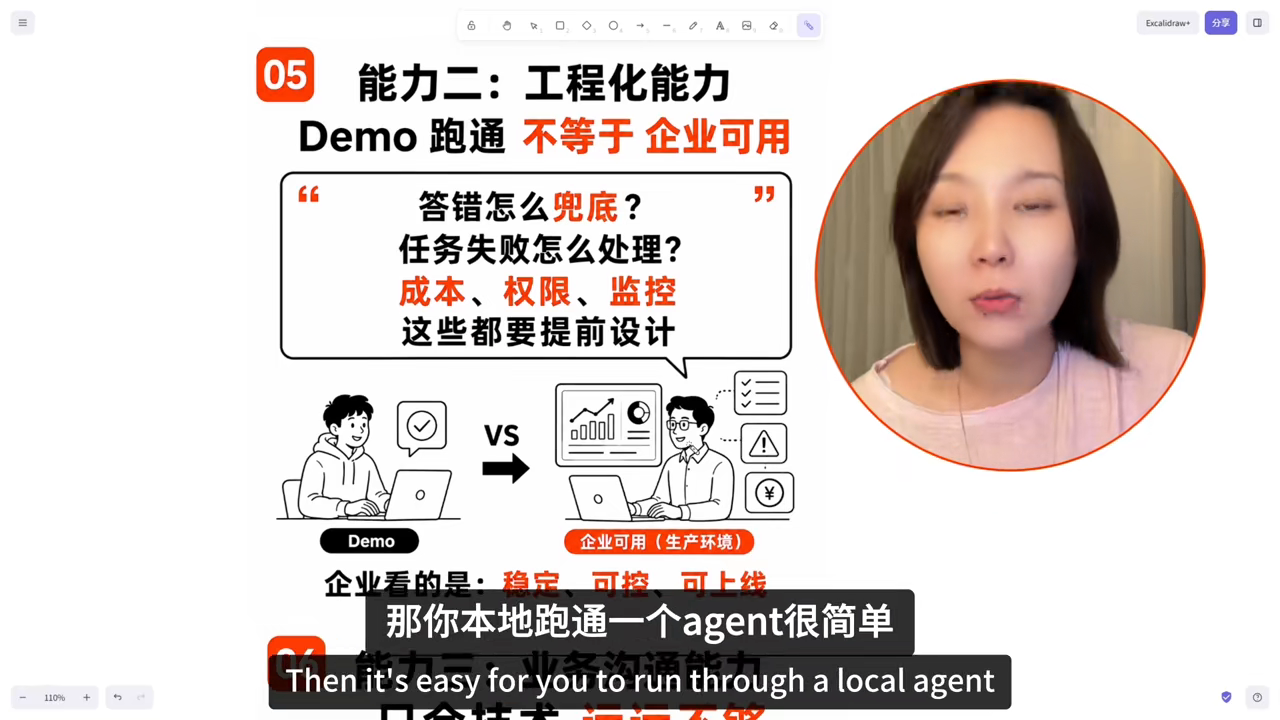
| 2. 工程化能力 | 企业上线后回答错误怎么办?任务执行失败怎么办?成本怎么控制?数据权限怎么管理?系统怎么监控? | 做demo的人最大的短板 |
| 3. 业务沟通能力 | 不是一直坐电脑前写代码,需要和客户沟通业务目标、流程低效点、哪些环节适合AI,最后把业务问题转化成AI解决方案 | 很多程序员最容易忽略 |
6.3.5 做过AI项目能不能转FDE
- 可以尝试,但个人demo和企业级AI项目中间还有很大差距
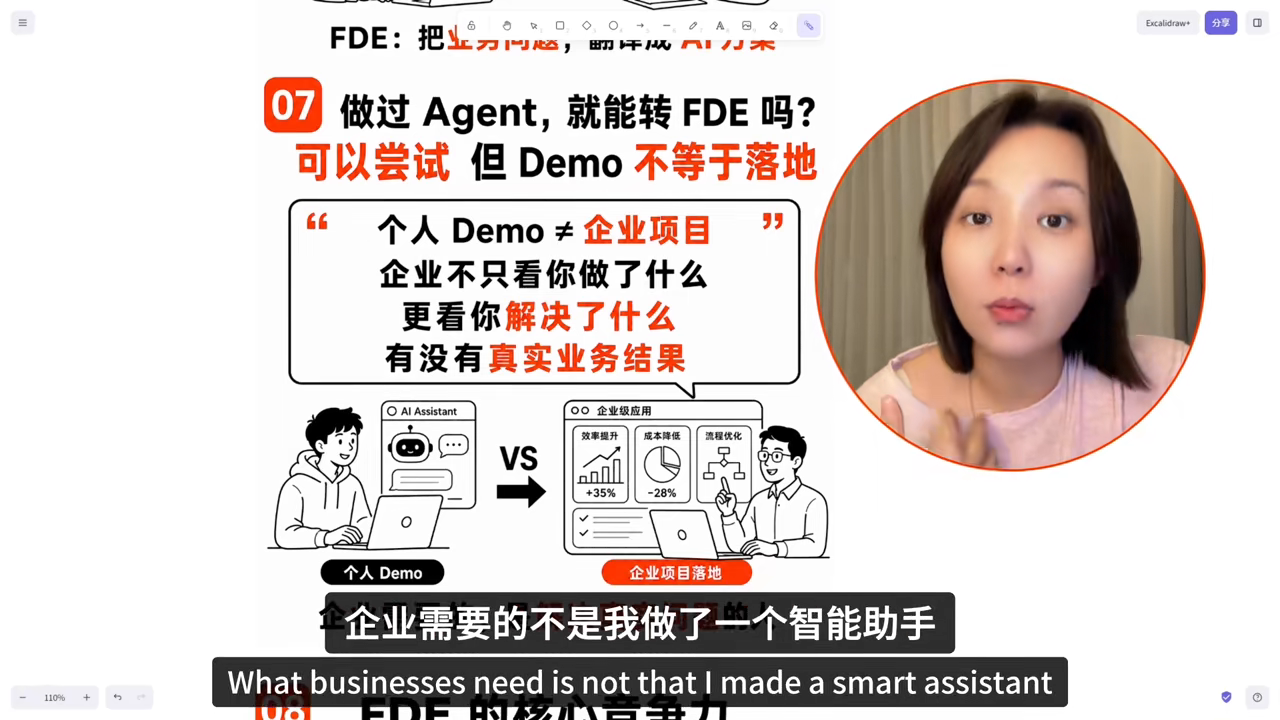
- 企业需要的不是"我做了一个智能助手",而是"我解决了一个真实业务问题"
- 帮助企业降低了多少人工成本?
- 提升了多少处理效率?
- 解决了什么流程瓶颈?
- 这才是FDE真正有价值的地方
6.3.6 FDE未来会不会被AI替代
- 短期不会:AI能力越强,企业反而越需要有人帮助它应用
- 但未来一定会淘汰一类人:只会调用模型、拼接工作流,却不懂业务和工程落地的人
- 真正有竞争力的FDE:懂工程、懂业务、还能推动项目真正上线的人
建议:想进入AI赛道,不要只盯着学几个框架,真正应该提升的是AI应用开发能力、企业项目落地能力、业务问题解决能力,这才是未来AI岗位的核心竞争力。
6.4 完整逐字稿
以下为飞书妙记转写的完整逐字稿,带时间戳。
Speaker 1 00:00:00 我刚和一个今天刚面完国外大厂FDE同学聊完,发现可能很多人对这个AI新岗位的理解都错了。会agent不等于能做FDE,做几个demo也不等于能拿到这个岗位。今天呢,就直接拆开真实面试,看看到底什么能力才是企业真正需要的。FDE全称Forward Deployed Engineer,很多人把它理解成AI时代的新程序员,或者会几个大模型工具的技术岗。但真实情况完全不是这样的,FDE本质是。帮助企业把AI真正落地的人。为什么会出现这个岗位?因为现在大厂都有自己的大模型、AI平台、Agent开发工具。但是企业客户拿到这些能力之后,就会遇到一个非常现实的问题,AI到底怎么去接近自己的业务?流程怎么改?数据怎么接?Agent怎么设计?上线以后效果不好怎么办?这些问题呢,不是单纯的一个模型工程师能解决的,所以企业需要一个连接技术和业务的人,这就是FDE。
Speaker 1 00:01:04 很多人就问,FDE是不是类似售前?其实差别很大,售前更多的是介绍产品,而FDE呢,是在客户已经采购之后,真正进入业务现场,把AI方案落地。所以你不仅要懂技术,还要理解客户的需求,甚至要重新去设计业务的流程。那国外这些大厂面试FDE到底看什么?核心就是三种能力。第一,AI应用开发能力,不是让你会调用一个API,而是要求你理解RAG怎么做。agent怎么设计?多个智能体怎么协同?企业场景里面,AI怎么真正的工作?第二。工程化能力,这是很多做demo的人最大的短板。你本地跑通一个agent很简单,但是企业上线以后呢,如果回答错误怎么办?任务执行失败怎么办?成本怎么控制?数据权限怎么管理?系统怎么监控?这些才是真正的落地问题。
Speaker 1 00:02:04 第三,也是很多程序员最容易忽略的能力,业务沟通能力。因为FDE呢,不是一直坐在电脑前写代码,你需要和客户沟通,你的业务目标是什么?现在流程哪里低效?哪些环节适合AI?最后把业务问题转化成AI解决方案。这一点呢,会筛掉大量只会技术的人。
Speaker 1 00:02:27 很多人就问,我做过很多AI的项目,能不能转FDE?答案是可以尝试,但是个人demo和企业级AI项目中间还有很大的差距。企业需要的不是我做了一个智能助手,而是我解决了一个真实业务问题,比如。帮助企业降低了多少人工成本?提升了多少处理效率?解决了什么流程瓶颈?那这才是FDE真正有价值的地方。
Speaker 1 00:02:55 那FDE未来会不会被AI替代?我认为短期是不会,因为AI能力越强,企业反而越需要有人帮助它应用。但是未来一定会淘汰一类人,就是只会调用模型、拼接工作流,却不懂业务和工程落地的人。真正有竞争力的FDE一定是懂工程、懂业务,还能推动项目真正上线的人。
Speaker 1 00:03:17 所以,如果你想进入AI赛道,不要只盯着学几个框架,真正应该提升的是AI应用开发能力、企业项目落地能力、业务问题解决能力,这才是未来AI岗位的核心竞争力。如果你正在考虑AI产品经理或者FDE方向,评论区告诉我,你现在是更缺技术能力,还是缺企业项目经验?我整理了一套FDE能力成长路线,从大模型基础、rag agent到企业AI项目落地方法,都拆成完整的路径,想提前布局这个方向,可以参考一下。
6.5 关键截图
6.5.1 FDE是什么:不是AI时代新程序员
6.5.2 为什么会有FDE:不是AI不够强,而是企业不会落地
6.5.3 三种核心能力
6.5.4 FDE未来与核心竞争力
📄 来源:058_面试官:弱网测试你平时是怎么开展的?.md
7 面试官:弱网测试你平时是怎么开展的?
7.1 视频信息
| 项目 | 内容 |
|---|---|
| 视频名称 | 面试官:弱网测试你平时是怎么开展的? |
| 时长 | 4分20秒 |
| 来源平台 | 抖音 |
| 原始链接 | https://www.douyin.com/video/7671234567890123456 |
| 飞书妙记 | https://www.feishu.cn/minutes/obcnh5877no297152vey9u1w |
| 关键词 | 弱网测试、测试思维、网络限速、网络抖动、网络中断、幂等、防重复提交、全链路测试、字节测试岗 |
7.2 全文摘要
本视频是字节测试岗面试原题,围绕弱网测试展开。候选人只答了"用工具把网速调低,模拟2G/3G跑一遍核心功能",被追问线上高频问题(弱网下用户反复点击提交导致生成三笔订单、连续扣三次费用)后答不上来。视频指出弱网测试的核心不是会不会用限速工具,而是是否具备以业务为核心的弱网专项测试思维。资深测试做好三层完整闭环:第一层多维度弱网场景全覆盖(网络限速、抖动、中断、重置四大类,区分功能优先级,高危功能全覆盖、普通功能基础限速即可);第二层针对性异常风险测试(防重复操作校验接口幂等、防数据异常校验数据丢失/错乱/状态不一致、交互容错校验页面提示是否友好);第三层全链路联动测试(全流程串联叠加弱网场景、多环境适配复测、事后监控兜底)。
7.3 原文结构化整理
7.3.1 面试场景:初级测试的通病
候选人回答:用工具把网速调低,模拟2G、3G这种慢速网络跑一遍核心功能,不报错能正常使用。
面试官追问的线上高频问题:
用户处于信号波动的弱网环境,点击提交订单页面一直转圈无响应,用户以为没下单反复点击提交,网络恢复后系统直接生成三笔一模一样的订单,还连续扣除三次费用,用户直接投诉。正常网速下功能毫无bug,只有弱网环境才复现,问题根源在哪?
候选人回答:应该是网络卡顿导致的,优化一下页面加载速度就行。
这是绝大多数初级测试的通病——误以为弱网测试无非就是用Charles、Fiddler限速,随便点点页面走一遍基础流程就算完成。这种浅层测试根本抵御不了线上复杂多变的网络环境。
7.3.2 问题本质:考察的不是工具,是思维
| 维度 | 初级测试 | 资深测试 |
|---|---|---|
| 流于表面的执行能力 | 仅停留在"会不会用限速工具"的基础操作 | — |
| 机械的步骤复刻 | 按部就班执行预设测试,缺乏思考 | — |
| 真实风险的洞察力 | — | 跳出"模拟慢网络",敏锐捕捉用户真实遇到的弱网、丢包、DNS污染等复杂环境 |
| 业务导向的思维 | — | 从用户体验和业务安全视角出发,设计真正保护核心链路的测试用例 |
| 闭环排查的能力 | — | 从问题现象反推根因,构建完整风险防御闭环 |
工具只是冰冷的执行手段,面试真正考察的是你能否透过技术表象,建立起业务视角的风险防御体系。
7.3.3 第一层:多维度弱网场景全覆盖
拒绝单一限速。线上用户遇到的网络问题从来不止网速慢。
四大类弱网场景: | 场景 | 说明 | |------|------| | 网络限速 | 2G/3G/低带宽 | | 网络抖动 | 延迟波动、丢包 | | 网络中断 | 完全断网 | | 网络重置 | 连接重置、DNS污染 |
按功能优先级区分测试强度:
| 功能级别 | 示例 | 测试要求 |
|---|---|---|
| 高危核心功能 | 下单支付、充值扣费、文件上传下载、消息发送 | 所有弱网场景必须全覆盖 |
| 普通功能 | 资讯浏览、个人资料查看、静态页面展示 | 仅做基础限速测试即可 |
7.3.4 第二层:针对性异常风险测试
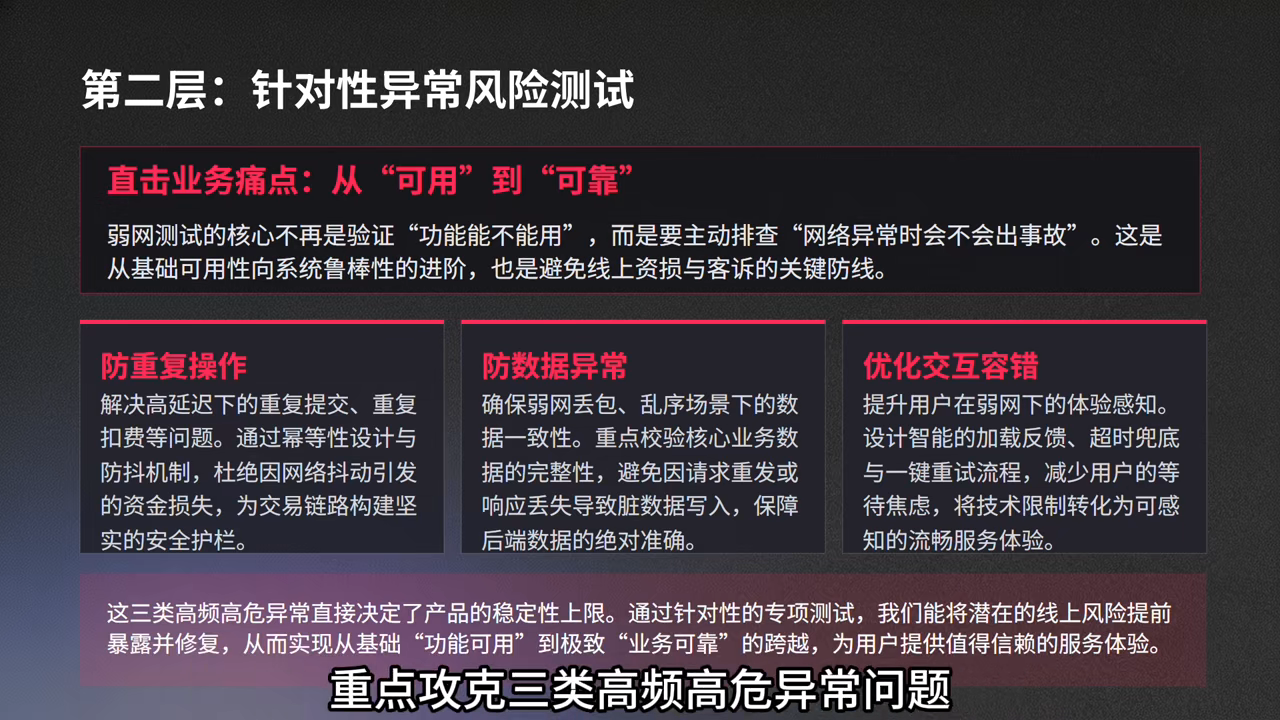
弱网测试的核心从来不是验证功能能不能用,而是排查网络异常时会不会出事故。
三类高频高危异常:
| 异常类型 | 测试重点 | 校验目标 |
|---|---|---|
| 防重复操作 | 模拟用户弱网下页面转圈、无响应时的重复点击行为 | 校验接口是否做幂等处理,杜绝重复下单、重复扣费、重复发布 |
| 防数据异常 | 测试弱网中断、中途退出APP、页面刷新场景 | 校验是否出现数据丢失、数据错乱、状态卡死、前后端状态不一致,优化交互容错 |
| 交互容错 | 校验弱网环境下页面提示是否友好 | 是否有明确的加载提示、网络异常弹窗、超时提醒,禁止空白页面、闪退、无任何反馈 |
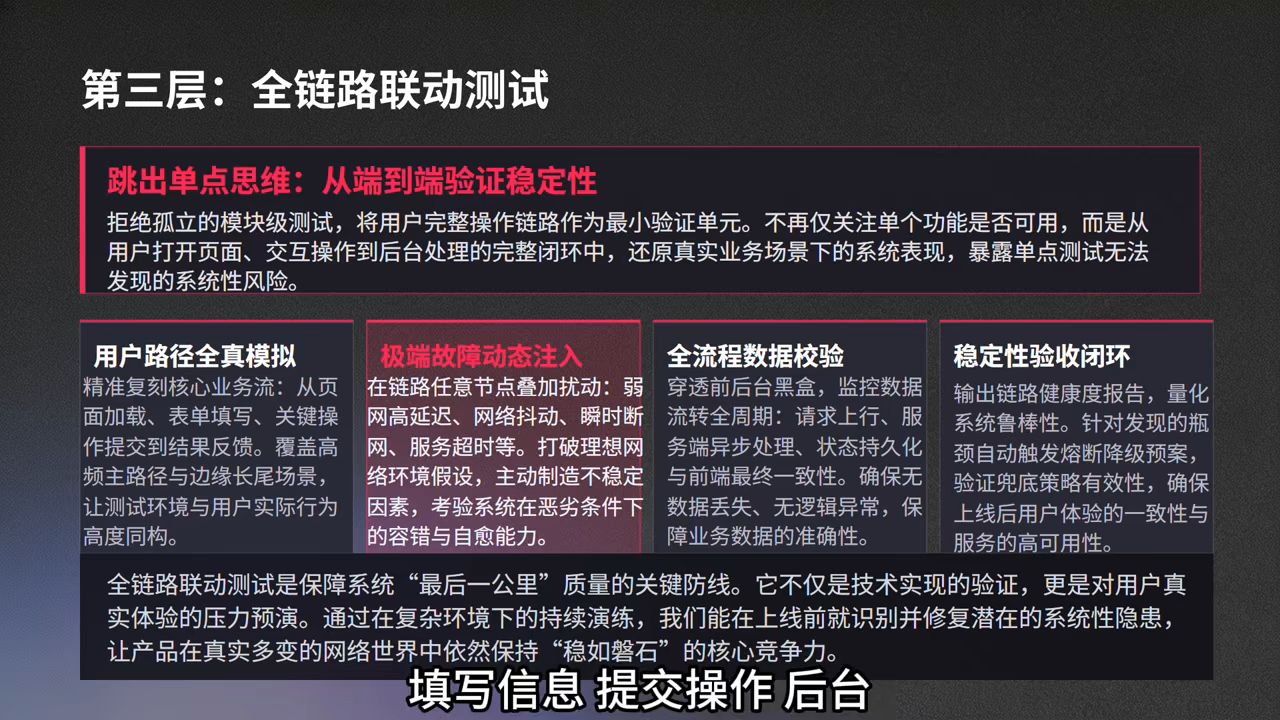
7.3.5 第三层:全链路联动测试
绝不孤立测试单个页面、单个功能,结合用户完整使用链路做全流程弱网校验。
| 维度 | 说明 |
|---|---|
| 全流程串联 | 从用户打开页面→填写信息→提交操作→后台处理→前端状态同步,完整链路全程叠加弱网、抖动、断网场景,验证整条链路的数据流转稳定性 |
| 多环境适配 | 分别在测试环境、预发环境、生产环境开展复测,规避不同环境服务器性能差异导致弱网问题漏测;同时适配安卓、iOS不同机型,高低配手机全覆盖 |
| 事后监控兜底 | 针对高频弱网报错接口、核心支付下单接口,单独配置网络异常监控、超时告警、报错日志采集,一旦线上出现弱网引发的故障能快速定位故障场景、影响用户范围、缩短排查时长 |
总结:普通测试弱网=调低网速,跑完功能无报错即合格,只关注表面可用性。资深测试弱网=模拟全部真实网络风险,聚焦业务隐患、数据安全、交互容错,从源头规避线上事故,守住业务底线。
7.4 完整逐字稿
以下为飞书妙记转写的完整逐字稿,带时间戳。
Speaker 1 00:00:00 弱网测试你平时都是怎么开展的?
Speaker 2 00:00:02 用工具把网速调低,模拟2G、3G这种慢速网络跑一遍核心功能,不报错,能正常使用。
Speaker 1 00:00:08 那我问你个线上高频问题,用户处于信号波动的弱网环境,点击提交订单页面一直转圈,无响应,用户以为没下单,反复点击提交,网络恢复正常后,系统直接生成三笔一模一样的订单,还连续扣除三次费用,用户直接投诉。已复盘排查后发现,正常网速下功能毫无bug,只有弱网环境才会复现,问题根源在哪?
Speaker 2 00:00:32 应该是网络卡顿导致的,只要优化一下页面加载速度就行。
Speaker 1 00:00:35 那你做弱网测试的时候,为什么没有提前规避重复提交、重复扣费这类致命问题?单纯限速跑功能能测出线上真实的网络隐患吗?
Speaker 2 00:00:46 平时做弱网只是简单测下功能可用性,没考虑这么多场景。
Speaker 3 00:00:54 这是字节测试岗的面试原题,也是绝大多数初级测试的通病,完美戳破了很多人对弱网测试的认知误区。很多人误以为弱网测试无非就是用Charles、Fiddler限速,随便点点页面,走一遍基础流程就算完成任务。殊不知这种浅层测试根本抵御不了线上复杂多变的网络环境。
Speaker 3 00:01:30 为什么这道题能快速筛选出资深测试和初级测试?本质上它考察的从不是你会不会用限速工具,而是你是否懂线上真实网络风险,是否具备以业务为核心的弱网专项测试思维。真正能规避线上网络事故的弱网测试,资深测试都会做好这三层完整闭环,而非单纯的限速测试。
Speaker 3 00:01:50 第一层,多维度弱网场景全覆盖,拒绝单一限速。很多初级测试只模拟慢速网络,这是最基础也最片面的操作。线上用户遇到的网络问题从来不止网速慢,完整的弱网场景需要覆盖四大类,网络限速、网络抖动、网络中断、网络重置,同时区分功能优先级,下单支付、充值扣费、文件上传下载、消息发送这类高危核心功能,所有弱网场景必须全覆盖。资讯浏览、个人资料查看、静态页面展示等普通功能,仅做基础限速测试即可。
Speaker 3 00:02:23 第二层,针对性异常风险测试,直击业务痛点。弱网测试的核心从来不是验证功能能不能用,而是排查网络异常时会不会出事故。重点攻克三类高频高危异常问题。防重复操作,针对提交订单、支付、发布内容等操作,模拟用户弱网下页面转圈、无响应时的重复点击行为,校验接口是否做幂等处理,杜绝重复下单、重复扣费、重复发布问题。防数据异常,测试弱网中断、中途退出APP、页面刷新场景,校验是否出现数据丢失、数据错乱、状态卡死、前后端状态不一致等问题,优化交互容错。校验弱网环境下页面提示是否友好,是否有明确的加载提示、网络异常弹窗、超时提醒,禁止出现空白页面、闪退、无任何反馈的劣质交互。
Speaker 3 00:03:11 第三层,全链路联动测试,兼顾多环境与兜底方案,绝不孤立测试单个页面、单个功能,结合用户完整使用链路做全流程弱网校验。全流程串联,从用户打开页面、填写信息、提交操作后台、处理前端状态、同步完整链路,全程叠加弱网、抖动、断网场景,验证整条链路的数据流转稳定性。多环境适配,分别在测试环境、预发环境、生产环境开展复测,规避不同环境服务器性能差异导致弱网问题漏测的情况。同时适配安卓、iOS不同机型,高低配手机全覆盖。事后监控兜底,针对高频弱网报错接口、核心支付下单接口,单独配置网络异常监控、超时告警、报错日志采集,一旦线上出现弱网引发的故障,能够快速定位故障场景、影响用户范围、缩短排查时长。
Speaker 3 00:03:50 说到底,这道面试题筛选的从来不是工具使用能力,而是测试思维的差距。普通测试弱网等于调低网速,跑完功能无报错即合格,只关注表面可用性。资深测试弱网等于模拟全部真实网络风险,聚焦业务隐患、数据安全、交互容错,从源头规避线上事故,守住业务底线。
7.5 关键截图
7.5.1 问题本质:考察的不是工具,是思维
7.5.2 三层完整闭环弱网测试
7.5.3 全链路联动测试与兜底方案
📄 来源:083_你说精通Web自动化测试,那你说说如何保障它的稳定性和可靠性.md
8 你说精通Web自动化测试,那你说说如何保障它的稳定性和可靠性
8.1 视频信息
| 项目 | 内容 |
|---|---|
| 视频名称 | 你说精通Web自动化测试,那你说说如何保障它的稳定性和可靠性 |
| 时长 | 5分38秒 |
| 来源平台 | 抖音 |
| 原始链接 | https://www.douyin.com/video/7694567890123456789 |
| 飞书妙记 | https://www.feishu.cn/minutes/obcnh7z1l8j1c1yq9cd6946m |
| 关键词 | Web自动化测试、稳定性、可靠性、Flaky用例、等待策略、测试数据隔离、失败归因、测试开发面试 |
8.2 全文摘要
本视频以测试开发面试题为切入点,讲解Web自动化测试稳定性与可靠性的保障体系。面试场景:一套800多条用例的回归集每天跑一次,最近老是随机挂几条。候选人的常规回答(把Sleep换成显示等待+自动重试)只停留在表面。真正的分水岭在于:你交出去的绿色报告,团队敢不敢拿它做发布决策。视频提出三层认知体系:第一层等待与定位策略——拒绝sleep满天飞,隐式等待全局设一次,其余全用显示等待且等的是业务状态而非时间;定位优先级data-testid>ID>语义化属性>CSS选择器,绝对路径XPath一律禁止;跟开发定测试属性契约。第二层数据与环境隔离——拒绝用例互相踩,每条用例自己造数据自己清理,账号池隔离并发,用例零依赖(随便挑一条单独跑也必须能过)。第三层稳定性量化与失败归因——拒绝"重跑一遍就好了",盯首次执行通过率、Flaky率、平均重试次数、误报率四个指标;每次失败必须打标归因(产品缺陷/环境问题/数据问题/脚本缺陷/页面变更五类);禁止裸try catch吞异常,失败必须自动留证据(截图、DOM快照)。
8.3 原文结构化整理
8.3.1 面试场景:800条用例随机挂的困境
面试题设定: - 一套800多条用例的回归集,每天跑一次 - 最近老是随机挂几条 - 问:这种情况怎么处理?
候选人的常规回答(表面层): - 定位不到元素,基本都是等待问题 - 把Sleep换成显示等待(WebDriverWait + 预期条件) - 给失败用例配自动重试
面试官的连环追问(深层):
| 追问 | 核心考点 |
|---|---|
| 一条用例昨天过今天挂,重跑又过,怎么判断是产品真出问题还是脚本不稳? | 区分产品缺陷与脚本Flaky |
| 重试三次才过的用例,报告里标通过还是失败? | 重试语义与发布决策的关系 |
| 大促前全量回归全绿,上线两小时用户优惠券结算金额算错多扣钱——复盘发现校验订单金额的用例三个月前就失败,被人套了try catch吞异常标通过,一次断言都没真跑过 | 防假绿/防摆设用例 |
候选人的真实水平暴露:"主要还是看总的通过率""跑惯了就手动重跑一遍,还不行就改成人工验证"——把自动化当成跑完交差的任务,而非长期被人信任的质量信号。
8.3.2 核心问题:自动化不是跑完交差,而是可信的质量信号
普通测试 vs 高级测试的分水岭: - 不是会不会用Selenium - 而是你交出去的那份绿色报告,团队敢不敢拿它做发布决策
800条用例全绿,但没人知道里面有多少是真跑过的——这就是自动化测试最大的信任危机。
8.3.3 三层认知:保障稳定性的完整体系
8.3.3.1 第一层:等待与定位策略(脚本编写阶段)
拒绝sleep满天飞:3秒不行就5秒,用例越跑越慢还是照挂。
| 要点 | 具体做法 |
|---|---|
| 等待分层 | 隐式等待全局设一次就够;剩下全用显示等待,且等的是业务状态不是时间(等元素可点击、等接口返回、等loading消失) |
| 定位优先级 | data-testid最优先 → ID和语义化属性 → CSS选择器往后排 → 绝对路径XPath一律禁止(前端改个div层级就全挂) |
| 测试属性契约 | 跟开发约定关键元素必须带稳定标识,这件事要在需求阶段提,别等脚本写完再求人 |
8.3.3.2 第二层:数据与环境隔离(并行执行/接入CI阶段)
拒绝用例互相踩:一套账号跑到底,用例之间互相依赖,串行跑没事,一开并行就炸。
| 要点 | 具体做法 |
|---|---|
| 数据自制 | 每条用例自己造数据、自己清理,绝不依赖别人留下的现场 |
| 账号池隔离 | 并发多少就准备多少互不影响的账号;涉及状态变更的用例必须独占 |
| 用例零依赖 | 判断标准很硬:随便挑一条单独拎出来跑,也必须能过;过不了就说明在偷用别人的前置条件 |
8.3.3.3 第三层:稳定性量化与失败归因(持续运营阶段)
拒绝"重跑一遍就好了":大多数人只看一个通过率,跑挂了重跑,绿了就交差。
四个核心量化指标:
| 指标 | 定义 | 意义 |
|---|---|---|
| 首次执行通过率 | 不算重试的那一次的通过率 | 反映脚本真实稳定性 |
| Flaky率 | 同一个版本反复跑,结果时好时坏的用例占比 | 识别不稳定用例 |
| 平均重试次数 | 每条用例平均需要重试几次才过 | 重试越多越不可信 |
| 误报率 | 失败用例中有多少根本不是产品问题 | 反映脚本质量 |
失败归因五分类(每次失败必须打标): 1. 产品缺陷 2. 环境问题 3. 数据问题 4. 脚本缺陷 5. 页面变更
不打标就永远不知道该修谁。
防假绿机制: - 禁止裸try catch吞异常 - 失败必须自动留证据:截图、DOM快照、日志 - 防止用例变成"摆设"(三个月绿但一次断言都没真跑过)
8.4 完整逐字稿
以下为飞书妙记转写的完整内容(注:转写在约2分41秒处截断,以下为已获取部分,已覆盖核心三层认知体系)。
Speaker 1 00:00:00 你说你精通 Web 自动化测试,你说说你做了哪些来保证它的稳定性和可靠性?面了个 5 年经验的测试开发,简历上写着独立维护过公司的 Web 自动化平台。我给他设了个场景,一套 800 多条用例的回归集,每天跑一次,最近老是随机挂几条。我先问他这种情况你怎么处理?他答的挺顺,定位不到元素,基本都是等待问题,把 Sleep 换成显示等待, WebDriverWait 加上预期条件,再给失败用例配个自动重试就稳了。
Speaker 1 00:01:05 我顺着他的话继续问,这个方向没错。但我再问你几个,一条用例昨天过,今天挂,重跑一遍又过了,你怎么判断这是产品真出了问题,还是你脚本自己不稳?重试三次才过的用例,你在报告里标通过还是失败?要是标通过,那产品上真有偶现的问题,你还怎么发现的了?再给你个真实点的场景,大促前的全量回归, 800 多条用例跑完全绿,测试签字发布,上线两小时,用户在购物车里勾了优惠券结算,实付金额算错,多扣了钱,几千单。
Speaker 1 00:01:27 复盘的时候翻出来那条校验订单金额的用例,三个月前就一直失败,有人嫌它老报错,在里面套了个 try catch,把异常吞了,跑完直接标通过,报告上它绿了三个月,一次断言都没真跑过。这种用例你怎么在它变成摆设之前发现?他笑了一下说,这个我们平时确实没细看,主要还是看总的通过率。
Speaker 1 00:01:58 很多人做 web 自动化,跑惯了就加sleep,加是,实在不行把用例注释掉,报告永远是绿的,绿到最后开发和产品都不看了。你有没有一套能量化脚本到底稳不稳的标准?他嘴上还在解释,但话越说越慢,最后说,我们平时跑惯了,就手动重跑一遍。还不行就改成人工验证。我说,行,今天先到这里,你回去等 HR 通知吧。他不是不会写脚本,他是把自动化当成了一个跑完就交差的任务,而不是一个要长期被人信任的质量信号。
Speaker 1 00:02:41 800 条用例滤着,可没人知道里面有多少是真跑过的。这就是普通测试和高级测试的分水岭,考的不是你会不会用Selenium,而是你交出去的那份绿色报告,团队敢不敢拿它做发布决策。能把脚本跑起来和能让脚本一直可信,完全是两个技术层次。下面这三层认知缺一不可。第一层,等待与定位策略,拒绝 sleep 满天飞。大多数人一遇到偶发失败就加sleep, 3 秒不行就 5 秒,用力越跑越慢还是照挂。要做的是三件事,一是等待分清楚,隐式等待全局设一次就够,剩下全用显示等待,而且等的是业务状态,不是时间。等元素可点击,等接口返回,等 loading 消失。二是定位有优先级, data- testid 的最优先,其次是 ID 和语义化属性。 CSS 选择器往后排,绝对路径的 XPath 一律禁止,前端改个低危层级,你就全挂。三是跟开发定一个测试属性契约,关键元素必须带稳定标识。这件事要在需求阶段提,别等脚本写完再去求人。第二层数据与环境隔离,拒绝用例互相踩。大多数人一套账号跑到底,用例之间还互相依赖,串行跑没事,一开并行就炸。核心是三条,一是数据自制,每条用例自己造数据,自己清理,绝不依赖别人留下的现场。二是账号池隔离,并发多少就准备多少互不影响的账号。涉及状态变更的用例必须独占。三是用例零依赖,判断标准很硬,随便挑一条单独拎出来跑,也必须能过,过不了就说明他在偷用别人的前置条件。第三层稳定性量化与失败归因,拒绝重跑一遍就好了。大多数人只看一个通过率,跑挂了重跑,绿了就交差。真正该盯的是这几个指标,首次执行通过率,也就是不算重试的那一次。 Flaky 率,同一个版本反复跑。结果时好时坏的用例占多少?平均重试次数,还有误报率,失败率有多少?根本不是产品的问题。每次失败必须打标归因,分五类,产品缺陷、环境问题、数据问题、脚本缺陷、页面变更,不打标就永远不知道该修谁。最后是防假率,禁止裸 try catch 吞异常,失败必须自动留证据,截图、 DOM 快照。
8.5 关键截图
本视频为纯口播形式(主播面对面讲解+字幕),无PPT/架构图/原理图等有价值的结构化截图,故不保留截图。
📄 来源:001_模型评测指标知识点汇总.md(## 二十一、UI 自动化框架选型(Selenium / Playwright / Midscene.js))
8.6 UI 自动化框架选型(Selenium / Playwright / Midscene.js)
8.6.1 先澄清一个概念混淆
你提到的 "Midjourney GS" 应该是 GSD (Get-Shit-Done),AI Agent 编码工作流框架,不是浏览器 UI 自动化库,经常和 Playwright/Selenium 一起搭配做 AI 驱动 UI 自动化,不是平级竞品。
-
Playwright、Selenium 是真正浏览器 UI 自动化框架
-
GSD 是 AI 编程 Agent 工作流系统
-
后续会话又提到 Midscene.js(字节 Web-Infra 团队开源),AI 视觉驱动的 GUI Agent 自动化 SDK
8.6.2 Selenium
底层协议:WebDriver 标准,HTTP 协议与浏览器驱动通信,需要单独管理 driver 二进制文件
语言:Java/Python/C#/JS 等几乎全语言支持
| ✅ 优点 | ❌ 缺点 |
|---|---|
| 1. 行业老牌标准,社区极其庞大,StackOverflow 资料极多;支持 IE11 等老旧浏览器,遗留企业系统唯一选择 | 1. 没有内置自动等待,需要手写大量显式等待,非常容易产生 flaky 不稳定用例 |
| 2. 标准 WebDriver,知识通用性强;可配合 Appium 做移动端真机自动化 | 2. HTTP 通信开销大,速度慢;Selenium Grid 需要自己维护集群,运维成本高 |
| 3. 大量成熟企业老项目历史沉淀,企业存量代码极多 | 3. 进入维护模式,新功能迭代缓慢,新版本浏览器适配经常滞后 |
| 4. 网络拦截、mock、trace 调试需要依赖第三方插件 |
适用场景:遗留老系统(需要兼容 IE11、旧版 Edge);大量存量 Selenium 测试套件(迁移成本极高);移动端真机自动化(搭配 Appium);Java 技术栈传统企业
8.6.3 Playwright(微软开源)
底层:WebSocket,直接调用浏览器 DevTools Protocol,不需要独立 driver,框架自带对应浏览器二进制文件
语言:Python / JS-TS / Java / C#
| ✅ 优点 | ❌ 缺点 |
|---|---|
| 1. 内置 Auto-wait 自动等待,自动校验元素可点击、可见,极大减少 flaky 不稳定用例,不用手写大量 sleep/wait 逻辑 | 1. 不支持 IE11 等古老浏览器 |
| 2. 原生支持 Chromium、Firefox、WebKit (Safari) 一套 API;速度显著快于 Selenium | 2. 第三方插件生态小于 Selenium |
| 3. 原生支持网络拦截 mock、请求修改、截图、录屏、TraceViewer 时间旅行调试;原生支持并行分片执行,开箱即用,不用维护 Grid 集群 | 3. 仅支持浏览器模拟,不支持移动端真机(只能模拟视口) |
| 4. 微软持续高频迭代维护,浏览器版本同步更新,AI Agent 网页自动化现在主流选择 | 4. 老的 Java 技术栈企业存量少 |
适用场景:全新 UI 自动化项目(2026 主流首选);SPA 现代前端、React/Vue 项目,大量异步渲染页面;CI 流水线 E2E,追求稳定、少不稳定用例;AI Agent 网页浏览、爬虫自动化
8.6.4 Midscene.js(字节 Web-Infra 开源,AI 视觉驱动 GUI Agent)
不是底层浏览器驱动;
底层依赖 Playwright / Puppeteer / ADB
,上层做视觉定位,用自然语言描述操作,不用写 CSS/XPath 选择器。
核心底层原理:
-
底层调用 Playwright 做页面跳转、截图
-
把截图 + 自然语言指令发给多模态 VL 模型
-
模型输出屏幕坐标、操作类型(点击、输入、断言)
-
将坐标传给 Playwright 执行真正页面操作
-
采集结果,生成可视化报告,支持缓存优化重复任务
传统 Playwright/Selenium 靠 DOM 选择器找元素;Midscene 看截图找元素,DOM 结构变了脚本不一定会挂,<canvas>、图标按钮、自定义渲染控件也能操作。
| ✅ 优点 | ❌ 缺点 |
|---|---|
| 1. 不需要维护 selector/xpath,页面重构、class 改名脚本不容易失效,维护成本大幅下降 | 1. 依赖视觉大模型,会产生 AI 随机性:相同页面偶尔定位偏移、点错位置,存在 flaky 不稳定问题 |
| 2. 支持 Canvas、WebGL、原生 App(Android),DOM 拿不到的控件也能操作 | 2. 每一步要调用 VL 模型,执行速度慢,有 token 消耗、模型调用成本 |
| 3. 自然语言编写用例:aiTap ("蓝色登录按钮"),非开发人员也可以写 YAML 用例 | 3. 不适合大规模高频回归测试,全量用 Midscene 跑完整测试套件成本很高 |
| 4. 多模型兼容:豆包 Seed-VL、Qwen-VL、Gemini、UI-TARS,支持私有化部署模型 | 4. 底层仍然依赖 Playwright;浏览器能力受限于底层驱动 |
| 5. 自带可视化报告、回放调试,支持 MCP 协议,可被 AI Agent 直接调用 | 5. 复杂页面、元素密集界面,视觉定位准确率下降 |
8.6.5 三者完整对比表
| 框架 | 定位 | 定位原理 | 优点 | 缺点 | 主流适用场景 |
|---|---|---|---|---|---|
| Selenium | 底层浏览器驱动库 | DOM/XPath/CSS 选择器,WebDriver HTTP 协议 | 生态庞大,兼容 IE,支持 Appium 移动端真机 | 不稳定,需要手写大量等待,速度慢 | 遗留老项目,Java 栈企业存量用例 |
| Playwright | 底层浏览器驱动库 | DOM/XPath/CSS 选择器,CDP-WebSocket | 自动等待,速度快,调试 TraceViewer,原生并行 | 依赖 DOM 结构,页面一改选择器容易失效 | 新项目 E2E 回归测试首选 |
| Midscene.js | AI 视觉上层 SDK,依赖 Playwright/Puppeteer | 截图 + VL 视觉模型输出屏幕坐标 | 不用维护选择器,支持 Canvas / 原生 App,抗页面重构 | 速度慢、有模型调用开销、存在 AI 随机性 | 页面频繁重构、Canvas 控件、原型快速验证、AI Agent 网页操作;不建议全量回归直接替代 Playwright |
8.6.6 2026 行业现状与选型决策口诀
2026 现状:
-
新项目、绿场项目:Playwright 是当前行业主流首选,调研数据显示新项目采纳率已经超过 Selenium;flaky 用例少、开箱即用、调试能力强是核心优势
-
存量老项目:大量企业还在继续使用 Selenium,尤其传统金融、政务系统,需要兼容老旧浏览器,历史代码迁移成本巨大
-
GSD 不会单独拿来做 UI 自动化,它是上层 AI 工作流,底层还是要依赖 Playwright/Selenium
选型决策口诀(面试背诵):
-
全新 Web E2E 自动化,优先选 Playwright
-
需要 IE11、老浏览器、大量历史 Selenium 代码、移动端真机,选 Selenium
-
如果要让大模型自动生成、调试自动化脚本,在底层自动化库之上叠加 GSD 这类 Agent 工作流
-
DOM 难以定位(Canvas / 自定义控件),局部引入 Midscene.js;不要整体替换 Playwright
三者层级关系:
上层业务脚本

    ↓

Midscene.js(视觉AI层,选元素)

    ↓

Playwright(浏览器底层,执行点击输入截图)

    ↓

浏览器内核
面试一句话总结:
"Selenium 是行业老牌标准,存量巨大,但容易产生不稳定用例;Playwright 为现代 web 应用而生,自动等待、调试能力强,新项目现在普遍优先选择 Playwright;Midscene.js 是 AI 视觉上层 SDK,解决选择器脆弱问题,但受限于大模型能力,适合局部增强,不适合直接做全套回归测试。GSD 属于上层 AI Agent 工作流,不是浏览器自动化底层库。"
📄 来源:001_模型评测指标知识点汇总.md(## 二十二、Flaky 不稳定测试用例详解)
8.7 Flaky 不稳定测试用例详解
8.7.1 定义
Flaky(不稳定用例):同一个自动化测试用例,代码、被测系统没有任何改动,反复跑,时而 Pass、时而 Fail。
同样的代码,CI 跑 10 次:6 次过,4 次莫名其妙失败。没有修改被测代码、没有修改测试脚本,结果随机波动,这就是 flaky。
不是业务真的 bug,是自动化本身的问题,非常折磨 E2E UI 自动化。
8.7.2 关键区分
| 类型 | 特征 |
|---|---|
| 真正 Bug | 每次跑都失败,10 次 10 次 Fail,代表系统有问题 |
| Flaky | 时而成功时而失败,间歇性失败,复现很难 |
8.7.3 底层产生原因(UI 自动化场景)
-
时间 / 同步问题(最高频):页面异步渲染(Vue/React),网络请求、接口返回、DOM 渲染、动画还没完成,脚本就去点击、读取元素。Selenium 没有自动等待,很多人写固定 sleep (2000)。网络慢时 2 秒不够 → 失败;网络快时 2 秒够用 → 成功。这就是典型 flaky 来源。Playwright 的 auto-wait 专门解决这个:执行操作前自动等待元素可见、可点击
-
元素定位歧义:选择器匹配到多个元素,脚本随机拿到其中一个。比如页面有多个 .btn-submit,DOM 查询返回数组,有时候拿到第一个,有时候拿到第二个,时而对时而错
-
测试用例之间互相污染(状态污染):用例 A 跑完,弹窗、缓存、localStorage、登录态没有清理干净;用例 B 执行时页面状态不对。顺序跑全部用例容易 flaky;单独跑某一条用例每次都正常
-
环境、网络波动:CI 机器性能差、网络抖动,接口响应忽快忽慢;页面加载时快时慢。本地跑一切正常,CI 流水线频繁 flaky,这是 UI 自动化非常经典现象
-
动画、过渡动画、弹窗遮罩:按钮还在做淡入动画、被遮罩层盖住,脚本直接去点击,报元素不可点击。偶现失败
-
Midscene.js 这类 AI 视觉自动化特有 flaky:VL 视觉模型识别不稳定,同一个截图偶尔识别错按钮坐标,点错地方,间歇性失败。这是 AI 自动化带来新一类 flaky
8.7.4 Flaky 的危害
-
CI 流水线不可信:CI 变红,你分不清是业务真出 Bug,还是单纯 flaky
-
团队慢慢麻木,看到失败就直接重跑流水线,真正的线上 bug 被漏掉
-
大量时间浪费在排查间歇性问题;很难稳定复现,定位 bug 非常痛苦
-
很多团队最后对 flaky 用例直接加重试,治标不治本,掩盖根本问题
8.7.5 各个框架怎么应对 flaky
| 框架 | 应对方式 |
|---|---|
| Selenium | 没有内置自动等待。必须手写显式等待 WebDriverWait,禁止写死 sleep。缺点:全靠工程师写代码,漏写一处就会产生 flaky |
| Playwright | 内置 Auto-wait:调用 page.click ()、fill (),内部自动等待:元素存在、可见、没有被遮挡、可点击,超时时间内不满足直接报错。能干掉 80% 以上时间类 flaky,但不能解决状态污染、环境问题带来的 flaky |
| Midscene.js(AI 视觉) | 无法彻底消除 flaky;根源是 VL 模型输出存在随机性。只能增加重试、调高截图质量、增加断言校验缓解,不能根除 |
行业常见错误做法(不推荐):用例失败直接加重试机制,失败自动跑 2-3 次。短期看起来 CI 绿了;但是把 flaky 问题掩盖,问题越积累越多。最佳实践:优先修复根源,重试只作为兜底手段,不能当成主要解决方案。
面试背诵短句:
"Flaky 测试就是同一个测试用例,被测代码和脚本都没有改动,但是执行结果时而成功时而失败。大多来自异步渲染、等待逻辑缺失、状态污染、环境网络抖动。Selenium 容易出现 flaky,Playwright 的 auto-wait 机制可以消除大部分时间相关的不稳定,但无法解决状态污染这类问题。AI 视觉驱动的自动化还会引入模型随机性带来的 flaky。"
📄 来源:001_模型评测指标知识点汇总.md(## 二十三、Flaky 的量化表达 & pass@k 概念区分)
8.8 Flaky 的量化表达 & pass@k 概念区分
8.8.1 问题背景
一开始问 "Flaky 能用 pass@10=40% 这样来表达吗?",随后用户指出 "pass@k 是 k 次里有一次通过就算 OK",两者确实混淆了。以下是完整纠正。
8.8.2 pass@k(LLM 代码生成标准指标,HumanEval 原始定义)
标准定义:对于一个问题,独立采样 k 个模型输出;k 个里面只要任意 1 个通过测试,这个任务就记为成功。最后统计全部问题中成功任务的占比。
-
pass@1:采样 1 个,这个样本要正确才算成功。等价于单次采样正确率
-
pass@10:采样 10 个不同结果,只要 1 个能跑通,任务就算过
数学无偏估计公式:
$pass@k = 1 - \frac{C(n-c, k)}{C(n, k)}$
- n = 总采样数,c = 其中正确样本数,k = 允许抽取的候选数量
举例:某道题跑 10 次生成,7 次失败,3 次成功。pass@10 ≈ 1,只要 10 个里面碰得到 1 个正确,任务就视为解决。
⚠️ 关键:pass@k 不是统计 k 次运行中成功的占比,不是 4/10=40%。 pass@10=40% 的含义是:40% 的题目,在 10 个采样候选中至少存在 1 个正确解,不是跑 10 次 4 次过。
8.8.3 那 flaky UI 测试那套 "跑 10 次 4 次过" 该叫什么?
这个叫 per-run pass rate(单轮执行通过率)。
-
用例重复执行 10 次,4 次通过:per-run pass rate = 40%
-
flaky_rate = 1 − per-run pass rate
-
❌ 错误:把 flaky 的单轮通过率写成 pass@10=40%,属于概念混用。pass@k 面向多候选采样;flaky 重复执行是同一个用例反复执行
8.8.4 两者本质场景差异
| 指标 | 场景 | 含义 |
|---|---|---|
| pass@k | LLM 代码生成,生成 k 份不同候选代码 | k 份候选里至少 1 份正确,任务就算成功,衡量模型上限,允许反复采样重试拿结果 |
| per-run pass rate | Flaky UI 自动化,反复执行同一套脚本 | 每一轮执行,成功 / 失败;统计每一轮执行成功的比例;衡量脚本本身的稳定性 |
直观对比:
-
pass@10:我让 AI 生成 10 段不同代码,只要其中 1 段能跑,任务搞定。不在乎另外 9 段全烂
-
flaky per-run pass rate=40%:完全同一套脚本,跑 10 遍,4 遍跑通,6 遍随机挂。每一轮都是一模一样的脚本
8.8.5 工程上经常出现的混淆(面试高频坑)
很多做 AI-Agent UI 自动化的工程师,会口语把 "用例重复跑 k 次的成功率" 随口叫 pass@k,这是口语误用,不是学术原始定义。
-
论文、标准评测报告,严格区分两者
-
内部工程文档可以口语混用,但面试说的时候要分清
面试标准回答:
"pass@k 来自代码生成评测,对每个问题采样 k 个独立候选,只要 k 个里面至少 1 个正确,任务就算通过,衡量模型多次采样后的能力上限。而 flaky 测试,同一个脚本重复跑 10 次,4 次通过,这个指标叫单轮执行通过率 per-run pass rate,不要写成 pass@10。工程上很多人会口语混用,但二者定义不一样。"
8.8.6 补充:如果坚持用 pass@k 描述 flaky(原始对话曾出现的表述,仅供理解)
⚠️ 以下为会话早期 "错误但常见的工程量化口吻",随后已被纠正,
正式表达请以 23.2-23.5 为准
。
-
pass@k 表示 "同一个用例重复执行 k 次,成功的占比"(此为口语化误用)
-
flaky_rate = 1 − pass@k
-
pass@k=100%:完全稳定;0 < pass@k <100%:典型 flaky;pass@k=0%:必现 bug 不属于 flaky
-
指标必须带上 k(pass@10=40% ≠ pass@100=40%);k 一般取 5-20 保证统计置信度
9 测试开发(SDET)面试全合集:手撕代码 + AI-Coding + 口述模板
来源:豆包分享链接《测试开发面试口述完整模板(2套高频真题)》整理 链接:https://www.doubao.com/thread/xqtXE0MBffXTgxQtC 适配:北京 / 上海大厂、中厂;校招 / 实习、1-3 年社招、8-12 年高级社招;语言默认 Python。 说明:页面内容由 AI 生成,不能完全保障真实,请结合自身实际核实。文档整合了全部面试题、参考答案、口述模板、QA 问答与进阶内容。
10 第一部分:面试现状与准备策略
10.1 手撕代码 vs AI-Coding 面试现状(北京 / 上海大厂 & 中厂,2026)
核心结论:传统手撕算法没有被取消,是双轨并行;不是全部换成 AI 编码模式,不同公司、不同业务组差异巨大。测开(SDET)相比后端开发,算法难度整体会更低,但编程考察依然是硬性门槛。
10.2 三种面试流派(测开岗位)
10.2.1 ① 保守派(占比最高:字节大部分测开、腾讯、拼多多、多数中厂)
- 仍然传统手撕代码(白板 / 在线 coding 编辑器),面试环节禁止使用外部 AI 工具。
- 测开算法难度:中等难度为主,链表、字符串、哈希、二分、简单滑动窗口,极少硬核 DP。
- 社招:一般 1 道算法题;校招实习:1-2 道算法题。
- 考察重点:边界处理、复杂度分析、写可运行 Python 代码,不是考脑筋急转弯。
- ⚠️ 注意:牛客 OA 笔试系统有切屏检测,笔试阶段不能开 ChatGPT/Cursor,会判定作弊。
10.2.2 ② 过渡派(阿里、美团部分业务组、部分 AI 相关测开)
保留手撕算法,同时新增 AI-Coding 类场景题,两种都会出现。典型 AI-coding 测开题型: - 给一段 AI 生成的自动化脚本,让你找 bug、改缺陷、补测试用例; - 给定业务需求,让你描述:你会怎么写 prompt,指挥 AI 生成测试脚本,然后你如何 review、校验 AI 产出; - 场景:用 AI 生成接口自动化,但是 AI 代码有漏洞,你识别风险。
⚠️ 这里不是让 AI 直接把答案全部生成交差。面试官重点看:你能不能识别 AI 幻觉、缺陷,而不是看 AI 写得多快。
10.2.3 ③ 开放拥抱派(AI 公司、大模型评测测开岗,数量不多)
- 面试明确允许使用 AI 工具,模拟真实工作流;
- 面试官给业务需求,允许你用 Copilot/Claude,重点考察:需求拆解、prompt 编写、审查 AI 输出、修正错误、补全测试用例。
- 普通互联网业务测开岗位,这种模式目前还不是主流。
10.3 非常关键的误区澄清
- ❌ 网传"大厂全部不手撕,全部改成 AI-coding"是过度传播的谣言。
- AI-Coding 更多是新增的考察维度,不是替换掉手撕算法。
- 只有大模型相关业务线(大模型评测、AI 测试),AI 协作的权重会明显更高;普通业务测开,算法手撕依然是筛选门槛。
- 中厂(二线互联网):绝大多数仍然以传统手撕代码为主,几乎没有 AI-coding 面试环节。
10.4 测试开发岗位两种考察的本质区别
| 考察模式 | 考察核心 | 真实工作映射 |
|---|---|---|
| 传统手撕算法 | 基础逻辑、数据结构、边界处理,确认你看得懂、写得出基础代码 | 遇到简单脚本、小工具,自己独立编码能力 |
| AI-Coding 协作题 | 需求拆解、prompt 能力、代码评审、识别 AI 幻觉 bug | 日常工作中大量使用 AI 辅助写自动化脚本、工具代码 |
现实工作中测开确实天天用 AI 写脚本,但面试的时候,面试官依然需要确认:如果 AI 给错代码,你有能力识别错误,而不是完全依赖 AI。
10.5 校招 vs 社招差异
- 校招 / 实习:手撕算法权重更高,很多组必写算法;部分大厂笔试加入 AI 编码场景题。
- 社招(1-3 年测开):算法题会减少,题目难度降低,更偏向工程脚本题(写接口请求、解析日志、数据处理脚本),会夹杂 AI 协作相关的业务提问。
10.6 备考建议(双轨准备)
- 不能直接放弃刷 LeetCode,基础链表、字符串、哈希表、二分要练;测开不用死磕高难度 DP。
- 额外准备 AI-coding 方向:
- 练习:AI 生成一段自动化脚本,你人工 review,找出缺陷、边界漏洞;
- 想清楚:拿到测试开发需求,你会如何写 prompt,如何校验 AI 输出结果。
- 面试前可以反问面试官:"编码环节是否允许使用 AI 辅助工具?",提前确认规则。
📄 来源:003_测试开发面试全合集.md(# 附录 C:测开面试核心加分点速记)
11 附录 C:测开面试核心加分点速记
| 场景 | 加分表达 |
|---|---|
| 所有算法题 | 先讲思路 → 再写代码 → 讲边界 → 口头跑样例 |
| 工程脚本题 | 强调 try-except 容错、脏数据跳过不崩溃 |
| JSON diff | 集合做差集(O(n));追问再讲递归方案 |
| 重试装饰器 | 不吞全部异常、参数校验、耗尽抛原始异常、wraps |
| 非幂等接口 | 主动提出"写接口慎用重试,会产生脏数据" |
| 高级社招 | 主动讲 trade-off、大数据约束、并发安全、可观测性、方案局限性 |
| AI-coding 题 | AI 是辅助,人做评审、校验、补边界;识别 AI 幻觉 |
| 笔试 OA | 切屏检测,禁止使用 AI 工具 |
整理说明:本文档整合自豆包分享链接《测试开发面试口述完整模板(2套高频真题)》的全部内容,包括:面试现状分析、三种面试流派、误区澄清、刷题清单、AI-Coding 模拟面试样题、面试口述模板、测开手撕真题(合并区间、日志解析、JSON diff、重试装饰器)、一页纸速记版、10 年高级测开面试考察、手撕代码全合集(初级 8 题 + 高级 6 题,含逐行注释与追问)。页面原内容由 AI 生成,不能完全保障真实,请结合实际情况使用。
12 A/B 测试与灰度测试:区别、机制与工程实践
📎 内容来源:豆包会话知识整理(2026-09-13),结合行业通用实践。
12.1 一句话先记住
- 灰度测试(Canary / 灰度发布)是「发布策略」:把新版本先放给一小部分流量/用户,验证没问题再逐步放量到全量——解决的是「怎么把新版本安全地上线」。
- A/B 测试(A/B Test / 实验)是「决策工具」:同一时刻让不同用户看到不同方案(A 版 / B 版),对比关键指标,用数据决定「哪个方案更好、要不要全量推」——解决的是「改还是不改、按哪个方案改」。
一句话:灰度管「上线过程安不安全」,A/B 管「方案本身好不好」。灰度是发布工程,A/B 是增长/产品决策工程。
12.2 核心区别对照表
| 维度 | A/B 测试 | 灰度测试 |
|---|---|---|
| 本质 | 随机对照实验(实验设计) | 渐进式发布(发布工程) |
| 回答的问题 | 方案 A 和 B 哪个指标更好? | 新版本能不能安全地逐步放量上线? |
| 对象 | 方案/策略/页面/算法(多个变体并存) | 新版本代码/配置(一个目标版本) |
| 时间特征 | 同一时间段内并存对比 | 按时间先后逐步放量(5%→20%→50%→100%) |
| 用户分桶 | 随机分流(hash 分桶),组间可比 | 按百分比/地域/渠道/名单放量,不需严格随机 |
| 样本要求 | 需统计显著性(样本量估算、置信区间、p 值) | 无需显著性,看错误率/核心指标阈值即可 |
| 判定标准 | 实验指标(转化率/留存/收入)达到显著差异 | 发布指标(错误率/延迟/崩溃率/告警)无恶化 |
| 决策出口 | 全量推 A / 推 B / 继续迭代(实验报告) | 放量下一档 / 暂停 / 回滚(发布决策) |
| 回滚 | 关掉实验即可恢复旧版(实验本身就是开关) | 一键回滚到上一版本(回滚预案) |
| 归属团队 | 增长/产品/数据科学(决策) | 研发效能/稳定性/SRE(工程) |
| 典型场景 | 新首页文案、推荐算法、定价策略、UI 改版 | 新服务版本发布、数据库迁移、架构升级 |
12.3 A/B 测试的工程要点
- 随机分桶(Hashing):用户 ID 用一致性 hash 分到 A/B 桶(如
hash(uid) % 100),保证同一用户稳定落在同一组、组间样本量均匀;实验之间要正交(分层分桶),避免两个实验互相污染。 - 样本量估算:根据基线转化率、期望提升幅度(MDE)、显著性水平 α(通常 0.05)、统计功效 1-β(通常 0.8)估算所需样本量;样本不够就下不了显著结论。
- 显著性判定:用 t 检验 / z 检验看 p 值 < 0.05 才认为差异显著;不能只看「A 比 B 高了 1%」就下结论(可能只是随机波动)。补充置信区间与效应量。
- AA 测试 / 防偏置:正式实验前先跑 AA 实验验证分流无偏;关注组间基线是否一致(用户构成、时段、新老占比)。
- 叠加效应与时段效应:A/B 与灰度可叠加(灰度放量过程中同时开 A/B);避开大促/节假日等干扰时段,实验周期要覆盖完整业务周期。
- 指标看板与归因:一个实验只改一个变量(控制变量),盯主指标 + 护栏指标(如改转化率不能砸了留存),防辛普森悖论(分组看 vs 总体看结论相反)。
12.4 灰度测试的工程要点(与稳定性三板斧联动)
- 灰度分层:常见分层——①按比例(5%→10%→25%→50%→100%);②按内部用户/白名单(先内部狗粮);③按地域/渠道/客户端版本;④金丝雀(Canary)小流量试点。
- 每档放量的准入条件(门禁):上一档的错误率、P99 延迟、崩溃率、核心接口成功率、告警数量在观察窗口内达标才放下一档;不达标则暂停/回滚。
- 灰度期间的全链路监控:业务指标(下单成功率)+ 技术指标(错误率/延迟)+ 基础设施指标(CPU/内存/GC)三张表同时盯;灰度是监控的「实弹演练」。
- 回滚预案前置:灰度上线前必须写好回滚 SOP(回滚命令、回滚影响面、回滚验证);「可灰度、可监控、可回滚」三板斧缺一不可。
- 灰度与 A/B 的关系:实践中常叠加使用——灰度控制「版本流量的节奏」,A/B 在灰度流量内对比「新旧策略的效果」,灰度放量决策可以参考 A/B 结论。
12.5 面试回答模板(30 秒版本)
「灰度测试和 A/B 测试本质不同:灰度是发布策略,解决新版本怎么安全上线,按流量百分比渐进放量、每档看错误率和核心指标、不达标就回滚;A/B 是实验设计,解决方案哪个更好,随机分流、对比指标、算显著性再决策。实践中两者叠加用——灰度管发布节奏,A/B 管方案取舍,灰度放量时参考 A/B 的显著性结论决定全量还是回滚。」
12.6 常见追问
- 「灰度失败怎么判定?」→ 看门禁指标(错误率/延迟/核心链路成功率/告警)是否超过阈值,而不是看业务好坏;业务好坏是 A/B 的活。
- 「A/B 样本量怎么算?」→ 基线率 + MDE + α + 1-β 四个参数代入公式估算;样本不足可以延长周期或降低 MDE。
- 「灰度期间用户反馈不好要不要停?」→ 反馈类问题走监控/舆情通道,量化成指标后再决策;灰度本身的决策依据是技术指标为主、业务指标为辅。
13 Playwright / Web UI 自动化工程落地全景
📎 内容来源:豆包会话知识整理(2026-09-13)+ 行业实践调研(Playwright 官方 Agent CLI Skills、Midscene.js、Claude Playwright MCP 等公开资料)。
13.1 落地路径:从「写脚本」到「平台化」四阶段
| 阶段 | 做什么 | 关键产出 | 典型坑 |
|---|---|---|---|
| 0 选型 | 确定框架(Playwright / Selenium / Cypress)+ 语言(TS/JS 首选) | 技术选型文档 | 被历史包袱拖住(老项目还在用 Selenium) |
| 1 基建 | 搭工程:Page Object 模式、fixtures、CI 接入、Allure 报告 | 测试工程脚手架 | 没有 PO 模式,用例间大量重复选择器 |
| 2 稳定性 | 等待策略、自动重试、数据隔离、失败截图/录屏、flaky 治理 | 稳定性专项 | flaky 用例没人管,越积越多 |
| 3 规模化 | 用例分级(冒烟/回归/全量)、并行分片(Sharding)、测试环境管理 | 分级流水线 + 并行报告 | 用例太多跑不动,CI 排队 |
| 4 平台化/AI化 | 用例平台、AI 生成用例、AI 视觉定位、自然语言驱动 | 测试平台 + AI 测试能力 | AI 生成的用例质量不可控 |
13.2 要不要创建 Skill?——要,而且这是落地的关键动作
结论:UI 自动化落地一定要把方法论固化成 Skill/能力资产,理由:
- Skill 把「经验」变成「可复用资产」:测试稳定性的坑(选择器脆弱、等待不稳、数据污染)是反复踩的,固化进 Skill 后每次生成用例自动规避,不靠个人记忆。
- Skill 是「人机协作的接口」:AI 负责生成/维护用例,Skill 承载「该公司/该项目的测试规范」(选择器命名、PO 分层、断言写法、数据构造),AI 按规范产出,人来评审。
- Skill 让「AI 生成用例」从玩具变工程:没有 Skill 约束,AI 生成的用例风格漂移、断言脆弱、无法维护;有 Skill 后有结构契约 + 校验门禁(见第 14 章的 test-master-improve 思路)。
- 落地难点(稳定性/维护性)的本质是「知识没有沉淀」:把难点对应成 Skill 的规则(如「禁止硬编码等待」「必须用 getByRole 语义定位」「失败必须带截图」),难点自动缓解。
落地 Skill 的推荐形态(参考用户自建 skill 体系):
| Skill | 职责 | 对应落地难点 |
|---|---|---|
| UI 测试方法论 Skill | 测试规范 + 稳定性铁律 + 反模式 | 稳定性、维护性 |
| 用例设计 Skill | 从 PRD/需求生成结构化用例(XMind/MD) | 覆盖率、需求遗漏 |
| 执行框架 Skill | 把用例落成可执行 pytest/Playwright 代码 | 从设计到执行的沟 |
| 环境配置 Skill(如 midscene-env-config) | 模型/环境变量配置沉淀 | 环境问题反复排 |
13.3 落地难点与克服方法(面试重点)
| 难点 | 具体表现 | 克服方法 |
|---|---|---|
| 选择器脆弱 | 前端改 class/结构,脚本全挂 | ①语义定位(getByRole/getByLabel/getByText,按可访问性而非 DOM);②Page Object 集中管理;③AI 视觉定位(Midscene:看截图不读 DOM,改版自适应) |
| 等待不稳(flaky) | 偶发失败,重跑又过 | ①智能等待(expect 自动重试)替代 sleep;②固定重试 + 失败分类(断言失败 vs 环境失败);③隔离/修复 flaky,不许「重跑到绿」 |
| 测试数据污染 | 用例间共享数据导致顺序依赖 | ①每条用例自包含数据(API 造数/独立账号);②数据库清理策略;③数据驱动与代码解耦 |
| 环境不稳定 | 依赖服务挂了导致误报 | ①mock 外部依赖;②环境健康检查前置;③测试环境分级(本地 Mock/CI/Staging) |
| 用例爆炸维护成本高 | 用例多、重复多、没人敢改 | ①用例分级(冒烟/回归/全量);②PO 模式消除重复;③AI 生成 + 人评审;④用例即文档(命名可读) |
| CI 集成难 | 跑得慢、不稳定、阻塞发布 | ①并行分片(Playwright Sharding);②失败重试 + 报告(Allure);③作为质量门禁但不阻塞紧急发布(分级门禁) |
| 报告不可读 | 失败只有堆栈,不知道哪错了 | ①失败自动截图 + 录屏 + DOM 快照;②Allure 结构化报告;③错误信息带「路径/实际值/期望值」 |
13.4 当前业内有代表性的 Web/UI 自动化 Skill 与方案(2026-09 调研)
| 方案 | 类型 | 特点 | 适用 |
|---|---|---|---|
| Playwright 官方 Agent CLI Skills(playwright.dev/agent-cli/skills) | 官方 Skill | 教 coding agent 用 playwright-cli:跑/调试测试、请求 mock、执行脚本、管理浏览器会话 | 让 Claude/Cursor 等 agent 直接驱动 Playwright 做测试 |
| Claude Playwright MCP(claude.com/plugins/playwright) | MCP 插件 | 通过可访问性树(accessibility tree)驱动浏览器,不依赖视觉模型,确定性高、轻量 | Claude 生态内的浏览器自动化/测试 |
| playwright-skill(skillmd.ai / claudedirectory 社区版) | 社区 Skill | 自动检测 dev server、写干净测试脚本到 /tmp、覆盖表单/截图/响应式/登录流 | Claude Code / Cursor 里快速做浏览器验证 |
| devel-jb-playwright(agentskills.codes) | 社区 Skill | CLI 封装 Playwright:快照、交互、产物捕获 | 轻量浏览器自动化 |
| Midscene.js(midscenejs.com,web-infra-dev 开源,14k+ ⭐) | GUI Agent 框架 | 视觉驱动:不读 DOM 只看截图,用自然语言描述操作,AI 定位并执行;支持 Web/移动端/桌面端;可与 Playwright 集成(PlaywrightAgent) | 端到端 UI 测试,选择器维护痛点场景 |
| 字节内部方案(公开实践) | 方案组合 | Midscene.js + TRAE+MCP 生成/维护测试代码 + UI-TARS 视觉底座,统一融入内部 AI 测试基础设施 | 把「写脆弱的代码」变成「描述意图让 AI 适应变化」 |
| browser-use / computer-use 类 Skill(如本项目 browser-use-automation-mac) | 通用浏览器自动化 | 面向 agent 的页面导航、点击、表单、截图、下载,ref-first 观察-行动循环 | Agent 类产品自身测试/巡检 |
13.5 AI 时代 UI 自动化新范式(面试升华点)
- 从「写选择器」到「描述意图」:传统 UI 自动化是「定位器 + 操作」的命令式;AI 时代是「自然语言描述意图 + AI 视觉/语义理解 + 自动定位执行」的声明式。
- 两条技术路线: - 可访问性树路线(Playwright MCP / getByRole):快、确定性高、不需要视觉模型,但依赖页面可访问性质量; - 视觉模型路线(Midscene.js / UI-TARS):只看像素、跨端通用、改版自适应,但慢、贵、依赖视觉模型能力。
- 稳定性的新解法:视觉定位天然免疫「改 class 名就挂」;语义定位免疫「纯 DOM 结构变动」;两者结合 + 智能等待,把维护成本从「每次发版改脚本」降到「AI 重新理解页面」。
- Skill 化的价值:把「公司测试规范 + 稳定性铁律 + 环境配置」固化进 Skill,AI 生成用例时自动遵守——这是「传统测试 × AI」在 UI 自动化的落点。
14 传统测试 × AI 重塑:三个 Skill 的落地实践与方法论拆解
📎 内容来源:精读
/Users/user/workspace/gopath/src/ai.changjovan.com/skills/testing/下 test-master、test-master-improve、api-automation 三个 Skill 的 SKILL.md 与 references 整理(2026-09-13)。
14.1 总体定位:三个 Skill 的分工体系(一条流水线)
| Skill | 定位 | 解决的问题 | 输入 → 输出 |
|---|---|---|---|
| test-master(父级,社区版) | 通用测试方法论与测试代码生成 | 单测/集成/E2E/性能/安全的「怎么测」通用规范 | 需求/代码 → 测试策略、测试代码、缺陷报告 |
| test-master-improve(子级,自研) | 结构化用例设计(XMind/MD)+ 质量门禁 | 「用例设计靠脑图、无结构契约、质量靠感觉」 | PRD/Spec/设计稿/历史用例 → test-plan.md + test-cases.md/.xmind |
| api-automation(执行侧,自研) | 用例执行自动化(接口测试套件) | 「用例设计和测试代码之间的沟」 | test-cases.md(脑图)→ 可运行 pytest 套件 + Allure 报告 + 覆盖率报告 |
一句话:test-master 定「测什么、怎么测」的通用方法论;test-master-improve 把需求「翻译」成有结构契约、有质量门禁的用例;api-automation 把用例「落」成可执行、可报告、可度量的测试。三者串成「需求 → 用例设计 → 执行 → 报告」的端到端流水线。
14.2 test-master:通用测试方法论 Skill
14.2.1 结构
test-master/
├── SKILL.md                  # 96 行:核心工作流 + 快速示例 + 约束 + 输出模板
└── references/               # 10 个按需加载的专题文档
    ├── unit-testing.md       # 单元测试(Jest/Vitest/pytest 模式)
    ├── integration-testing.md# 集成/API 测试(Supertest)
    ├── e2e-testing.md        # E2E 策略与用户流(Playwright 示例)
    ├── performance-testing.md# 性能测试(k6/Artillery)
    ├── security-testing.md   # 安全测试清单(OWASP)
    ├── test-reports.md       # 报告模板
    ├── qa-methodology.md     # 手工测试/质量倡导/shift-left
    ├── automation-frameworks.md # 框架模式/扩展/维护/团队赋能
    ├── tdd-iron-laws.md      # TDD 铁律(red-green-refactor)
    └── testing-anti-patterns.md # 测试反模式清单
14.2.2 原理与实现方法论
- 场景化触发 + 按需加载(Progressive Disclosure):description 声明 triggers(test/QA/E2E/coverage/performance…),命中后只加载当前场景对应的 reference(写单测加载 unit-testing,做性能加载 performance-testing)——上下文省、知识不丢。
- 核心工作流 5 步闭环:①Define scope(测什么)→ ②Create strategy(怎么测)→ ③Write tests(写断言)→ ④Execute(跑,失败分类:断言失败 vs 环境/flaky)→ ⑤Report(带严重度分级 Critical/High/Medium/Low + 修复建议 + 覆盖缺口显式标注)。
- 约束即规范(MUST DO / MUST NOT):正向铁律(happy path + 错误路径都要测、mock 外部依赖、断言具体值而非 truthy、CI 中跑)与反模式禁令(不许只测成功分支、不许用生产数据、不许顺序依赖、不许忽略 flaky、不许测实现细节)——这些是「AI 生成测试质量」的第一道护栏。
- 借鉴价值:这是「AI 写测试」的通用底座——AI 默认会漏错误路径、会测实现细节,用 MUST/MUST NOT 显式约束 + 反模式清单,把 AI 的「概率性正确」拉到「规范内正确」。
14.3 test-master-improve:结构化用例设计 + 质量门禁(方法论核心)
14.3.1 结构
test-master-improve/
├── SKILL.md                  # 708 行:设计原则/工作流全景/Core Rule/校验矩阵/方法论演进
├── README.md                 # 951 行:完整设计文档
├── tools/                    # 15 个确定性校验/转换脚本(核心资产)
│   ├── validate_risk_strategy.py  # G1 方案一致性门禁
│   ├── validate_xmind_md.py       # G2 层级结构门禁
│   ├── validate_tc_id.py          # G3 TC-ID 编号门禁
│   ├── validate_risk_coverage.py  # G4 风险→用例覆盖门禁
│   ├── validate_assertion.py      # G5 L4 断言护栏门禁
│   ├── snapshot_baseline.py       # 基线快照
│   ├── xmind2md.py / md2xmind.py  # XMind ↔ MD 互转
│   ├── measure_adoption.py        # 采纳率统计
│   ├── learn_from_cases.py        # 历史用例学习
│   ├── review_cycle.py            # 评审闭环(直读 xmind + 采纳率 + 学习)
│   ├── synthesize_learning.py / commit_principles.py  # 原则沉淀
│   ├── md2html.py                 # Markdown → 自包含 markmap HTML 脑图
│   └── validate_risk_coverage.py / validate_risk_strategy.py / validate_assertion.py
├── references/               # 方法论详解(test-case-quality-methods.md 680 行是核心)
├── history_case/             # 自学习语料库(业务知识 + 用户风格 + 案例索引)
└── samples/ examples/        # 完整示例
14.3.2 核心原理与好思想(面试价值最高的部分)
-
设计铁律:「帮用户做他不想做的繁琐事」:凡能自动代劳的(读文件、跑脚本、对比、归档、沉淀学习)默认自动做,唯一例外是不可逆写入需用户确认。三个用户介入节点(方案审阅 A / 用例审阅 B / 原则沉淀 C)之外零打扰。
-
产物结构契约(Core Rule,NON-NEGOTIABLE):XMind 树严格四级父子——
用例名称 → 前置条件 → 操作步骤(可嵌套)→ [优先级]TC-ID + 预期结果(合并叶子)。反模式:ID 独立成节点、三者写成兄弟、操作步骤下禁嵌套。这是「AI 生成结果的确定性约束」——结构不靠 AI 自觉,靠契约 + 脚本校验。 -
测试方案先行(test-plan.md 推理链骨架):先写方案后写用例。方案按推理链组织:
##1 源信息溯源(测的是哪个版本)→ ##2 需求分析(§2.1 REQ 全集 ↔ §2.2 需求-功能一体表,孤儿 REQ=漏提取)→ ##3 技术分析(§3.1 代码改动影响面 → §3.2 模块边界/架构 → §3.3 强弱依赖与容灾限流降级 → §3.4 打点监控 → §3.5 核心接口 + V-01~V-12 接口质量维度锚表)→ ##4 风险分析与质量保障(推理链大表:风险→来源→影响→概率→优先级→手段→理由→关键用例点)→ ##5 支持性需求汇总 → ##6 参考文档。每个功能点必须被风险引用、每个风险必须有手段和用例点——漏覆盖被门禁兜住。 -
两维驱动的生成心智:类型清单 × 六层判据: - 横向「类型清单」定骨架:功能/安全/合规/兼容/弱网/异常/接口/集成/埋点等大类; - 纵向「六层判据」定判据:L0 定位(测对对象)→ L1 取值构造(等价类+边界)→ L2 组合构造(2-way 保底、高危升 3-way、IF-THEN 剔非法)→ L3 业务真实(状态机+联合链路 TC-Joint)→ L4 断言构造(断言四步)→ L5 有效性反馈(执行期预埋)。 - 精髓:层 = 按触发规则点名的排查项,不是每次跑六遍——轻需求只触发 L0+L1+L4,重需求六层全触发。
-
L4 断言四步(死断言护栏):①断言业务判定(写「处置动作=转人审」不写「返回 200」);②强度取可测最高档(状态码→响应字段→状态机迁移→持久化副作用→跨系统联动);③正反成对(该拦的被拦 + 该放的被放);④可失败自检(把断言条件翻转,翻转后必须变红,仍绿说明没绑到业务判定)。
-
逐层校验矩阵 G0~G7(最重要的思想:AI 会漂移,校验器不会): - 前提:LLM 是概率模型,同一需求多次生成取值/组合/断言都会漂移;正向分层规则约束不了输出,只有生成后的逐层逆向校验能兜住。 - 三档校验器:A = 确定性脚本(exit 0/1 零漂移)、B = agent 回读自检(以校验者身份回读产物)、C = Reviewer 权威(用户介入节点拍板)。最终置信度由校验器 + Reviewer 保证,不由模型保证。 - G0 定位自检 → G1 方案一致性(validate_risk_strategy.py)→ G2 层级结构(validate_xmind_md.py)→ G3 编号(validate_tc_id.py)→ G4 风险覆盖(validate_risk_coverage.py)→ G5 断言护栏(validate_assertion.py)→ G6 判据回读 → G7 用户 HITL。 - 这是「AI 生成质量如何可控」的完整答案:不是让 AI 更聪明,而是用确定性脚本 + 人审把 AI 的随机性关进笼子。
-
采纳率闭环(对话驱动,用户零命令):生成 → snapshot_baseline 存基线 → 交付 .xmind → 用户改 → review_cycle 直读改后的 .xmind diff 基线 → 四层采纳率报告(整体/按模块/按优先级/按测试类别 + 字段修改热度)→ 定稿版回灌 history_case 并重新摄取 → learn_from_cases 刷新业务知识与风格库。学到的是用户真正认可的那一版(被删的用例不再学、被精炼的断言以定稿为准)。
-
自学习飞轮(Self-Learning):历史用例 → 分析(编号/层级/步骤/断言/组织/优先级/覆盖模式)→ 提取「一条一主题」原则 → 写入 knowledge/style-principles.md(带置信度计数)→ 下次生成优先采用;原则应用优先级:用户本次明确要求 > knowledge 已学原则 > 技能默认原则。
-
风险优先级判定矩阵(影响 × 概率,不设 P3):影响高一律 P0(不论概率);判定矩阵 3×3(高影响行全 P0、中影响中概率 P1、低影响低概率 P2);不引入「风险值 = I × P」中间变量(与矩阵一一对应,保留即重复抄写)。
-
方法论「编译」路径(v0.4.0→v0.8.1 演进):把沉淀在 references 的方法论编译进执行层——「知识 → 指令 → 门禁」,每次版本演进把「待补项」固化为校验脚本;README 保留完整变更记录。这是 AI 时代「方法论资产化」的范式:方法论不靠人记,靠脚本强制。
14.4 api-automation:用例执行自动化
14.4.1 结构
api-automation/
├── SKILL.md                  # 301 行:设计哲学/四铁律/技术设计/工作流
├── framework/                # 可运行框架(四层架构)
│   ├── jsonpath_util.py      # JSONPath 求值器(零依赖)
│   ├── checks.py             # 数据驱动断言规则引擎
│   ├── runner.py             # CaseRunner 数据驱动执行引擎
│   ├── exec_results.py       # 执行结果收集
│   ├── conftest.py           # pytest fixtures(数据驱动注入/优先级映射/铁律守卫)
│   ├── http_client.py        # HTTP 客户端(Bearer 鉴权 + 结构化请求日志)
│   ├── data_loader.py        # 测试数据加载器
│   ├── mock_server.py        # 零依赖 Mock 服务
│   └── tests/                # 框架自测
├── templates/                # 项目脚手架模板
├── examples/                 # 完整示例(comment-api)
└── references/               # 设计参考(allure-report/data-driven/design/env-switching/fixtures)
14.4.2 原理与实现方法论
- 设计哲学:「用例 ≠ 测试代码」——用例设计在需求侧(test-master-improve 的脑图),执行在工程侧;本 Skill 绝不自建用例层级,强制委托 test-master-improve,自己负责把脑图落成可执行代码。这条「分工」解决的是测试行业最经典的沟:设计很丰满、代码很骨感。
- 数据与代码解耦:测试数据(payload/边界/预期)落盘
data/{env}/,禁止硬编码进测试函数;一份代码--env=test跑 test 数据、--env=prod跑 prod 数据,改数据不改代码。 - 四铁律(NON-NEGOTIABLE,每一条都有历史 bug 依据):
- 铁律一:错误用例(expected_status ≥ 400)必须断言 response.body,只断状态码在 collection 阶段即报错——依据:历史 22/27(81%)错误用例只断状态码,400/401/403/404 响应格式变化完全没被捕获;
- 铁律二:prod 环境必须显式
--allow-prod才执行——防止误打生产; - 铁律三:数据驱动用例必须自包含(除非显式 depends_on)——可重复运行的前提; - 铁律四:用例 ID 与脑图严格对应(TC-COMMENT-001 ↔ 脑图 ID),覆盖率报告靠 ID 对齐需求侧与工程侧。 - 规则引擎(checks.py):每条 check 是 JSON 对象——
{path: "$.error.code", eq: "VALIDATION_ERROR"};支持 eq/ne/contains/type/regex/one_of/len_eq 等;所有规则同时执行,不只到第一条失败——一次失败暴露所有断言问题,减少修复迭代。 - 环境隔离:test(Mock,localhost:8787,可无后端跑绿)vs prod(真实 API,token 环境变量注入不落明文,必须 --allow-prod);用例数量 test 可多、prod 通常少。
- Fail Fast, Fail Verbose:错在 collection 阶段不执行(铁律守卫在 pytest_configure 里);执行失败带「路径/实际值/期望值」三段诊断,不是裸 AssertionError。
- 报告自增强 + 覆盖率对齐:Allure 报告注入 Dark 主题、优先级分布、失败行标红;coverage_report.py 输出「需求侧用例 × 工程侧覆盖 × 真实执行率」三对齐报告——覆盖率不是「代码覆盖率」而是「需求覆盖率」,这是测试价值可视化。
14.5 三 Skill 协同:端到端工作流全景
用户提供接口契约(Spec/OpenAPI/RPC DSL/接口文档)
        │
        ▼
[test-master-improve] 委托:生成 test-plan.md(推理链骨架)+ test-cases.md/.xmind
        │  G1 方案一致性 → G2 层级 → G3 编号 → G4 风险覆盖 → G5 断言护栏 → G6 回读
        │  用户审阅方案(介入节点 A)→ 用户审阅用例(介入节点 B)
        ▼
[api-automation] 解析脑图 → 生成 test_<module>.py + data/{env}/<module>.json
        │  铁律守卫(collection 阶段校验)
        ▼
pytest 执行(test 环境自动 Mock / prod 需 --allow-prod)
        │
        ▼
Allure 报告 + exec_results.json + coverage 覆盖率报告(需求侧×工程侧×执行率)
        │
        ▼
[test-master-improve] 采纳率闭环:review_cycle 对比基线 → 定稿回灌 history_case → 飞轮学习
关键点:这条链路每个环节都有「确定性校验兜底」(G1~G5 脚本 + 四铁律 + 规则引擎),AI 的随机性被层层约束;用户只在 A/B/C 三个决策点介入,其余全自动。
14.6 落地方法论总结:传统测试 × AI 重塑的六条心法(面试提炼)
- 分工即架构:用例设计(需求侧)与执行(工程侧)分离,各配一个 Skill——设计侧管「结构契约 + 质量门禁」,执行侧管「可执行 + 可报告 + 可度量」。
- AI 会漂移,校验器不会:AI 生成质量靠「生成后逆向校验」保证,不靠提示词自觉——确定性脚本(exit 0/1)+ 回读自检 + 用户权威三层兜底(G0~G7 矩阵)。
- 把方法论「编译」成门禁:知识 → 指令 → 门禁脚本,方法论不靠人记靠脚本强制(validate_* 系列 + 铁律守卫 + 规则引擎)。
- 数据与代码解耦、用例自包含:环境切换改数据不改代码;用例无顺序依赖——可重复运行是自动化可信的前提。
- 闭环可度量:采纳率(四层报告)、覆盖率(需求侧×工程侧×执行率)、失败诊断(路径/实际/期望)——测试价值可视化,才能跟业务/研发对话。
- 自学习飞轮:历史用例 → 提炼原则 → 沉淀知识库 → 下次生成采用——AI 测试系统「越用越懂你的业务和风格」,这是 AI 重塑测试的长期主义。
14.7 面试口述模板(60 秒版本)
「我在测试提效上做了三件事,对应三个自研 Skill:第一是 test-master-improve,把用例设计方法论固化成 Skill——测试方案先行、按推理链组织(源信息→需求→技术→风险→保障),用例生成后有 6 道确定性门禁(方案一致性、层级结构、编号、风险覆盖、断言护栏、回读自检),专门解决 AI 生成质量不可控的问题,核心思想是『AI 会漂移,校验器不会』;第二是 api-automation,把用例脑图落成可执行 pytest 套件——数据与代码解耦、四铁律兜底(错误用例必须断言 body、prod 必须显式确认)、Allure 报告加需求覆盖率报告;第三是闭环——用户改完用例自动算采纳率、把定稿回灌历史库、提炼风格原则,让系统越用越懂业务。这条链路的价值是:从『人工写用例 + 人工写脚本』变成『AI 设计 + 门禁校验 + AI 执行 + 数据度量』,传统测试经验(等价类、边界值、风险优先级、反模式)全部以结构化规则固化下来,没有被 AI 丢掉,而是变成了 AI 的约束。」
15 AI 时代测试工程师的三重角色:流程设计者 · AI 指挥官 · 关键节点决策者
📎 内容来源:豆包会话观点整理(2026-09-14)。观点:AI 时代的测试工程师不应该仅仅是执行者,而应该是流程的设计者、AI 的指挥官、关键节点的决策者。本章与本文档 2.2(AI 时代 QA 质量保障体系)、14(三 Skill 落地方法论)构成闭环:2.2 讲"体系怎么搭",14 讲"工具怎么落地",本章讲"人的角色怎么变"。
15.1 观点总述:为什么"执行者"角色必然被淘汰
传统定位:测试工程师是"执行者"——按既定用例执行、按模板产出报告、按清单做回归。这个定位的核心资产是"执行能力"(手速、耐心、对工具的使用熟练度)。
AI 时代的现实:执行层正在被 AI 全面接管——AI 生成用例、AI 写脚本、AI 跑回归、AI 分析日志、AI 出报告。如果测试工程师的价值还停留在"执行",那 AI 替代的就是你。执行者被替代,不等于测试被替代——价值上移到"设计、指挥、决策"三个 AI 做不了或不该做的位置:
| 角色 | 干什么 | 为什么 AI 替代不了 |
|---|---|---|
| 流程的设计者 | 设计"AI 时代怎么测"的流程:用例结构契约、质量门禁、评估体系、流水线 | 流程设计依赖业务理解、风险判断与组织知识,AI 只能执行流程,不能凭空定义"该测什么、标准是什么" |
| AI 的指挥官 | 指挥 AI 干活:定义任务、喂对输入、校验输出、把经验固化成 Skill | 指挥依赖"知道要什么结果、能判断结果好坏"——AI 不知道自己的输出是否偏离预期,人知道 |
| 关键节点的决策者 | 在风险定级、方案评审、上线放行、AI 产出验收等节点做最终决策 | 决策需要承担责任的权威主体;"AI 会漂移,校验器不会,最终置信度由人拍板" |
一句话:AI 时代测试工程师从"亲自下场干活的人"变成"设计怎么干活、指挥谁来干活、决定活干得好不好的那个人"——从 execution 到 orchestration,从 operator 到 decision maker。
15.2 角色一:流程的设计者(Designer)
干什么:设计 AI 时代的质量保障流程与测试体系,让 AI 在"你设计的轨道"里干活。
落地抓手(对应本文档已有章节): 1. 设计"测试方案先行"的流程(对应 14.3):AI 生成用例前必须先有 test-plan(源信息溯源 → 需求分析 → 技术分析 → 风险推理链),流程设计者定义"推理链骨架",AI 沿骨架填充——你设计的是思维流程,AI 执行的是流程实例。 2. 设计结构契约与门禁(对应 14.3 的 G0~G7):用例的层级结构、编号规范、风险覆盖、断言护栏——你把这些设计成"AI 必须遵守的格式",再用脚本校验强制。流程设计者的产出物是"规范 + 校验器",不是"用例本身"。 3. 设计评估体系(对应 008 第 28~30 章):评测维度怎么定、打分锚点怎么定义、通过阈值设多少——这是"测什么、怎么算好坏"的设计决策。 4. 设计流水线(对应 14.5):需求 → 用例设计 → 执行 → 报告 → 飞轮学习,各环节谁来做(AI/人)、哪些节点必须人审(A/B/C 介入节点)。
面试表达:"我不再亲自写每一条用例,而是设计『用例怎么被生成出来』的流程——定结构契约、定质量门禁、定校验脚本,AI 在我的流程里生产,我用门禁保证质量。产出物从用例本身变成了规范和校验器。"
15.3 角色二:AI 的指挥官(Commander)
干什么:像指挥官一样调度 AI——派活、给资源(数据/上下文)、验收结果、把打过的仗沉淀成战法(Skill)。
指挥四要素: 1. 定义任务(Describe):把模糊需求翻译成 AI 可执行的任务描述(用例设计委托、测试代码生成、缺陷分析);任务定义得越清晰(角色+目标+约束+输出格式),AI 产出越可控——对应第 14 章的"角色设定收敛行为"。 2. 给对输入(Feed):喂对的材料(PRD/Spec/设计稿/历史用例/契约),让 AI 有足够的上下文;多渠道输入合并(对应 14.3 输入渠道识别)。 3. 验收结果(Verify):AI 的输出必须过校验(脚本门禁 + 人工复核 + 双模型一致性),不验收就不信任——"AI 会漂移"是指挥官必须默认的前提。 4. 沉淀战法(Codify):把成功的指挥经验固化成 Skill/原则库(对应 14.3 的 learn_from_cases 飞轮),下次指挥更高效——指挥官越打越会打,靠的是把经验沉淀成可复用资产。
面试表达:"我把 AI 当团队里最能干但最需要盯的新人——派活时把任务定义清楚(角色、目标、约束、格式),干完必须验收(脚本校验 + 我复核),干得好的经验沉淀进 Skill,下次它直接会。AI 是执行的手,我是指挥的脑。"
15.4 角色三:关键节点的决策者(Decision Maker)
干什么:在 AI 无法决策、不该决策、决策要负责的节点拍板。
关键决策节点清单(对应 14.3 的用户介入节点 A/B/C 思想):
| 决策节点 | 决策内容 | 为什么必须人决策 |
|---|---|---|
| 需求风险定级 | 需求 P0/P1/P2、QA 介入档位(L0/L1/L2) | 风险判断依赖业务上下文与组织经验,AI 只能给建议(对应 2.2.2 五维评分模型,AI 算分、人定级) |
| 方案/用例评审 | test-plan 是否成立、用例是否覆盖风险 | 覆盖正确性最终由"懂业务的人"背书(介入节点 A/B) |
| AI 产出验收 | AI 生成的用例/脚本/报告是否可用 | 概率模型的输出需要权威主体确认("最终置信度由 Reviewer 保证,不由模型保证") |
| 上线放行 | 灰度放量、全量发布(对应第 12 章灰度门禁) | 放行是承担责任的动作,责任主体必须是人 |
| 原则沉淀 | 哪些经验写入知识库/原则库(介入节点 C) | 不可逆写入需人确认(用户铁律:不可逆操作走确认闸门) |
| 异常处置 | 线上事故定级、止损决策、复盘结论 | 高风险高影响决策必须人在回路(HITL) |
面试表达:"我给自己留了三个必须拍板的节点:方案能不能过、用例覆盖够不够、经验要不要沉淀。其他都交给 AI 和自动化——这叫『人在关键节点,AI 在全部过程』。"
15.5 三重角色如何协同(体系闭环)
你(测试工程师)
 ├─ 流程设计者 → 设计「规范 + 门禁 + 评估体系 + 流水线」
 │     ↓ 产出物:test-plan 骨架 / 校验脚本 / 评测维度 / 介入节点清单
 ├─ AI 指挥官 → 派活 + 验收 + 沉淀
 │     ↓ 产出物:用例脑图 / 测试代码 / 报告 / Skill 资产
 └─ 关键节点决策者 → 在 A/B/C、风险定级、上线放行处拍板
       ↓ 产出物:决策记录(权威结论)
与本文档的对应关系:2.2(体系设计)是"流程设计者"的成果;14(三 Skill 链路)是"AI 指挥官"的指挥系统;介入节点 A/B/C 与风险定级是"关键节点决策者"的决策点——三个角色是一套体系的三个侧面,不是三个岗位。
15.6 能力配方与成长路径
| 能力 | 对应角色 | 怎么练 |
|---|---|---|
| 需求拆解与风险建模 | 流程设计者 | 用五维评分模型给真实需求定级,练"从需求到风险"的抽象能力 |
| 提示词与 Skill 设计 | AI 指挥官 | 把重复任务固化成 Skill(参考 14 章三 Skill),练"把经验编译成指令" |
| 校验与验收方法 | AI 指挥官 | 给 AI 产出设计校验清单(门禁脚本 + 人工复核 + 双模型一致性),练"不信任默认值" |
| 决策与责任承担 | 关键节点决策者 | 在方案评审/上线放行中主动拍板并承担后果,练"在不确定中做决策" |
| 业务与架构理解 | 全部 | 不懂业务无法设计流程,不懂架构无法定风险——AI 越强,人的业务理解越值钱 |
成长路径:执行者(会用 AI 提效自己)→ 设计者(设计 AI 流程服务团队)→ 决策者(对质量与风险负责)——前两层 AI 可以辅助,第三层的"负责"只能是人。
15.7 面试口述模板(60 秒版本)
「我对 AI 时代测试工程师的定位有三句话:第一,是流程的设计者——我不再亲自写每一条用例,而是设计『用例怎么被生成出来』的流程,定义结构契约、质量门禁和校验脚本,AI 在我的轨道里生产;第二,是 AI 的指挥官——派活时定义清楚任务(角色、目标、约束、格式),干完必须验收,干得好的经验沉淀成 Skill,让 AI 越用越懂业务;第三,是关键节点的决策者——风险定级、方案评审、上线放行、AI 产出验收这些必须人拍板的地方我负责,AI 会漂移,校验器不会,最终置信度由人来保证。一句话:执行者被 AI 替代,但『设计怎么测、指挥谁来测、决定测得好不好』的位置,永远需要人。」
16 AI Native 测试工作流重构:行业实践调研(2026-09-14)
📎 内容来源:公开技术分享调研(字节跳动质量保障团队、华为云、蚂蚁集团、阿里技术、快手 InfoQ/AICon 分享、腾讯云开发者社区等,2026-09-14 整理)。本调研聚焦"AI 原生测试工作流重构"——即用大模型/Agent 重构"用例生成→执行→缺陷分析→报告"全链路,而非简单用 AI 辅助单个环节。
16.1 全景速览:谁在做、做到什么程度
| 公司 | 代表实践 | 关键数据/能力 | 来源性质 |
|---|---|---|---|
| 字节跳动 | 测试用例生成 Agent、质量大模型、智能单测生成 | 85.4% 生成用例集成 CI/CD;新增用例 25% 来自 Agent(峰值 50%+);Agent 月活 30.7%;每双周省约 30 人天 | 官方技术团队分享(最完整) |
| 华为云 | CodeArts TestPlan v2.4 + 码道代码智能体 | 自动解析接口业务语义(前置约束/异常分支/合规边界)生成 JUnit 5 用例;单元测试智能体"生成-修复"闭环 | 官方产品/认证 |
| 蚂蚁集团 | AI 生成代码三维测试体系、Harness 质量门禁 | 捕捉传统覆盖率漏掉 73% 的 AI 特定缺陷(一方称);40 万行 Rust 新项目内建 Harness | 公开分享/博客 |
| 阿里 | Aone Copilot Agent 单测生成 | AI 代码采纳率约 50%,靠持续优化 prompt | 阿里技术官方 |
| 快手 | 柯南 AI 稳定性 Agent、AI 研发数字员工、AgentX | 稳定性 Agent 用户渗透率 60%、完整采纳率 50%;AI 生成代码占比 30%+;AI Agent 员工使用率 92% | InfoQ/AICon + 财报 |
| 腾讯 | PagePilot PC 端 AI 测试 Skill | 7 条 Case 人工需半天~1 天 → Skill 30 分钟跑完,自动截图+归档+通知 | 公开分享 |
16.2 字节跳动:从"经验驱动"到"智能驱动"(最完整的案例)
16.2.1 测试用例生成 Agent(质量保障团队官方落地)
做法:Agent 读取 PRD/需求 → 结合历史知识库 → 批量生成迭代专属用例与测试数据 → 用户审阅后一键集成 CI/CD。核心设计点: - 审阅与集成闭环:生成用例不是直接进库,而是经 QA 审阅后集成——这是"人在关键节点"的落地; - 效果数据:85.4% 生成用例被集成到 CI/CD 工作流;新增用例中平均 25% 来自 Agent 生成(个别团队峰值 50%+);Agent 用户月活 30.7%;每双周为部门节省约 30 人天。 - 启示:AI 生成用例的落地关键不在"生成多好",而在"审阅流程 + 集成流程"设计得好——与本文档 14 章"介入节点 A/B/C"完全一致。
16.2.2 质量大模型体系(GIAC 分享)
- 思路:在保障业务质量不劣化前提下最大化测试人效,将质量保障从"经验驱动"升级为"智能驱动";
- 能力矩阵:需求分级 → 代码分级 → 测中提效(文本用例生成、自动化生成)→ 兜底能力;
- 启示:AI 质量建设是"分级分层的系统"(需求侧分级、代码侧分级、执行侧提效、兜底侧保障),不是单点工具。
16.2.3 智能单测生成(QECon 分享)
- 做法:大模型 + 深度程序分析 + 真实业务流量采集(司内流量)+ 断言工程 + 语法修正 + 效果度量;
- 解决的核心问题:单测用例的"真实性"(不是凭空编造)和覆盖率;
- 启示:真实流量喂给 AI 是让生成用例"贴近业务"的关键手法。
16.2.4 鸿蒙版抖音 AI 质量保障
- 结果:主功能 100% 覆盖、整体效率提升 20%——AI 重塑质量保障在客户端侧的成功样例。
16.3 华为云:把"业务语义理解"编译进测试生成
16.3.1 CodeArts TestPlan v2.4(业务语义级用例生成)
- 做法:对 Java Spring Boot 微服务接口自动解析业务语义——识别"用户余额扣减"的前置约束(余额≥扣款金额)、异常分支(账户冻结、风控拦截)、合规边界(单日限额)→ 生成含真实业务断言的 JUnit 5 用例;
- 闭环:理解意图 → 推导路径 → 生成可执行断言;
- 启示:AI 测试生成从"语法层"(会调接口)进化到"语义层"(懂业务规则)——业务断言是 AI 生成用例价值的分水岭。
16.3.2 码道 CodeArts 代码智能体(单元测试智能体)
- 能力:测试设计、用例生成、用例智能修复全流程(自动识别编译错误并修复);
developer-test-agent技能(单测生成/修复/覆盖率优化); - 启示:生成-修复闭环是 AI 测试提效的成熟形态——AI 不只是"一次生成",而是"生成→报错→自修→验证"自迭代。
16.4 蚂蚁集团:AI 生成代码的质量保障(质量左移 + 门禁)
16.4.1 三维立体测试体系(AI 生成代码专项)
- 做法:对 AI 生成代码建立专项测试体系(功能维度 + AI 特定风险维度 + 架构约束维度);
- 效果:捕捉传统覆盖率漏掉的 73% 的 AI 特定缺陷(该数字来源为公开博客,建议面试引用时标注"公开分享口径");
- 质量左移:从"事后测试"推到"事前约束"——在提示词层面预防缺陷(给 AI 写代码的 prompt 里就约束架构与规范);架构一致性等不可运行验证的质量属性靠静态约束保证;
- 启示:AI 时代质量保障的第一道防线不是测试,是"给 AI 的约束"(对应本文档 15 章流程设计者的理念)。
16.4.2 Harness 工程实践(AICon 分享)
- 做法:把"可验收性"内建进 AI Coding 流程——40 万行 Rust 新项目第一天起内建 Harness(质量门禁 + 事实源);60 万行 C++ 存量项目先重建事实源和质量门禁,再让 Agent 参与仓库升级;
- 启示:先有门禁再放 AI 进场——AI 编码/测试的规模化前提是质量门禁先行(与 14 章 G0~G7 校验矩阵同理)。
16.4.3 测试用例生成模型(AiDD 分享)
- 四种能力:Text-to-测试用例(按需求生成)、Code-to-测试用例(按代码生成)、测试用例补全、多场景联动(测试分析与用例联动)。
16.5 阿里:Aone Copilot Agent 单测自动编写
- 做法:Agent 按精心设计的 prompt 自动生成单测用例 + 修改代码;实践结论:AI 代码采纳率约 50%,持续优化 prompt 质量是提升采纳率的关键变量;
- 启示:prompt 即产品质量——同样的模型,prompt 设计决定一半效果(呼应第 30 章评测器 prompt 方法论)。
16.6 快手:人机分工 + Skill 沉淀(与本文档方法论最契合)
16.6.1 柯南 AI 稳定性 Agent(InfoQ/AICon 分享)
- 核心原则:确定性的流程交给代码,概率性的推理交给模型;通过 Skill 沉淀专家经验,以源码服务和端侧基建提供有效上下文,用 Bad Case 持续迭代;
- 数据:用户渗透率 60%、完整采纳率 50%;
- 启示:这条"确定性/概率性分工 + Skill 沉淀 + Bad Case 反哺"的路线,与本文档 14 章(三 Skill 方法论、G0~G7 门禁、飞轮学习)惊人一致——你的方法论与大厂实践同构,面试可直接引用互证。
16.6.2 AI 研发数字员工与 AgentX
- AI Agent 员工使用率 92%;研发技术人员 AI 代码贡献率 60%;需求交付周期缩短 10%+(季度环比);
- AgentX:Agent 驱动的研发闭环(面向工业推荐系统)——从研发提效到组织跃迁。
16.7 腾讯:PagePilot PC 端 AI 测试 Skill
- 做法:把 PC 端测试流程固化成 Skill——自动执行(含等渲染、填表、上传、截图)+ 提交/撤销 DB 双验证 + 自动归档语雀 + 自动发钉钉通知;
- 数据:人工一条 Case 约 30 分钟(7 条需半天~1 天)→ Skill 30 分钟内跑完 7 条;
- 启示:单点流程 Skill 化(不追求全流程 AI,先把高频人工环节固化)是低门槛起步路径——与用户自研 skill 的定位一致。
16.8 火山引擎 / Agent 时代:质量保障体系的延伸
- OneAgent 统一探针:从 App/Web/小程序到 AI 网关、Agent 工具、底层 LLM 的全链路 MTL(Metrics/Traces/Logs)统一采集——Agent 应用的"可观测即质量保障";
- Agent 评测:字节 Data Agent 评测(InfoQ 分享,Agent 评测 Agent 三层框架)、EdgeBench(134 个真实任务,Agent 至少跑 12 小时,5 模型累计约 38000 小时)——AI 时代测试对象从"应用"扩展到"Agent 本身"。
16.9 共性最佳实践模式(八条,面试直接可用)
- 用例生成 Agent 化:Text-to-TC(按需求)/ Code-to-TC(按代码)/ 补全/联动——所有大厂都做,字节/蚂蚁/华为/阿里均有落地;
- 生成-修复闭环:AI 生成 → 自动识别编译/断言错误 → 自动修复 → 验证(华为 developer-test-agent、字节智能单测);
- 真实数据喂养:真实业务流量采集(字节)、数据沙箱(蚂蚁 OceanBase)——用真实数据校准生成质量;
- 业务语义级断言:从"语法正确"到"懂业务规则"(华为 CodeArts TestPlan"余额扣减前置约束"式生成);
- 人机分工原则:确定性的流程交给代码,概率性的推理交给模型(快手柯南 AI);AI 生成、人审阅集成(字节 85.4% 审阅后入库);
- 质量左移与门禁先行:提示词层面预防缺陷(蚂蚁 73% AI 特定缺陷)、先建门禁再放 AI 进场(蚂蚁 Harness);
- Skill 沉淀专家经验:把领域知识/流程固化进 Skill(快手、腾讯 PagePilot、用户自研体系)——这是跨公司最一致的落地形态;
- Bad Case 反哺闭环:失败用例/修正标注/修复建议回灌,持续优化生成质量(快手 Bad Case、SITS 类反馈闭环、PDCA-AI)。
16.10 对测试工程师的启示(面试升华)
- 大厂实践验证了"流程设计者"定位:字节 85.4% 审阅后集成、快手"确定性交给代码",都说明 AI 时代测试工程师的核心动作是设计流程与验收标准,而不是写用例本身(呼应第 15 章三重角色);
- Skill 化是落地共识:快手、腾讯、字节(火山)都在做 Skill/Agent 沉淀——会设计 Skill 的人 = 会指挥 AI 的人,这是当前最稀缺、最可讲的能力;
- 业务语义是分水岭:AI 生成用例的能力上限取决于"业务知识怎么注入"(真实流量、语义解析、历史用例库)——测试工程师的领域经验是喂给 AI 的关键原料;
- 你的方法论与大厂同构:本文档 14 章(三 Skill + 门禁 + 飞轮)与快手柯南 AI(确定性/概率性分工 + Skill + Bad Case)同构,面试时可用"我的实践与快手柯南 AI 的思路一致"来互证,比空谈概念更有说服力。
16.11 深度拆解:快手柯南 AI(五层架构与关键设计逐句落地)
📎 内容来源:InfoQ/AICon 2026 快手主站技术稳定性专家王泽锋分享全文精读(2026-09-14 补充)。
16.11.1 它为什么存在(背景与出发点)
- AI Coding 把研发吞吐拉快,但"线上告警 → 根因定位 → 止损 → 修复回归 → 经验沉淀"这条下游链路没有同步提速——稳定性处置是 AI Native 研发体系的最后一公里;
- AI 有局部最优陷阱:缺全局上下文时,AI 会沿"最小阻力路径"让现象消失而非真正解决问题。真实案例:AI 生成的 ProGuard 配置含
-dontoptimize被写进consumerProguardFiles,随 AAR 传递到主工程合并进 R8 配置,关掉了主工程全局优化,APK 包体凭空 +6MB——从 AI 视角"SDK 能跑"就是合理的,但它看不到跨工程边界; - 前置拦截(SDD/Coding Harness/测试)消灭不了所有问题:状态空间爆炸(Android 100+ OEM ROM、1000+ 机型、单日 10000+ 次 A/B/灰度/活动变更、用户路径无穷大),组合空间轻松破 10⁹;软件稳定性是不完备性证明,线上真实现场永远是核心战场。
16.11.2 定位与产品形态
- 定位"问题处置"四场景:报警处置(解释/影响面/SOP)、根因分析(线索/假设/证据链)、修复建议(方向/风险/验证)、治理初检(优先级/分发)。选择原因:最吃研发时间、弥补人脑盲区、ROI 高、专家经验杠杆高、适合 AI(聚合多步推理);
- 产品形态原则:不额外创造孤立交互,嵌入开发者已有工作流——① IM 机器人(报警处置/指标巡检/问题分发,天然在群里协作);② 监控平台侧边栏(打开崩溃详情自动携带上下文触发根因分析);③ CLI(监控平台信息不足时,连手机拉设备 so 文件等现场信息继续排查)。
16.11.3 五层架构总览
| 层 | 定位 | 关键组成 |
|---|---|---|
| 应用层 | 用户直接接触的入口 | IM 机器人 / 监控平台侧边栏 / CLI |
| Agent 编排层 | 什么任务用什么形态承载 | Workflow / 单次 LLM / Agent |
| Agent Harness 层 | 包裹在模型外的控制系统 | System Prompt / Tool / Permission / Skill |
| 数据服务层 | Agent 的感知输入 | APM 聚合数据 / 单点详细数据 / 源码 / 变更(发版·活动·实验) |
| 端侧基建层 | 决定能采集到什么样的现场 | 堆栈 / 火焰图 / 内存快照 / Core Dump |
| (贯穿) | 反馈迭代·可观测 | 链路层 / 指标层 / 运营层三层观测 + Bad Case 闭环 |
16.11.4 编排层:确定性的归代码,概率性的归模型(最核心原则)
- 确定性的归代码,概率性的归模型:流程清晰、规则明确、答案唯一的用代码实现;只有涉及理解/推理/判断的才让模型介入;
- 单次 LLM 请求能解决就不用 Agent:Agent Loop 每多一轮 = 多一次 LLM 请求(时延 + Token)+ Tool Call 可能失败 + 自主决策可能跑偏。任何任务都用 Agent 是过度工程化;
- 三种形态组合:确定流程 → Workflow(用代码复刻人工 SOP);简单概率任务 → 单次 LLM;复杂非线性推理 → Agent;
- 单 LLM 案例(报警快速分析·维度分析):代码聚合 APM 维度数据(设备/系统/地域 Top N + 占比同比)→ 上下文一次性入 Prompt → 按预设结构化模板输出(集中维度 + 置信度,直接渲染卡片)。耗时稳定在 1 分钟以内。真实案例:iOS 27 推送后小规模堆栈报警,快速分析发现 100% 集中在 iOS 27,秒级收敛到新系统兼容性问题;
- Agent 案例(根因分析):跨多个数据源(堆栈/源码/代码变更/聚合特征/历史相似 Case)、多次 Tool Call、无固定线性流程——才需要长链推理 + 动态扩展上下文 + 按需加载 Skill(避免上下文一次性膨胀)。
16.11.5 Harness 层:成熟底座 + 轻量化定制 + Skill 承载专家经验
- 框架演进史:AutoGen → OpenAI Agent SDK 自研 Workflow → 最终用 Claude Agent SDK(工程红利:继承生产级上下文管理/工具能力;迭代同步;对 Claude 适配好,国内开源模型可兼容接入);
- 轻量化定制一(精简 System Prompt):剥离与领域无关的通用准则(通用 Coding 约束 / auto memory / 通用 skill 清单),注入领域硬规则——猜测/结论分段、置信度标注、禁跨类型对比;
- 轻量化定制二(Tool 精简 + Permission 沙箱):通用工具(计划/工作树等)用 disallowedTools 关闭缩小攻击面;Read/Write/Edit 等 Bash 工具锁定 cwd,越界即拒绝——即使 Agent 失控,影响半径可控;
- Skill 为什么是承载专家经验的形态:① 按问题类型按需触发——渐进式披露 + 按需加载,30+ skill / 19K+ 行知识共存不撑爆上下文;② 对领域专家友好——MD + frontmatter,不需要懂 runtime、不需要写代码,"专家维护"从工程团队边界释放;
- Skill 如何组织:① 不耦合 Agent——skill-tree 独立仓库、领域专家维护、独立发布/灰度/回滚;② 按异常退出类型划分——android-/ios-/harmony- 各自独立,宁愿适度重复,避免跨端跨类型上下文污染*;
- Skill 怎么写(两类核心内容):
- 私域知识注入:字段语义与上报时不一致(如 FD OOM 判定在 Android 高版本失效 → 写"禁止信任 mCrashType/异常类型 上报字段");私有框架/SDK 专有知识(LLM 训练语料从未见过,必须显式注入,如内部崩溃兜底框架 ekko 的 fake_exception 帧与业务无关 → 写明"跳过 ekko 帧,从业务帧开始分析");
- 根因分析 SOP(决策树):鸿蒙 AppFreeze 主线程根因(3S/6S 双采样一致性判断"阻塞 vs 繁忙",阻塞时查全线程堆栈找持锁线程);Android Native Crash 信号路由(SIGABRT/SIGTRAP 走 abortMsg 轻量路径——根因常直接写在 Abort Message;SIGSEGV/SIGBUS 才走反汇编/寄存器深度分析)。核心决策逻辑参考了华为系统 DFX 团队开源版本。
16.11.6 数据服务层:上下文决定 Agent 的效果上限
- 独立源码服务(不每次重新 clone):① 解决"仓库找不到"——一个崩溃堆栈横跨 5~10 个仓库,崩溃模块名与仓库名不一致,源码服务提前完成仓库聚合与索引;② 解决拉取效率——大型客户端主仓 clone 几十秒到分钟级,预聚合后接近本地 grep 速度;
- Agent 友好接口:把"人 + GUI"的数据重新包装为"Agent + bash 接口"——
git grep / git log / git blame,LLM 天然熟悉 bash 语义,无需为每种查询定义 API Spec;安全配套:容器只读挂载 + 命令超时 + 完整命令日志——Agent 自由探索但不能越界; - 演进方向:关键词检索 → 语义检索(LSP / Code Graph,解决 NPE 类跨函数跨文件变量生命周期追踪);单体 → 分布式(源码服务日承载数万次调用)。
16.11.7 端侧基建层:端侧基建从"为人优化"变为"为 Agent 优化"
- Core Dump 探索(ART JIT 踩内存场景:PC 落在 jit-code-cache,tombstone 只有 PC 附近几百字节不够用,只有 Core Dump 能存完整进程内存快照);
- ROI 重写:过去 Core 文件几百 MB 起、纯二进制、只有专家 + lldb/gdb 数小时甚至数天能挖 → AI 时代 Agent 自动反汇编 + 关联源码/寄存器/现场信息,任何研发 + 一个 Agent 就能用;
- 结论:端侧基建决定 Agent 能看到什么、分析到什么深度——上下文决定效果上限,Agent 无法凭空创造有价值的信息。
16.11.8 反馈迭代:用 Bad Case 驱动长期效果提升
- 三层观测体系:链路层(Agent 一次调用过程完整还原:对话→大模型→工具调用/Skill 按时序)|指标层(4 类 Token 消耗、模型降级状态、首 Token 响应速度)|运营层(用户增长/Token 消耗/模型调用/会话管理);
- Bad Case 两步闭环:① Case 管理——基于观测数据建标注平台,制定统一采纳率标准,筛选有效问题 + 用户回访 + 专业经验二次确认;经典 Case 进评测集,对应缺陷转优化项;② Case 总结——固定例会 Review 采纳率和细粒度 Case,拉齐采纳标准、共识优先级;
- 瓶颈与探索:根因分析思考深度不足(NPE 只答"哪里为空"答不了"为什么为空")、信息缺失时本能幻觉 → 短中期 Skill 强化约束 + 问题分级路由(难问题分配给更强模型),长期树形搜索(多假设并行收集证据);修复效果落后于排障(历史修复经验缺位、业务暗知识只在人脑里)→ Memory 体系承载历史经验 + 业务暗知识显性化(没有被表达和沉淀的知识,就无法成为 Agent 可用的上下文)。
16.11.9 效果数据与统计口径
- 用户渗透率接近 60%:快手内部大前端研发中使用柯南 AI 的用户占比(使用柯南 AI 的用户数 / 目标用户群);
- 根因分析完整采纳率稳定在 50% 左右:人工(用户回访 + 专业二次确认)判断柯南 AI 给出的根因结论"完整、正确、可用"的比例——有统一采纳率标准 + 固定例会拉齐,不是模型自评;
- 10 分钟案例:鸿蒙 C++ Crash(SIGSEGV、纯系统堆栈、踩内存特征)→ 按 Skill 信号路由进入内存分析 → 寄存器分析判断 Use-After-Free → 业务日志共性收敛到内部基础组件 → 私域知识排除 HiLog 噪声 → 寄存器+日志+源码三证据链自洽 → 定位 libuv async handle UAF 并找到止损开关,全程约 10 分钟(过去需平台型稳定性专家介入)。
- 开源情况:柯南 AI 是快手内部系统,未开源(公开载体为 AICon/QCon 演讲 + InfoQ 文章)。注意区分:快手开源的是通用 Agent 项目 KwaiAgents(7B/13B 模型 + 评测,哈工大合作)与柯南 AI 无关。
16.12 快手"92% / 60%"统计口径(官方定义)
📎 内容来源:快手 2026Q2 财报(程一笑业绩会)+ 快手技术 InfoQ《AI 研发范式升级新路径》(2026-08-10)。
- AI Agent 员工使用率 92%:2026 年 6 月,快手员工使用各类自研 AI Agent 产品的人数占比超过 92%——口径是"员工中使用过自研 AI Agent 产品的人数 / 员工总数"(财报业绩会披露);
- AI 代码贡献率 60%:官方定义原文——分母:所有上线发布的代码行;分子:分母中所有 AI 生成的代码行(快手内部称"AI 代码贡献率",计算的是上线代码里 AI 生成的占比;AI 生成的标记来自 IDE 插件 / Agent 工具的代码来源埋点,在发布流水线全量统计);
- 相关过程指标(同一体系):AI 代码生成率从 30% → 60%+(观察指标翻倍);L2+ 需求占比从 13.23% → 64.87%(增长近 4 倍);人均需求交付数 ↑10%;需求平均交付周期 ↓11%+;AI 代码生成率 >40% 的人员占比 30% → 47% → 77%;
- 统计落地方式:不是问卷调研,而是研发平台全量埋点——发布流水线统计上线代码行,AI 生成代码行由 IDE/Agent 工具在生成时打标(提交时带来源标记),最终在效能平台聚合出占比;员工使用率由各 AI 产品的账号活跃数据聚合。
16.13 深度拆解:字节 NL2Test Agent(测试脚本雕刻 Test Script Carving)
📎 内容来源:字节跳动质量保障团队 × 复旦 CodeWisdom《让 QA 真正用起来》全文精读;论文:Industrial Practice of LLM-based Test Case Carving and Assertion Generation,ISSTA 2026(2026-09-14 补充)。
16.13.1 定位与开源情况
- 定位:面向测试自动化的 NL2Test Agent——QA 用自然语言描述测试场景,Agent 自动生成可运行的回归测试用例;
- 开源情况:未开源。方法与工程取舍以 ISSTA 2026 论文形式公开(字节 TikTok Eng-Testing × 复旦大学 CodeWisdom 董震团队);
- 选对场景(最关键决策):不替代 QA 做测试设计,只做"用例转译"——QA 负责描述测试目标和业务判断(前端 App 操作流程),Agent 负责识别背后的后端 API 并生成符合框架规范的可执行用例。本质是从"测试意图"到"可执行用例"的转译,输入输出约束清晰、确定性更高,最适合作为 LLM Agent 的落地切入点。
16.13.2 核心流程:Test Script Carving(测试脚本雕刻)五步
输入:NL Test Case Description(QA 自然语言用例描述)+ Raw Traffic Capture(原始流量捕获)
  │
  ▼ ① Action Sequence Extraction(动作序列提取)
  │    Rule-based Filter(规则过滤去噪)+ LLM Semantic Alignment(语义对齐:业务步骤→具体 API 请求)
  ▼ 输出 Step-Aligned API Sequence(步骤对齐的 API 序列)
  │
  ▼ ② Test Data Parameterization(测试数据参数化)
  │    LLM Dynamic Data Identification(识别动态数据,如第2步的 cid 来自第1步响应)
  │    + Dynamic Data Validation(动态数据验证)
  ▼ 输出 Dynamic Data Bindings(动态数据绑定)
  │    例:test_data["2"]["params"]["cid"] = resp0["cid"]
  ▼
输出 Test Skeleton(测试骨架:Python 测试代码 + TODO 断言)
  例:class TestCase:  def test_case(self, test_data, http_client):
        status_code, resp0 = http_client.get_challenge_detail(**test_data["0"]["request"])
        ...
        # TODO: Assertions
16.13.3 七大工程取舍(每一句怎么落地)
- 全流程无人干预 > 单点智能:用例生成是多阶段流程(请求识别→依赖分析→参数处理→断言生成→代码生成),任一环节失败要 QA 介入就会抵消收益。核心设计目标是整条链路容错——对模型输出做结构校验、异常内容丢弃,保证后续阶段能继续执行,"哪怕初版不够完美也要自动生成可运行结果";
- 能用程序解决的问题就不要用 LLM:字段查找、schema 校验、值匹配、请求过滤、参数替换、断言校验交给确定性逻辑;LLM 只处理语义理解和模糊判断(业务步骤映射到请求、推断预期结果)——模型不确定性被限制在必要范围内;
- 把 LLM 任务拆小,小到可以校验:不设计成一次端到端大模型调用(出错难定位、错误会放大)。拆成请求匹配、依赖关系提取、断言意图识别、受约束代码生成等小任务,每次只产出小的结构化结果,进入下一阶段前完成校验;
- 给模型必要的信息,而不是塞入完整流量:原始流量有大量噪声(静态资源、轮询请求、重复流量、时间戳、trace id、诊断字段、运行时临时字段)。调用 LLM 前先治理流量:过滤无关请求、摘要响应结构、突出候选字段、排除不稳定字段——上下文不是越多越好,而是越相关越好;
- 用明确约束限制模型输出,而不是只靠自然语言指令:只靠 prompt 说"不要编造字段"不可靠。给模型明确的 schema 和允许集合(合法请求标识、候选字段、支持的断言类型、已有变量名),输出后做约束校验;只有唯一确定性修复方式才自动修复,否则直接丢弃,避免不可靠内容进入链路——输出从"自由生成"变"受控生成";
- 优先生成稳定断言,而不是追求断言数量:回归测试断言不是越多越好。只针对"与业务结果直接相关、多次执行相对一致"的字段生成断言;目标缺失、语义不明确、依赖运行时状态的断言直接移除——少而准、能长期稳定运行的断言 > 丰富但脆弱的断言;
- 效果数据:85.4% 生成用例被集成到 CI/CD 工作流;新增用例中平均约 25% 来自 Agent 生成(个别团队峰值 50%+ 且持续提升);Agent 用户月活率 30.7%;工具平均每双周为部门节省约 30 人天投入。
16.13.4 指标解读(面试口径)
- 85.4% 生成用例被集成:指"生成的用例中,有 85.4% 经 QA 审阅后真正进入 CI/CD 回归工作流"——是生成→入库的集成率,不是覆盖率也不是采纳率;与快手柯南 AI 的"根因分析完整采纳率 50%"是两套不同指标(一个是用例集成,一个是分析结论被用户认可);
- 每双周省 30 人天:原文未披露统计方法学,按行业通行口径合理推测为"工具前后对比法"——手工编写同等数量回归用例的人天 − 使用 Agent 后人天,乘以双周用例产量,聚合到部门级(面试引用时建议标注"公开材料未披露方法学,此为合理推断");
- 25% 新增来自 Agent(峰值 50%+):统计周期内新增入库用例中,由 Agent 生成并通过审阅的比例(分母是新增用例总数,分子是其中 Agent 生成的)。
16.13.5 有必要做成 Agent 吗?Skill 行不行?(关键分析)
- 字节为什么用 Agent 形态:任务是多阶段流水线(识别→依赖→参数→断言→代码),且目标是全流程无人干预——需要按中间结果动态决策(哪些请求匹配、哪些字段要绑定),具备"工具调用 + 多步编排"特征;
- 但要看到本质:字节的实现本身就是"LLM + 确定性逻辑"混合(能用程序解决就不用 LLM、任务拆小、约束校验)——这与快手"确定性的归代码、概率性的归模型"是同一思想,也与 Skill 化实现同构;
- 结论(可面试引用):如果只是"自然语言 → 用例"单点转换,用 Skill(知识 + 工作流封装 + 确定性校验脚本)完全够——对应你的 test-master-improve + api-automation 组合,G1~G5 脚本就是"约束校验"的等价物;但如果要"自己抓流量 → 生成 → 执行 → 修断言 → 回填结果"的无人干预闭环、并要独立评测与迭代,Agent 形态更合适。关键决策不是"叫 Agent 还是 Skill",而是"哪些环节交给 LLM、哪些交给确定性逻辑"——字节 7 条取舍里 5 条是在回答这个问题。
16.14 "我的方法论"与大厂实践的同构对照(面试互证)
来源:本文档第 14 章(三 Skill 方法论)+ 第 16 章调研的交叉印证。
| 我的方法论(14 章六条心法) | 大厂同构实践 | 对照点 |
|---|---|---|
| ① 分工即架构(设计侧 Skill / 执行侧 Skill 分离) | 快手柯南 AI:编排层三种形态分工;字节:LLM 与确定性逻辑分工 | "什么归模型、什么归代码"是共同的第一决策 |
| ② AI 会漂移,校验器不会(G0~G7 确定性门禁) | 字节:schema/允许集合约束输出 + 约束校验 + 异常丢弃;快手:Skill 领域硬规则(置信度标注/禁跨类型对比) | 都认为不能靠提示词自觉,要靠外部校验兜底 |
| ③ 方法论编译成门禁(知识→指令→脚本) | 快手:Skill 沉淀专家经验(SOP 决策树、私域知识注入、禁止行为) | 专家经验以结构化规则注入,而非靠模型记忆 |
| ④ 数据与代码解耦、用例自包含 | 字节:测试数据参数化 + 动态数据绑定;快手:Agent 友好数据接口(bash + 只读挂载) | 数据/上下文准备是效果上限 |
| ⑤ 闭环可度量(采纳率/覆盖率/诊断) | 快手:三层观测 + 统一采纳率标准 + 固定例会 Review | 采纳率是共同的核心度量 |
| ⑥ 自学习飞轮(历史用例→原则→知识库) | 快手:Bad Case 驱动(标注平台 + 回访 + 评测集 + 优化项);Memory 体系探索 | 长期效果靠反馈闭环,不靠一次性模型 |
一句话总结(面试可直接说):我在测试提效上的方法论(分工架构 + 确定性门禁 + Skill 沉淀 + 闭环度量 + 自学习飞轮)与快手柯南 AI(确定性的归代码/概率性的归模型 + Skill 承载专家经验 + Bad Case 驱动)、字节 NL2Test(LLM 与确定性逻辑分工 + 约束校验 + 全流程无人干预)是同构的——大厂的工程实践反过来验证了这套方法论不是空谈,而是当前 AI Native 测试/稳定性工程的事实共识。
16.15 大厂智能测试方法:图灵测试类与对抗性对话测试(J16)
来源:WorkBuddy《面试知识点详解》主题 J16(豆包对话《智能测试相关问题解答》) 整理入库:2026-09-14(WorkBuddy 137 条知识点覆盖检查补录) 定位:与 16 章大厂 AI Native 测试实践互补——16.2~16.14 讲"AI 提效测试"(用例生成/脚本雕刻),本小节讲"测 AI 系统本身"的智能测试方法。
WorkBuddy 文档原文(J16):
- 图灵测试类:标准图灵测试(30% 以上误判视为通过);对抗性对话测试(反复问同一问题、故意矛盾、诱导出错,测一致性/记忆/抗干扰)。
- 自动化用例生成(字节/阿里/微软):输入 PRD,LLM 自动生成用例(正常/边界/异常);字节效率提升 4–10 倍,覆盖率 85%+;微软 Autogen 多智能体分工。
★ 入库补充(面试展开要点):
- 标准图灵测试口径:让真人分辨"AI 回答 vs 真人回答",若 ≥30% 被误判为真人即视为通过(弱/强图灵测试的不同阈值与用途)。
- 对抗性对话测试的三种打法:①反复问同一问题(测答案一致性,防"同问不同答");②故意给出矛盾前提(测模型是否察觉并纠正,测逻辑一致性);③诱导出错(模糊指令/误导性暗示,测抗干扰与立场稳定)。
- 与自动化用例生成的关系:图灵测试/对抗测试是"评测手段",自动化用例生成是"生产手段"——一个负责测、一个负责产,组合起来就是大厂智能测试闭环。
17 研发质量指标体系与性能测试管理(管理域/运行域)
来源:WorkBuddy《面试知识点详解》主题 H9/J11/J10(豆包对话《研发质量指标管理域与运行域拆分统计方案》《近一年本业务P2+事故分析汇报(含指定章节)》) 整理入库:2026-09-14(WorkBuddy 137 条知识点覆盖检查补录) 定位:研发质量度量体系(发布维度 7 项指标 + 管理域/运行域双维度统计 + 管理域性能测试方案),与 8 章测试数据租户、16 章 AI Native 测试互为补充。
17.1 研发质量指标(发布维度)7 项及统计口径(H9)
WorkBuddy 文档原文(H9):
7 项指标释义: 1. 单测增量代码覆盖率:本次迭代新增代码被单测覆盖占比。
★ 入库补充(7 项完整口径,业界通用版本):
| # | 指标 | 统计口径 |
|---|---|---|
| 1 | 单测增量代码覆盖率 | 本次迭代新增代码被单测覆盖的行/分支占比(增量口径,防存量拉高) |
| 2 | 单测存量代码覆盖率 | 累计存量代码被单测覆盖占比(长期趋势看板) |
| 3 | 静态代码扫描问题数 | 增量/存量分级(P0/P1/P2),发布前 P0/P1 清零 |
| 4 | 测试用例通过率 | 本次迭代关联用例(单测+集成+回归)执行通过比例 |
| 5 | 缺陷密度 / 缺陷引入率 | 千行代码引入缺陷数(按迭代统计,含线上缺陷回溯) |
| 6 | 发布成功率 / 回滚率 | 发布成功比例、发布后回滚次数(含配置发布/代码发布) |
| 7 | 线上故障数 / 可用性 | P0/P1 事故数、MTTR、SLO 达成率(运行域结果指标) |
17.2 管理域 / 运行域双维度拆分统计逻辑(J11)
WorkBuddy 文档原文(J11):
⚠️ 原对话抓取被截断,内容可能不完整。 核心拆分逻辑: 即:管理域管"准入"(代码质量),运行域管"结果"(发布稳定性/合规)。
★ 入库补充(拆分逻辑 + 各自指标集):
- 管理域(研发过程质量):管"准入"——代码提交、单测、CR、静态扫描、用例覆盖、评审通过。按迭代/发布周期统计准入类指标(17.1 中 1-5 项),是发布前的"关卡"。
- 运行域(线上结果质量):管"结果"——发布稳定性、可用性、故障、合规、SLO。按时间窗统计线上指标(17.1 中 6-7 项 + SLO/合规),是发布后的"成绩单"。
- 为什么拆:管理域指标好(覆盖率/扫描全绿)不代表线上结果好;两个域分开统计才能定位问题出在"准入关没把住"还是"线上环境/依赖出问题"。
17.3 管理域性能测试方案(压测分级/风险/场景/指标/步骤)(J10)
WorkBuddy 文档原文(J10):
压测分级:管理域单模块、运行域单模块、跨域联合、端到端(E2E)。
★ 入库补充(压测方案四要素):
- 分级与目标:①管理域单模块(定位单服务性能基线)→ ②运行域单模块(线上流量形态摸底)→ ③跨域联合(验证强弱依赖交互、级联放大)→ ④端到端 E2E(验证全链路体验,用户视角)。
- 风险识别:核心链路、强弱依赖、数据量级(压测数据与真实数据分布差异)、依赖组件瓶颈。
- 关键场景:读写混合、峰值突发(秒杀/红包)、长尾慢请求、排队堆积。
- 核心指标:RT(P50/P95/P99)、TPS、错误率、资源占用(CPU/内存/GC)、连接数。
- 标准步骤:基线压测 → 施压 → 瓶颈定位(逐层下钻 DB/缓存/下游)→ 优化 → 回归对比。
面试串讲:性能测试不是"压一把看数字",而是分级(单模块→跨域→E2E)+ 定场景 + 盯 P99/错误率/资源 + 逐层下钻定位瓶颈的闭环。